ARTICLE · 1060289
MinerU 4.0 重磅升级:开源文档解析进入 Agent 时代(附安装与实测)
文档解析 = 转PDF再OCR?
复杂文档,直接读
进Agent工作流
四级解析 · 原生多格式 · 本地文档库 · 附安装与实测
MinerU 4.0 正式发布
📦 5 Parts + Conclusion
👉 滑动
PART 01
重新认识
它是什么
PART 02
架构解析
四级与工具链
PART 03
安装部署
pip到模型
PART 04
怎么用
CLI/SDK/API
PART 05
实测对比
跑分与短板
PART ///
写在最后
选型建议
一句话看懂
MinerU 4.0 把复杂文档变成 Agent 能直接啃的干净数据
MinerU 是 OpenDataLab(上海人工智能实验室)开源的智能文档解析引擎,专门把 PDF、图片、Office、网页、电子书等复杂文档,转成大模型可直接消费的结构化数据(Markdown / JSON / LaTeX)。它长期是开源社区里最受欢迎的复杂文档解析工具之一,GitHub Star 已破 8 万,被广泛用于科研文献解析、AI-Ready 数据生产和企业知识库建设。
2026 年 9 月,MinerU 4.0 正式发布。这是一次面向 Agent 时代的重要升级:模型能力更强,产品形态从「单机工具」演进为「文档解析基础设施」。本期我们就从 介绍、架构、安装、使用、实测 五个维度,把它一次讲透,并附上可直接复制的安装与调用命令。
01
PART
重新认识 MinerU
INTRO · 它解决什么问题
传统 PDF 解析在复杂排版、扫描件、公式、表格上常常吃力。MinerU 用 VLM + 小模型双引擎,自动去除页眉页脚页码、还原人类阅读顺序、保留标题段落列表,并抽取图文表——公式转 LaTeX、表格转 HTML,输出即是大模型友好的结构化文本。
4.0 的六大关键变化
四级解析
flash到advanced
DocVortex
原生多格式
本地文档库
Agent渐进读
再加:模型配置独立 · 统一SDK/API/WebUI · 九种渲染目标
开源与协议:商用友好
MinerU 采用 MinerU Open Source License(基于 Apache 2.0,附加少量条款)。绝大多数场景可免费商用;仅当 MAU 超 1 亿或月收入超 2000 万美元时需单独商业授权;基于 MinerU 提供第三方在线服务需显著标注。4.0 移除了 doclayoutyolo / mfd_yolov8(AGPLv3)与 layoutreader(CC-BY-NC-SA)等受限模型,授权更干净。
生态上,MinerU 支持 MCP 协议,可对接 Dify / Notion / OpenClaw 等主流 Agent 框架;4.0 还首次适配 AMD Radeon 本地 GPU,让本地部署覆盖更多算力平台。下面这张官方 Logo,先认识一下主角。
— MinerU 官方 Logo(来源:opendatalab/MinerU)
02
PART
架构解析:四级解析与统一工具链
ARCH · 4.0 如何重组系统
2.1 四级解析质量(Tiers)
4.0 用 四级解析质量 取代了 3.x 的 pipeline / vlm / hybrid 后端选择,按「质量—速度—成本」灵活取舍。PDF 与图片支持全部四级;Office、OpenDocument、EPUB、OFD、HTML、CSV-TSV 在 flash 层本地解析;纯文本直接读取。
2.2 DocVortex 原生解析
DocVortex 提供原生文档解析:不再转 PDF、不下载模型,直接解析 docx / pptx / xlsx 等。它无幻觉、结构还原完整,比「先转 PDF 再解析」快数十倍,且几乎不占 GPU,非常适合高频、批量、在线化的文档处理。
2.3 本地文档库与 Agent 渐进式阅读
4.0 把「解析」升级为「文档库」:mineru 命令族涵盖 parse / read / find / search / show / list / watch / scan,外加缓存控制(invalidate / forget / cleanup)与后台服务。关键点在于 渐进式阅读:mineru parse 默认只解析前 10 页并返回 next_request 续读命令,长文档逐页读,而不是一次性加载。
稳定定位符 doc:{id}/tier:{tier}/page:{page}/block:{block} 支持续读、页码/区块图片导出,以及可核验引用——这正是 Agent 把文档当「可检索知识」用的关键。隐私默认本地解析,仅 --remote 显式上传;遥测可用 mineru telemetry status 查看并关闭。
2.4 模型配置独立 + 2.5 统一工具与 V1 API
小模型(ONNX 或 Torch)与 VLM 引擎(llama.cpp / vLLM / LMDeploy)通过 model.small_backend 与 model.vlm.engine 独立配置,移除旧的 model.stack / --stack。基础包开箱即用(ONNX CPU 小模型 + llama.cpp VLM);mineru[torch] 加 Torch 小模型,mineru[full] 装 vLLM(Linux)/ LMDeploy(Windows)。
Python SDK、无状态批量转换(mineru-kit parse)、多服务 Router(mineru-router)、Gradio WebUI(mineru-webui)共享同一结构化结果模型。HTTP 服务围绕 V1 重建:/v1/health、/v1/tiers、/v1/uploads、/v1/parse/jobs、/v1/files;旧的 /file_parse 与 /tasks 已移除。
2.6 九种渲染目标 + 2.7 工程增强
一个文档模型可渲染到 Markdown、HTML、LaTeX、DOCX、EPUB、PDF、Structured Content、Content List V1/V2 共九种目标;PDF 页码范围(1-5,8,r3-r1;r1 末页,all 全文档)跨 CLI / 库 / API / SDK 完全一致。
工程侧,4.0 通过滑动窗口降低长文档峰值内存、流式落盘持续写出,并实现线程安全与多线程并发推理;配合 mineru-router 一键多 GPU、自动负载均衡,万页级长文档在 8GB 内存下也能稳定跑。国产芯片(昇腾、寒武纪、昆仑芯、海光、摩尔线程等)持续适配。
03
PART
安装部署:从 pip 到模型下载
INSTALL · 本地跑起来
环境要求:Python >= 3.10 且 < 3.15。普通电脑用基础包即可开箱即用(ONNX + llama.cpp),想要更高精度或 GPU 加速再装 torch / full。
3.1 安装 + 3.2 模型下载
# 基础包:开箱即用(ONNX CPU 小模型 + llama.cpp VLM)
pip install -U mineru
# 加 Torch 小模型(Apple Silicon / 有 GPU 推荐)
pip install -U "mineru[torch]"
# 加 vLLM / LMDeploy(Linux / Win 高性能推理)
pip install -U "mineru[full]"
# 下载模型(standard 替代旧的 -m all)
mineru-kit models download --tier standard
mineru-kit models verify # 校验完整性
✦ 镜像与配置迁移
国内可设 export MINERU_MODEL_SOURCE=modelscope 走 ModelScope 镜像。配置已从旧 mineru.json 迁移到 $MINERU_HOME/config.yaml。
3.3 硬件推荐 + 资源占用
资源参考:basic(ONNX)模型约 0.8GB、最小内存 2GB、可纯 CPU;standard/advanced(ONNX+llama.cpp)约 2GB、8GB 内存;torch+vLLM 约 3GB、16GB 内存。Docker 部署详见官方文档(Linux / Win WSL2)。
04
PART
怎么用:CLI / SDK / API / WebUI
USAGE · 四种入口
4.1 命令行(CLI)
# 解析全部页(4.0 新语法)
mineru parse input.pdf --pages all -o output.md
# 默认前 10 页,返回 next_request 续读
mineru parse input.pdf -o output.md
# 指定 tier 与页码范围
mineru parse input.pdf --tier advanced -o out.md
mineru parse input.pdf --pages "1-5,8,r3-r1" -o out.md
# 文档库搜索与按定位符续读
mineru search "大模型" --json
mineru read "doc:ab12cd3/tier:standard/page:11" --json
默认本地解析;只有显式加 --remote 才会上传到远程服务,隐私边界清晰。
4.2 Python SDK
from pathlib import Path
from mineru.parser import parse, ParseResult
result = parse("document.pdf", tier="standard",
ocr_mode="txt", page_range="1-3")
Path("document.md").write_text(result.markdown(),
encoding="utf-8")
Path("document.json").write_text(result.to_json(),
encoding="utf-8")
SDK 还提供异步入口 parse_async 与云端客户端 MinerUApiParser,结果对象可序列化回放。
4.3 V1 HTTP API + 4.4 WebUI + 4.5 Agent 集成
# 自托管 V1 服务(默认本地匿名)
mineru-kit api-server --host 127.0.0.1 --port 8000 --tier standard
# 多 GPU 路由(自动负载均衡)
mineru-router --host 0.0.0.0 --port 8002 --local-gpus auto --worker-tier standard
# Gradio WebUI
mineru-kit webui --server-name 0.0.0.0 --server-port 7860
请求周期:POST /v1/uploads → 上传字节 → 提交解析任务 → 轮询任务状态 → GET /v1/files/{file_id}/content 下载产物。加 --api-key 启动后,请求头带 Authorization: Bearer $MINERU_API_KEY。新版 MinerU Skill 还能让 Agent 自动安装并调用本地能力,文档上传由用户授权。
05
PART
实测对比:OmniDocBench 跑分
BENCH · 客观数据说话
OmniDocBench 是文档解析综合基准,覆盖 981 个 PDF 页面、9 种文档类型、4 种排版、3 种语言,对文本、表格、公式、阅读顺序分别打分。下面是基于 eulerai 开源评测的横向对比(MinerU vs Marker / Docling / olmOCR)。
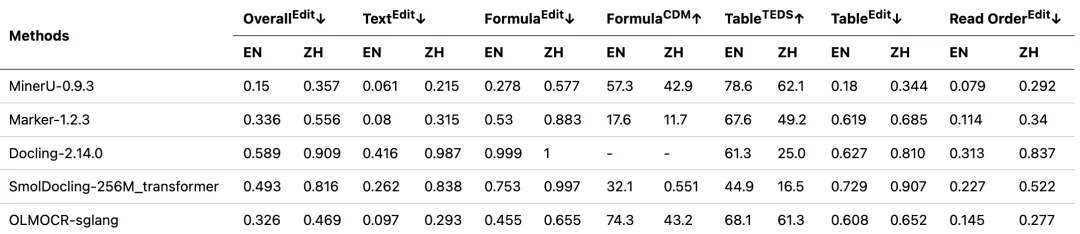
— OmniDocBench 深度测评对比(来源:eulerai-au 开源评测)
综合最优:MinerU 英文整体编辑距离 0.15(最低),中文 0.357(双语最佳);olmOCR、Marker 次优;Docling 最差(英文 0.589、中文 0.909)。纯文本 MinerU 全面领先,英文误差 0.061、中文 0.215,均第一。
分项看:表格 MinerU 英文 TEDS 78.6、中文 62.1;公式 MinerU 中英文 CDM 57.3 / 42.9 较均衡,olmOCR 英文 74.3 但中文骤降至 43.2;阅读顺序 MinerU 英文 0.079 极佳,中文场景误差率上升。
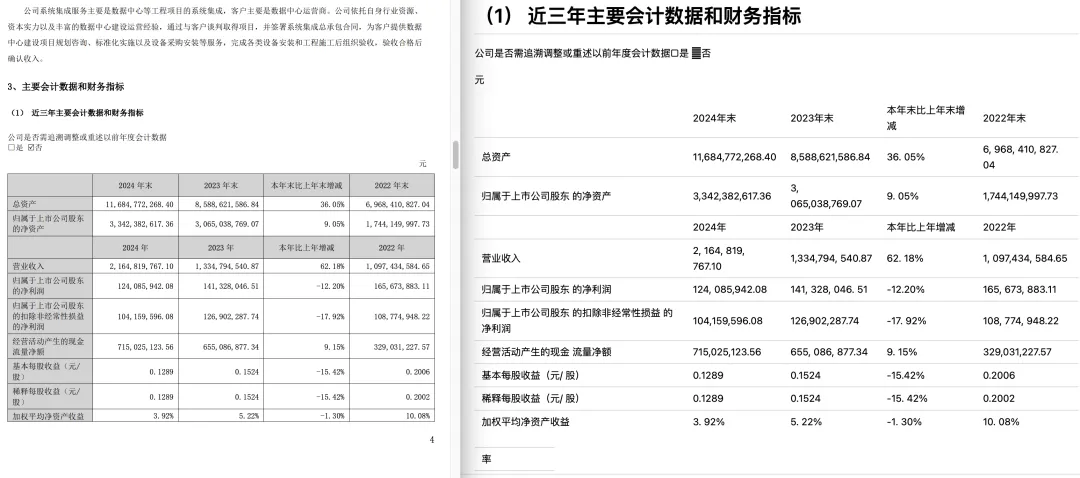
— MinerU 中文文档实测解析结果(来源:eulerai-au 评测)
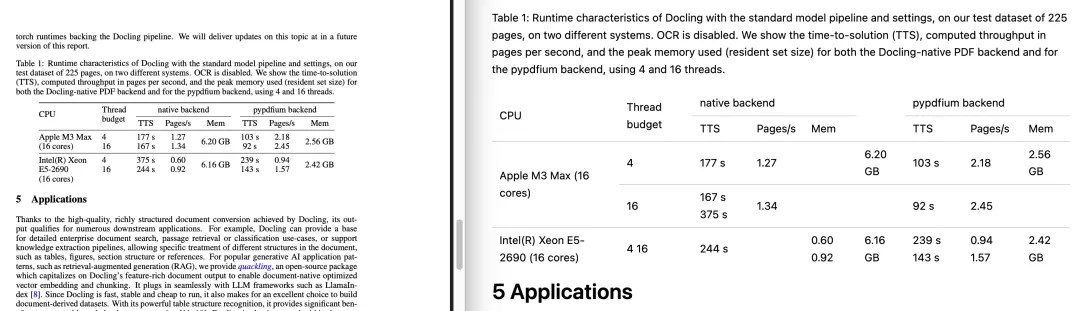
— MinerU 英文文档实测解析结果(来源:eulerai-au 评测)
客观短板(必须说清楚)
第三方横向测试(macOS,9 页英文+11 页中文 PDF)显示:MinerU 与 Marker 质量相近,Marker 表格布局略优、速度更快,MinerU 耗时偏长但精度高;Docling 复杂表格吃力;MarkItDown 最快但质量最差。MinerU 自身仍有边界:中文复杂排版与竖排阅读顺序存在误差、超长文档需渐进读取、VLM 模式吃 GPU、暂不原生支持多层级标题与代码块版面识别。
选型建议
///
LAST
写在最后
SUMMARY · 一句话结论
MinerU 4.0 不再只是「PDF 转 Markdown」,而是把文档变成 Agent 可用的知识基础设施——四级解析、原生多格式、本地文档库、统一 API,开源且商用友好。本地部署零成本(显卡+电费即可),想省事直接上官方在线 Demo(mineru.net)。
如果你正在搭 RAG 或 Agent,不妨把文档入口先换成 MinerU 4.0,再回头看解析质量与Pipeline 稳定性的变化。欢迎在评论区聊聊你的实测体验。
我是 AI研习驿站,一个最懂你的 AI 学习社区——只聊 Python、大模型、RAG 的实战与通俗解读,陪你从入门到精通。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING