ARTICLE · 1064531
AI 运维助手变搜索框,锅真不在模型
AI 运维助手变搜索框,锅真不在模型
凌晨两点十七分,订单接口 P99 从 180ms 飙到 4 秒。
你打开上线三个月的「AI 运维助手」,敲下一行:订单服务为什么变慢?
三秒后,它回了一段教科书式的答案:可能是数据库慢查询、下游超时、JVM GC 频繁、网络抖动、缓存失效……
每一条都对,每一条都没用。
你关掉窗口,手动翻日志、拉监控、扯会议,40 分钟后定位到根因:某个 Redis 节点网络抖动。
转身你在周报里写下:这东西,就是个高级搜索框。
但我想先说一个反直觉的结论:搜索框不是 AI 的失败形态,而是你组织现状的诚实投影。 模型没有辜负你,它只是把它能看到的世界,如实翻译了一遍。
这篇文章不聊「Agent 有多强大」,聊一个更扎心的问题:为什么你家的 AI 助手,注定只能当搜索框——以及从搜索框到诊断 Agent,中间到底断了几根链子。
一、它不是变笨了,是只被喂了文字
大模型的回答质量,取决于输入。
你只给它一句「订单服务为什么慢」,它手里没有任何此刻的生产状态,只能调用通用知识作答。
这本质上就是检索,不是诊断。
流行的解释是:因为它是 Chatbot,不是 Agent。但这个说法只是把现象换了个名字,没有回答真问题——为什么上线三个月,它还是个 Chatbot?
答案是:从它出生那天起,三条让它变成 Agent 的链路,一条都没接通。
二、三条断链:状态、验证、授权
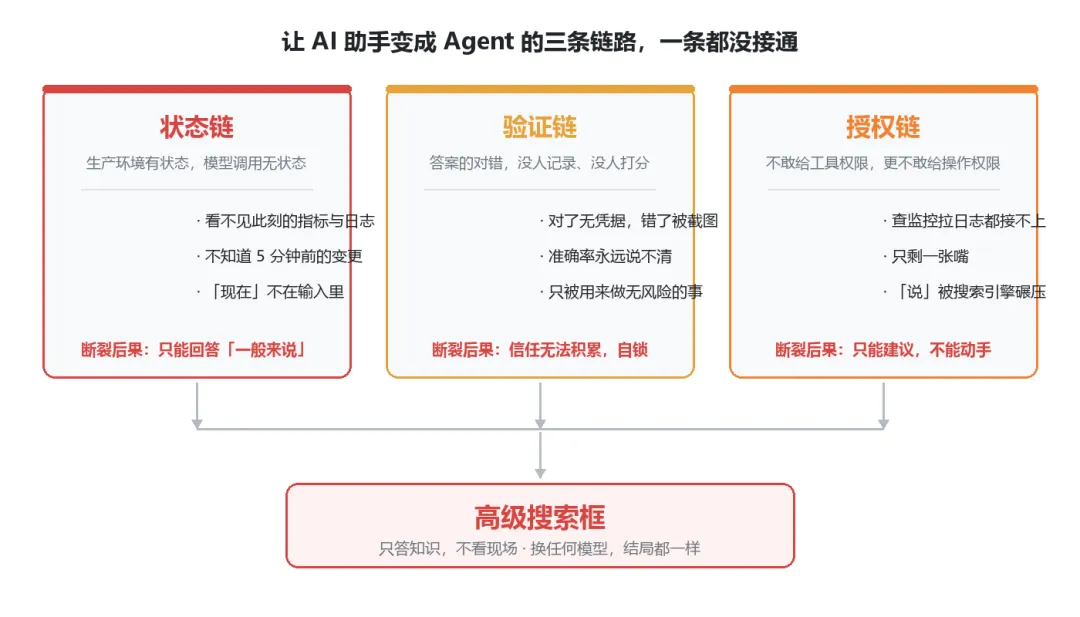
状态链。 生产环境是有状态的,而 LLM 的每次调用是无状态的。
它不知道此刻 Redis 的 RT 是 1ms 还是 120ms,不知道 02:17:18 发生过什么,不知道三分钟前有个变更单刚上线。
「现在」这个维度,在它的输入里根本不存在。一个看不见现在的系统,只能回答关于「一般来说」的问题。
验证链。 这一根更隐蔽,也更致命。
它的答案对了,没人记录;答案错了,立刻被截图进群嘲讽。对错都不进任何系统,于是它的准确率永远是一笔糊涂账。
人不信任它,就只用它做无风险的事——查查概念、问问命令。而越只用它做无风险的事,就越没有证据去积累信任。 这是一个自锁的死循环。
授权链。 没人敢给它查监控、拉日志、调 CMDB 的工具权限,更别说执行操作。
于是它只剩一张嘴。「说」的性价比被搜索引擎碾压,「做」的能力被权限系统锁死。
三条链路断成这样,换成哪个模型,结局都一样:搜索框。
三、为什么换模型救不了它
很多团队的改进路径是:换个更强的模型、重写 system prompt、优化 RAG 切片。
折腾一圈,搜索框还是搜索框——只是答案变得更流畅了。
原因很简单:模型再强,也只能站在知识库里隔空喊话。
模型决定回答的上限,链路决定能不能摸到下限。
你优化的是它说话的方式,从没管过它看世界的方式。
所以判断一个 AI 运维项目有没有戏,别看它 demo 里对答如流,看三件事:它有没有工具、它的答案有没有人打分、它有没有执行过一次真实的操作。 三个都没有,趁早别立项。
四、接通状态链:把「问 AI」改成「AI 自己查」
好消息是,状态链的修复成本,比想象中低。
不用建中台,不用等数据治理验收。给模型一组只读的诊断工具,让它自己取证,一两周就能搭起来:
# 只读诊断工具集(MCP server 注册示例)
tools:
  - k8s_get_pod          # Pod 状态、事件、重启次数
  - k8s_get_events       # 命名空间近期事件流
  - prom_query           # Prometheus 即时/区间查询
  - loki_search          # 按 service/traceID 检索日志
  - trace_query          # 拉取慢请求的调用链
  - cmdb_lookup          # 服务依赖与宿主机归属
  - change_list          # 近 24h 变更记录
read_only: true          # 全部只读,不改动任何状态
工具接通的那一刻,回答的性质就变了。
同一个问题「订单服务为什么慢」,它会自己去看 P99 曲线、慢请求调用链、Redis 指标、两小时前的发布记录——然后给你一份带证据的诊断报告,而不是六条猜测。
输出格式也要换。别让它输出「建议清单」,强制它输出诊断报告:
## 诊断报告 2026-09-23 02:19
现象:订单服务 P99 180ms→4.2s(02:17:23 起)
证据:
  - trace:92% 慢请求卡在 Redis 调用(trace_query)
  - 指标:redis-b01 网络 RT 1ms→120ms(02:17:18 起,prom_query)
  - 变更:近 24h 无相关发布(change_list)
时间线:Redis RT 异常 → 订单超时 → 支付/库存级联
假设:redis-b01 宿主机网络异常(置信度:高)
下一步:查宿主机丢包率;预备流量切换方案
关键约束就一条:每个结论必须引用数据源和时间戳,不允许输出无证据的判断。
这一条同时治两个病:幻觉,和「正确的废话」。
五、接通信任链:让验证有通道,权限有阶梯
验证链和授权链,靠的不是技术,是设计一个信任能长大的机制。
刚上线的头一周,别考核它答得多准——考核它引用的数据全不全。数据全不全可以客观打分,准确率短期内没法服人。
每次故障复盘,加一个五分钟环节:把它的诊断报告翻出来,人工标注哪些结论成立、哪些不成立,计分进看板。
两三个月后,你手里就有硬数据:它 60 次诊断,对了几次,错在哪类问题上。
有了分数,才敢谈权限。 权限按阶梯放:
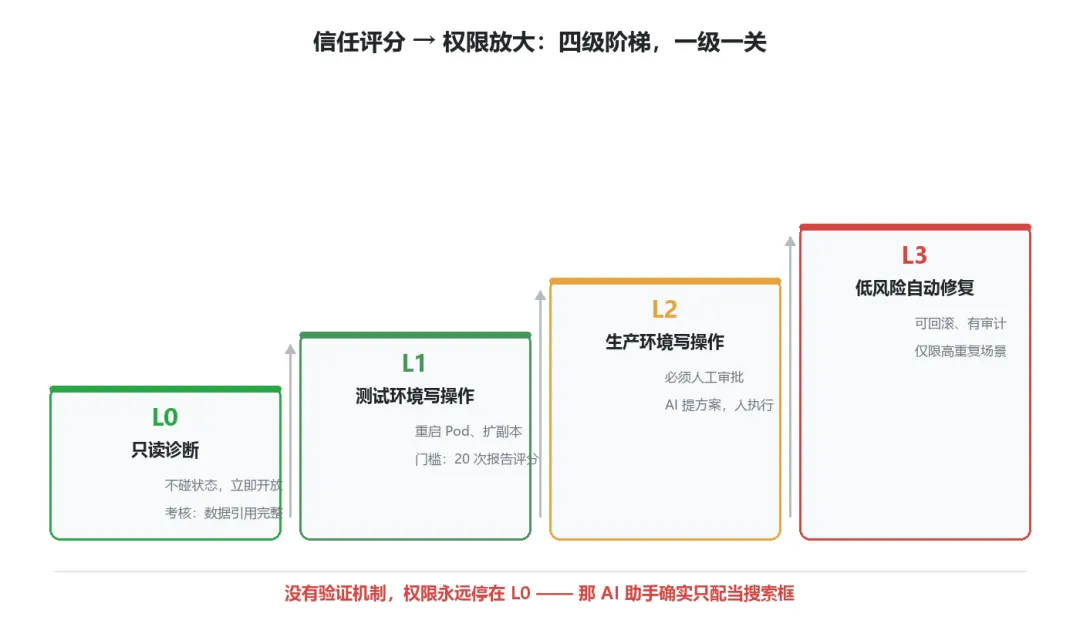
- L0 只读诊断
:立即开放,不碰任何状态; - L1 测试环境写操作
(重启 Pod、扩容副本):拿到 20 次以上报告评分后再开放; - L2 生产环境写操作
:必须人工审批,先从「AI 提方案、人点执行」开始; - L3 低风险自动修复
:仅限重复性高、可回滚、有完整审计的场景。
信任不是要求出来的,是被一个个可验证的闭环喂大的。 没有验证机制,权限永远停在 L0——那它确实只配当搜索框。
六、一页自查清单
立项前、复盘时,拿这五个问题过一遍:
它能看到「现在」吗——有没有接指标、日志、链路、变更的工具? 它的答案有证据链吗——每条结论能不能点回原始数据? 谁在给它的答案打分——对错有没有进系统? 它执行过一次真实操作吗——还是永远停在「建议」? 它坏了你怎么知道——准确率跌了,你有数吗?
五个问题答不上三个,先别急着扩场景,把链子接上。
搜索框不可怕,可怕的是把它当终点。从搜索框到诊断 Agent,差的从来不是模型智商,是那三根没人肯接的链子。
你家的 AI 运维助手现在停在哪一级?评论区聊聊你踩过的坑。