ARTICLE · 1065945
Linux 6.12 源码深度剖析: switch_mm
Linux 6.12 核心源码深度解析:ARM32 架构下的进程地址空间切换 switch_mm
在多任务操作系统中,进程上下文切换(Context Switch)是支持并发执行的核心机制。而进程上下文切换中最重、最关键的一步,莫过于进程地址空间的切换——即 switch_mm。
本文将基于 Linux 6.12 内核源码,深入剖析 ARM32 体系结构(Arch_ARM32)下的 switch_mm 实现机制。我们将从硬件设计(MMU、Cache、TLB)与内核软件协同的角度,揭示这一底层函数的精妙设计。
📌 1. 技术点速览
switch_mm 函数是 Linux 内核中用于切换用户态进程虚拟内存空间(Address Space)的核心底座。
解决什么问题:它解决了多任务并发时,如何安全、高效地将 CPU 的 MMU(内存管理单元)从上一个进程(
prev)的页表切换到下一个进程(next)的页表,同时最大程度减少昂贵的 TLB(旁路转换缓冲)刷新和 Cache 失效开销。处于系统什么位置:它处于核心调度器(Scheduler)与底层体系结构(Arch)的交界处。由进程调度主控函数
__schedule()触发,在context_switch()中被调用。软件模块归属:属于
Arch_ARM32(ARM32 体系结构相关模块),其声明与内联实现位于arch/arm/include/asm/mmu_context.h。
🗺️ 2. 软件功能架构图
在进程切换过程中,调度器模块、内存管理模块与 ARM32 体系结构模块紧密协同。以下是 switch_mm 的整体调用与协作架构图:
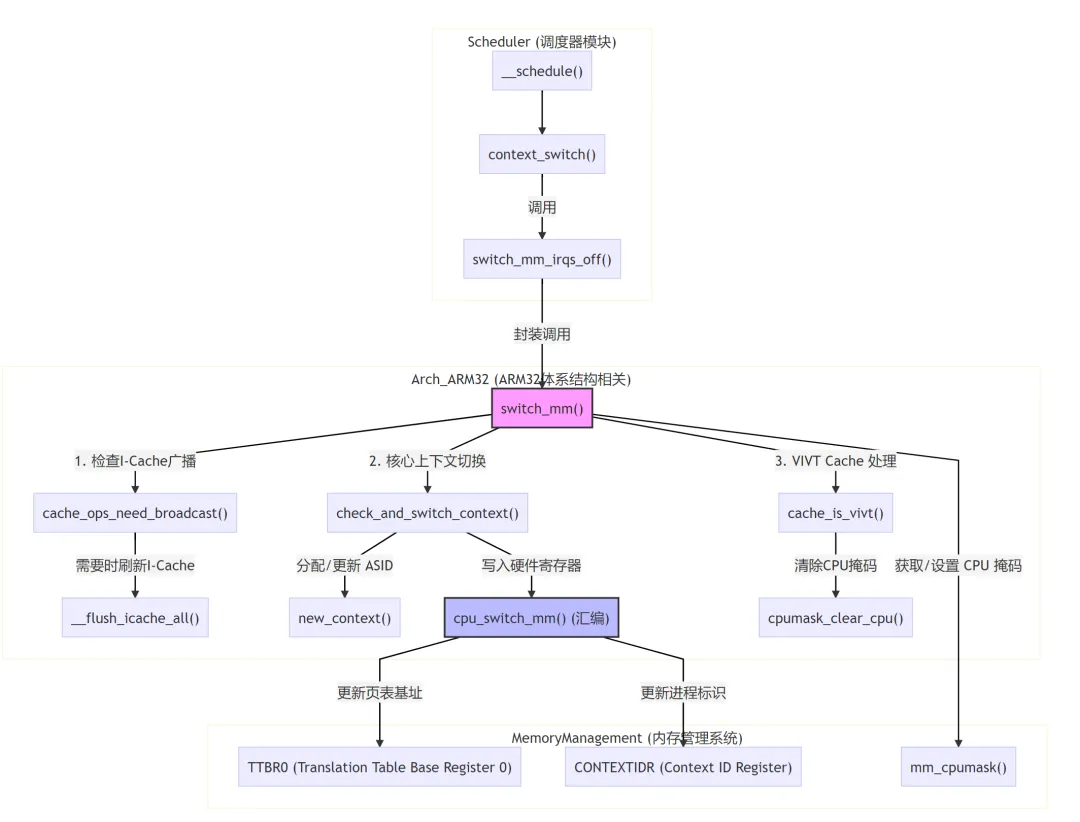
🔍 3. 核心源码硬核解析 (基于 Linux 6.12)
在 ARM32 架构中,switch_mm 的实现需要应对复杂的硬件特性:哈佛结构(I-Cache 与 D-Cache 分离)、VIVT/VIPT Cache 别名问题以及 ASID(进程地址空间标识符)。
以下是 arch/arm/include/asm/mmu_context.h 中 switch_mm 的完整源码及逐行硬核解析:
staticinlinevoidswitch_mm(struct mm_struct *prev, struct mm_struct *next,struct task_struct *tsk){#ifdefCONFIG_MMU// 获取当前物理 CPU 的 IDunsigned int cpu = smp_processor_id();/** __sync_icache_dcache doesn't broadcast the I-cache invalidation,* so check for possible thread migration and invalidate the I-cache* if we're new to this CPU.** 【核心职责解析 - 跨核迁移与 I-Cache 一致性】:* 在多核(SMP)ARM32 系统中,当一个进程从 CPU-A 迁移到 CPU-B 运行时,* 如果该进程之前在 CPU-A 上修改了代码段(例如 JIT 编译、ptrace 写入断点),* 对应的 D-Cache 会被写回并同步到物理内存,但 CPU-B 的 I-Cache(指令缓存)* 并不知道这些修改。由于 ARM32 的某些硬件实现不支持跨核广播 I-Cache 失效指令,* 内核必须在软件层面检测这种“跨核迁移”并手动刷新当前 CPU 的 I-Cache。*/if (cache_ops_need_broadcast() &&!cpumask_empty(mm_cpumask(next)) &&!cpumask_test_cpu(cpu, mm_cpumask(next)))__flush_icache_all();/** 【核心职责解析 - 避免重复切换与 ASID 分配】:* 1. cpumask_test_and_set_cpu(cpu, mm_cpumask(next)):* 检查当前 CPU 是否已经记录在 next 进程的 cpu_vm_mask 中。* 如果未记录(返回 0),说明这是 next 进程首次在该 CPU 上运行,或者其 ASID 已失效。* 2. prev != next:* 如果前后两个进程的 mm_struct 不同,则必须进行切换。*/if (!cpumask_test_and_set_cpu(cpu, mm_cpumask(next)) || prev != next) {/** 核心函数:检查并切换硬件上下文。* 负责分配 ASID(Address Space Identifier),并最终调用汇编代码* 写入 CP15 协处理器寄存器(TTBR0 和 CONTEXTIDR)。*/check_and_switch_context(next, tsk);/** 【核心职责解析 - VIVT Cache 别名与冲突处理】:* 如果当前 CPU 的 Cache 类型是 VIVT(Virtually Indexed, Virtually Tagged,* 虚拟索引虚拟标记),由于不同进程的相同虚拟地址会映射到相同的 Cache Line,* 必须在切换时进行特殊处理。* 如果是 VIVT,我们需要将当前 CPU 从上一个进程(prev)的 cpu_vm_mask 中清除。* 这样,当 prev 再次回到该 CPU 运行时,会强制重新触发 check_and_switch_context,* 从而安全地刷新或重建 Cache 映射,防止虚拟地址冲突导致的数据错乱。*/if (cache_is_vivt())cpumask_clear_cpu(cpu, mm_cpumask(prev));}#endif}
🛠️ 关键底层机制深度剖析
1. check_and_switch_context 的幕后功臣:ASID 机制
在 ARM32 架构中,如果每次进程切换都全量刷新 TLB,会导致巨大的性能损失(TLB Miss 暴涨)。为了解决这个问题,ARM 引入了 ASID(Address Space Identifier,地址空间标识符)。
ASID 占用 8 位(或 16 位),与虚拟地址一起参与 TLB 匹配。
不同的进程拥有不同的 ASID。这样,TLB 中可以同时缓存多个进程的转换表项,切换进程时无需清空整个 TLB。
check_and_switch_context(定义于arch/arm/mm/context.c)会检查next->context中的 ASID 是否仍然有效(是否属于当前这一代的 ASID 序列)。如果有效,直接使用;如果发生 ASID 回绕(Rollover),则重新分配,并在必要时全局刷新 TLB。
2. 汇编级寄存器操作:cpu_switch_mm
当 ASID 和页表准备就绪后,check_and_switch_context 最终会调用平台相关的汇编函数 cpu_switch_mm(例如对于 ARMv7 架构,实现在 arch/arm/mm/proc-v7.S 中):
/** v7_switch_mm(pgd_phys, mm)** Set the translation table base pointer to be pgd_phys** - pgd_phys - physical address of translation table* - mm - mm_struct of next task*/ENTRY(cpu_v7_switch_mm)#ifdefCONFIG_MMU/* 1. 将新的页表物理基地址(PGD)写入 TTBR0 寄存器 */mcr p15, 0, r0, c2, c0, 0 @ write to TTBR0/* 2. 将新的 ASID 和进程上下文信息写入 CONTEXTIDR 寄存器 */mcr p15, 0, r1, c13, c0, 1 @ write to CONTEXTIDR/* 3. 内存屏障,确保上述写入对后续指令和内存访问立即可见 */isb#endifret lrENDPROC(cpu_v7_switch_mm)
TTBR0(Translation Table Base Register 0):存放用户空间页表的物理基地址。CONTEXTIDR(Context ID Register):低 8 位存放当前运行进程的 ASID。MMU 在进行地址翻译和 TLB 缓存时,会读取该寄存器以区分不同进程的虚拟地址。
⚙️ 4. 系统运行背景与上下文
switch_mm 不是孤立运行的,它处于内核三大核心子系统(调度器、内存管理、体系结构)的交汇处。
+-------------------------------------------------------------------+| Scheduler (调度器) || - 决定下一个运行的 task_struct (next) |+-------------------------------------------------------------------+|v+-------------------------------------------------------------------+| Memory Management (内存管理) || - 提供 mm_struct, 管理页表 (PGD) || - 维护 mm_cpumask (跟踪哪些 CPU 正在运行该地址空间) |+-------------------------------------------------------------------+|v [switch_mm]+-------------------------------------------------------------------+| Arch_ARM32 (体系结构层) || - 硬件级 Cache 一致性维护 (I-Cache / D-Cache) || - 硬件级 TLB 优化 (ASID 分配与管理) || - 协处理器操作 (CP15: TTBR0, CONTEXTIDR) |+-------------------------------------------------------------------+
跨模块协同工作流:
内核线程的“惰性 TLB”(Lazy TLB)优化: 当调度器准备切入一个内核线程(Kernel Thread)时,由于内核线程没有独立的用户空间地址空间(其
tsk->mm为NULL),调度器不会调用switch_mm。 相反,内核线程会“借用”上一个用户态进程的active_mm。此时,MMU 保持原有的TTBR0不变,从而完全避免了切换页表和刷新 TLB 的开销。这就是 Lazy TLB 机制。多核(SMP)下的 CPU 掩码同步:
mm_cpumask(next)是一个位图,记录了当前有哪些 CPU 核心正在运行该进程。当进程在 CPU-0 上运行时,CPU-0 会被置位。
如果该进程在 CPU-1 上被唤醒,
switch_mm检测到 CPU-1 不在掩码中,就会触发check_and_switch_context为其在该 CPU 上激活或分配新的 ASID。这种设计保证了多核并发时,ASID 分配的局部性与正确性。
💡 5. 10年老兵避坑指南/实战案例
在基于 ARM32 架构(如 Cortex-A7/A9/A15 等嵌入式、物联网设备或老旧服务器)的生产环境中,围绕 switch_mm 及其底层的 Cache/TLB 机制,经常会遇到极其隐蔽的性能瓶颈和系统崩溃。
🚨 案例一:多核 JIT 引擎(如 JVM/V8)随机崩溃与指令损坏
现象:在某款双核 Cortex-A9 智能设备上,运行带有 JIT(即时编译)功能的应用程序(如 Java 业务或 Node.js 服务)时,系统会随机出现
SIGSEGV(段错误)或执行流异常,且崩溃地址完全随机。病因分析:
JIT 引擎在运行过程中,会在内存中动态生成机器码(写入 D-Cache),然后将其作为函数执行。
写入完成后,JIT 引擎会调用
sys_cacheflush系统调用来同步 D-Cache 和 I-Cache。然而,Cortex-A9 的硬件设计中,I-Cache 的失效操作(Invalidation)不会通过 SCU(Snoop Control Unit)自动广播到其他 CPU 核心。
当该 JIT 线程被调度器迁移到另一个 CPU 核心运行时,由于
switch_mm中的cache_ops_need_broadcast()未能正确识别或未开启相关内核配置,导致新 CPU 的 I-Cache 中残留了旧的指令缓存,从而执行了错误的指令,引发随机崩溃。排查与调优方法:
检查内核配置:确保内核配置中开启了
CONFIG_ARM_ERRATA_764369或相关的 SMP Cache 广播补丁。ftrace 追踪:使用
ftrace追踪__flush_icache_all的调用频率和触发时机:
echo function > /sys/kernel/debug/tracing/current_tracerecho __flush_icache_all > /sys/kernel/debug/tracing/set_ftrace_filtercat /sys/kernel/debug/tracing/trace
规避方案:在调度器层面,通过设置 CPU 亲和性(CPU Affinity),将 JIT 密集型线程绑定到固定核心,避免频繁跨核迁移。
🚨 案例二:高并发进程场景下的“TLB 抖动与抖动风暴”(ASID Rollover Storm)
现象:在 ARM32 嵌入式网关上,当运行大量短生命周期的容器或微服务进程时,CPU 利用率莫名暴涨,系统吞吐量急剧下降。通过性能分析工具发现,系统在
check_and_switch_context上的耗时占比极高。病因分析:
ARM32 架构的硬件 ASID 通常只有 8 位(即最多支持 256 个不同的 ASID)。
当系统中活跃的进程数量远超 256 个时,ASID 会频繁发生回绕(Rollover)。
一旦发生 Rollover,内核的 ASID 分配器(
arch/arm/mm/context.c)为了防止 ASID 冲突,不得不执行一次全局 TLB 刷新(Global TLB Flush),并递增 ASID 版本号。在高并发、多进程频繁切换的场景下,这种全局 TLB 刷新会演变成“TLB 刷新风暴”,导致 CPU 管道频繁清空,内存访问延迟暴涨。
排查与调优方法:
性能监控:使用
perf工具抓取热点函数:perf record -a -g -- sleep 10 perf report如果发现
cpu_v7_switch_mm或flush_tlb_all处于调用栈顶端,说明存在严重的 TLB 抖动。架构调优:
合并进程为线程:由于同一进程下的所有线程共享同一个
mm_struct(及相同的 ASID),将多进程架构重构为多线程架构,可以彻底消除switch_mm带来的 ASID 分配压力。升级硬件/内核:如果硬件支持 16 位 ASID(可支持 65536 个并发地址空间),确保内核正确识别并启用了 16 位 ASID 支持。
✍️ 总结
switch_mm 是 Linux 内核在 ARM32 架构上对硬件特性的极致压榨与妥协的产物。它通过精巧的 mm_cpumask 跟踪、ASID 软硬件协同管理以及对 VIVT/VIPT Cache 的小心呵护,在保证进程隔离安全性的前提下,将地址空间切换的开销降到了最低。
理解这一机制,不仅有助于编写高性能的底层代码,更是排查多核嵌入式系统下各种诡异内存、Cache 一致性 Bug 的终极利器。