ARTICLE · 1069739
PDF文档搜索怎么提速?NeoMME直接看页面找答案,索引可压缩255倍
Hugging Face / 项目观察
VOL. 017
HUGGING FACE 项目分享
不用先做OCR,把整页图片变成可检索向量,适合合同、报告和扫描件
H Company 发布的多语言、多模态检索编码器,可直接读取文档页面图片并生成检索向量,用于扫描件、表格、图文报告与视觉 RAG。
PDF搜索|RAG知识库|多模态检索
SECTION 01
真实界面与实际效果
下面均为项目方公开的官方图片、界面或演示素材,非本文伪造的运行结果。每张图均保留完整画布,并附原始资料页。
SECTION 02
它能做什么
H Company 发布的多语言、多模态检索编码器,可直接读取文档页面图片并生成检索向量,用于扫描件、表格、图文报告与视觉 RAG。
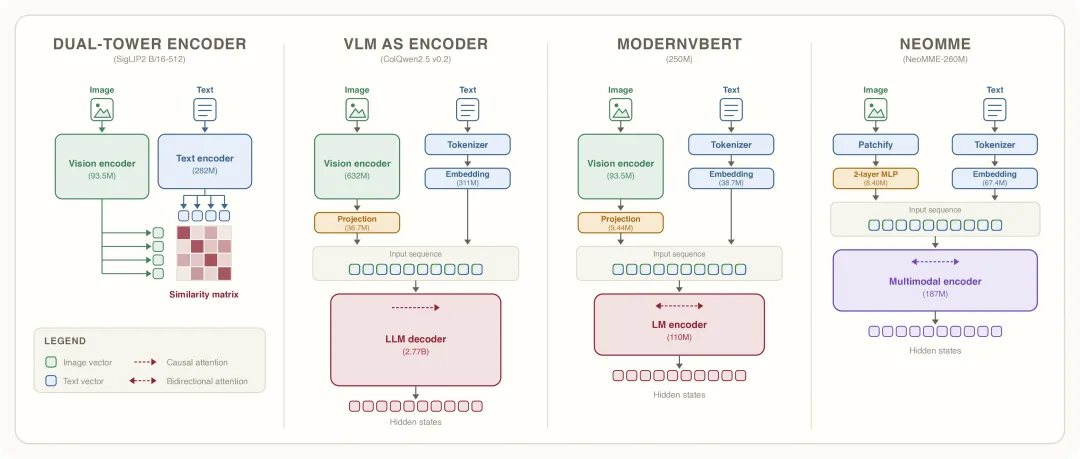
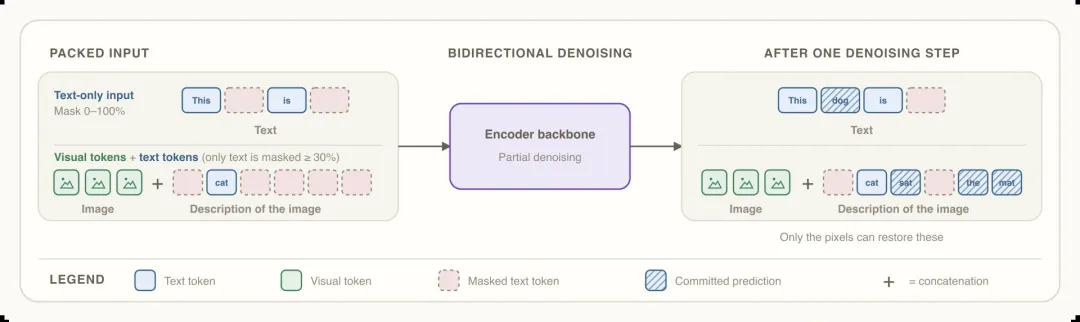
直接处理文字 token 与原始图像 patch,不依赖单独视觉塔
260M 与 800M 两种规模,支持多语言与动态图片分辨率
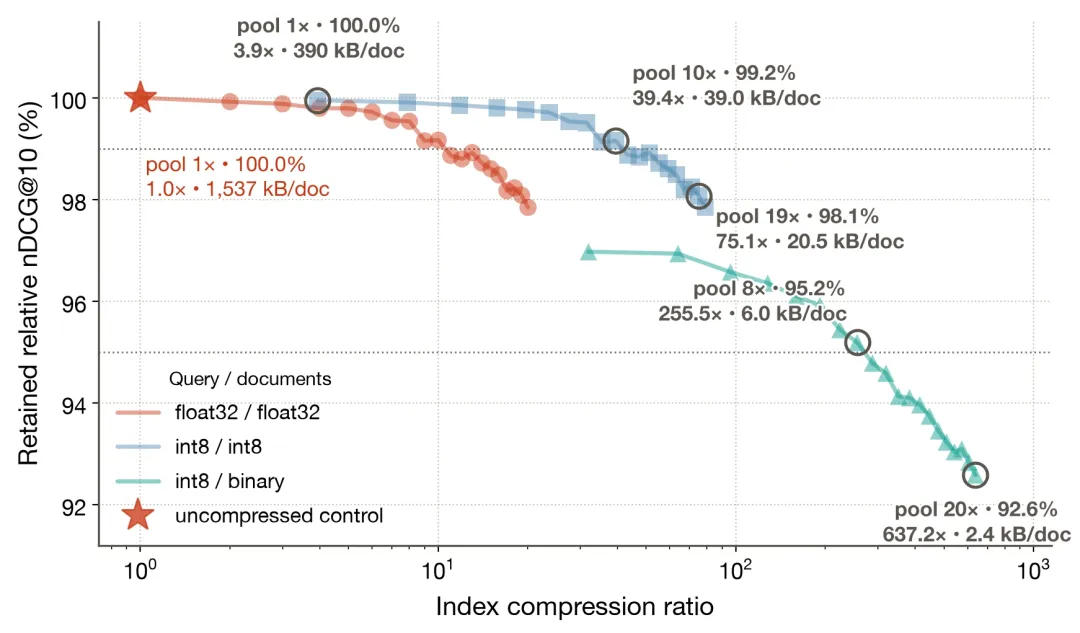
官方实验把单页后期交互索引从约 1.5MB 压缩到 6KB,同时保留超过95%的基线检索质量
它的价值不是“榜单分数看起来很高”,而是能否放进真实流程。建议先选一个明确任务和一组真实输入,做可复现的小范围验证。
SECTION 03
从准备输入,到得到结果
SECTION 04
适合谁,以及哪些地方要检查
适合希望快速验证相关 AI 能力的开发者、内容团队、产品经理、研究人员和业务部门。正式使用前,应检查输入数据权利、输出准确性、失败样本、隐私边界、运行成本和许可证。
先定义可量化的成功标准,不只挑最好看的案例
保存输入、模型版本、参数和输出,便于回溯
涉及决策、执行或公开发布时保留人工复核
在线演示状态、硬件要求与商业许可都以当天页面为准
SECTION 05
项目现状与使用条件
官方文章称 NeoMME 已集成 Hugging Face Transformers,所有 checkpoint 以 Apache 2.0 发布。51页/秒等速度来自指定 L40S 与输入尺寸测试,实际吞吐不能直接照搬。
以上状态核查日期为2026年9月20日。模型、Space、依赖、下载量、许可和页面入口都可能更新,正式发布或部署前应再次打开原页面确认。
SECTION 06
项目地址与资料来源
https://huggingface.co/blog/Hcompany/neomme
https://huggingface.co/collections/Hcompany/neomme
事实优先采用 Hugging Face 模型卡、Space、官方文章和项目方资料;正文图片访问日期与资料核查日期一致。