ARTICLE · 1078067
AI会不会取代影像科/放射科医生?——这篇Science研究给了最诚实的回答
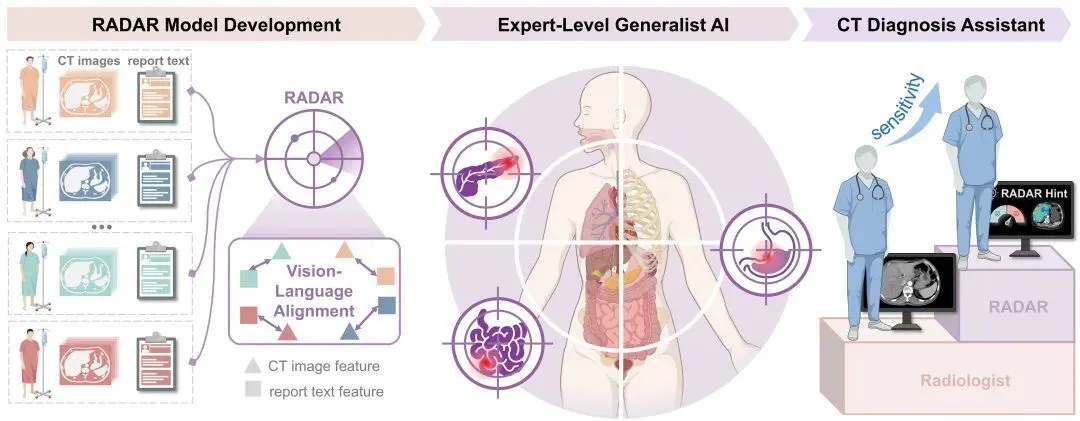
一、为什么腹部CT,是影像AI最难啃的骨头
在放射科,能不能读懂腹部CT,常被拿来衡量一名医师的基本功。它难在哪里,做这行的人心里有数。原因很实在:
·器官太多。肝、胆、胰、脾、双肾、肾上腺、胃肠、血管、骨骼……一个横断面扫过去,几十个结构同时入镜。
·病变太杂。从胆囊结石到肝细胞癌,从阑尾炎到肠套叠,上百种可能。
·对比度太低。病灶和正常组织的密度差,有时小到肉眼要"盯"很久才能分辨。
·形态变异太大。同一个器官,在不同人身上位置、形状、大小都不同。
这也是为什么,过去十年里AI在肺结节、乳腺、眼底这些领域先跑出来,而腹部CT一直进展缓慢。
更根本的问题在于训练方式。此前的医学影像AI大多走监督学习路线——需要医生逐张图、逐个病灶地打标签。一个病种动辄几万张大标注,成本高、扩展慢,而且一旦换到新医院、新设备、新的病种,模型往往就水土不服。
一句话概括旧路线的困境:标注多少,才能学会多少。而临床的需求是开放的——你永远不知道下一个病人得的是什么病。

二、RADAR的思路:不教它「答案」,教它「读报告」
RADAR 走的是另一条路——视觉-语言学习。
逻辑不复杂:医院里每天都产生海量的CT图像和对应的诊断报告。报告是医生写的,本身就包含了"这个器官有没有问题、是什么问题"的专业判断。既然这样,为什么不让AI直接从"图像—报告"的对应关系里学?
这样就不需要额外人工标注了。数据有多少,就能学多少。
但直接把"整卷CT"和"整份报告"配对,效果很差。原因在于——腹部CT的诊断信号极度稀疏:一份报告可能提到五六个器官,但真正有问题的可能只有一个,而那个病灶在整个3D体数据里可能只占极小的比例。整卷对齐,等于让"肝上有病灶"这句话被其他正常器官的描述淹没。
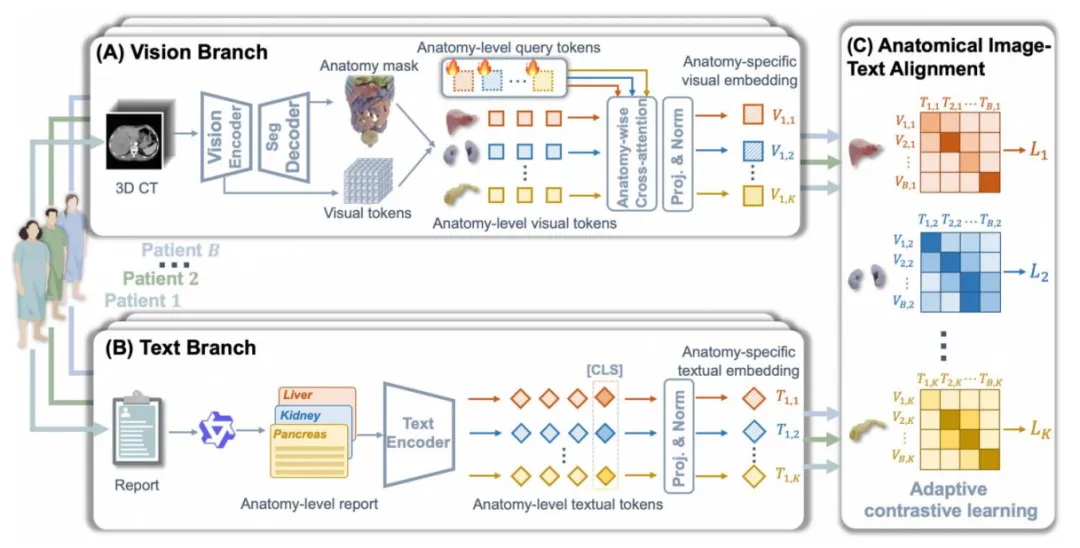
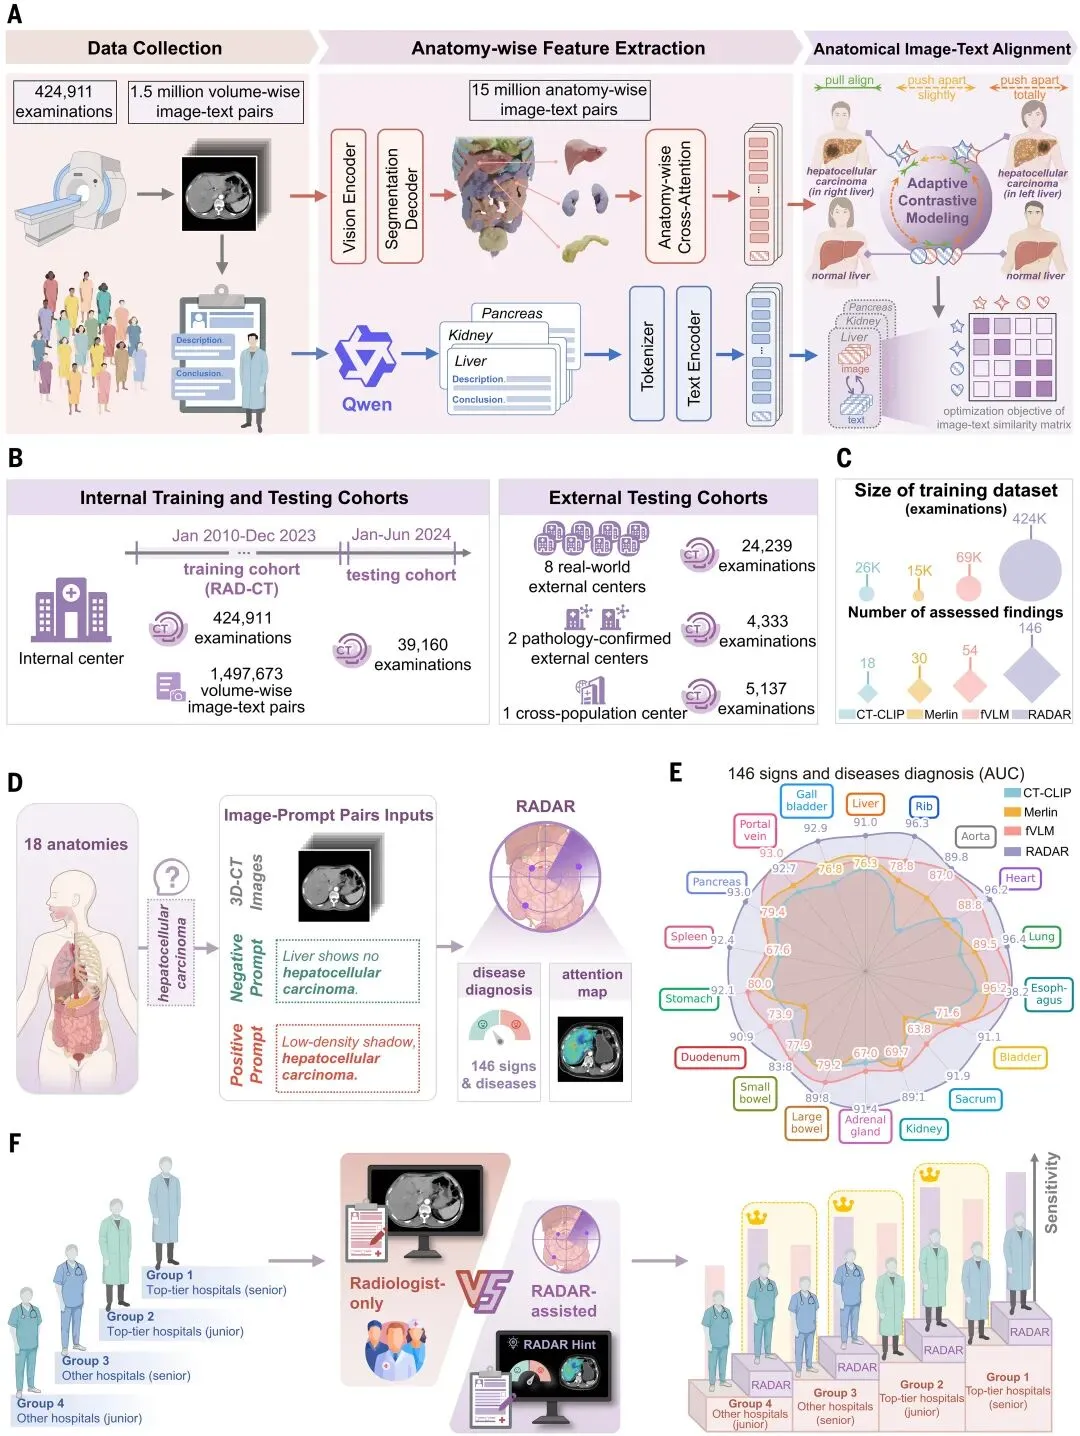
RADAR 的解法是:把CT按解剖拆开,让每个器官的影像,去对应报告里描述这个器官的那一段话。
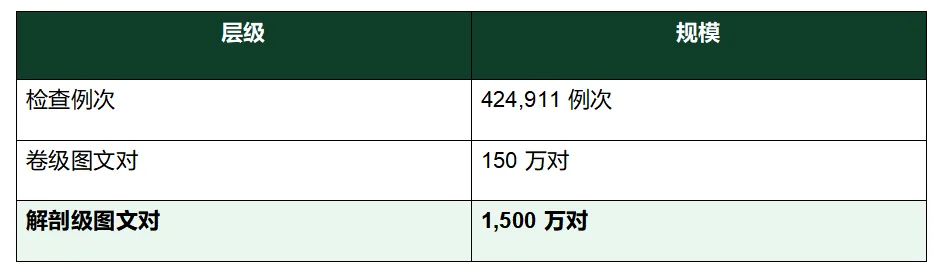
RAD-CT 训练数据集(浙大一院,2010–2023)

三、它做对了三件事
① 把粗粒度的「整卷对齐」,拆成细粒度的「器官对齐」
前面说的"信号稀疏"问题,就是靠这个解决的。让"肝的影像"去和"肝的描述"对齐,而不是让"全腹的影像"去和"全腹的报告"对齐。这一个改动,是后面所有性能的基础。
② 把「器官定位」能力,内化进模型自己
要按器官对齐,首先得知道器官在哪。团队之前的工作(fVLM)依赖一个外部的分割模型先跑一遍;RADAR 则把定位能力做进了端到端训练里——模型自己学会找准器官,不需要外部再喂一张"器官地图"。同时,分割和诊断两个目标互相促进。
③ 让「相似的东西」不要互相排斥
这一条最技术,但也最妙。
对比学习的基本原则是:同一患者的图文要靠近,不同患者的要推开。但这里有个漏洞——两个不同患者的肝脏都正常,或者都长了肝细胞癌,它们本该是"相似"的,却被当成"不相似"硬推开。
RADAR 引入了"自适应对比建模":对正常器官,不同患者的表征互为正样本;对异常器官,用语义相似度做软对齐。简单说——它允许"同样正常"和"同样有病"互相靠近。
从内部到跨人群
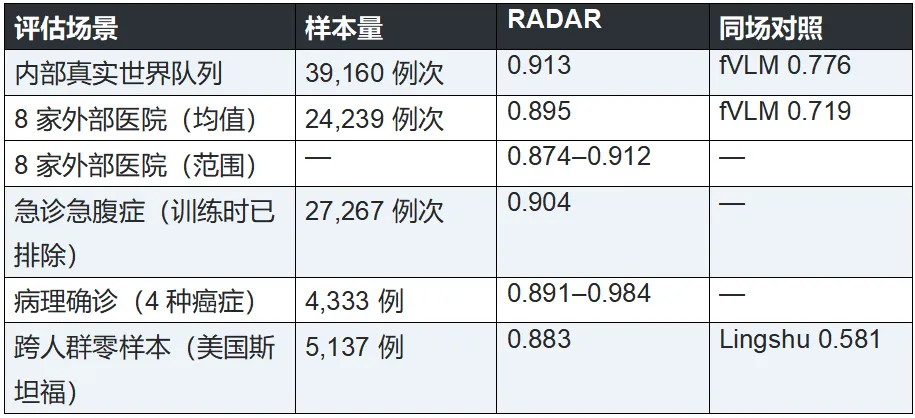
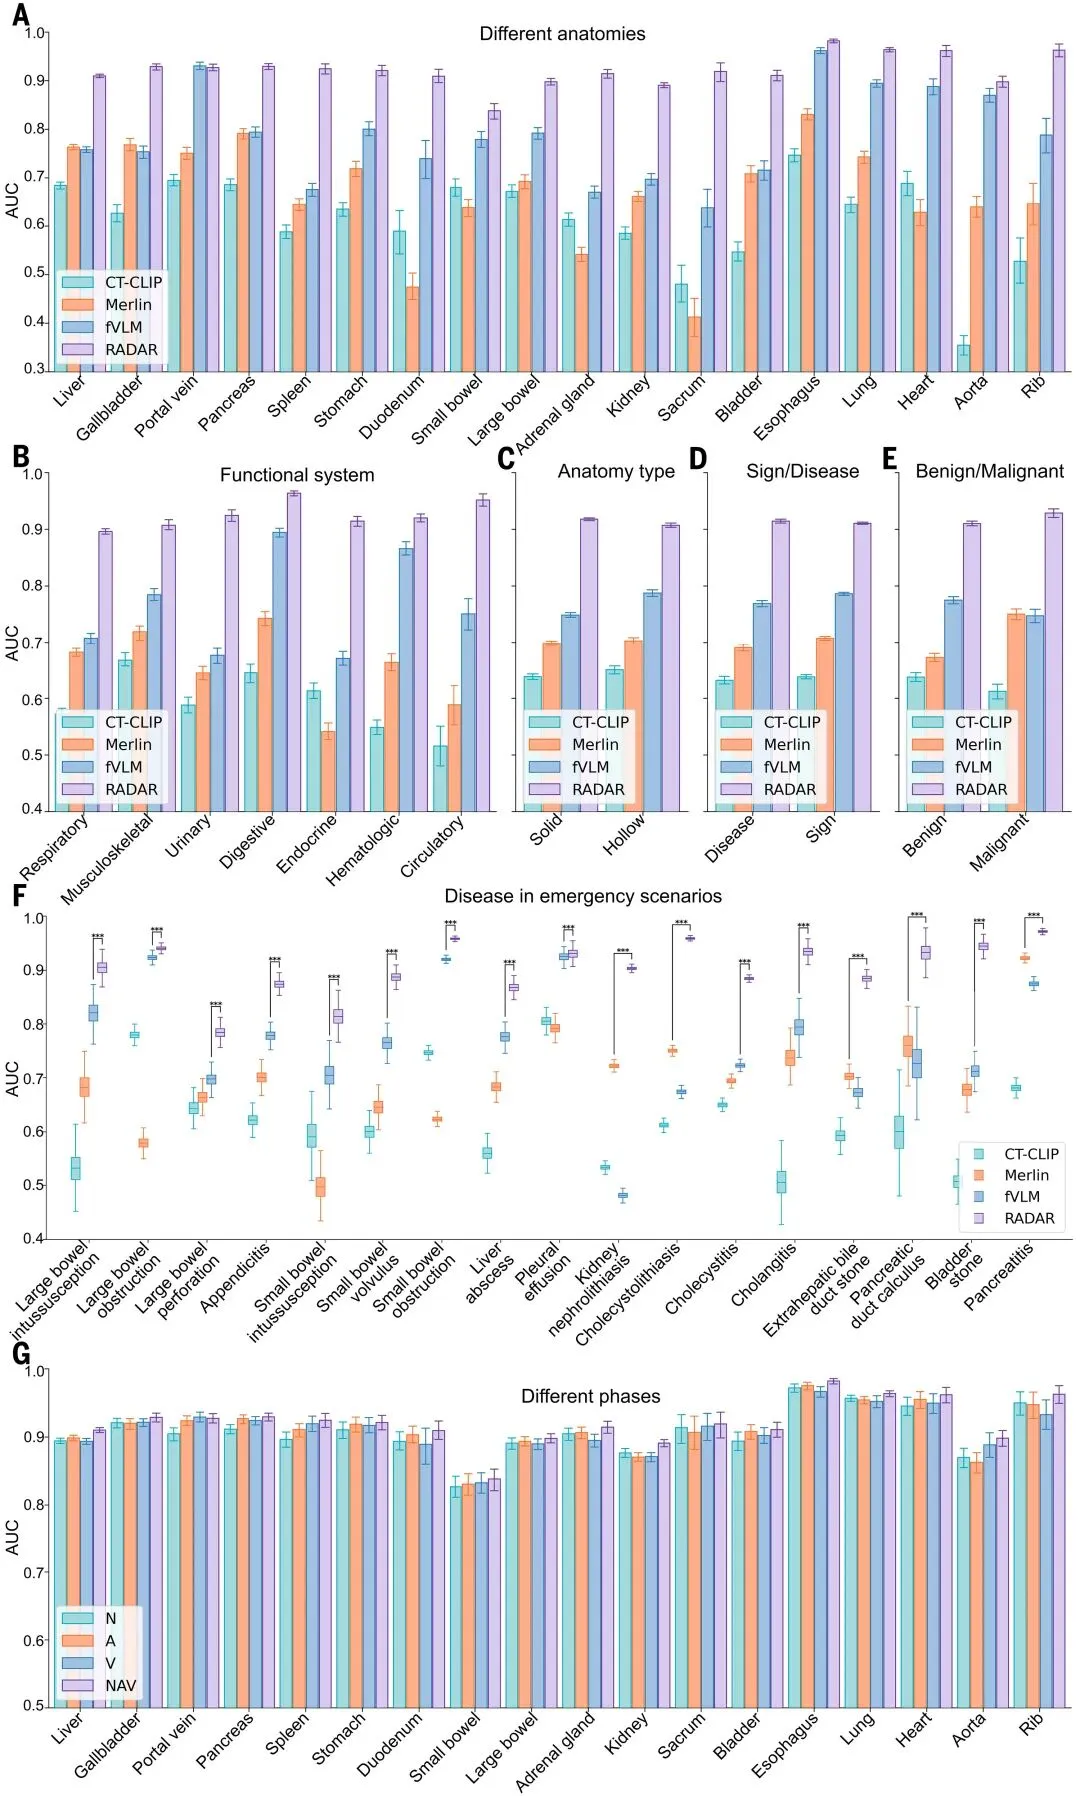
模型在 146 种影像征象和疾病上评估,覆盖 18 个解剖结构。研究把评估分成了几个层次,逐层加难。
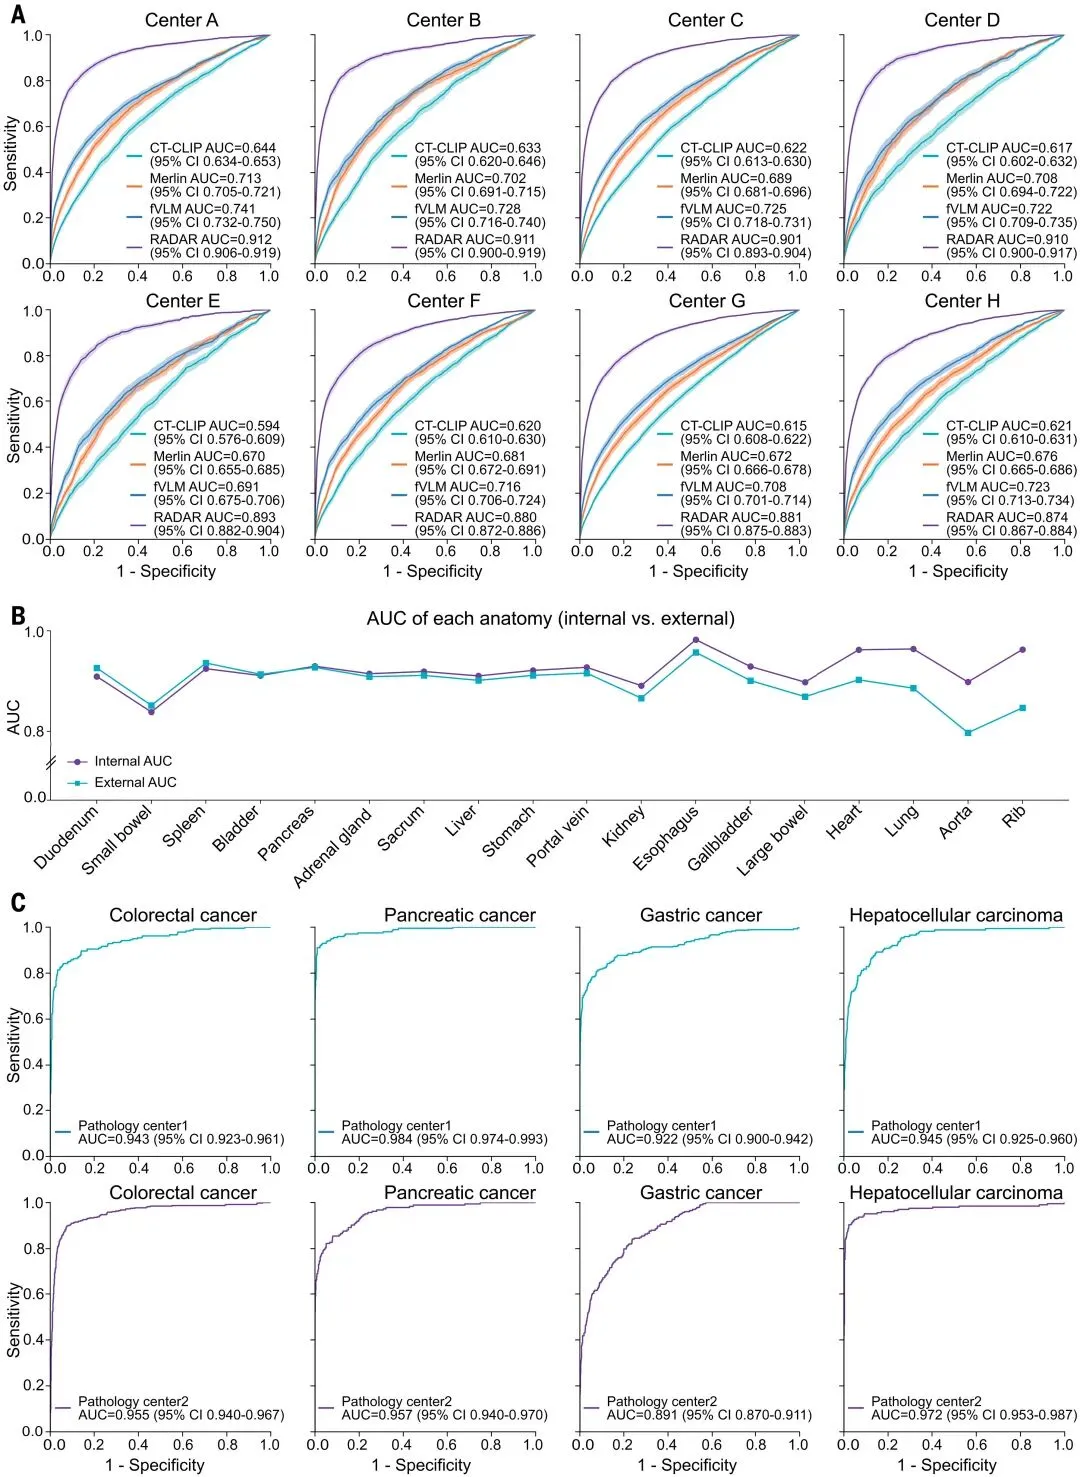

四、最强的证据:不是AUC,是26位医生读片实验
对临床医生来说,AUC 再漂亮也只是统计量。真正要看的是:这东西上了临床,到底帮不帮得上忙?
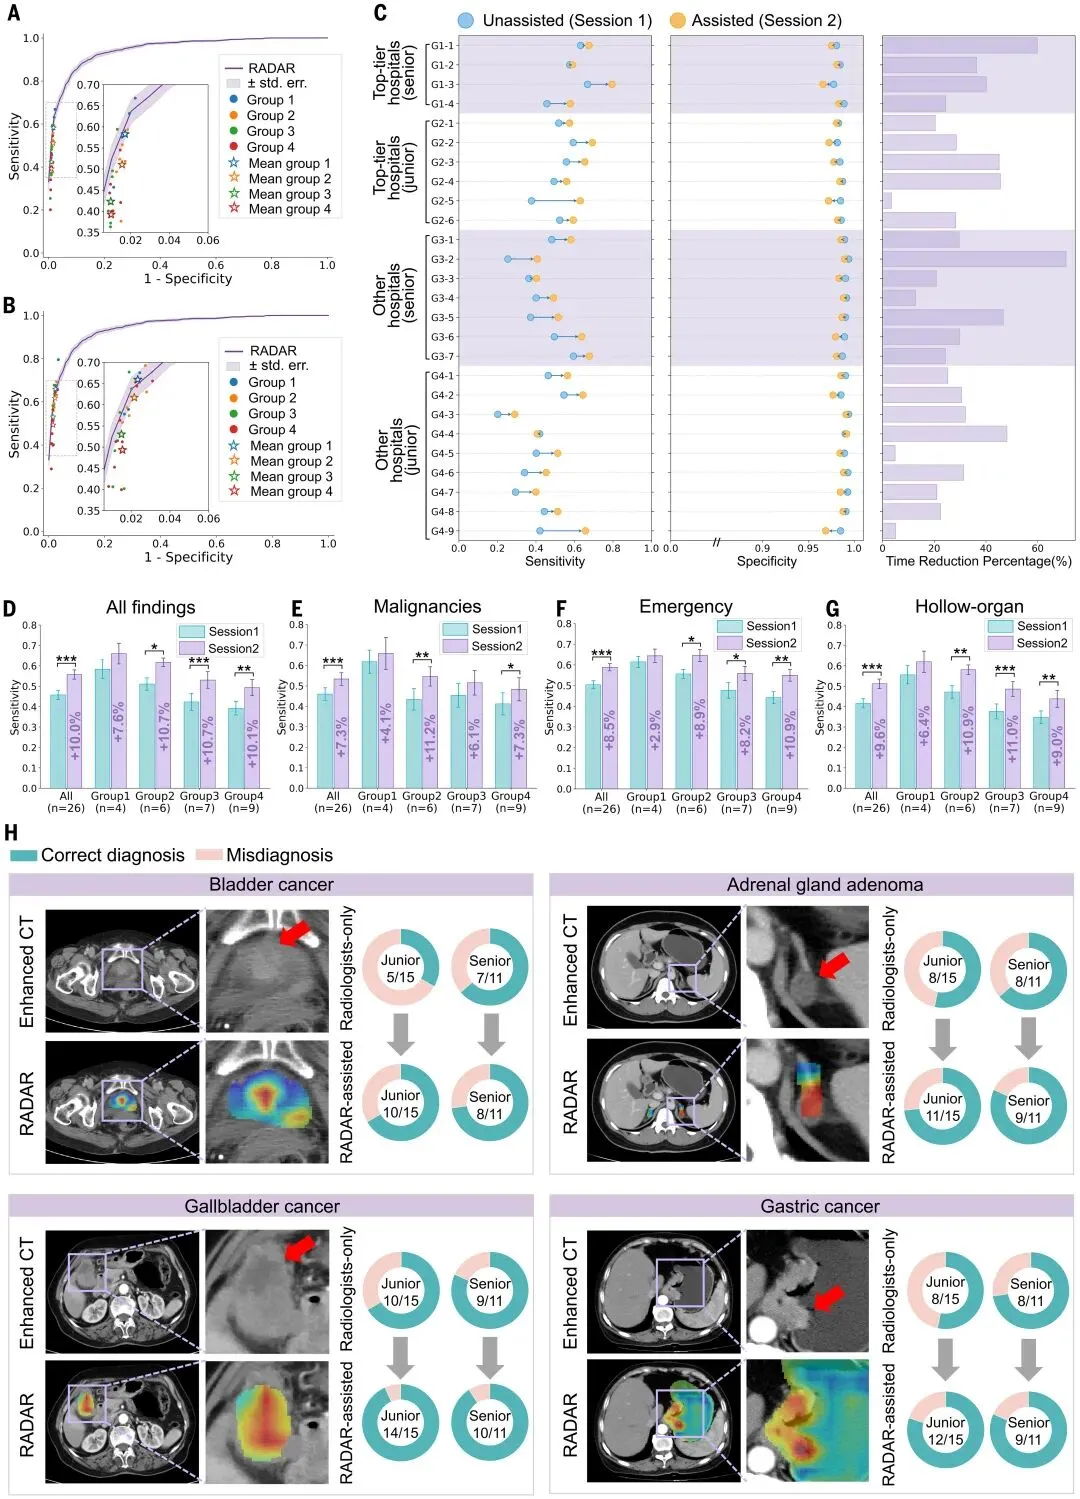
这项研究做了一个两阶段读者研究:26位来自14家机构的放射科医师,按经验(>10年 / ≤10年)和医院等级(三甲 / 其他)分成4组,先独立读片,间隔至少1个月"洗脱期"后,再在RADAR辅助下重读同一批病例。
读者研究实验结果(300例患者 · 61种征象 · 26位医师)
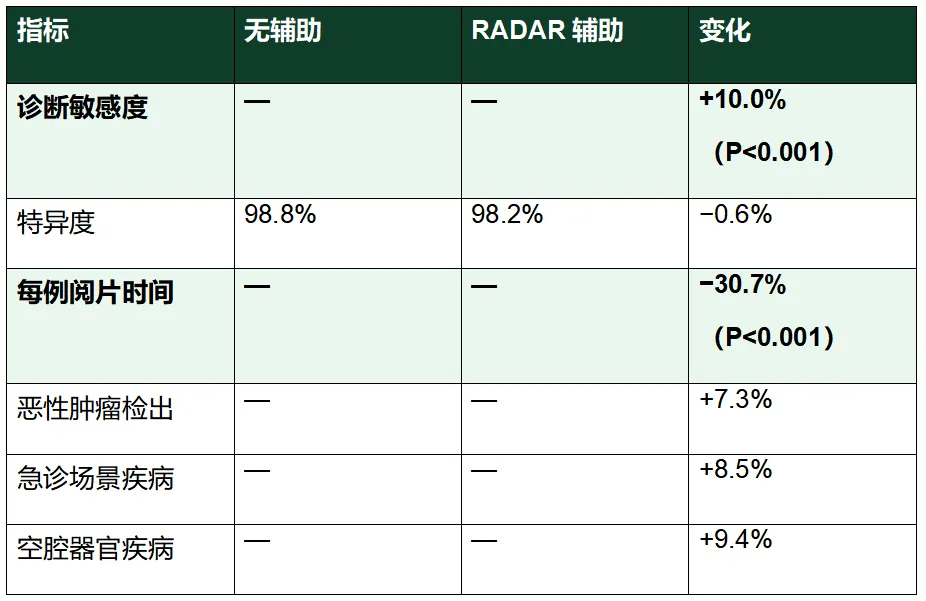
更值得注意的是"跨层级追赶"效应:
·三甲医院里,RADAR辅助下的初级医师,表现已经和无辅助的高级医师相当;
·其他医院里,初级医师在辅助下敏感度提升10.1%,反超同院无辅助的高级医师7.0%。
这意味着什么?AI不能替代经验,但它可能填平一部分经验鸿沟。对基层医院、对年轻医师、对急诊值班,这一点的价值远大于AUC上那零点零几的提升。
五、它的泛化能力,被单独考了三次
一项模型能不能用,关键看它离开训练环境后还灵不灵。这篇研究设计了三个"刁钻"的考场:
RADAR 的外部验证
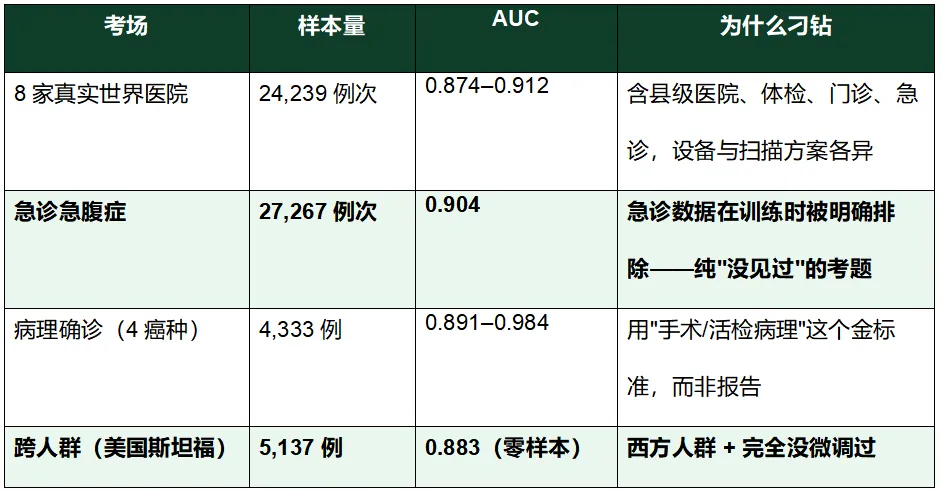
特别是第二行那个"急诊留出"设计——训练时刻意不给急诊数据,然后专门拿27,267例急诊病例来考,还能拿到0.904。
这比一般的"多中心验证"更有说服力:它证明模型不是在背答案。

六、这四个问题它还没解决
① 金标准问题,只是被绕过,没有被解决
模型用CT报告训练,评估时大部分用的也是"从报告里抽出来的标签"(146种征象里只有4种癌症有病理验证)。
报告是人写的,人也会漏诊——所以模型学到的,本质上是"报告里的判断",而不是"病理真相"。 0.891–0.984 的病理AUC很漂亮,但只覆盖4种癌症,剩下142种征象仍无金标准。
② 「平均AUC」是一个被平滑过的数字
论文报告内部AUC范围是 0.838–0.982,均值0.913。但作为临床医生,我更想知道的是:那些最要命的征象(小胰腺癌、早期腹膜转移、血管侵犯),单项表现到底如何?
论文正文没有给出。平均分很高,不代表每一项都好。
③ 「跨人群零样本」其实有落差
这一条容易被忽略:RADAR 在美国斯坦福数据上的零样本AUC是0.883,低于它内部队列的0.913、外部8家中心的0.895。
跨种族、跨设备、跨扫描协议的稳健性,仍然是通用模型最大的软肋,论文对此讨论偏轻。
④ 「可解释」目前还只是「看起来对」
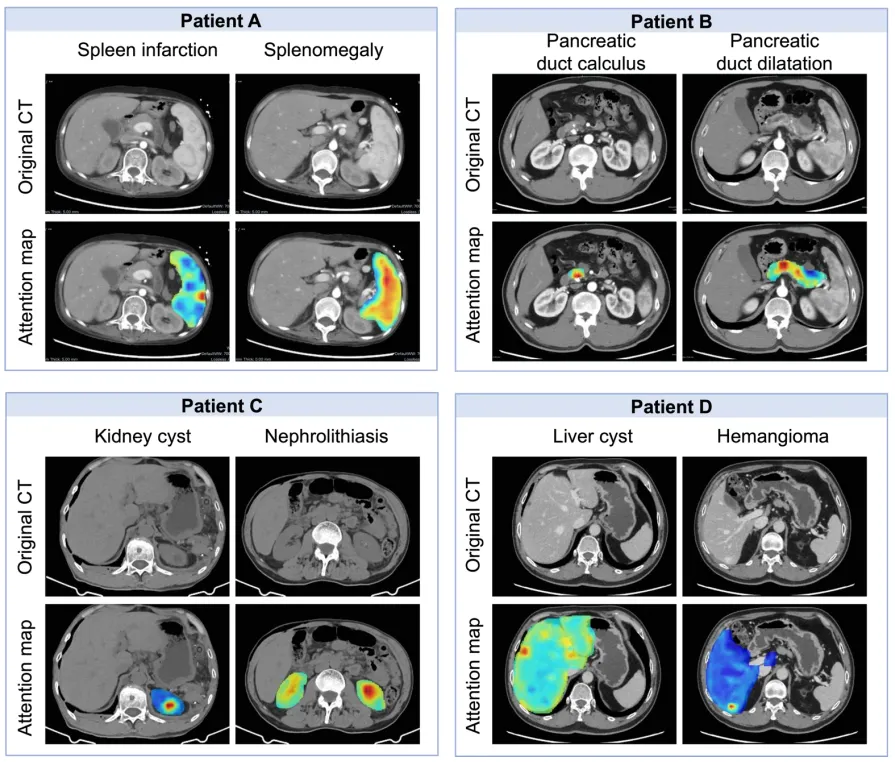
RADAR 会给出注意力热图(Grad-CAM),高亮它认为重要的区域。但在读者研究中,这部分只有"减少了误诊"的间接证据,缺乏定量的空间正确性评估——热图高亮的区域,究竟是不是真的病灶?没有量化验证。
此外论文也未涉及模型何时会出错(金属伪影?术后改变?罕见变异?),没有不确定性量化,也没有前瞻性临床验证。

七、所以,这对我们意味着什么?
抛开细节,这篇文章真正值得记住的,是三个判断:
1."标注瓶颈"正在被语言监督绕开。如果你的研究受困于标注量不足,一个可考虑的方向是:用报告文本做弱监督预训练,再用少量精细标注做微调。这条路在2026年已经被Science级别的工作验证过。
2.通用模型不一定输给专科模型。这是一个反直觉但重要的结论——RADAR在病理确诊队列上的表现(AUC 0.891–0.984),和最好的单病种专科模型在同一水平线上,甚至更好。
3."平均AUC"是陷阱。无论写论文还是审稿,都应关注低频、高危征象的单项性能,而不是被一个漂亮的均值掩盖了短板。

最后说一句实话
这篇文章质量高于典型的AI影像论文——公平重实现基线、急诊留出测试、病理金标准验证、跨种族零样本、配对读者研究,这套评估组合拳非常扎实。模型和代码也已开源(Zenodo 公开可访问),这一点对临床转化极其关键。
(开源地址:https://github.com/alibaba-damo-academy/damo-radar)
但它距离真正的临床落地,还隔着三道门:病理金标准的全面验证、不确定性量化与失败模式分析、以及前瞻性临床部署证据。

申明

本公众号所有内容仅供医学专业同道学术交流,不代表任何治疗建议和治疗选择!不代表任何单位的意见和建议!
Q. Zhang et al.An expert-level generalist AI for abdominal CT diagnosis, Science 393, eaec6129 (2026).