ARTICLE · 1088051
AI大模型连细菌都认不出,凭什么说自己是科学智能?
AI大模型连细菌都认不出,凭什么说自己是科学智能?把一张工业零件的X光图喂给GPT-4o,让它揪出缺陷。整体准确率74.9%,人类专家86.7%——看着差距不大?但镜头拉近,那些面积只占画面百分之几的小瑕疵,GPT-4V的召回率只有0.22。十个小缺陷,它漏掉将近八个。而专用检测器YOLO26-x-obb能做到0.852,是它的将近四倍。 到了生命科学领域,数字更难看。一项细胞形态学恶性检测评测里,最强的视觉大模型零样本F1只有0.057,基本等于闭眼瞎猜。植物显微图像里分辨寄主和病原菌,主流闭源开源VLM平均准确率约30%,只比抛硬币强一点。 
这就是今天大模型最拧巴的现实:宏观世界它像个通才,微观科学世界它几乎是个文盲。 先看看大模型在"宏观"上有多风光。 CLIP拿4亿图文对做零样本分类,SAM一刀下去切出10亿掩码,GPT-4o一发布就在21/22项评测上压过GPT-4 Turbo,MedQA零样本准确率从78.2%拉到89.4%。朋友圈里到处是"AGI要来了"的尖叫。 
可一旦把镜头从街景、猫狗、网页截图,换到显微镜、电镜、X光探伤片上,画风立刻变了。 Stanford在NeurIPS 2024发的Micro-Bench,覆盖24项生物和病理任务,横跨电子、荧光、光学三种显微镜。结论很扎心:不管是生物医学专用模型还是通用VLM,在所有类别上都"表现挣扎"——哪怕是"判断这张图是哪种显微镜拍的"这种最基础的题,它们都费劲。 
组织病理领域更割裂。PLOS Digital Health的一项评测里,大模型做文字类组织学评估能拿90.3%到92.0%,可一到真正的视觉判读,立刻掉到50.7%到80.1%。Gemini最好也就3.35/4.0,GPT-4o和Copilot只有2.76,Claude 2.55。 说白了:它读过万卷书,但从没真正"看过"切片。 ChatGPT和Gemini甚至搞不定标尺——没法把显微镜上的scale bar和物体真实尺寸对应起来,认不出细胞处于哪个分裂期。你往图里加点伪影,它性能就哗哗往下掉。 别以为这只是显微镜的问题。arXiv:2407.06581那篇《Vision language models are blind》直接开锤:让GPT-4o判断两个圆是相交、相切还是相离,它在所有模型里表现最差。连最基本的几何空间关系都看不准,你还指望它看懂一张灰度渐变的电镜图? 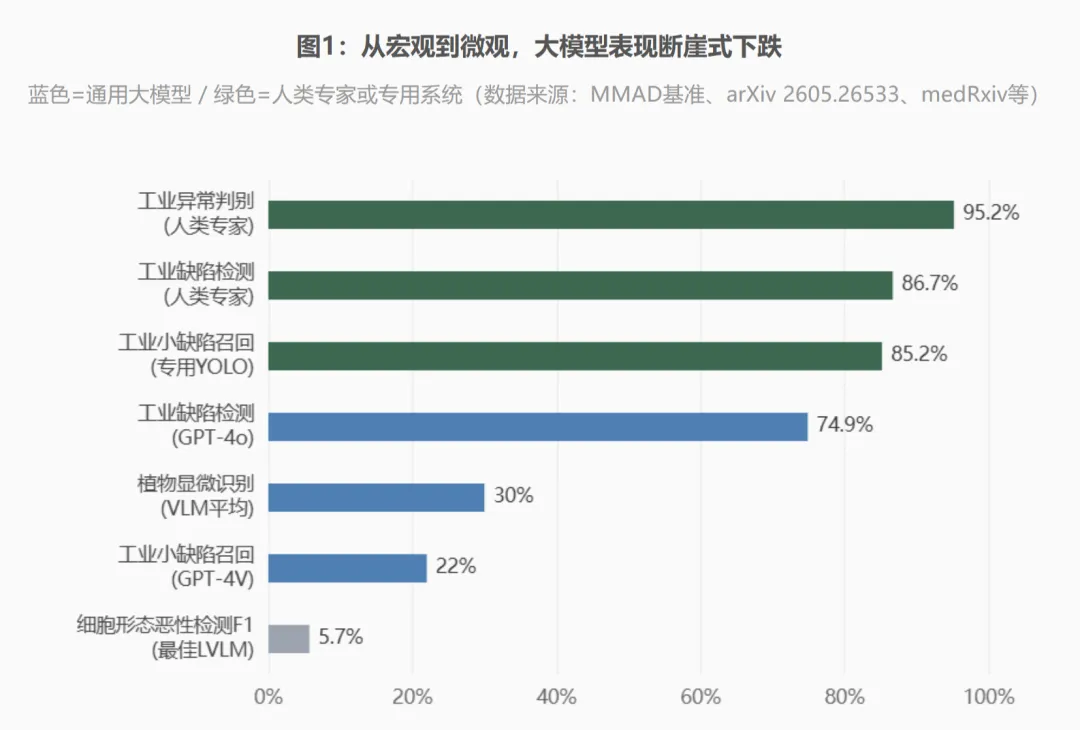
【图1:从宏观到微观,大模型表现断崖式下跌】 横向条形图,按数值排序:工业异常判别(人类专家)95.2%、工业缺陷检测(人类专家)86.7%、工业小缺陷召回(专用YOLO)85.2%、工业缺陷检测(GPT-4o)74.9%、植物显微识别(VLM平均)30%、工业小缺陷召回(GPT-4V)22%、细胞形态恶性检测F1(最佳LVLM)5.7%。蓝色为通用大模型,绿色为人类专家或专用系统。 大模型的能力是喂出来的。 ImageNet有1400万张图,LAION-5B有58亿。可真正的病理金标准数据集TCGA,只有大约18000张切片、32种癌种——差不多是ImageNet的0.13%。 就算是现在最猛的病理基础模型Virchow,用了150万张全切片,听着吓人?跟LAION-5B比,还是小了大约三个数量级。 更麻烦的是长尾。罕见恶性肿瘤占全部癌症的20%到25%,可PathPT基准覆盖56个罕见亚型,拢共才2910张切片。白血病数据集里AML原始粒细胞14066例,嗜碱性粒细胞只有1745例,8比1。 还有隐私这堵墙。HIPAA禁止未经授权二次使用健康数据,GDPR对健康数据罚款上限是全球营收的4%。一张病理切片理论上能反推患者身份,数据根本不敢像互联网图片那样随便爬。 数据不够,模型自然学不到微观世界的纹理规律。 很多人以为,科学图像就是"拍清楚一点的照片"。根本不是。 八家医院联合研究发现,同一种H&E染色,实验室内变异9%到12%,实验室之间最大中位数差异达到31%。就算你做了染色归一化,换个批次切片,深度学习模型照样泛化不动。 PLISM数据集覆盖46种组织、13种染色、13种成像设备。CONCH、Virchow这些在Aperio扫描仪上训得好好的,一换到Hamamatsu或3D-Histech的机器上,分类精度立刻掉下来。 还有更微妙的。七种常见致病菌在相衬显微镜下长得几乎一模一样,静态照片根本分不出来。必须靠微流控加单细胞延时成像,用视频模型追踪它的动态行为,才能做到98%以上的准确率。 你给大模型看一张静态电镜图,让它重建原子晶体结构。就算模板匹配对了,下游步骤照样有60.7%的失败率——其中40%是因为二维投影丢了z轴信息,20.7%是因为碳和氧这两种原子序数太接近,衬度根本分不开。 微观世界是三维的、动态的、跨设备不一致的。而大模型吃到的,是互联网上那些二维的、静态的、打了磨皮滤镜的照片。 互联网聊天说错一句话,顶多被人截图嘲笑。工厂产线和手术台上说错一句话,是要出事故的。 ChatGPT做START灾难分诊,99.7%的问题都能给出回答,但只有63.9%是对的。它几乎从不标注"我不确定"。 LLaMA-2生成的医疗摘要,平均每篇含2.60个幻觉;微调后降到1.55,GPT-4基线也有0.7个以上。Red-teaming测试里,它甚至会凭空编造影像发现,比如写一段"T12-L1 T2高信号"的MRI描述,压根没这回事。 JMIR 2024的一项研究更狠:ChatGPT 3.5和Bing生成的500条引用里,61.6%跟提问关键词压根不相关。 已经上市的医疗AI也一样。美联社2024年10月报道,Nabla的医疗录音转写AI会"invent things no one ever said"——把医生没说过的话编进去。还有LLM给孕妇推荐四环素治莱姆病,那是妊娠禁忌药。 大模型的商业模式是"流利地接话",科学的要求是"不确定就闭嘴"。这俩底层性格就是冲突的。 再加上工程现实:GPT-4V API平均响应4到6秒,网络一波动超过10秒。可产线节拍要求2秒以内。你总不能让传送带停下来等模型想明白吧。 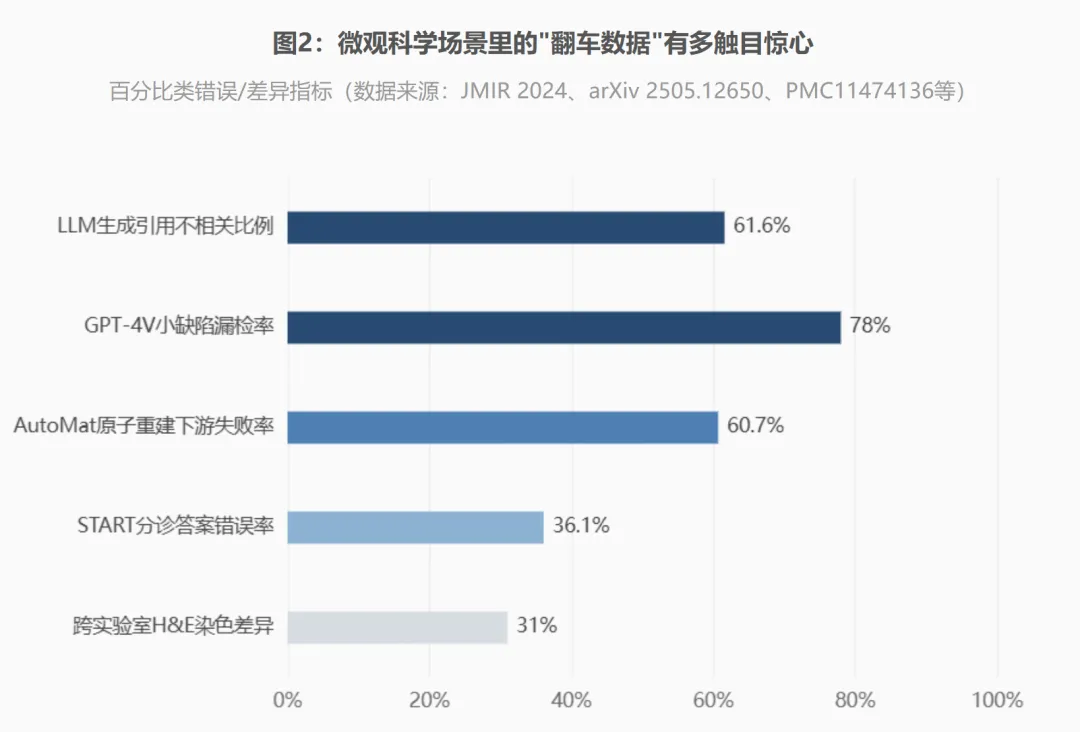
【图2:微观科学场景里的"翻车数据"】 横向条形图(百分比):LLM生成引用不相关比例61.6%、GPT-4V小缺陷漏检率78%、AutoMat原子重建下游失败率60.7%、START分诊答案错误率36.1%、跨实验室H&E染色差异31%。 真实数据拿不到,那就用生成模型自己造。 PixCell是第一个扩散式病理生成基础模型,用DiT架构在PanCan-30M上训练——3080万个1024×1024的patch,来自69184张真实H&E切片。扩散模型已经被用来给罕见病做数据增广、合成千兆像素切片、甚至做超分辨率和伪影校正。 His-MMDM更狠,用扩散模型把冷冻切片"翻译"成FFPE切片,做虚拟免疫组化染色,还能在驱动基因突变的条件下编辑病理图像。 物理仿真也在跟进。deltaMic是面向荧光显微镜的3D可微渲染器,OSOG把整个微光学环境做成了PyTorch原生的合成数据引擎,pySTED直接对超分辨显微的光漂白和PSF做物理级模拟。 造出来的数据跟真实成像的物理过程对齐,模型就不用再靠猜。 另一条路,是干脆别让通才模型上战场。 2023到2025年,病理视觉基础模型密集爆炸:UNI、Virchow、CONCH、Prov-GigaPath、Phikon-v2……综述统计已经有50多个,训练数据从3000张到150万张切片不等。 微软的GigaTIME更进了一步,把H&E病理切片"翻译"成虚拟的多色荧光图像,用4000万细胞配对数据训练,已经在51家医院14256名癌症患者身上落地。NVIDIA的VISTA-2D直接基于SAM,专门做细胞生物显微镜分析。 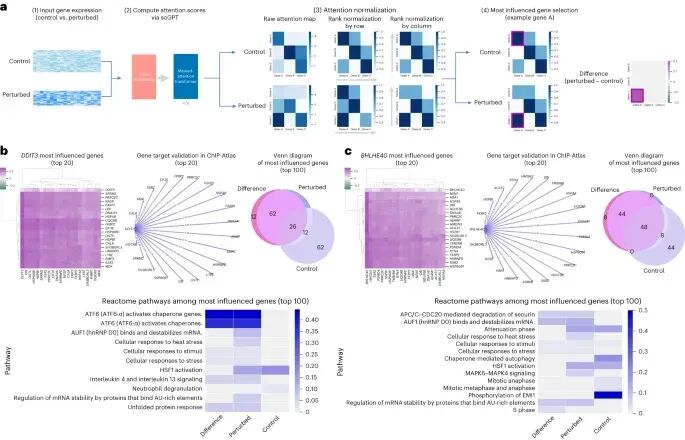
跨学科的也在冒头。IBM的MoLFormer在11亿条分子结构上预训练;scGPT在3300万人细胞上做生成式预训练;中科院2025年发布了"磐石·科学基础大模型",2026年WAIC又推出ScienceOne Omni。 AlphaFold 3把预测范围从蛋白质扩到DNA、RNA、配体和离子——虽然FoldBench显示抗体-抗原预测失败率仍超过50%,但2024年诺贝尔化学奖已经颁给了Hassabis和Jumper。 科学的问题,正在由科学数据自己解决。 最激进的一条路,是把模型塞进机器人,让它在物理世界里闭环。 Berkeley的A-Lab,联合Google DeepMind,把Materials Project、500万篇论文文本挖掘和ML主动学习串起来,机器人自己研磨、转移、烧结、做XRD。17天从58个目标里自主合成出41种新化合物,成功率约71%,日产新材料数大约是人工的100倍。 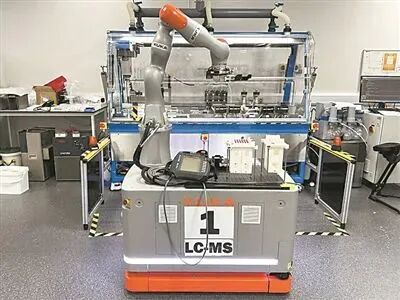
利物浦大学那个400公斤的移动机器人化学家,8天连轴转近21.5小时,完成了近700个催化实验,光催化活性比初始配方高6倍。2024年他们又升级成多机器人团队SYNTHESIS-BOT,在三个方向上达到人类同等水平但更快。 DeepMind的GNoME则用图神经网络加主动学习,发现了220万种新晶体结构,其中38.1万种预测为热力学稳定——让人类已知的稳定晶体数量直接扩大了近一个数量级,差不多相当于800年的知识积累。外部实验室已经独立合成了736种,稳定性预测成功率约80%。 CMU的Coscientist更绝,GPT-4和Claude当大脑,自己查文献、设计实验、调用机器人API,第一次由"非有机智能"自主完成了Suzuki、Sonogashira这些钯催化交叉偶联反应。 当模型不再只是"看图说话",而是能亲手做实验、看结果、再迭代,幻觉就被物理世界当场纠错了。 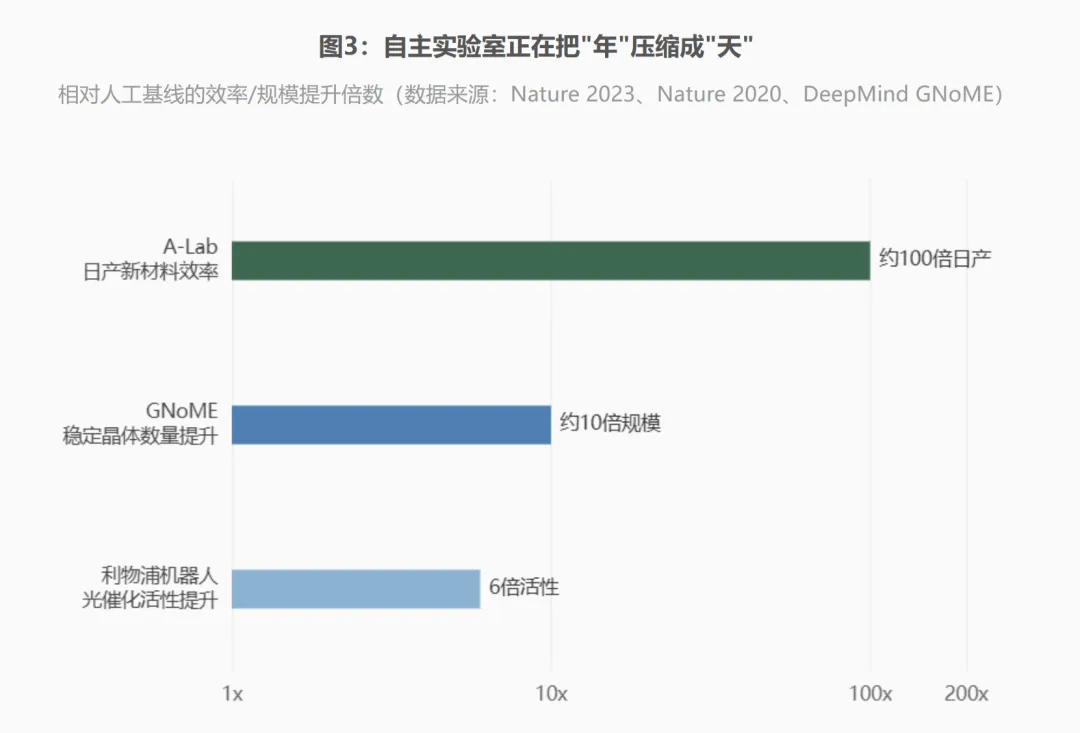
【图3:自主实验室正在把"年"压缩成"天"】 横向条形图(对数坐标,相对人工基线的倍数):A-Lab日产新材料约100倍、GNoME稳定晶体数量提升约10倍、利物浦机器人光催化活性提升6倍。 所以,实验室的科学智能还有多远? Stanford AI Index 2026第一次专门加了一章"AI across Scientific Domains"。这说明什么?说明整个领域都意识到:大模型在科学上的表现,已经值得单独立项追踪了。 但冷静看,今天的所谓"科学智能",更多是在孤立环节上破局——AlphaFold解决了蛋白质结构,GNoME筛出了晶体候选,A-Lab把它们做了出来。可从假设到实验到论文的完整闭环,还远没打通。 一篇2025年的综述《Foundation Models for Scientific Discovery》说得直白:现在的基础模型大多是"被动、孤立的环节",未来第一优先级,是把它们部署进实验室机器人和数字孪生环境,形成物理世界的闭环。 
会写诗、会画图、会聊天的大模型,已经很聪明了。但显微镜下那点尺度的世界,它还得从头学起。 当然,希望不是没有。Insilico Medicine的rentosertib——全球首个"AI发现靶点+AI设计分子"的特发性肺纤维化候选药,2026年已经宣布完成III期临床首例患者给药,计划在中国47家中心入组320人。这是科学智能在真实世界里最硬的一块试金石。 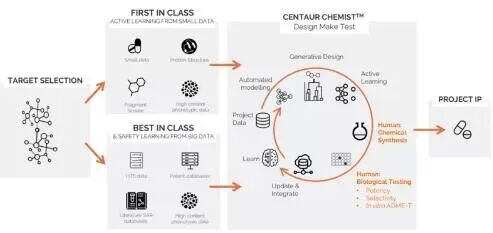
毕竟,科学智能的门槛从来不是"像人一样说话",而是"像人一样——甚至比人更严格地——面对证据"。 --- 转发给你身边做科研、搞工业质检、读医学院的朋友,说不定下次他就不会再把显微镜图直接丢给GPT了。
一、宏观封神,微观翻车
二、三个为什么
1. 数据:科学图像比互联网小了两三个数量级
2. 物理:显微镜下的世界,不只是"放大的图片"
3. 容错:工厂和医院,容不下一本正经地胡说
三、三条出路
1. 合成数据:喂不饱,就自己造
2. 科学基础模型:别再拿互联网模型硬扛
3. 具身实验室:别光看,上手做