ARTICLE · 1098510
Multica 的服务端源码:AI 任务分配,服务端根本没有这个组件
五张架构图,拆解一个生产级多智能体平台的任务主链路
最近把多智能体协作平台 Multica 的服务端源码通读了一遍,把「新建任务 → AI 分派 → agent 处理 → 执行完毕」这条主链画成了五张架构图。
最出乎意料的发现是:整个系统里,找不到一个专门负责「给 AI 分配任务」的组件。
先交代背景。在 Multica 上,人和 agent 用同一套任务看板协作:你把一个任务指派给 AI agent,它会认领、执行、回评论、改状态,像一位远程同事。
本文所有结论来自对服务端(Go 单体仓库)的源码实读。关键函数与代码位置都标在图上,文字只讲主线;图都可以点开放大看细节。
一、全景:六个平面串起一次任务的一生
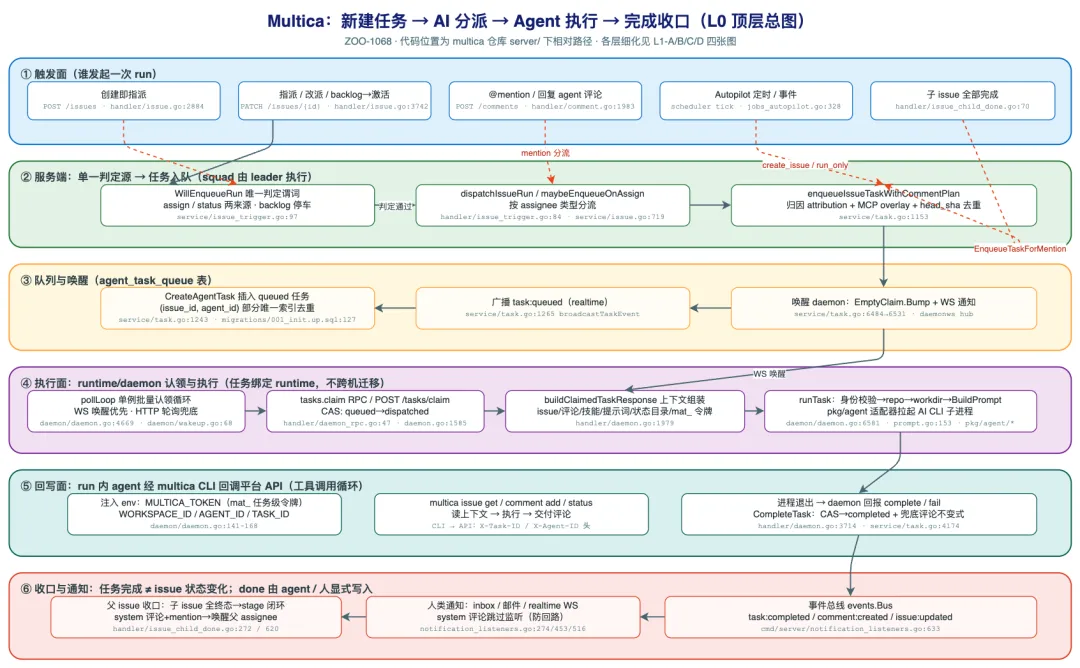
图 1|L0 总图:触发 → 判定 → 队列 → 执行 → 回写 → 收口
把总图从上往下读,就是一次任务的一生:
触发面:谁发起——创建即指派、改派、@mention、定时任务、子任务收口;
判定面:一个函数决定这次写入要不要启动 run;
队列与唤醒:往任务表插一行「排队中」,并唤醒对应的执行机;
执行面:执行机认领任务、组装上下文、拉起 AI CLI 子进程;
回写面:agent 用和人类完全相同的 API 写评论、改状态;
收口面:事件总线驱动通知,父子任务按阶段收口。
有三个设计选择,看懂了它们,后面的细节都好理解。
run 就是数据库里的一行。平台没有消息队列,也没有独立的调度服务。一次执行就是任务表里的一条记录,状态机直接建在表上。
服务器不推任务,只发「有活干」。真正取货的是执行机自己批量认领。任务绑定在具体机器上,不跨机迁移——你的代码永远在你自己的机器上跑。
agent 用人类的接口交付结果。run 里的 agent 写评论、改状态,调用的是和你手动操作完全相同的一组 API,权限来自认领时签发的任务级令牌。平台对「自己人」没有任何特权通道。
二、分派:七条入口,一个汇点
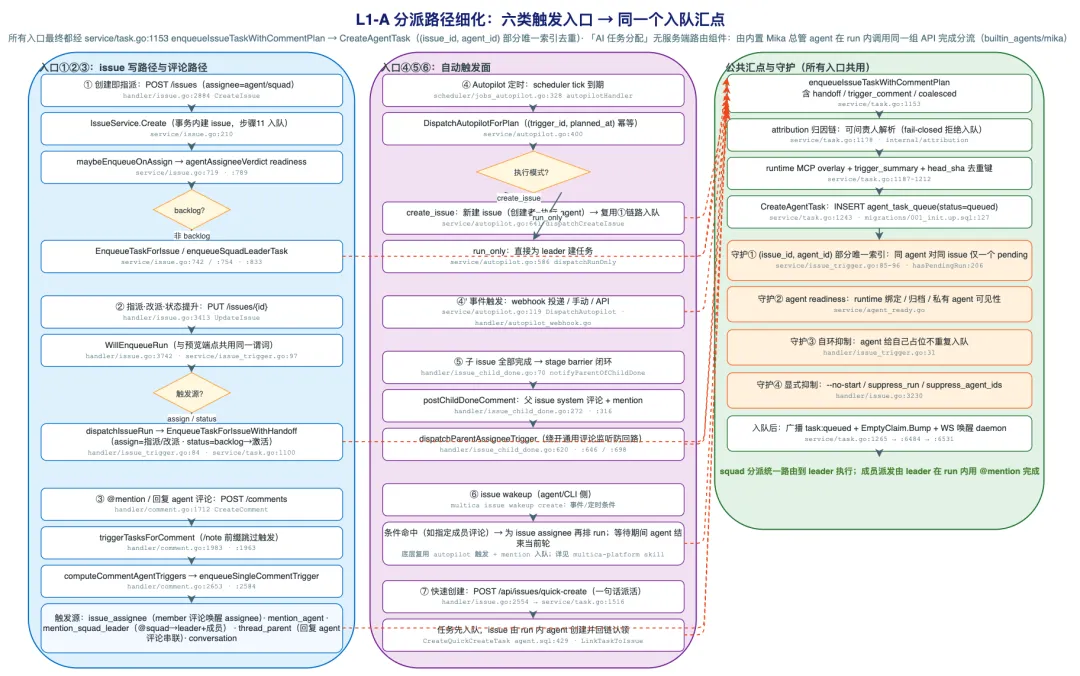
图 2|L1-A:七条触发入口,汇入同一个入队函数
下一个问题:哪些动作会让一个 agent 开始干活?
答案一共七条入口:创建时直接指派、后续改派、评论区 @mention、定时自动触发、子任务全部完成、wakeup 唤醒、一句话快速建任务。
有意思的是形状:七条入口最终都汇进同一个入队函数(CreateAgentTask)。去重、守护、限流,全部集中在这一个门口做。
至于「这次写入要不要触发 run」,全平台只有一个函数说了算:WillEnqueueRun。它同时服务预览和写入两条路径。
所以界面上「将启动 N 个 run」的提示,永远不会和实际行为不一致。判定逻辑只写了一份,预览和现实不会漂移。
三、「AI 分配」的真相
这是整次阅读里最颠覆我预期的部分。
我原以为「AI 任务分配」会是服务端的一个组件:任务进来,模型打个分,路由给最合适的 agent。把服务端翻了个遍,没有这个东西。
实际做法是:内置的总管 agent 作为一次普通 run 被触发。它在 run 里阅读任务,然后调用与人类相同的 API 完成分流:建子任务、改指派、@mention 成员。全部路由逻辑,住在它的提示词文件里。
服务器只提供机制(第二节的七条入口),策略完全外包给模型。平台把「智能」放到了执行面,判定面保持机械。
团队协作也一样:派给一个 squad 的任务只入队队长,队长再用 @mention 给成员派活。多智能体协作复用的就是评论这条原语,没有私有协议。
四、run 内部:认领、装货、执行
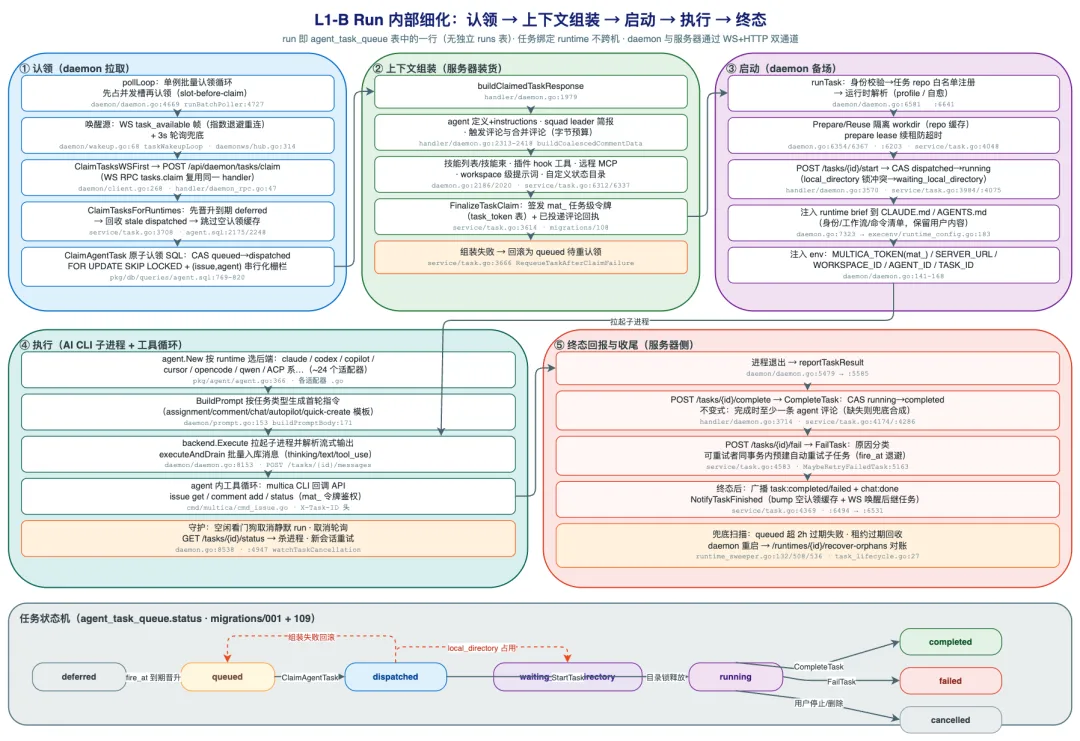
图 3|L1-B:一次 run 的内部——认领、上下文组装、执行与终态
一次 run 的内部可以拆成三段。
第一段,认领。执行机先占本地并发槽,再向服务器要货,保证认领的任务本地一定有容量跑。
认领走 WebSocket 和 HTTP 轮询双通道,服务端是一条 FOR UPDATE SKIP LOCKED原子 SQL,两台机器永远不会抢到同一个任务。
这里有个我读源码时特意核了的细节:服务器为每台执行机维护一份「空认领」缓存,新任务入队时,必须先让缓存失效、再发唤醒。
这个顺序写死在代码注释里。反过来写,唤醒驱动的认领会读到过期的「没活」结论,任务就卡在那了。
第二段,装货。认领应答把这次 run 需要的一切打包:agent 定义、触发评论、技能列表、插件工具,还有一枚任务级令牌。
daemon 拿到后渲染首轮指令,并把 agent 身份、工作流、可用命令清单写进工作目录的 CLAUDE.md,用户已有的内容按字节保留。
上下文工程因此发生在两层:服务器决定装什么货,daemon 决定怎么摆盘。
第三段,执行。按 runtime 选择后端,claude、codex、copilot 等共 20 多个适配器,各自负责拉起对应的 CLI 子进程并解析输出。
安全模型在这步落地:子进程环境里只拿得到一枚任务级令牌,后续所有 API 调用的身份都从它推导,客户端伪造不了。
执行结束有两条硬保证。
完成不变式:一个完成的任务必须至少留下一条 agent 评论。agent 全程没说话时,服务器会把最终输出合成为兜底评论,用户永远看得到交付物。
失败自动重试:可重试的失败在同一个事务里预建好退避重试;无人认领的「进行中」任务会被回滚回待办。失败不会把看板留在假状态上。
五、收口:解耦、屏障、通知
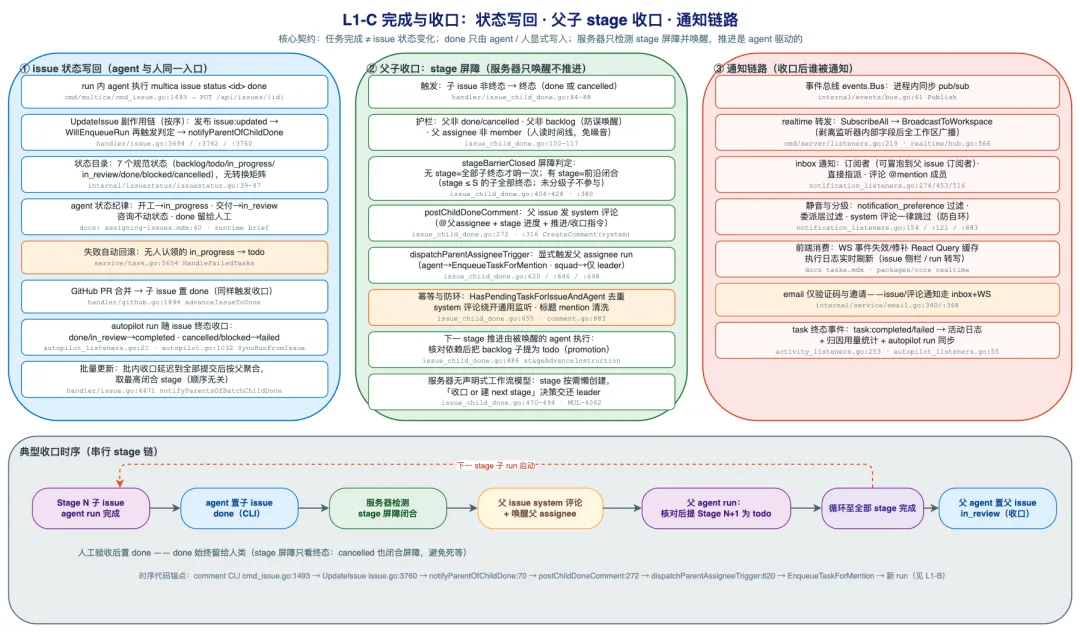
图 4|L1-C:状态回写、stage 屏障收口、通知链路
任务跑完,系统怎么收口?先记住一条解耦契约:任务完成,不自动改任务单状态。
任务单的状态,是 agent(或人)对「工作进展到哪」的显式判断:开工置进行中,交付置待验收,完成留给人验收。agent 和人走同一个状态入口,所有副作用完全一致。
父子任务收口是全链路最有「编排感」的部分,但服务器依然克制地只做两件事。
一是检测屏障闭合:子任务进入终态时,判断它所在的那一级是否全部收口。被取消的子任务也算终态,一个死任务不会把整级拖死。
二是唤醒父任务:在父任务下发一条系统评论,并显式入队父任务的负责人。
「推进下一级」这个动作本身,是被唤醒的 agent 干的:核对依赖、把停车场里的子任务提出来、开工。服务器没有声明式工作流模型,编排决策也交还给 agent。
通知面出乎意料地安静:站内收件箱加实时推送,没有任务邮件——邮件只用于验证码和邀请。
六、七个状态与一张速查表
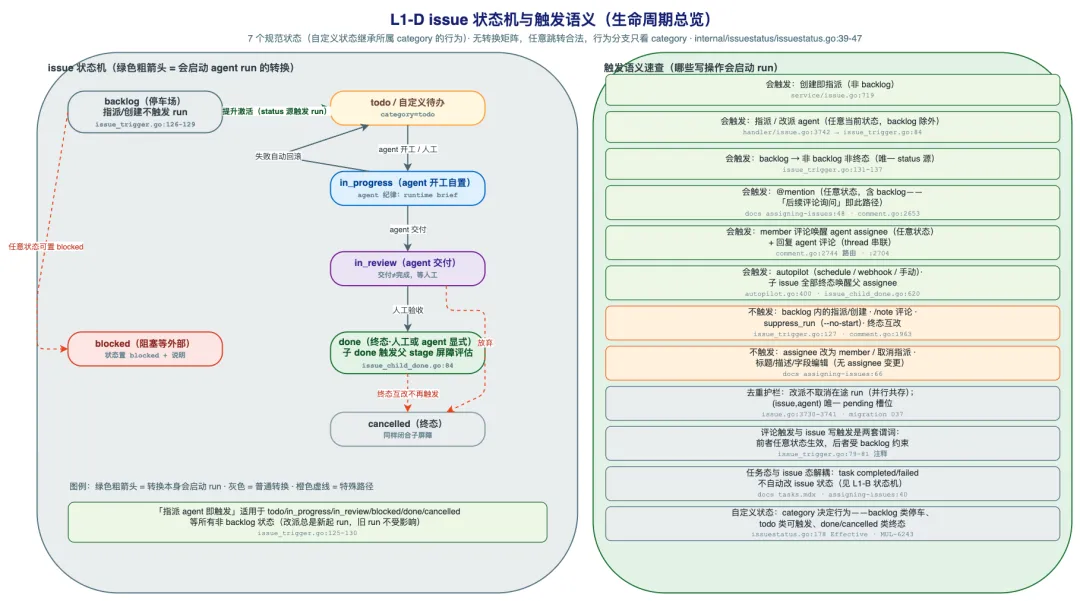
图 5|L1-D:issue 状态机与「会/不会启动 run」速查表
issue 只有 7 个规范状态,而且没有转换矩阵:任意跳转都合法,所有行为分支只看状态属于哪个类别。自定义状态因此天然兼容。
哪些操作会启动 run?速查表里三条边界最实用:
backlog 是「停车场」:里面的任何写操作都不触发,但评论和 @mention 任意状态生效。先停进停车场、用评论追问,是产品设计出来的正规用法;
已完成任务上改派,仍然触发:把旧任务重新交给 agent,是合法流;
改派给人类、取消指派、纯改字段都不触发:只有负责人变成「可执行的 agent」才是触发事件。
七、四点观察与代价
把五张图叠起来看,这套系统有四条一以贯之的设计选择。
判定收窄到单点。触发判定一个函数、入队一个汇点,换来预览等于实际、改一处全链生效,去重和守护也集中在正确的位置。
控制面极简,智能面外置。服务器只做机制:队列、守护、唤醒、记账。路由给谁、怎么拆解、何时收口,全部住在提示词里,平台因此天然容纳异构模型和 20 多种 CLI。
可靠性靠数据库原语,不靠框架。幂等交给唯一索引,并发交给 CAS 和 SKIP LOCKED,自愈交给 TTL 加对账扫描。每一层失败都有明确的所有者。
同构回写是关键杠杆。agent 和人用同一套 API 协作,评论、@mention、状态机对人机无差别,多智能体协作不过是这些原语的递归复用。
也要说代价。路由逻辑住在提示词里,分配质量的上限就是模型表现,出了问题只能去翻 run 的执行转写排查;两个核心函数承受着全系统最高的注释密度,它们是契约所在地,也是改动时最需要小心的地方。
对正在转向 AI agent 开发的工程师,这次阅读给我最大的确认是:生产级 agent 平台的难点不在「调模型」,而在触发的一致性、执行的可靠性、权限的收敛与失败的自愈。
这些恰好是传统后端工程能力的延伸。你原来攒下的功夫,在这里全都用得上。
留个讨论题:如果你也在做 agent 系统,你会把「智能」放在判定面还是执行面?留言聊聊。
— END —