ARTICLE · 1112721
poll 源码分析(五):从内核返回用户态-中
上篇走完了系统调用从内核返回用户态的完整流程,但留了 do_signal() 这个函数未分析。现在就来会会它。
本来以为一篇就能写完剩下的内容,但写到后面发现篇幅越来越长。文章越长,越没有耐心看完。所以决定将整个流程分成上中下三个部分。
本文属于中篇,会分析除了 handle_signal() 以外 do_signal() 的所有细节。下篇则专门分析 handle_signal()。
本文基于 Linux 4.4.126 版本的源码,只分析 ARM64 平台上的流程。
1. 总览
为了更丝滑地和上篇衔接上,把 do_notify_resume() 再次贴出来:
asmlinkage voiddo_notify_resume(struct pt_regs *regs,unsigned int thread_flags){if (thread_flags & _TIF_SIGPENDING)do_signal(regs);...}
_TIF_SIGPENDING 标志在上篇已经详细介绍过,表示有信号待处理。do_signal() 就是信号处理的总入口。
不同的平台架构都有自己的 do_signal() 实现,ARM64 平台上的 do_signal() 在 arch/arm64/kernel/signal.c:
staticvoiddo_signal(struct pt_regs *regs){unsigned long continue_addr = 0, restart_addr = 0;int retval = 0;int syscall = (int)regs->syscallno;struct ksignal ksig;/** If we were from a system call, check for system call restarting...*/if (syscall >= 0) {continue_addr = regs->pc;restart_addr = continue_addr - (compat_thumb_mode(regs) ? 2 : 4);retval = regs->regs[0];/** Avoid additional syscall restarting via ret_to_user.*/regs->syscallno = ~0UL;/** Prepare for system call restart. We do this here so that a* debugger will see the already changed PC.*/switch (retval) {case -ERESTARTNOHAND:case -ERESTARTSYS:case -ERESTARTNOINTR:case -ERESTART_RESTARTBLOCK:regs->regs[0] = regs->orig_x0;regs->pc = restart_addr;break;}}/** Get the signal to deliver. When running under ptrace, at this point* the debugger may change all of our registers.*/if (get_signal(&ksig)) {/** Depending on the signal settings, we may need to revert the* decision to restart the system call, but skip this if a* debugger has chosen to restart at a different PC.*/if (regs->pc == restart_addr &&(retval == -ERESTARTNOHAND ||retval == -ERESTART_RESTARTBLOCK ||(retval == -ERESTARTSYS &&!(ksig.ka.sa.sa_flags & SA_RESTART)))) {regs->regs[0] = -EINTR;regs->pc = continue_addr;}handle_signal(&ksig, regs);return;}/** Handle restarting a different system call. As above, if a debugger* has chosen to restart at a different PC, ignore the restart.*/if (syscall >= 0 && regs->pc == restart_addr) {if (retval == -ERESTART_RESTARTBLOCK)setup_restart_syscall(regs);user_rewind_single_step(current);}restore_saved_sigmask();}
速览一遍可以发现,整个函数主要由三个 if 块组成。
三个 if 分别在第 11、40、63 行。注意,第 2 个 if 的最后是 return 语句,说明第 2 个 if 和第 3 个 if 是互斥的。
在开始分析代码之前,有必要先明确一下此刻的状态。
还是沿用之前的 SIGUSR1 的例子:
用户程序用 sys_ppoll 临时放开了 SIGUSR1,并为 SIGUSR1 注册了 handler SIGUSR1 到来,do_sys_poll() 返回 -EINTR,sys_ppoll() 把它改成 -ERESTARTNOHAND sys_ppoll() 把旧掩码存进 saved_sigmask,并置上 TIF_RESTORE_SIGMASK
各个字段的状态如下:
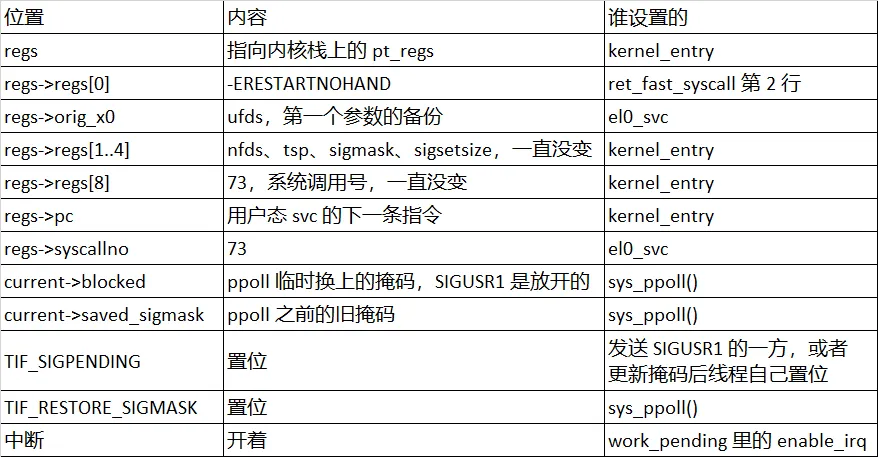
第 3 行的 regs->regs[0] 是 sys_ppoll() 的返回值,在 poll 源码分析(四)里留了好几个关于它的问题,本文将逐一解答。
为什么要把返回值从 -EINTR 改成 -ERESTARTNOHAND? 那么多 ERESTART 开头的错误码,为什么一定是 ERESTARTNOHAND? 这四个 ERESTART 开头的错误码分别是什么含义?它们有什么区别?
第 4 行的 regs->orig_x0 在上篇已经分析过,在 do_signal() 里它将被派上大用场。
倒数第 2 行的 TIF_RESTORE_SIGMASK 在 poll 源码分析(四)里也介绍过,涉及旧掩码的恢复,最终也会收敛在 do_signal() 里。
2. 预设重启
第一个 if 块:
/** If we were from a system call, check for system call restarting...*/if (syscall >= 0) {continue_addr = regs->pc;restart_addr = continue_addr - (compat_thumb_mode(regs) ? 2 : 4);retval = regs->regs[0];/** Avoid additional syscall restarting via ret_to_user.*/regs->syscallno = ~0UL;/** Prepare for system call restart. We do this here so that a* debugger will see the already changed PC.*/switch (retval) {case -ERESTARTNOHAND:case -ERESTARTSYS:case -ERESTARTNOINTR:case -ERESTART_RESTARTBLOCK:regs->regs[0] = regs->orig_x0;regs->pc = restart_addr;break;}}
根据这里的三个注释,大概也能猜到这段代码是在给系统调用重启(system call restart)做准备。
第 1 - 3 行:注释。如果代码流程上是从系统调用走到了这里,那么就要为系统调用重启做一些检查。
第 4 行:临时变量 syscall 在定义时就被初始化为 regs->syscallno,也就是 73,if 判断成立。
第 5 行:continue_addr 也是一个临时变量。注意,此时 regs->pc 指向的是用户态 svc 的下一条指令。再根据变量名,可知这个变量保存的是原本返回用户态后要继续执行的第一条指令。
第 6 行:compat Thumb 模式的指令宽度是 2 字节,AArch64 为 4 字节。所以这条语句的意图是将 PC 值往回拨一个指令宽度,也就是指向 svc 本身。
compat_thumb_mode() 是个宏,本质上是检查 regs->pstate 字段的 COMPAT_PSR_T_BIT 位。
从这里依稀可以推知,所谓重启系统调用,也就是再执行一次 svc 指令,然后再次陷入内核态,根据系统调用号找到对应的系统调用函数。
第 7 行:用 retval 保存返回值,因为接下来 regs->regs[0] 马上要被覆盖。
第 9 - 12 行:把 regs->syscallno 赋值为 -1。注释说是为了避免额外的、通过 ret_to_user 过来的系统调用重启。
字面意思不难理解,regs->syscallno 为 -1 后,这个 if 就不再成立,整个代码块都不会再执行。也就是不再给系统调用重启做准备。
可是,为什么呢?
这得从 do_signal() 的调用场景说起。
上篇讲过 work_pending 的循环。do_notify_resume() 返回后回到 ret_to_user 重新检查标志,TIF_SIGPENDING 还置位就再进 do_signal()。也就是说,do_signal() 有可能在短时间内被调用不止一次。
第一次调用 do_signal() 时,regs->regs[0] 里装的是 sys_ppoll() 的返回值,regs->pc 则是用户态 svc 的下一条指令。整个 if 代码块就是基于这个前提来实现的。
等到第二次调用 do_signal() 时,如果 if 代码块再跑一遍,那它还是按照上面的前提来执行。
问题是,第二次调用 do_signal() 时,regs->regs[0] 早已不是返回值,regs->pc 也不是 svc 的下一条指令了。此时如果还是把它们当成返回值和返回地址来处理,那代码逻辑就会出大问题。
根据目标处理信号是否有信号处理函数 handler,这两个字段的值也会有所不同:
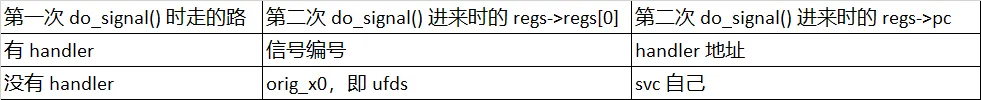
这里先不用管这些值是怎么来的,只需要知道第二次 do_signal() 时 regs->regs[0] 和 regs->pc 的值已经变得面目全非。
所以,这个 if 代码块只有在第一次进 do_signal() 时才需要执行,后面从 ret_to_user 循环再次进 do_signal() 时都需要跳过。
这也不难理解,第一次调用 do_signal() 时,重启所需的函数参数、PC 指针等已经准备好了,只等回到用户态恢复现场后就能立刻再次执行 svc 指令。只不过还没等回用户态就来了一点小插曲,需要再次执行 do_signal(),既然第一次调用时已经准备了,那这一次的调用就没必要再去准备了。
为什么赋值为 ~0UL
这是代码设计之初就约定好的。
poll 源码分析(三)里分析过,kernel_entry 给 syscallno 的默认值就是 ~0UL,表示这次进内核不是系统调用,只有 el0_svc 确认是 svc 之后才填真正的系统调用号。
另外,读 syscallno 的并不只有 do_signal(),ptrace 机制也会依赖这个字段。比如 syscall_get_nr() 直接返回它,调试器据此判断线程是否停在一次系统调用里。
第 14 - 26 行:如果返回值命中了这几个 case,那么就更新 regs->regs[0] 和 regs->pc。
代码本身很好理解,但背后的实现逻辑值得深入分析。两个问题需要搞清楚:
注释写的是这段代码在为系统调用的重启做准备,为什么更新栈上的两个字段就算是为重启做好了准备? 这四个以 ERESTART 开头的错误码分别是什么含义?它们有什么区别?
先来看第一个问题。
前面说过,所谓的重启系统调用,就是把 PC 指针拨回 svc 指令,之后 svc 自然会触发同步异常陷入内核态。注意,寄存器 x8 一直没变过,是第一次 svc 前用户态准备好的 73。这里再次陷入内核态,内核根据 73 便能再次找到 sys_ppoll(),这样就完成了系统调用的再次调用。
不要忘了,在调用 sys_ppoll() 之前,还要准备好它需要的函数参数,也就是 x0 - x4 这 5 个寄存器。x1 - x4 一直没变,唯独 x0 需要更新。第 23 行的 regs->regs[0] = regs->orig_x0; 就是在准备 ufds 指针,即 sys_ppoll() 的第一个参数。
等等,你这不都是在更新内核栈上的 pt_regs 字段吗?怎么就突然又去执行 svc 指令了?
如果待处理的目标信号并没有 handler,那 do_signal() 将直接恢复旧掩码,然后就返回了。
还记得之后的流程吗?没错,如果没有标志位再置位,那么 ret_to_user 里将直接走到 kernel_exit 0 返回用户态了。
还记得 kernel_exit 0 做了什么吗?没错,就是根据内核栈上的 pt_regs 恢复现场,然后返回用户态。
eret 时,x0 - x4 就是 sys_ppoll() 的五个参数,x8 装的是系统调用号,PC 寄存器则指向 svc 指令。之后返回用户态,程序立刻再次执行 svc 陷入内核态。
一路分析下来,对于重启系统调用,也就只有 regs->regs[0] 和 regs->pc 需要更新。
再来看第二个问题。
这四个错误码定义在 include/linux/errno.h:
/** These should never be seen by user programs. To return one of ERESTART** codes, signal_pending() MUST be set. Note that ptrace can observe these* at syscall exit tracing, but they will never be left for the debugged user* process to see.*/#define ERESTARTSYS 512#define ERESTARTNOINTR 513#define ERESTARTNOHAND 514 /* restart if no handler.. */#define ENOIOCTLCMD 515 /* No ioctl command */#define ERESTART_RESTARTBLOCK 516 /* restart by calling sys_restart_syscall */
中间的 ENOIOCTLCMD 和重启无关,不用管它。
注释有两点要关注:
这几个错误码用户空间永远看不到。 返回这几个错误码的时候 signal_pending() 必须为真。
第一点没什么好说的,代码设计之初就是这么约定的。
第二点,也就是要求 TIF_SIGPENDING 标志位是置位状态。这也比较好理解,返回路径只有在 TIF_SIGPENDING 置位时才会进 do_signal(),而处理这几个错误码的正是 do_signal()。
ERESTART 错误码本质上是一个系统调用被信号打断后给 do_signal() 提的重启需求
一个系统调用被信号打断,它自己只知道两件事:我被打断了,我活还没干完。它不知道打断它的信号有没有信号处理函数,因为取信号、查 handler 这些事都是在返回路径上的 do_signal() 里处理的。
不同的系统调用,在面对被信号打断时的诉求都不一样。有的要求不管怎样都要重新调用一次它,有的把是否重新调用的决定权交给用户,有的则要求只有在没有 handler 的时候才重启。
但最终用户程序只会收到 EINTR,表示当前系统调用被信号打断了。至于系统调用有没有重启这样的细节,内核并不会告知用户程序,用户程序也不用关心。
所以,系统调用期间被信号中断的这个场景下,角色分工是这样的:
系统调用只负责上报自己的需求。 随后的 do_signal() 根据不同的需求来决定是否重启系统调用,以及如何重启。do_signal() 还负责错误码的转换,确保用户程序只会收到 EINTR 的返回值。
现在再来解释这四个错误码就比较好理解了:
ERESTARTNOINTR,no interrupt。不管信号有没有 handler,一律重启。
典型的例子是 fork 系统调用。fork() 里的 copy_process() 如果在复制过程中被信号中断,就会把已经复制的部分全部撤销,然后返回 -ERESTARTNOINTR。
POSIX 规定 fork 没有 EINTR 这种失败方式,所以内核只能自己重来,等 handler 跑完(如果有)再从头执行一遍。
ERESTARTSYS,最常见的一个,SYS 可以理解为系统调用的默认行为。
没有 handler 就重启;有 handler 就看用户在 sigaction() 里有没有设置 SA_RESTART。设了就重启,没设就返回 -EINTR。
也就是说把重启的决定权交给了用户。管道和终端的阻塞读写、大部分会睡眠的系统调用都是用的它。
如果用户设置了 SA_RESTART 标志,就相当于告诉内核:我不希望我的 handler 打断正在进行的系统调用。这样,如果线程在系统调用期间收到了信号,内核也不会转而去处理信号,而是重启系统调用,让系统调用优先干完自己的活。
注意,在内核态,系统调用还是被信号中断返回了。
只不过在返回用户态的时候,内核并不会去处理这个信号,而是强制再次调用一次系统调用。只要系统调用在内核态是因信号而返回,那么就会一直重启下去,直到返回原因非信号引起。
整个过程对用户态而言是无感的,因为刚回用户态就立刻执行 svc 再次陷入内核态了,所以从用户程序的视角来看,系统调用并没有被信号中断。
ERESTARTNOHAND,no handler。没有 handler 才重启;只要有 handler,不管 SA_RESTART 有没有设,一律返回 -EINTR。
POSIX 规定 pselect/ppoll 被有 handler 的信号打断时必须返回 -EINTR。如果改用 ERESTARTSYS,一旦用户程序给信号设了 SA_RESTART,跑完 handler 内核就会自动重启 ppoll,用户程序永远拿不到 -EINTR,这样就违反了 POSIX 语义。
ERESTART_RESTARTBLOCK,语义和 NOHAND 一样,区别在重启的方式上。
前面三个错误码的重启都是刚才第一个问题里说的那个套路:PC 拨回 svc,x0 换回 orig_x0,让 CPU 再执行一遍 svc。
而这个错误码的重启则有点迂回,用的是回调的方式。这个方式依赖 restart_block 这个结构体,这也是这个错误码名字的由来。至于为什么是回调的方式,等分析第三个 if 块时再来详细解释,放在那里更合适。
汇总一下
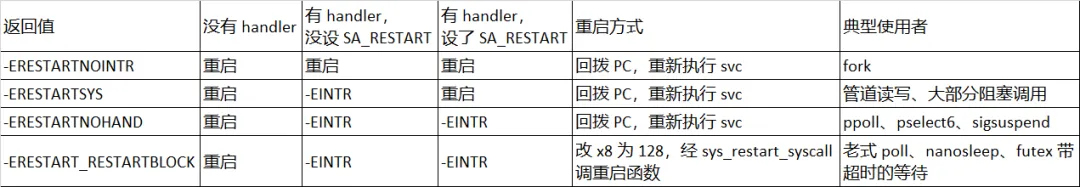
现在可以尝试回答总览里提到的三个问题中剩下的另外两个了:
为什么要把返回值从 -EINTR 改成 -ERESTARTNOHAND?
答:改成 -ERESTARTNOHAND 是在给 do_signal() 传递 ppoll 的需求,do_signal() 只有根据这个返回值才能保证 ppoll 的语义要求。即没有 handler 就重启,有 handler 就执行完后返回 -EINTR 给用户程序。
那么多 ERESTART 开头的错误码,为什么一定是 ERESTARTNOHAND?
答:还是由于 POSIX 对 ppoll 的语义要求。正是为了满足这个语义,内核开发者才创造了这个错误码并在代码层面实现了它。此外,看一眼上面对每个错误码的解释,用排除法也能锁定只能用 ERESTARTNOHAND。
等分析完了第二个 if 块,各位道友对这四个错误码将会有更深的理解。
3. 处理信号
第二个 if 块:
/** Get the signal to deliver. When running under ptrace, at this point* the debugger may change all of our registers.*/if (get_signal(&ksig)) {/** Depending on the signal settings, we may need to revert the* decision to restart the system call, but skip this if a* debugger has chosen to restart at a different PC.*/if (regs->pc == restart_addr &&(retval == -ERESTARTNOHAND ||retval == -ERESTART_RESTARTBLOCK ||(retval == -ERESTARTSYS &&!(ksig.ka.sa.sa_flags & SA_RESTART)))) {regs->regs[0] = -EINTR;regs->pc = continue_addr;}handle_signal(&ksig, regs);return;}
第 5 行:if 的判断条件是 get_signal() 的返回值。
get_signal() 的实现在 kernel/signal.c,将近两百行,涉及一堆和主线无关的东西,不打算逐行分析了。
只需要搞清楚两件事:
它干了什么 返回值是什么
它干了什么
一句话:遍历当前线程的挂起信号,找出下一个需要回用户态执行 handler 的信号;找的过程中,把所有能在内核里就地处理的信号顺手处理掉。
每一轮循环用 dequeue_signal() 取一个信号。dequeue_signal() 的第二个参数是信号掩码,被屏蔽的信号不会被取出。
每一个取出的信号有五种类别:
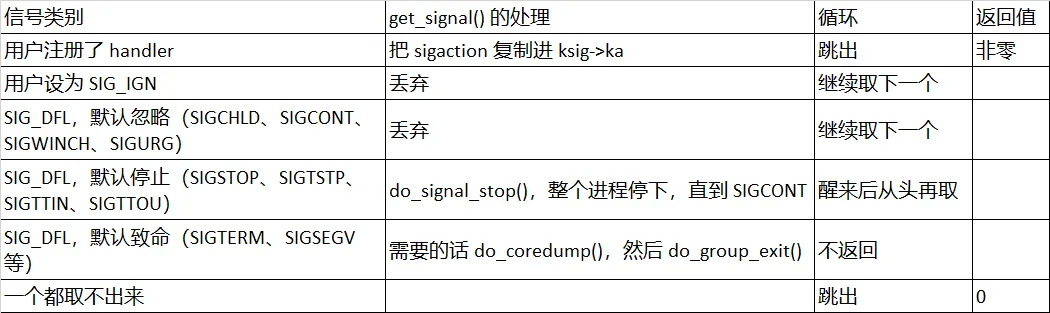
只有第一种需要回用户态去执行用户注册的 handler,其余四种要么在内核里当场解决,要么进程直接没了。
返回值是什么
返回非 0 表示找到了这样的信号,接下来就要回用户态执行 handler 了。也就是要执行 if 块里的代码。
返回 0 就表示没有找到这样的信号,不必回用户态执行 handler 了,那就直接跳到第三个 if 块。
根据我们之前的例子,ppoll 期间收到了 SIGUSR1 信号,所以这里 if 判断成立。
第 6 - 18 行:如果第 11 行的 if 成立,那么就修改 regs->regs[0] 和 regs->pc。
等等,前面第一个 if 块不刚刚才对它俩赋值吗?这里怎么又给它改了?
前面的赋值是在给系统调用的重启做准备,现在又改掉,那重启肯定就做不了。注意第 6 - 10 行的注释,其中有写道:我们可能需要撤销重启系统调用的决定。
regs->regs[0] 和 regs->pc 的作用前面解释过,根据第 16 - 17 行赋值的 -EINTR 和 continue_addr,似乎是打算回用户态了:返回 -EINTR,然后在 continue_addr 地址处执行下一条指令。
没错,这段代码就是为了撤销系统调用的重启,前提是第 11 行的 if 判断得为真。
这个 if 条件有点长,仔细分析发现是 A && B 这样的结构。
其中 A 是:
regs->pc == restart_addrB 是:
retval == -ERESTARTNOHAND ||retval == -ERESTART_RESTARTBLOCK ||(retval == -ERESTARTSYS && !(ksig.ka.sa.sa_flags & SA_RESTART))
A 和 B 必须同时为真才会撤销系统调用的重启。拆开后,逻辑就清晰多了。
先从 A 开始分析。
这个条件怪怪的。第一个 if 块里已经把 regs->pc 赋值为了 restart_addr,这里又马上判断是否相等。可是这期间只调用了 get_signal(),而 get_signal() 的传参是 ksig,并不是 regs 或者 regs->pc。从代码上来看,应该没有人会去修改 regs->pc。
这个 A 条件是不是搞错了?
注意整个 if 块的两段注释,都提到了 debugger。尤其是第一段注释:如果运行在 ptrace 下,debugger 有可能修改了我们所有的寄存器,自然也包括 PC。debugger 也许是搞清楚这个问题的突破口。
debugger,调试器,是用来观察和控制另一个程序运行的工具。最常见的是 gdb。
用它调试一个程序时,可以让程序在某一行停下来,然后查看、甚至修改此刻某个变量或某个寄存器的值,之后接着让它继续跑。让目标程序随时运行随时停下,依赖的便是 BRK (break 的缩写) 指令,以及上篇文章里介绍过的硬件单步机制。
一个进程靠什么能这样玩弄另一个进程呢?靠内核提供的 ptrace 系统调用。
ptrace 允许一个进程附着到另一个进程上,附着的一方叫 tracer,被附着的一方叫 tracee。附着之后,tracee 遇到某些事件时会停下来,并且通知 tracer;tracer 在 tracee 停着的时候可以读写它的内存和寄存器,然后决定让它怎样继续。
gdb 就是一个 tracer,被调试的程序就是 tracee。
tracee 停下来的时候在内核里,比如单步异常陷入内核态。它的用户态寄存器全在内核栈的 pt_regs 里躺着。tracer 读寄存器,内核就把 pt_regs 里的值拷给它;tracer 写寄存器,内核就把新值写进 pt_regs。
等 tracee 恢复运行,kernel_exit 根据 pt_regs 恢复现场,tracer 改的值就成了 tracee 的真实状态。
比如,tracer 修改 tracee 的 regs->pc,就可以让 tracee 从别的地方继续执行。gdb 的 jump 命令就是这么实现的。
再回到我们的代码。
get_signal() 里就有一个这样的停止点。被跟踪的线程,即当前线程,取出一个信号之后,不会直接处理,而是先在 ptrace_signal() 里调用 ptrace_stop() 停下来,把这个信号交给 tracer 过目。
tracer 可以随意处理这个信号,比如什么都不做直接放行,也可以拦截掉这个信号不让送达,甚至换成别的信号。在此期间,它随时可以读写这个线程的 pt_regs,当然也包括 regs->pc。
现在再来分析 A 条件就比较好理解了。
如果 A 为假,说明 tracer 已经把 regs->pc 改到别处了,内核尊重这个决定,不动现场。返回用户态后,程序将跳到 tracer 指定的指令地址处继续执行。
第二段注释的第二句话说的就是这个逻辑:如果 debugger 选择在不同的 PC 处重启,那就跳过撤销重启的代码。也就是不执行这个 if 块,维持前面第一个 if 块的赋值状态。
因为一旦 tracer 改了 pc,那它大概率还要改其它寄存器,为新的代码执行做好准备。所以,这里我们不能修改 pt_regs 了,否则就会破坏 tracer 准备好的现场。
如果 A 为真,说明 tracer 并没有修改 regs->pc,那我们可以按原计划继续往下走。
关于 debugger,还有一点没有触及到。
回到第一个 if 块里的 swtich/case 语句,它上面的注释也提到了 debugger。
我们已经知道,这段 swtich/case 代码是为了给系统调用的重启做准备。可是按照正常的思路,不应该是先检查目标信号有没有 handler,再来决定重启还是返回 -EINTR 吗?这里却反过来,先准备好重启,然后再来检查,如果发现有 handler 再改回来。
注释的第二句解释了原因:为了让调试器看到已经改好的 PC。
在 get_signal() 之前就把 pc 拨回 restart_addr、x0 换成 orig_x0,这样 tracer 在停止点上看到的是系统调用即将重启这个最终状态,而不是一个 pc 指着 svc 下一条、x0 里却装着 -ERESTARTNOHAND 的中间状态。
tracer 据此可以决定:不管,让它重启;或者改掉 pc,让线程从别的地方继续。
再来分析 B 条件。
能走到 B,说明 A 一定为真,也就是 tracer 并没有修改 regs->pc。
让我们先回顾一下这个 if 块的作用:
如果条件满足,就撤销系统调用的重启,转而返回用户态 如果条件不满足,那就不动 pt_regs,维持它原有的样子
还记得给四个错误码汇总的那张表吗?不管是哪个错误码,do_signal() 返回后,恢复用户态现场,最终回到用户态之后,要么重启系统调用,要么继续往下执行用户程序。
B 条件就是把所有可能情况一分为二,B 成立则返回用户态后继续往下执行用户程序,B 不成立则重启系统调用。
先看第一个或条件:
retval == -ERESTARTNOHAND ||如果系统调用的返回值是 -ERESTARTNOHAND,B 成立,意味着直接返回不重启系统调用。
等等,之前不是说 ERESTARTNOHAND 在没有 handler 的情况下会重启吗?现在怎么又不重启了?
这里的逻辑没有问题。不要忘了,我们现在在第二个 if 块的内部,说明 get_signal() 返回了非零,也就是说,信号必有 handler!
仔细再看看错误码汇总表的第 4 行,和这里的代码完美契合。
第二个或条件:
retval == -ERESTART_RESTARTBLOCK ||语义上和 ERESTARTNOHAND 一样。
第三个或条件:
retval == -ERESTARTSYS && !(ksig.ka.sa.sa_flags & SA_RESTART)ERESTARTSYS 的语义前面已经介绍过,这里的代码将其具象化了。
如果没有设置 SA_RESTART,B 成立,那就不重启系统调用,而是返回 -EINTR 给用户程序。
仔细再看看错误码汇总表的第 3 行,和这里的代码也完美契合。
等等,代码里怎么没有对 ERESTARTNOINTR 的判断?
非也。如果是 ERESTARTNOINTR,说明 B 永远为假,那 pt_regs 就永远维持重启系统调用的配置。
这不正是 ERESTARTNOINTR 的语义吗!
感慨一下
第一个 if 块里提前将系统调用重启所需的现场准备好,然后这里根据错误码来决定是否回退现场。一个 if 条件判断就把四个错误码的语义完整实现出来了,不可谓不精妙!
继续往下分析。
第 20 行:返回用户态后的行为处理好了,现在就要开始处理信号了。
这个函数实现很长,下篇单独分析。接着往下分析最后一个 if 块。
4. 恢复掩码
第三个 if 块:
/** Handle restarting a different system call. As above, if a debugger* has chosen to restart at a different PC, ignore the restart.*/if (syscall >= 0 && regs->pc == restart_addr) {if (retval == -ERESTART_RESTARTBLOCK)setup_restart_syscall(regs);user_rewind_single_step(current);}restore_saved_sigmask();
能跑到这里,说明 get_signal() 必返回 0,不用回用户态执行 handler 了。
第 5 行:这个 if 条件似曾相识。
syscall >= 0 刚好也是第一个 if 块的判断条件,用来判断是从系统调用返回后才走到了 do_signal(),而且是第一次到这里。
这拦截了两类场景:
其它异常(比如中断异常)返回用户态时也有可能走到这里(TIF_SIGPENDING 置位了),但并不会走第一个和第三个 if 块。 由于 work_pending 循环而再次进到 do_signal(),此时也不会再走这两个 if 块,因为第一次进来时准备工作就已经做好了,如果这时再走一遍,就属于帮倒忙了。
这个拦截属于精准打击,保证只有系统调用场景下才执行,因为这两个 if 块都是在为重启做准备。
你怎么知道第三个 if 块也是在为重启做准备?
好吧,为了把第一个和第三个 if 块凑在一起说明,我是有点提前剧透了。只有分析完代码后才能得出这个结论。
Anyway,接着往下分析。
regs->pc == restart_addr 则是第二个 if 块里决定是否撤销重启的条件之一,用来检查调试器是否动过 pc 值。
在这里,这个条件要成立,得同时满足两点:
第一个 if 块的 switch/case 确实命中了 ERESTARTxxx 错误码,把 pc 拨到了 restart_addr。这说明系统调用的需求是要重新调用它自己。 从那之后没人再改过 pc。这说明 tracer 没有附着在我们当前线程上,或者不打算让线程跳到别的指令处执行。
现在,第 1 - 4 行的注释的第二句话就比较好理解了:和上面(第二个 if 块)一样,如果调试器选择在不同的地方开始执行,那么就忽略此次重启。
所谓忽略重启,也就是不执行 if 块里的代码。
那 if 里的代码到底在干嘛呢?主要做了两件事。
第一件事:换系统调用号
if (retval == -ERESTART_RESTARTBLOCK)setup_restart_syscall(regs);
前面说过,ERESTART_RESTARTBLOCK 的重启方式有点迂回,采用回调的方式。这里就是专门给返回 -ERESTART_RESTARTBLOCK 的系统调用做好重启前的最后准备。
setup_restart_syscall() 也定义在 arch/arm64/kernel/signal.c:
static void setup_restart_syscall(struct pt_regs *regs){if (is_compat_task())compat_setup_restart_syscall(regs);elseregs->regs[8] = __NR_restart_syscall;}
is_compat_task() 检查线程标志位里的 TIF_32BIT,也就是确认这是不是一个 32 位程序。64 位程序则走 else 分支。
compat_setup_restart_syscall() 定义在 arch/arm64/kernel/signal32.c:
void compat_setup_restart_syscall(struct pt_regs *regs){regs->regs[7] = __NR_compat_restart_syscall;}
可见,不管是 32 位程序还是 64 位程序,setup_restart_syscall() 要做的事情都只是更新一个 pt_regs 的字段。
请回顾一下 poll 源码分析(三)的第 6 节内容:AArch32 兼容路径。
当时总结的差异点如下:
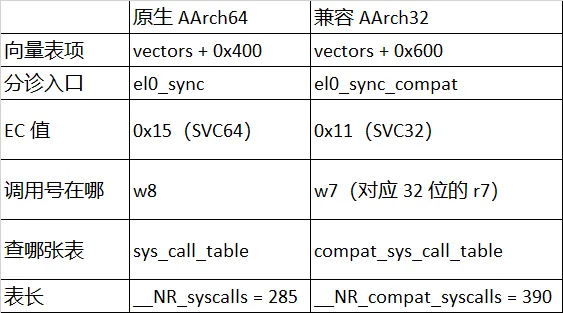
重点关注第 5 行和第 6 行:
保存系统调用号的寄存器分别是 w8 和 w7。这解释了为什么 else 修改的是 regs->regs[8],而 if 则修改的是 regs->regs[7]。 两个模式下用的系统调用表是不一样的,所以系统调用号也不一样。这解释了为什么它俩的赋值是不同的。
为什么要修改系统调用号呢?
kernel_exit 做的事情就是把 pt_regs 里的字段逐一恢复到对应的寄存器里,完成用户态的现场恢复。如果是重启系统调用,那么回到用户态后,程序立刻要再次执行 svc 指令触发同步异常,陷入内核态。
之后内核会根据 w8(32 位程序则是 w7)里的值,在系统调用表里找到对应的系统调用。
也就是说,这里来了招狸猫换太子,本来 svc 后应该是再走一遍 sys_poll(注意不是 sys_ppoll),但这里却把它改了。那改成哪个系统调用了呢?根据宏名也可以猜到,是 restart_syscall。
从原本的 sys_poll 切换到了 restart_syscall,这正是注释里 different 的含义。
ARM64 平台上,64 位程序用的系统调用表集中定义在 include/uapi/asm-generic/unistd.h,其中有:
#define __NR_restart_syscall 128__SYSCALL(__NR_restart_syscall, sys_restart_syscall)
32 位程序所用的系统调用表则集中定义在 arch/arm64/include/asm/unistd32.h,其中有:
#define __NR_restart_syscall 0__SYSCALL(__NR_restart_syscall, sys_restart_syscall)
宏名一样,所以给 regs->regs[7] 赋值时用了 __NR_compat_restart_syscall,用来和 64 位的 128 区分。
__NR_compat_restart_syscall 定义在 arch/arm64/include/asm/unistd.h:
#define __NR_compat_restart_syscall 0 名字不一样,但和 32 位的 __NR_restart_syscall 的值都是 0,指向同一个系统调用函数。
关于如何根据系统调用号找到对应的系统调用函数,这里就不赘述了。不清楚或忘了的道友请查阅 poll 源码分析(三)第 4 节的内容。
__NR_restart_syscall 对应的系统调用函数定义在 kernel/signal.c:
/*** sys_restart_syscall - restart a system call*/SYSCALL_DEFINE0(restart_syscall){struct restart_block *restart = ¤t->restart_block;return restart->fn(restart);}
这个函数没有参数,取出当前线程的 restart_block 后就直接调用 fn 回调了。
说了这么多,也都只是是什么,那为什么呢?
这得从返回 -ERESTART_RESTARTBLOCK 的系统调用说起。
用户程序调用的 poll() 是个非常好的例子,但它有时候走的是内核态的 sys_ppoll(),有时候走的又是内核态的 sys_poll()。
为了澄清这种疑惑,总结了下表:
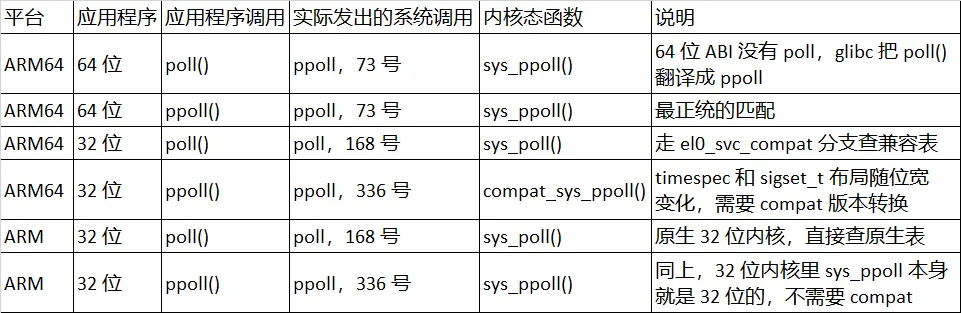
以第 4 行为例。假设我们的应用程序是 32 位的,那么用户态的 poll() 对应的内核态的系统调用就是 sys_poll()。
sys_poll() 也定义在 fs/select.c 里,就在 sys_ppoll() 的上面:
SYSCALL_DEFINE3(poll, struct pollfd __user *, ufds, unsigned int, nfds,int, timeout_msecs){struct timespec end_time, *to = NULL;int ret;if (timeout_msecs >= 0) {to = &end_time;poll_select_set_timeout(to, timeout_msecs / MSEC_PER_SEC,NSEC_PER_MSEC * (timeout_msecs % MSEC_PER_SEC));}ret = do_sys_poll(ufds, nfds, to);if (ret == -EINTR) {struct restart_block *restart_block;restart_block = ¤t->restart_block;restart_block->fn = do_restart_poll;restart_block->poll.ufds = ufds;restart_block->poll.nfds = nfds;if (timeout_msecs >= 0) {restart_block->poll.tv_sec = end_time.tv_sec;restart_block->poll.tv_nsec = end_time.tv_nsec;restart_block->poll.has_timeout = 1;} elserestart_block->poll.has_timeout = 0;ret = -ERESTART_RESTARTBLOCK;}return ret;}
这里不会像分析 sys_ppoll() 那样逐行分析,重点只放在 restart_block 部分。
第 7 - 11 行:和 sys_ppoll() 一样,把用户传进来的相对超时时间转换成绝对超时时刻。
第 13 行:do_sys_poll(),下篇文章专门来分析。
第 15 - 31 行:粗略一看,代码流程是:如果 do_sys_poll() 被信号中断(返回 -EINTR),那就填充当前线程的 restart_block 结构体,然后返回 -ERESTART_RESTARTBLOCK。
似乎有点眉目了:
如果被信号中断,sys_poll() 就准备好 restart_block 结构体,之后 do_signal() 根据返回值,修改系统调用号,切换到 __NR_restart_syscall。 之后返回用户态,svc 再次陷入内核态,内核会转而去调用 sys_restart_syscall()。 sys_restart_syscall() 只做了一件事,那就是调用这里准备好的 fn 回调(第 19 行),即 do_restart_poll() 函数。
流程大概清楚了,现在进一步分析 restart_block 的更多实现细节。
第 18 行:取出当前线程的 restart_block。
接下来都是赋值语句,所以得先了解一下这个结构体里的各个成员。
它定义在 include/linux/thread_info.h(省略掉了无关行):
struct restart_block {long (*fn)(struct restart_block *);union {/* For futex_wait and futex_wait_requeue_pi */struct {...} futex;/* For nanosleep */struct {...} nanosleep;/* For poll */struct {struct pollfd __user *ufds;int nfds;int has_timeout;unsigned long tv_sec;unsigned long tv_nsec;} poll;};};
就两个成员,一个 fn 回调指针,一个 union。
第 19 行就是在给 fn 指针赋值,指向的函数 do_restart_poll() 稍后再来分析。
union 的设计比较有意思,包含三个结构体。这和 restart_block 机制的使用场景密切相关。
内核中,返回 -ERESTART_RESTARTBLOCK 的系统调用只有这么几个:
futex_wait 和 futex_wait_requeue_pi nanosleep poll
很明显,它们之间是互斥的,A 使用的时候 B 就不可能用。所以使用 union 可以让 restart_block 结构体全部兼容这几个系统调用。
以 poll 为例。
它有五个成员,全部都和 poll 的传参有关。结合代码来分析。
第 20 - 21 行:把用户传进来的 ufds 和 nfds 全部备份到 restart_block 里。
干什么用目前还不清楚,不过根据前面的初步分析,restart_block 机制最终的落脚点是 fn 回调,那么可以猜测,做这些应该都是为了回调服务。
第 23 - 26 行:如果用户传进来的超时参数非负,就把绝对到期时刻 end_time 也备份,然后把 has_timeout 置 1。还是在填充 union 下的 poll 成员。
第 27 - 28 行:如果超时参数为负,说明用户希望的 poll 语义是一直工作,直到有 fd 就绪才返回,或者轮询一遍立刻返回。
无论哪种情况,都没有超时语义,所以只把 has_timeout 置 0。
第 30 行:返回 -ERESTART_RESTARTBLOCK,这个味道太熟悉了。
OK。只剩下最后的落脚点 fn 回调了。
do_restart_poll() 函数也定义在 fs/select.c 里,而且就在 sys_poll() 的上面:
staticlongdo_restart_poll(struct restart_block *restart_block){struct pollfd __user *ufds = restart_block->poll.ufds;int nfds = restart_block->poll.nfds;struct timespec *to = NULL, end_time;int ret;if (restart_block->poll.has_timeout) {end_time.tv_sec = restart_block->poll.tv_sec;end_time.tv_nsec = restart_block->poll.tv_nsec;to = &end_time;}ret = do_sys_poll(ufds, nfds, to);if (ret == -EINTR) {restart_block->fn = do_restart_poll;ret = -ERESTART_RESTARTBLOCK;}return ret;}
这个函数揭示了 restart_block 结构体的全部细节。
第 8 - 12 行:如果 has_timeout 为 1,那么就把之前备份在 restart_block 里的绝对到期时刻再取出来,构建好接下来的 do_sys_poll() 所需的第三个参数。
第 14 行:再次执行 do_sys_poll(),也就是真正完成 poll 语义的函数,相当于"重启"了用户态的 poll 调用。
到这里,前面赋值的语句就全部解释得通了,即都是为了给这一行服务。restart_block->poll.ufds 备份第一个参数,restart_block->poll.nfds 备份第二个参数,第三个参数由于情况不同,需要引入 has_timeout 来区分它们。
注意,如果 has_timeout 为 0,说明超时参数为负,对应的 to 将是第 5 行初始化的 NULL。这样,保证了 poll() 函数对超时参数的全部语义。
第 16 - 19 行:如果 do_sys_poll() 再次被信号中断,那么继续返回 -ERESTART_RESTARTBLOCK,那么后面执行到 do_signal() 时,它会继续按照 ERESTART_RESTARTBLOCK 语义处理,再次走 sys_restart_syscall 系统调用。
个人感觉第 17 行的赋值有点多余,不知各位道友什么想法?
完整梳理一遍流程。
sys_poll() 如果被信号中断,那就要提前准备 restart_block,主要是指定回调和备份用户传进来的参数,其中超时参数已经转换成绝对超时时刻了。 之后 sys_poll() 返回 -ERESTART_RESTARTBLOCK,do_signal() 里把系统调用号改成 __NR_restart_syscall,同时 pc 回拨到 svc 指令。 返回用户态后,立刻执行 svc,陷入内核态后调用 sys_restart_syscall() 而不是最开始的 sys_poll()。 sys_restart_syscall() 里只干了一件事,就是调用步骤 1 里早就准备好的回调,也就是 do_restart_poll()。 do_restart_poll() 准备好 do_sys_poll() 所需的参数,然后再次调用之。所谓准备,也就是从 restart_block 里取出对应的参数,真正的准备其实是步骤 1 完成的。 如果 do_sys_poll() 又被信号打断,那么 do_restart_poll() 再次返回 -ERESTART_RESTARTBLOCK。 之后 do_sinal() 继续保证再次陷入内核态后执行的还是 sys_restart_syscall()。
流程图(只关注 restart_block 和重启路径):
用户态 内核态poll()svc #0 ─────────────► sys_poll()do_sys_poll() 被信号打断restart_block.fn = do_restart_pollrestart_block.poll = {ufds, nfds, end_time}返回 -ERESTART_RESTARTBLOCKdo_signal()x8 = 128,pc = svcret_to_user → kernel_exit → eretsvc #0 ◄──────────────┘(用户程序毫无感知)svc #0 ─────────────► sys_restart_syscall()调用 restart_block.fn,即 do_restart_poll()从 restart_block 取出 ufds、nfds、end_time再次调用 do_sys_poll()又被信号打断,返回 -ERESTART_RESTARTBLOCK回到 do_signal(),再来一轮正常返回poll() 返回就绪个数 ◄──────────┘
还没完,继续追问。
为什么会有 ERESTART_RESTARTBLOCK 这样迂回的重启实现呢?
我的理解是,当时实现 sys_poll() 的作者想到的方案就是如此。
假设不走这个迂回流程,而是简单直接地再次走 sys_poll(),看看会发生什么。
想象这样一个场景:用户设置的超时是 1 秒,过了 123 ms 后 do_sys_poll() 被信号中断。那么走重启路径时,再次传给 sys_poll() 的超时时间将是 877 ms。但是 sys_poll 的超时参数直接以值传递,内核没法把 877 ms 这个值回传给用户程序,当再次调用 sys_poll() 时,用户只能还是用最开始的超时时间,这样超时就被拉长了。这显然是不能够接受的。
机智的小伙伴可能会问,不需要把剩余时间传给用户程序啊,直接修改 x2 寄存器不就可以了吗?
的确,理论上来说,这个方案可行。但是,这个方案还不如 restart_block 优雅。
我能想到的主要有两点原因:
时间精度上有损耗。剩余时间的计算是用超时时刻减去当前时刻,但是剩余时间是 ms 的精度,这样每次计算必然要取整。向下取整,每次少睡一点;向上取整,每次多睡一点。一次误差虽然不到 1 毫秒,但一个被频繁打断的 poll 会重启很多次,误差就逐渐累积起来了。相比较而言,restart_block 存的是纳秒精度的绝对到期时刻,重启多少次超时时刻都是同一个瞬间,没有误差。 通用代码不应该也不可能只为一个平台架构服务。sys_poll() 是所有架构共用的,它不知道第三个参数在 ARM64 上是 x2、在 x86-64 上是 rdx、在 32 位 ARM 上是 r2。真要改,就得给每个架构加一个修改第 n 个参数的接口。也许你会反驳,我们并没有说要把 x2 的修改放在通用的 sys_poll() 里,而是放在每个架构自己版本的 do_signal() 里。这个方案和 restart_block 相比,也并没有优势可言,它俩本质上是一样的。对于 ARM64 而言,前者相当于修改 regs->reg[2],而后者也只是修改了 regs->reg[8]。
所以,问题的根源在于 sys_poll() 的超时参数是以值传递的方式从用户程序传到内核的。如果系统调用重启还是调用 sys_poll(),那么超时参数不好处理。
restart_block 方案不仅可以解决这个问题,而且可以应用在面临相同问题的其它系统调用实现上,比如 nanosleep 和 futex_wait。
sys_ppoll() 没有这样的烦恼,因为在 glibc 里就完成了 int 到 struct timespec 的转换,转换后传给 sys_ppoll() 的超时参数就是 tsp 指针了。被信号中断后,poll_select_copy_remaining() 把剩余时间写回了这个指针。重新执行 svc 时,x2 指向的还是同一块内存,但里面已经是新的剩余时间了。
所以,sys_poll() 和 sys_ppoll() 的重启实现上的不同,是由于历史原因,而不是故意为之。前者是早期代码作者能想到的比较优雅的方案,后者则是更优雅的版本,实现上也很简单,把值传递改成地址传递即可。
第二件事:把单步调试回退到陷入内核态之前的用户态状态
user_rewind_single_step(current);这个函数定义在 arch/arm64/kernel/debug-monitors.c:
/* Re-enable single step for syscall restarting. */voiduser_rewind_single_step(struct task_struct *task){/** If single step is active for this thread, then set SPSR.SS* to 1 to avoid returning to the active-pending state.*/if (test_ti_thread_flag(task_thread_info(task), TIF_SINGLESTEP))set_regs_spsr_ss(task_pt_regs(task));}staticvoidset_regs_spsr_ss(struct pt_regs *regs){unsigned long spsr;spsr = regs->pstate;spsr &= ~DBG_SPSR_SS;spsr |= DBG_SPSR_SS;regs->pstate = spsr;}
倒数第二行的 DBG_SPSR_SS 定义在 arch/arm64/include/asm/debug-monitors.h:
#define DBG_SPSR_SS (1 << 21)字面意思很简单。如果线程标志位 TIF_SINGLESTEP 置位了,就调用 set_regs_spsr_ss(),把 regs->pstate 的第 21 位置 1。否则什么都不做。
注释也给了进一步的解释:如果当前线程正在被单步调试,那么就要把 SPSR.SS,也就是 regs->pstate 的第 21 位置 1,以避免返回到 active-pending 状态。
这句话的逻辑不太好理解,得再捋一遍单步调试。
下面的内容需要对单步调试有较深的理解,对这部分不感兴趣的道友可以略过,感兴趣的建议先把上篇文章的 3.1 节再读一遍。
上篇文章的 3.1 节已经详细介绍过单步调试了,为了方便解释,把那边的两张表拷贝过来:
涉及到的寄存器及其 bit 位:
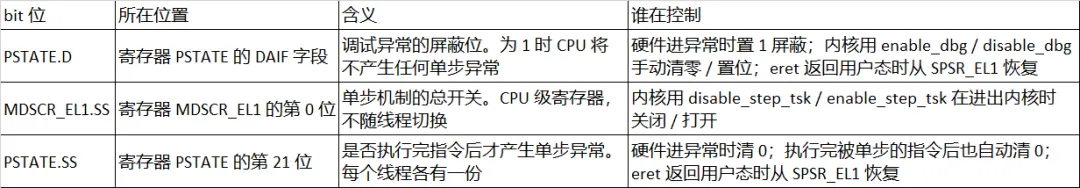
非常重要的状态机:
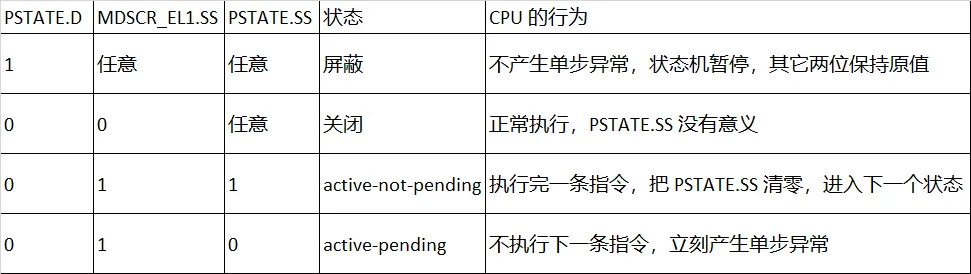
假设我们的线程正在被单步调试,那么各个 bit 位在不同时刻的值如下:
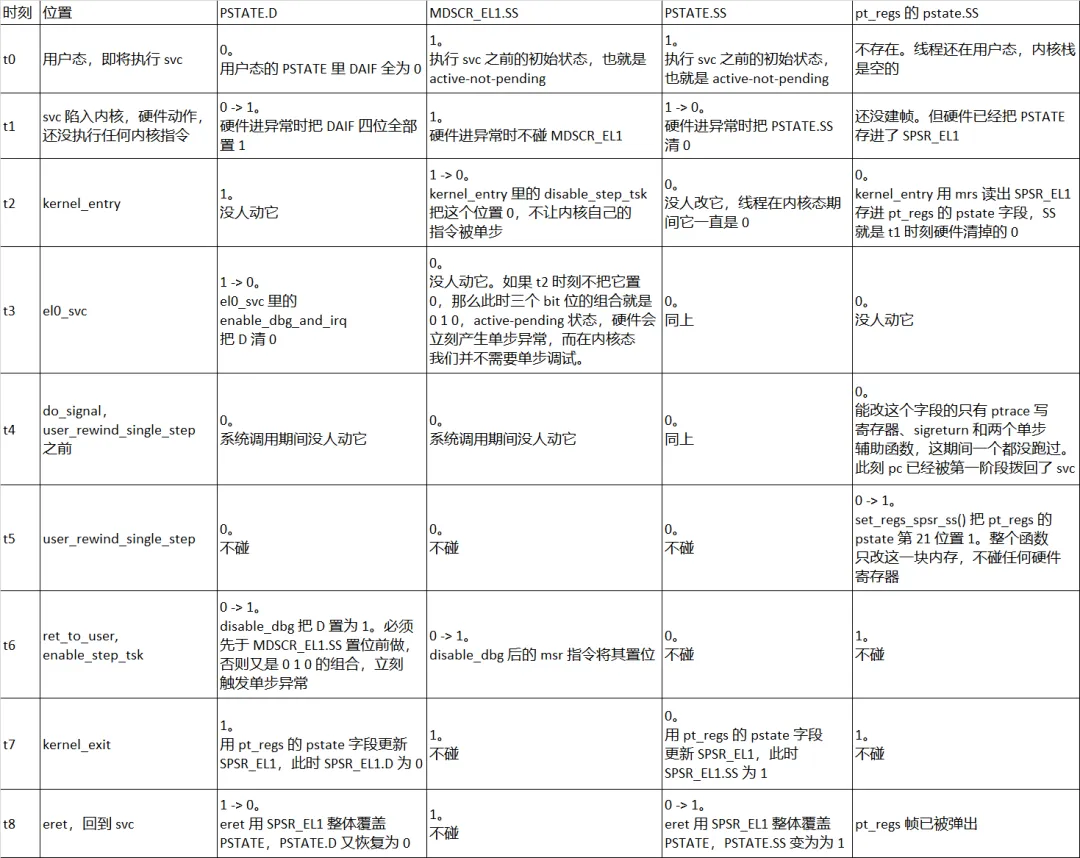
为了更好的理解这张表,有几点补充说明一下:
从 t1 时刻陷入内核态,到 t7 时刻着手回到用户态,中间无论这三个 bit 位怎么变化,始终保证了不会出现 0 1 0 的组合,确保不会在内核态触发单步异常。 t0 时刻和 t8 时刻的组合都是 0 1 1,这是符合预期的。t0 时刻是在单步调试 svc 指令,t8 时刻则继续单步调试 svc 的下一条指令。 PSTATE 寄存器和 pt_regs 的 pstate 字段中间还隔着 SPSR_EL1 这么一个影子寄存器。陷入内核态后,PSTATE 最终被保存进 pt_regs.pstate 分成了两步走:
t1: PSTATE -> SPSR_EL1t2: SPSR_EL1 -> pt_regs.pstate
其中,t1 是硬件自动完成的。
同样,返回用户态时,PSTATE 最终从 pt_regs.pstate 恢复也是分了两步:
t7: pt_regs.pstate -> SPSR_EL1t8: SPSR_EL1 -> PSTATE
其中,t8 也是硬件自动完成的。
现在再来理解代码意图和那段注释就很简单了。
代码做的事情发生在 t5 时刻,其实它并没有修改任何寄存器,而只是修改了栈上的 pt_regs.pstate 的第 21 位。结合刚说的 t7/t8 的 PSTATE 恢复流程,代码做的事情相当于最终修改了 PSTATE.SS。
假设不改,那么 t8 时刻三个 bit 位的组合将是 0 1 0 的组合,即 active-pending 状态,而这个状态下会立刻触发单步异常。
注释说 "将 regs->pstate 的第 21 位置 1 是为了避免返回到 active-pending 状态",指的就是这个逻辑。
为什么这两件事都要放在 regs->pc 的检查里面?
因为这两件事都有一个共同的前提,那就是返回用户态后 svc 会再执行一次。
而 pc 是否等于 restart_addr,就是这个前提是否成立的依据。pc 指着 svc,eret 之后 svc 就会重新执行;pc 被调试器改到了别处,svc 就不会重新执行。
第一件事里修改 x8 和前提的关系很直接。把 x8 改成 128 是为了让重新执行的 svc 之后走 restart_syscall 调用流程。svc 不重新执行,这个 128 就只是白白覆盖了用户态的 x8,用户程序从调试器指定的地方继续跑,手里的 x8 却莫名其妙地变了。
第二件事 user_rewind_single_step() 和前提的关系有点隐晦,需要多费些笔墨。
假设单步调试用的是 gdb 的 stepi 命令,这是机器码指令级别的单步。svc 陷入内核那一刻,硬件把 PSTATE.SS 清为 0。
正常情况下不用修改 PSTATE.SS。系统调用返回后回到 svc 的下一条,SS 为 0,0 1 0 的组合会立刻触发单步异常,线程停止运行,gdb 读到的 pc 变成了 svc 的下一条。用户看到 svc 执行了一次,且程序停在了它后面没有继续运行,这正是 stepi 单步调试所期望的结果。
系统调用重启则打破了这份美好。内核把 pc 拨回 svc,x0 换回 orig_x0。如果还是不修改 PSTATE.SS,eret 之后 CPU 会在执行 svc 之前立刻停下。gdb 读到的 PC 还是 svc 的地址,寄存器和执行 stepi 之前一模一样。
gdb 判断指令跑没跑的依据只有 PC,PC 没变,这次 stepi 在它眼里就是什么都没发生,尽管在内核视角下我们已经完整地走完了一遍同步异常处理流程。
user_rewind_single_step() 把 SS 置回 1,回到用户态后 CPU 就不会在第一次的 svc 的后面停下,而是继续从 PC 指向的地址处开始执行,也就是第二次执行 svc。这样,对用户而言是无感重启,第一次的 svc 相当于没有发生过。
至此,第三个 if 块的分析算是彻底完成了,整个人都通达了。
最后剩下一个 restore_saved_sigmask()。
这个函数定义在 include/linux/sched.h:
static inline void restore_saved_sigmask(void){if (test_and_clear_restore_sigmask())__set_current_blocked(¤t->saved_sigmask);}
有了 poll 源码分析(四)里 6.2 节的分析,这个函数就很好理解了。
这里就是 6.2 节里说的委托的收敛处。
当时的代码是:
if (sigmask) {memcpy(¤t->saved_sigmask, &sigsaved,sizeof(sigsaved));set_restore_sigmask();}
先把旧的信号掩码备份在 current->saved_sigmask 里,然后置位 TIF_RESTORE_SIGMASK。
现在,restore_saved_sigmask() 就根据这个委托完成信号掩码的恢复:如果 TIF_RESTORE_SIGMASK 置位了,清掉它,然后把 current->saved_sigmask 恢复成当前掩码。
至此,整个 do_signal() 就分析完了,可以稍微总结一下它在干什么了。
先为系统调用的重启做好准备。所谓准备,也就是修改 regs->regs[0] 和 regs->pc 而已。 检查是否有携带 handler 的信号要处理,有就处理,但处理前需要考虑调试器是否已经介入,以及系统调用的重启需求。 如果没有这样的信号要处理,那就为系统调用的重启做最后的收尾准备,主要是 ERESTART_RESTARTBLOCK 场景的重启,和单步调试状态机的处理。
有个问题留给各位道友:前面解释了第一个 if 块要在第二个 if 块之前执行的原因,那第三个 if 块在第二个 if 块之后执行的原因是什么呢?都是为了系统调用的重启做准备,就不能把第一个 if 块和第三个 if 块合并吗?