ARTICLE · 1117648
Excel脏数据到底应该怎么洗:正则三函数一篇讲透
拿到一张外部表,手机号一列三种写法:带横线的、带空格的、还有混着汉字备注的。
这时候拿它去 VLOOKUP,满屏 #N/A,你却不知道错在哪几行。
别急着删横线。Excel 这两年上了一批正则函数,干的就是这件事。
一、正则函数是什么:给脏数据画一张「通缉画像」
正则是个老技术,说穿了就一句话:用一串符号描述「你要找的数长什么样」,而不是写出它的具体内容。
比如「11位数字」写成[0-9]{11},「一个或多个空格」写成+。模式一旦写对,不管脏数据有一百种还是一千种姿势,都能按同一张画像抓出来。
以前 Excel 用不了正则,得开 Power Query 或者求 VBA。现在 Microsoft 365 直接给了三个函数,单元格里面就能用。
二、动手前先摸底:这列脏有几种
清洗第一课:先统计,别上手改。
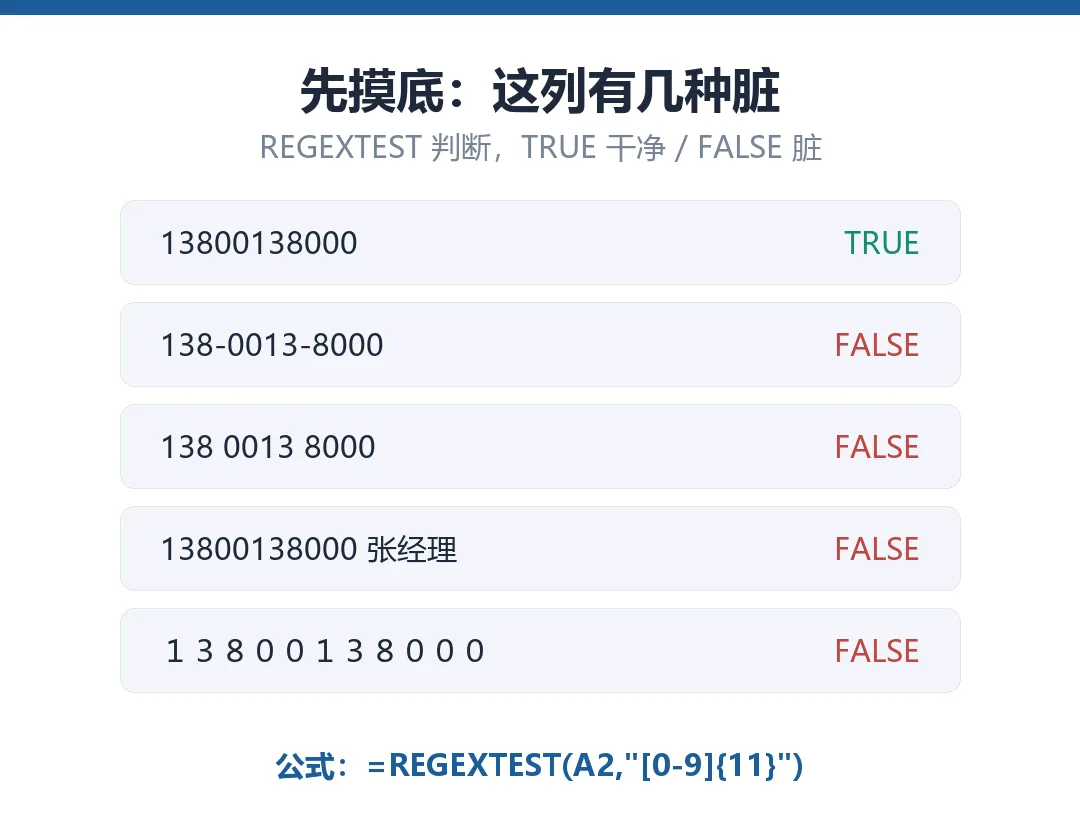
在旁边加一列,用=REGEXTEST(A2,"[0-9]{11}")判断:这个格子里有没有连续 11 位数字?返回 TRUE 就是干净的,FALSE 就是脏的。
先摸底再动手,坏处为零,好处是你知道自己要打几种怪。十行数据看不出差别,一万行的时候,这一步能救你半天。
三、REGEXEXTRACT:把号码从备注里捞出来
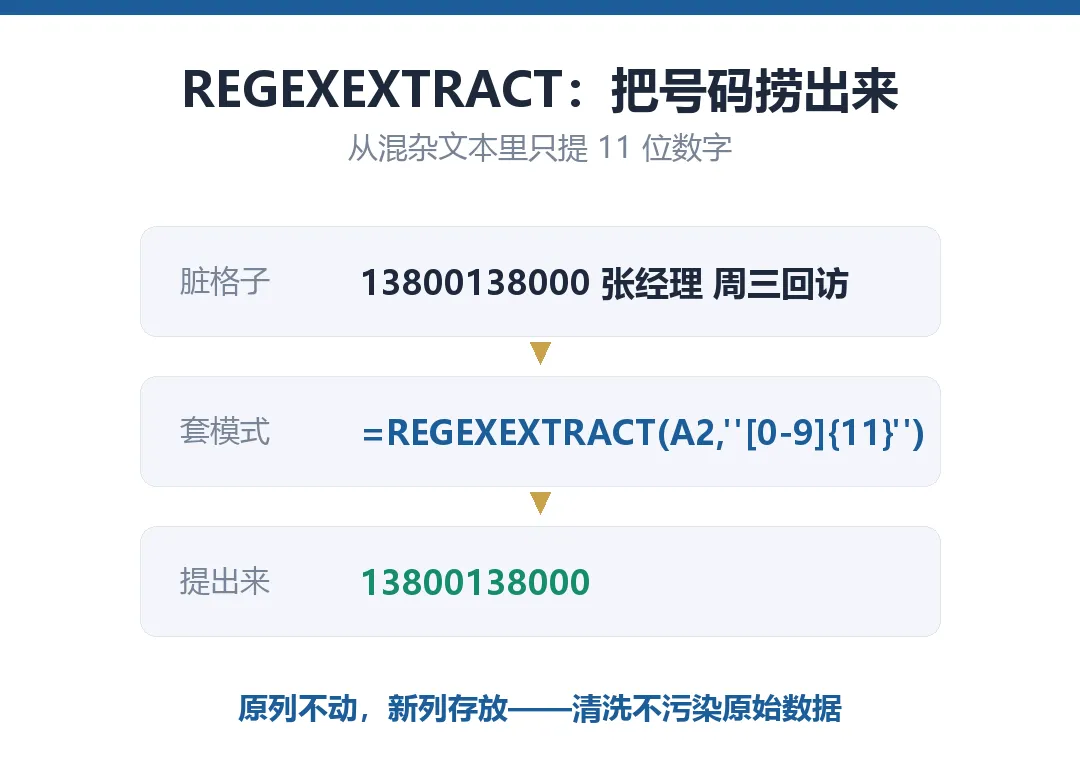
摸完底发现,最麻烦的是那种「13800138000 张经理 周三回访」混着汉字的格子。
用=REGEXEXTRACT(A2,"[0-9]{11}"),把符合画像的那一截单独提出来。汉字、空格、别的数字全留在原地,提出来的就是纯号码。
一列拖下去,脏行全部变干净,原列还留着不动——清洗永远不污染原始数据,这是给自己留的后路。
四、REGEXREPLACE:三种格式一次抹平
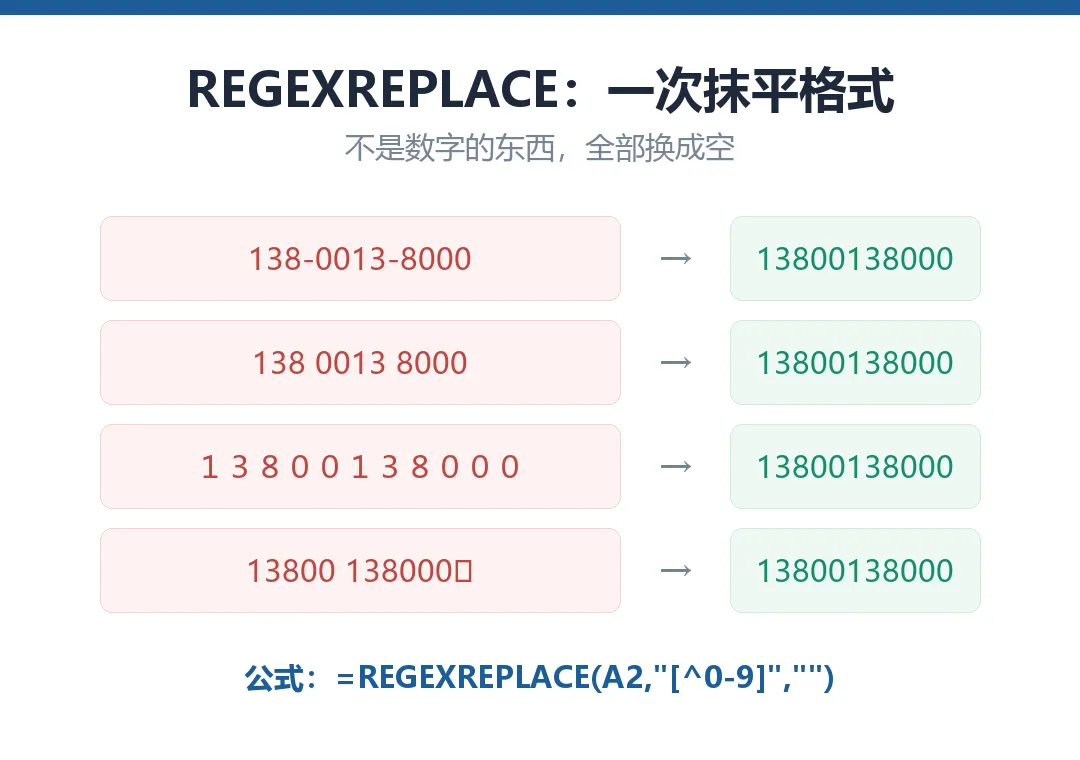
号码本身没缺,只是格式乱:有的带横线 138-0013-8000,有的带空格。
用=REGEXREPLACE(A2,"[^0-9]",""):把「不是数字的东西」全部换成空。横线、空格、不可见字符,一个模式全收。
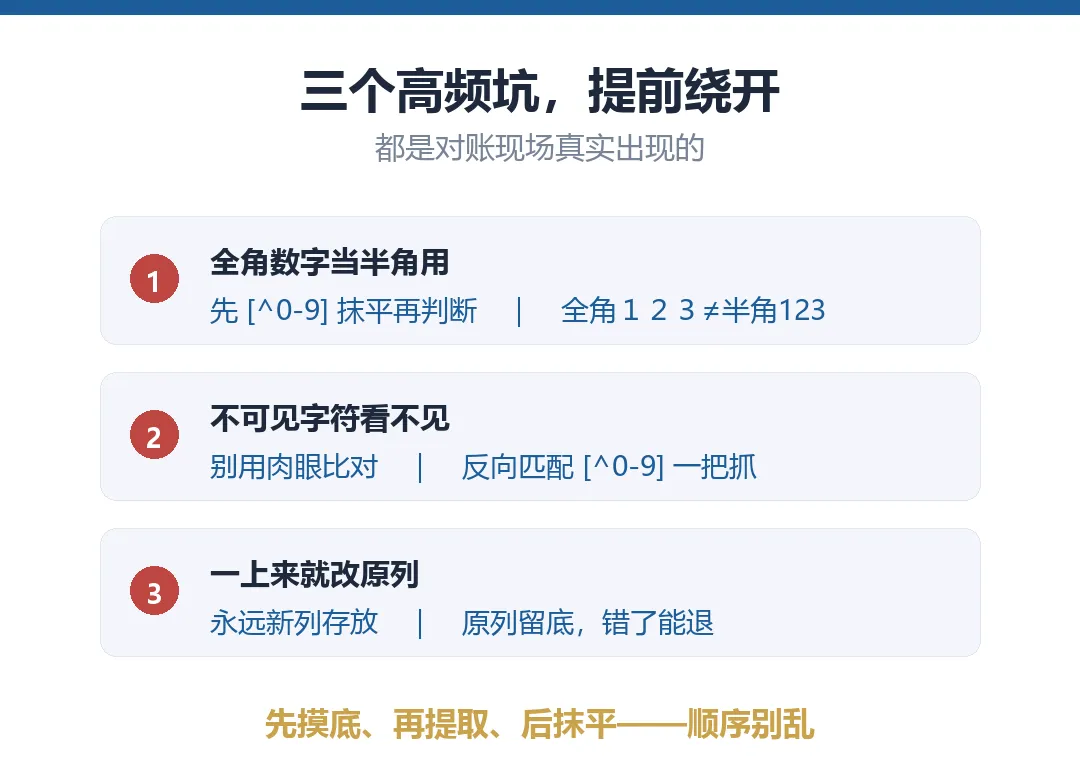
顺带说一个经典坑:看着一模一样的两个号码就是匹配不上,多半是里面有从网页复制来的不可见字符。「[^0-9]」这种反向写法,就是给这种看不见的脏准备的。
五、五个常用模式,抄走就能用
清洗 90% 的场景,下面五个模式够了:
• 纯数字:[0-9]+——提取编号、单号
• 手机号:1[0-9]{10}——1 开头共 11 位,比数 11 位更准
• 邮箱:[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+——从文本里捞邮箱
• 中文:[一-龥]+——把备注里的中文姓名提出来
• 多余空格:+——配合 REPLACE 换成单个空格
六、清洗完再验一遍:别让新错混进来
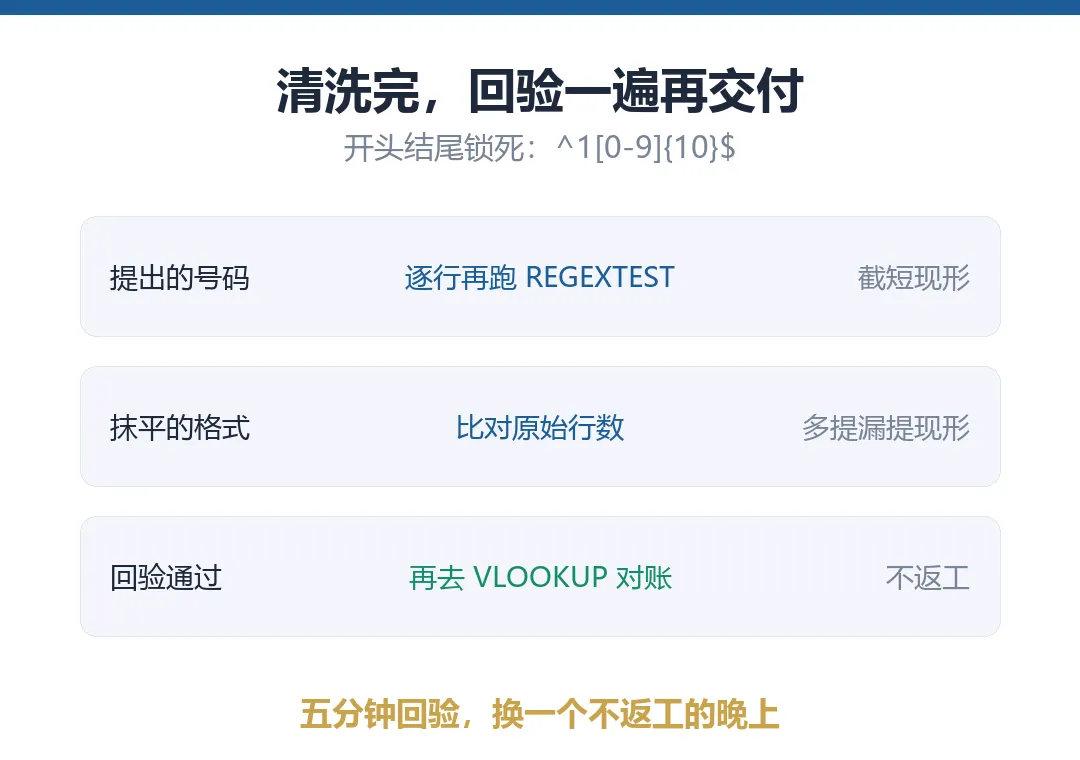
清洗不是终点。处理完回头再跑一次摸底那列:=REGEXTEST(B2,"^1[0-9]{10}$"),开头结尾都锁死,确认每一行都是标准 11 位。
谁在清洗中被截短了位数、谁被多提了数字,这一步全现形。
先验再交付,五分钟换一个不返工的晚上。
七、一个真实点的场景:对账前先洗一列
同事小周每周要拿系统导出的订单表对账,订单号一列混着全角数字和不可见字符,VLOOKUP 十行错三行,每次手动改到眼花。
现在的流程变成三步:REGEXEXTRACT 提出订单号 → REGEXREPLACE 抹平格式 → 摸底列验一遍。改完的列拿去匹配,一次过。
他省下的不是十分钟,是每次对账前那股「不知道今天又哪里对不上」的心理负担。
八、最后提醒:用之前先看你的版本
这三个函数目前铺在 Microsoft 365 的订阅版里,老版本输入 =REGEX 没有联想,就说明还没轮到你的更新通道。
没有也别硬等:Power Query 里的「替换值→使用正则」是同一套思路,模式照抄能用。
💬 你那列最脏的数据长什么样?评论区贴一段,我帮你看用什么模式抓。