ARTICLE · 1123643
全球首个“AI+脑机接口”医疗器械标准发布,到底规范了什么?
全球首个“AI+脑机接口”医疗器械标准发布,到底规范了什么?
从AI算法脑电数据集质量切入:真正被标准化的,不是某一种模型,而是“喂给模型的数据能不能信”。
2026年9月14日,国家药监局发布YY/T 2029—2026《脑机接口医疗器械 用于人工智能算法的脑电数据集质量要求与评价方法》。中检院标准数据库显示,该标准于2026年8月24日批准,计划自2027年9月1日起实施,适用于由人工智能算法对脑电信号进行后处理的脑机接口医疗器械在研发、生产、质量控制等环节使用的数据集。天津政务网和天津大学相关报道将其称为“全球首个采用人工智能技术处理脑电数据的脑机接口医疗器械标准”。
这条新闻真正值得关注的,不是“又多了一个标准”,而是脑机接口正在进入一个更具体的阶段:算法能力开始被追问到数据源头。
可以把AI算法想成一个学生,脑电数据集就是它长期使用的教材。模型再复杂,如果教材里混着大量噪声、标签不一致、采集条件说不清,最后学到的就可能不是稳定的脑活动规律,而是某台设备、某种操作习惯,甚至眨眼、肌电、接触不良等偶然特征。
因此,这项标准的核心不是规定企业必须使用哪一种神经网络,也不是给某个算法统一打分,而是先回答一个基础问题:进入AI训练、验证和质量控制流程的脑电数据,是否具有一致、可追溯、可评价的质量基础?
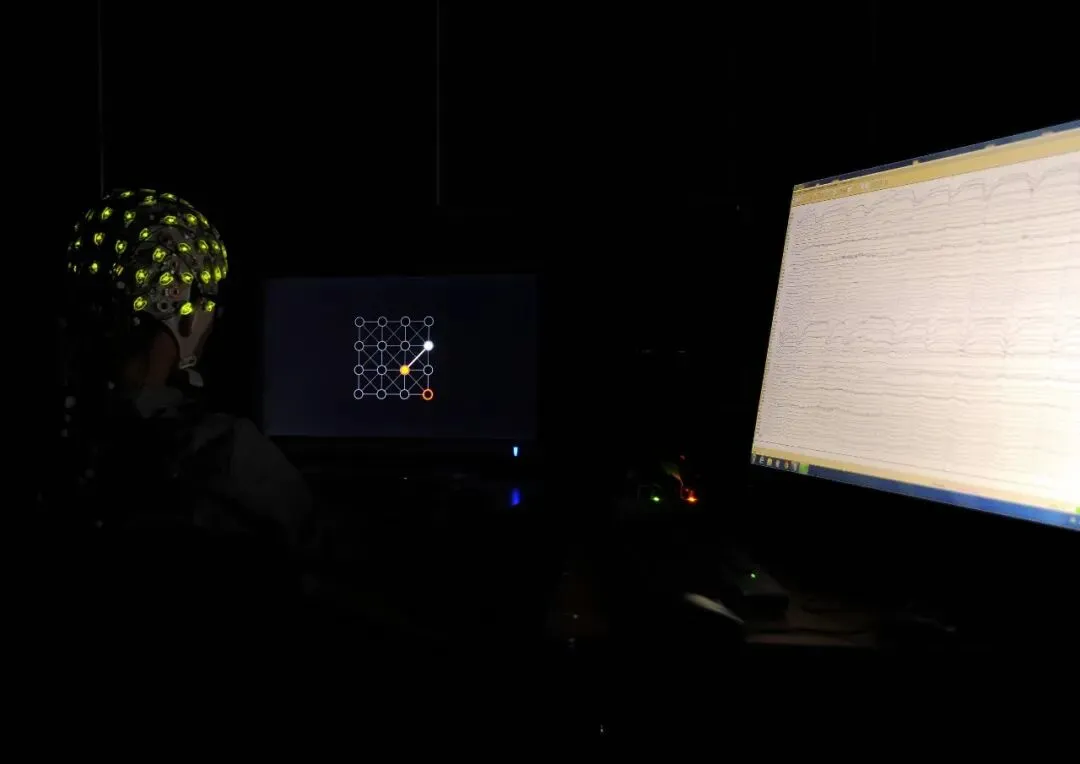
脑电信号本身很微弱。电极接触、采集设备、环境噪声、任务范式、被试状态、信号传输等变化,都可能改变最终记录到的数据。公开的标准项目说明把数据采集要求进一步落到电极、采集条件、传输、实验条件等环节,目的就是把“这段数据是怎么来的”说清楚。
这一步的价值很直接:如果一批数据是在安静实验室采集,另一批来自康复训练中的运动场景;如果两批数据的电极布置、采样设置或实验任务不同,却没有完整记录这些差异,那么它们即便都叫“EEG数据”,也不能简单混在一起训练模型。
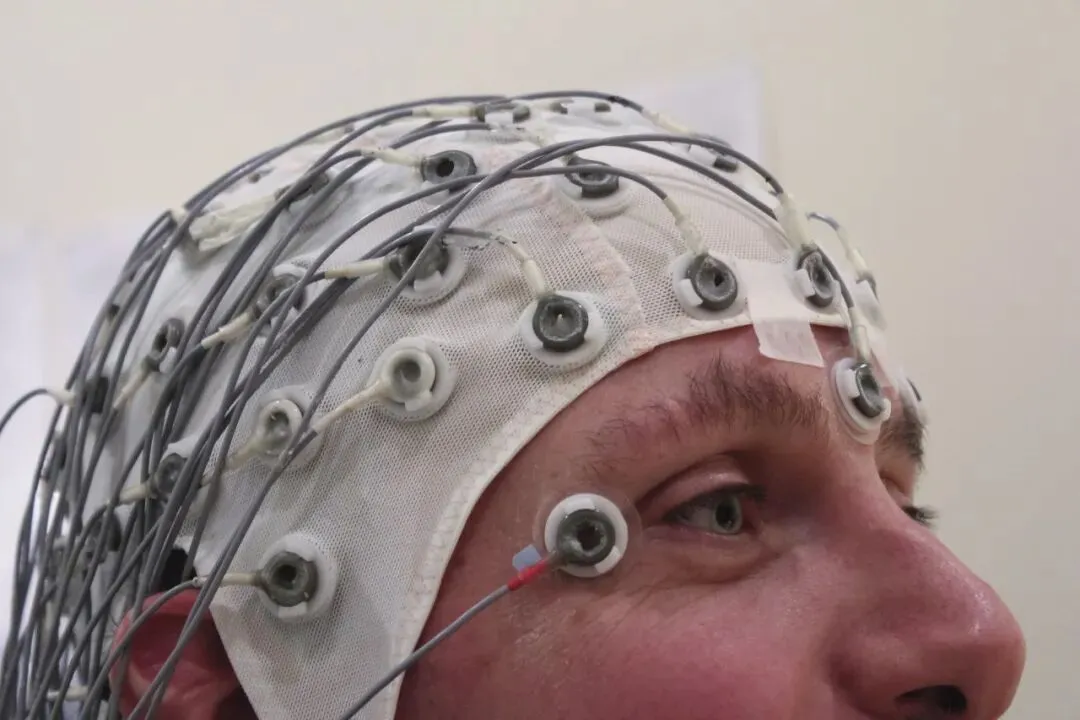
数据处理:去噪不是“修图”,每一步都可能改变模型看到的世界
原始脑电通常不能直接拿去训练AI。常见流程会涉及筛选、去标识化、伪迹处理、滤波、分段等操作。问题在于:处理得太少,噪声会进入模型;处理得太多,也可能把真正有意义的神经信号一起削弱。
因此,统一质量标尺的重要意义之一,是让处理过程可以被描述、复核和追溯。模型最后得到一个“干净数据集”并不够,还需要知道它经历过什么处理、哪些样本被剔除、为什么剔除,以及不同版本之间发生了什么变化。
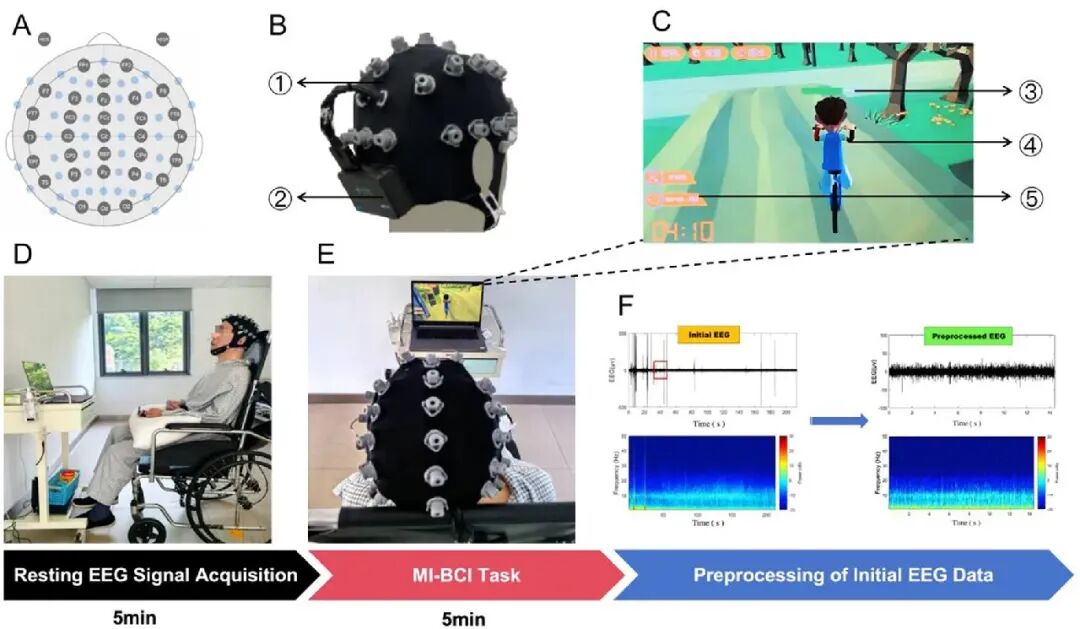
对于监督学习而言,脑电片段往往需要对应某种任务、事件或状态标签。标注看似只是给数据“加名字”,实际上决定了模型到底在学什么。
例如,同一个“运动意图”标签,如果不同中心对任务开始时刻、有效时间窗、失败试次、异常试次的定义不同,那么算法得到的“答案册”就是不一致的。最终看似准确率不错,换一批数据、换一家医院或换一种设备,性能却可能明显变化。
所以,标准化标注不是追求“标签越多越好”,而是要求定义清楚、规则一致、来源可追踪。这也是医疗AI从“实验室跑得通”走向可验证、可复现的重要前提。
与普通内容数据不同,医疗脑电数据往往会在研发、验证、质量控制等不同阶段被反复使用。公开项目说明提出存储安全、可追溯和有序访问等要求,背后的逻辑是:一个可用于医疗AI的数据集,不应只有数据文件本身,还应保留描述文档、元数据、版本和来源信息。
这意味着以后讨论“我们有多少小时脑电数据”并不够。更关键的问题会变成:这些数据来自谁、在什么条件下采集、经过什么处理、由谁标注、哪个版本进入了哪一次模型训练或验证?
最后还要“验”:质量要求必须能被检查,而不是只写在文档里
如果一个标准只有原则,没有测试方法,就很容易停留在“大家都觉得应该这样做”。此次标准及其公开技术说明把质量符合性测试方法也纳入框架,目的就是让数据集是否达到要求有可执行的判断方式。
这一步对行业很重要:研发团队、检测机构、注册审评和质量控制环节,才有可能围绕同一把“尺子”沟通,而不是每家公司都建立一套无法互相比较的数据标准。
脑机接口最容易被讨论的是“算法有多聪明”“能识别多少意图”。但当技术开始进入医疗场景,真正决定系统能不能稳定工作的,往往是更基础的问题:同样的信号能不能被一致采集、同样的数据能不能被一致理解、同样的结果能不能被重复验证。
从这个角度看,YY/T 2029—2026建立的不是一套“AI炫技规则”,而是一条数据基础设施的质量底线。未来AI+脑机接口的竞争,不只发生在模型参数和识别准确率上,也会发生在数据工程、标准化、可追溯性和真实场景验证上。
一句话理解:先把脑电数据的“尺子”统一,AI才有可能在医疗场景里被稳定地训练、比较和验证。
🇷🇺Русская версия
14 сентября 2026 года Государственное управление КНР по контролю за лекарственными средствами опубликовало отраслевой стандарт YY/T 2029—2026 «Медицинские изделия с интерфейсом мозг–компьютер. Требования к качеству и методы оценки наборов ЭЭГ-данных для алгоритмов искусственного интеллекта». Согласно базе стандартов NIFDC, документ утверждён 24 августа 2026 года и вступит в силу 1 сентября 2027 года. Он применяется к наборам данных, используемым при разработке, производстве и контроле качества медицинских изделий ИМК, где алгоритмы ИИ выполняют последующую обработку ЭЭГ-сигналов. В публикациях правительства Тяньцзиня и Тяньцзиньского университета этот документ назван первым в мире стандартом для медицинских изделий ИМК, использующих ИИ для обработки ЭЭГ.
Главный смысл новости не в самом факте появления ещё одного нормативного документа. Важнее другое:качество алгоритма теперь рассматривается вместе с качеством исходных данных.
1. Почему стандарт начинается с набора данных, а не с модели?
Алгоритм можно сравнить со студентом, а набор ЭЭГ-данных — с учебником. Даже самая сложная модель будет учиться на неверных закономерностях, если в данных много артефактов, метки заданы по-разному, а условия регистрации не документированы. В таком случае модель может распознавать не устойчивые нейрофизиологические паттерны, а особенности конкретного прибора, процедуры или помех.
Поэтому задача стандарта — не выбрать «правильную» нейросеть, а обеспечить основу: данные, входящие в обучение, валидацию и контроль качества, должны быть согласованными, прослеживаемыми и пригодными для оценки.
Рис. 1. Реальный эксперимент ИМК с ЭЭГ-шапочкой и обработкой сигнала в реальном времени. Источник: Wikimedia Commons, Laurens R. Krol, CC BY 4.0.
2. Сбор данных: одинаковое слово «ЭЭГ» не означает одинаковое качество
ЭЭГ — слабый сигнал, чувствительный к контакту электродов, оборудованию, помехам, экспериментальной парадигме, состоянию испытуемого и передаче данных. В опубликованном описании проекта стандарта требования к сбору раскрываются через электроды, условия регистрации, передачу и экспериментальные условия.
Если один набор записан в спокойной лаборатории, а другой — во время двигательной реабилитации, или если различаются расположение электродов и параметры регистрации, эти различия должны быть известны. Иначе два массива, формально называющиеся «ЭЭГ», нельзя бездумно объединять для обучения.
Рис. 2. Реальная ЭЭГ-шапочка. Размещение электродов и качество контакта являются частью исходного качества сигнала. Источник: Wikimedia Commons, Chris Hope, CC BY 2.0.
3. Обработка: очистка сигнала — не косметическая «ретушь»
Перед обучением ИИ сырую ЭЭГ обычно фильтруют, сегментируют, проверяют, обезличивают и очищают от артефактов. Но здесь есть баланс: недостаточная обработка оставляет шум, а чрезмерная может удалить полезную нейрофизиологическую информацию.
Поэтому важно не только получить «чистый» файл, но и иметь прослеживаемый процесс: что делалось с данными, какие записи исключались, по каким правилам и чем отличаются версии набора.
Рис. 3. Пример из открытой научной публикации: реальный сбор ЭЭГ и сравнение исходных/предобработанных сигналов. Источник: Frontiers in Neuroscience, 2026.
4. Разметка: метки — это «ключ с ответами» для ИИ
В обучении с учителем сегмент ЭЭГ связывается с событием, задачей или состоянием. Если разные центры по-разному определяют начало задачи, допустимое временное окно, неудачную попытку или артефакт, модель фактически получает разные ответы на один вопрос.
Поэтому цель стандартизации — не максимальное число меток, а чёткие определения, единые правила и прослеживаемое происхождение разметки. Без этого трудно воспроизводить результат на другом устройстве, в другой клинике или на новой выборке.
5. Хранение и доступ: важны не только файлы, но и их происхождение
Медицинские ЭЭГ-данные могут многократно использоваться в разработке, тестировании и контроле качества. В открытых материалах проекта стандарта отдельно подчёркиваются безопасность хранения, прослеживаемость и упорядоченный доступ. Это означает, что набор должен включать не только файлы сигналов, но и описание, метаданные, версии и сведения о происхождении.
Вопрос «сколько часов ЭЭГ у нас есть?» становится недостаточным. Более важны вопросы: кто и при каких условиях записал данные, как они обрабатывались, кто выполнил разметку и какая версия использовалась в конкретном обучении или тесте модели?
6. Качество должно проверяться
Если стандарт содержит только общие принципы, он остаётся рекомендацией на уровне намерений. В технической структуре предусмотрены методы проверки соответствия качества, чтобы команды разработки, испытательные организации и системы контроля могли использовать общую шкалу оценки.
7. Чего стандарт не делает
Он не предписывает конкретную архитектуру ИИ. Он также не означает, что набор данных, прошедший оценку качества, автоматически гарантирует безопасность и эффективность готового изделия. И, наконец, он не превращает любой продукт «ЭЭГ + ИИ» в медицинское изделие: область YY/T 2029—2026 относится именно к медицинским изделиям ИМК и их процессам разработки, производства и контроля качества.
8. Почему это важно за пределами отрасли?
О мозг–компьютерных интерфейсах часто говорят через точность распознавания и «умность» алгоритма. Но в медицинском применении устойчивость системы начинается с более базовых вещей: можно ли одинаково зарегистрировать сигнал, одинаково интерпретировать данные и повторить результат.
Поэтому YY/T 2029—2026 можно рассматривать как стандарт качества инфраструктуры данных. Следующий этап конкуренции в «ИИ + ИМК» — это не только модели, но и инженерия данных, стандартизация, прослеживаемость и проверка в реальных сценариях.
Коротко: сначала нужно унифицировать «линейку» для качества ЭЭГ-данных — только тогда ИИ можно устойчиво обучать, сравнивать и проверять в медицинском контексте.