ARTICLE · 1125203
斯坦福撕下AI科学家的遮羞布:测了184位顶会一作,大模型根本不懂“科研品味”!
你一定听过这样的狂言:AI 马上就要取代人类科学家了。
写代码,它信手拈来;跑实验,它不知疲倦;甚至连论文初稿,大模型都能在十分钟内洋洋洒洒整出几万字。所有人都觉得,只要给 AI 装上搜索工具、配上最先进的推理算力,一个自主发现新物理定律的“爱因斯坦级”AI 科学家,明天清晨就会破土而出。
但斯坦福、首尔大学、华盛顿大学和卡内基梅隆大学(CMU)的顶尖学者们,突然兜头泼下了一盆刺骨的冰水。
他们做了一个堪称“残酷”的实验:把 184 位顶级科学家的“灵感大脑”切片,做成了一块专门考核大模型的试金石。
结果让整个硅谷陷入了尴尬的沉默,无论是调用自主搜索工具的智能体(Agent),还是可能在训练集中接触过终稿论文的顶配大模型,在“科研品味”这项测试中,找回关键灵感的概率均未过半。
即使给大模型配上一整套眼花缭乱的自主搜索工具,其表现依然赶不上几年前最基础的“向量检索”。
AI 科学家的遮羞布,在 2026 年秋天被狠狠撕了下来。
01.考场崩塌:狂暴推理,为何沦为“垃圾桶里的沉思”?
基准测试的设定十分明确:假设时间倒流回两年前。一位人类学者刚刚推开实验室的大门,手里只有一个关于未解科学难题的模糊构想。他不想要那些陈词滥调,他只想知道:在当时人类浩如烟海的文献库里,究竟哪一篇早期论文,能像“催化剂”一样启发这个新想法?
研究团队给大模型提供了当时已发表的 19.1 万篇计算机科学论文语料,给足了工具调用权限,甚至用上了被称为推理天花板的 Claude Fable 5.1。
所有人都在屏息以待一场 AI 的智商碾压。
然而,成绩单公布的那一刻,空气瞬间凝固了。
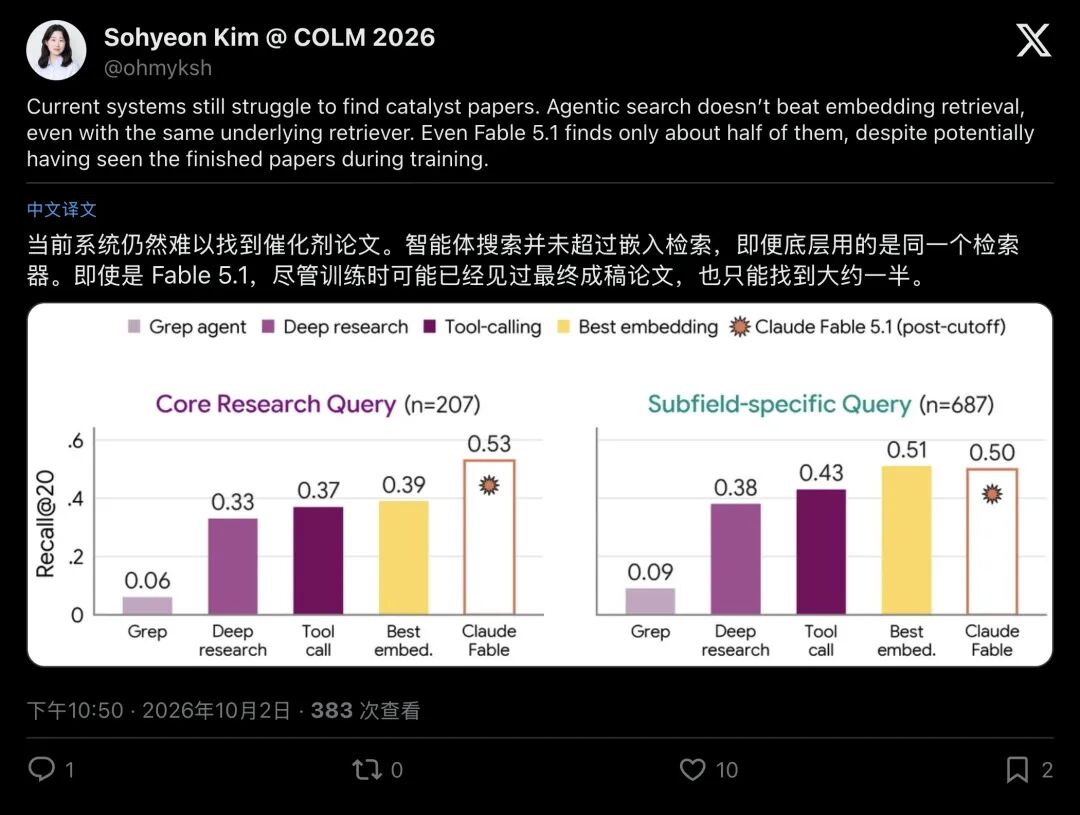
▲ 共同一作 Sohyeon Kim 公布的评测数据:智能体搜索并未超越基础嵌入检索,大模型只找回了约一半的催化剂论文
在最核心的研究瓶颈(CoreQ)检索上,所谓自主搜索智能体的召回率(Recall@20)只有惨淡的 0.37;即便是被视为上限的 Fable 5.1,整体表现也仅仅在 0.5 附近徘徊。
即便放宽到前 20 个候选,模型依然有将近一半的概率,与决定课题走向的核心文献失之交臂。
为什么会这样?论文揭开了一个极其残酷的工程真相:候选覆盖陷阱(Candidate Coverage)。
在科研探索中,“认得出”和“找得到”完全是两码事。现有的自主搜索智能体,每走一步都要依赖底层搜索引擎。如果搜索引擎第一步抓回来的前几十篇文献里压根就没有“真理”,那么无论大模型的推理能力多么惊人,它的“长考”都只是在替一份错误的短名单编造看似合理的借口。
底层检索器一旦遗漏关键文献,模型无论进行多么复杂的推理,都难以挽回前置候选集的缺陷。
02.什么是“科研品味”?别把票房当成了影评
要理解大模型面临的瓶颈,核心在于厘清一个关键区别:相关性,绝不等于启发性。
我们日常使用的学术搜索引擎,无论是 Google Scholar 还是 Semantic Scholar,它们的底层逻辑都是基于“相似度”:你搜“注意力机制”,它就给你吐出一万篇标题和摘要里带有“注意力机制”的论文。
顶尖学者在寻找灵感时的心智机制,与这种浅层字面匹配截然不同。
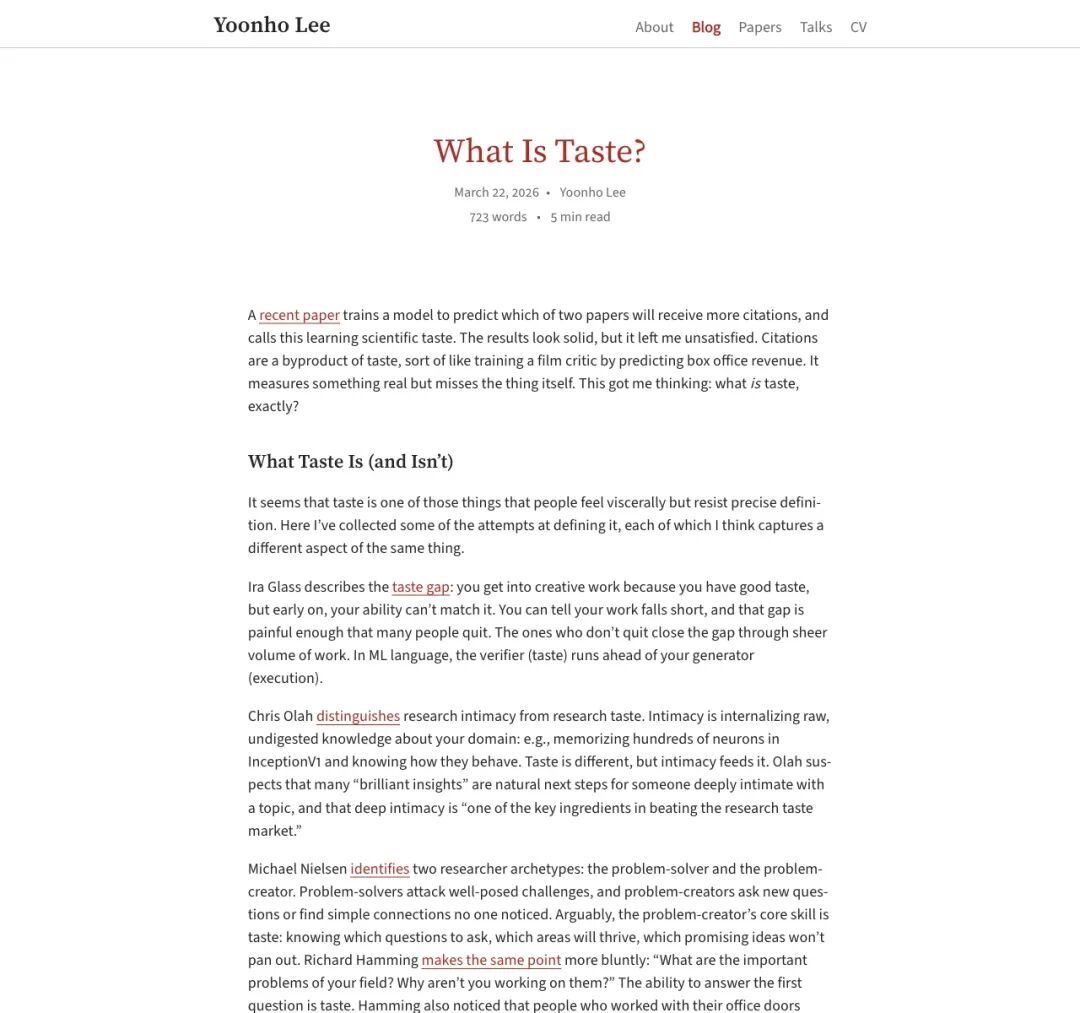
▲ Yoonho Lee 博客文章《What Is Taste?》探讨了科研品味为何无法用引用数来衡量
共同一作 Yoonho Lee 曾写过一篇广为流传的思考随笔《What Is Taste?》。他在文章里直言不讳地痛批了一种流行做法:有人试图通过“预测某篇论文未来会不会有高引用”来训练所谓的 AI 科研品味。
“这简直荒谬透顶,”Yoonho 写道,“引用量就像电影的票房。用票房高低去训练一个人,你只能培养出一个唯利是图的制片人,永远培养不出一个敏锐的影评家。”
科研品味本身,属于前语言阶段形成的默会知识(Tacit Knowledge)。它是在别人完全想不到的地方,建立起两座看似毫无关联的孤岛之间的桥梁;而当这座桥梁架起来之后,所有人事后回看,又觉得它顺理成章、宛若天成。
比如,一个研究流体力学的学者,可能偶然从四十年前一本冷门的几何拓扑学小册子里得到了顿悟,解决了湍流算法的收敛难题;而这种关键的启发,在字面关键词上可能与湍流毫无重合。
传统的搜索模型在面对这种跨维度的认知跃迁时,完全是个瞎子。
03.184 位一作的“灵魂告白”:终稿上没写的,才是颠覆的源头
为了衡量这种深层能力,斯坦福与 CMU 等机构的联合团队建立了一项大规模评估基准:他们搭建了一个名为 ScholarCatalyst 的基准,直接“解剖”了 184 位顶级学者的心智历程。
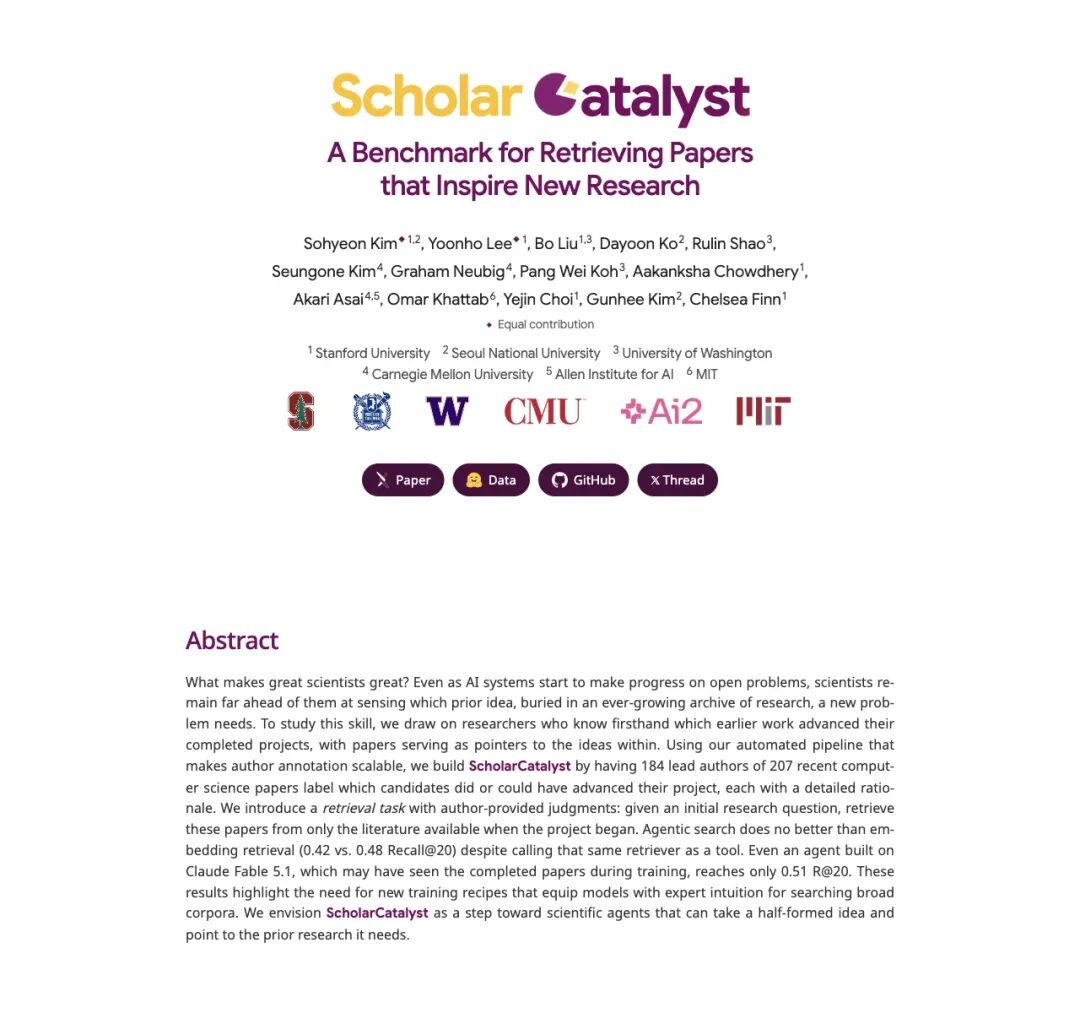
▲ ScholarCatalyst 项目主页,汇聚了 184 位顶级学者与 207 个前沿项目的真实复盘
研究团队避开了常规的网络爬虫抓取模式,转而逐一联络近年主要 AI 顶会(NeurIPS、ICML 等)的 oral、spotlight 和最佳论文主导作者。团队邀请这些一线研究主导者回到课题萌芽的原点,进行系统性复盘:
- 写下起点
:不泄露最终解法,仅写出当时面对的开放性瓶颈; - 标出催化剂(正例)
:究竟哪篇早期论文切实推进了思考、带来了突破性启发? - 标出毒药(难负例)
:哪些论文在主题与关键词上高度重合,但研读后确认并无实质启发?
当 184 位第一作者审阅完 207 个前沿项目后,一份让全世界检索领域震动的统计数据浮出了水面:
在子领域突破问题(SubQ)中,高达 43.6% 的催化剂论文,在最终发表论文的参考文献中并未出现。
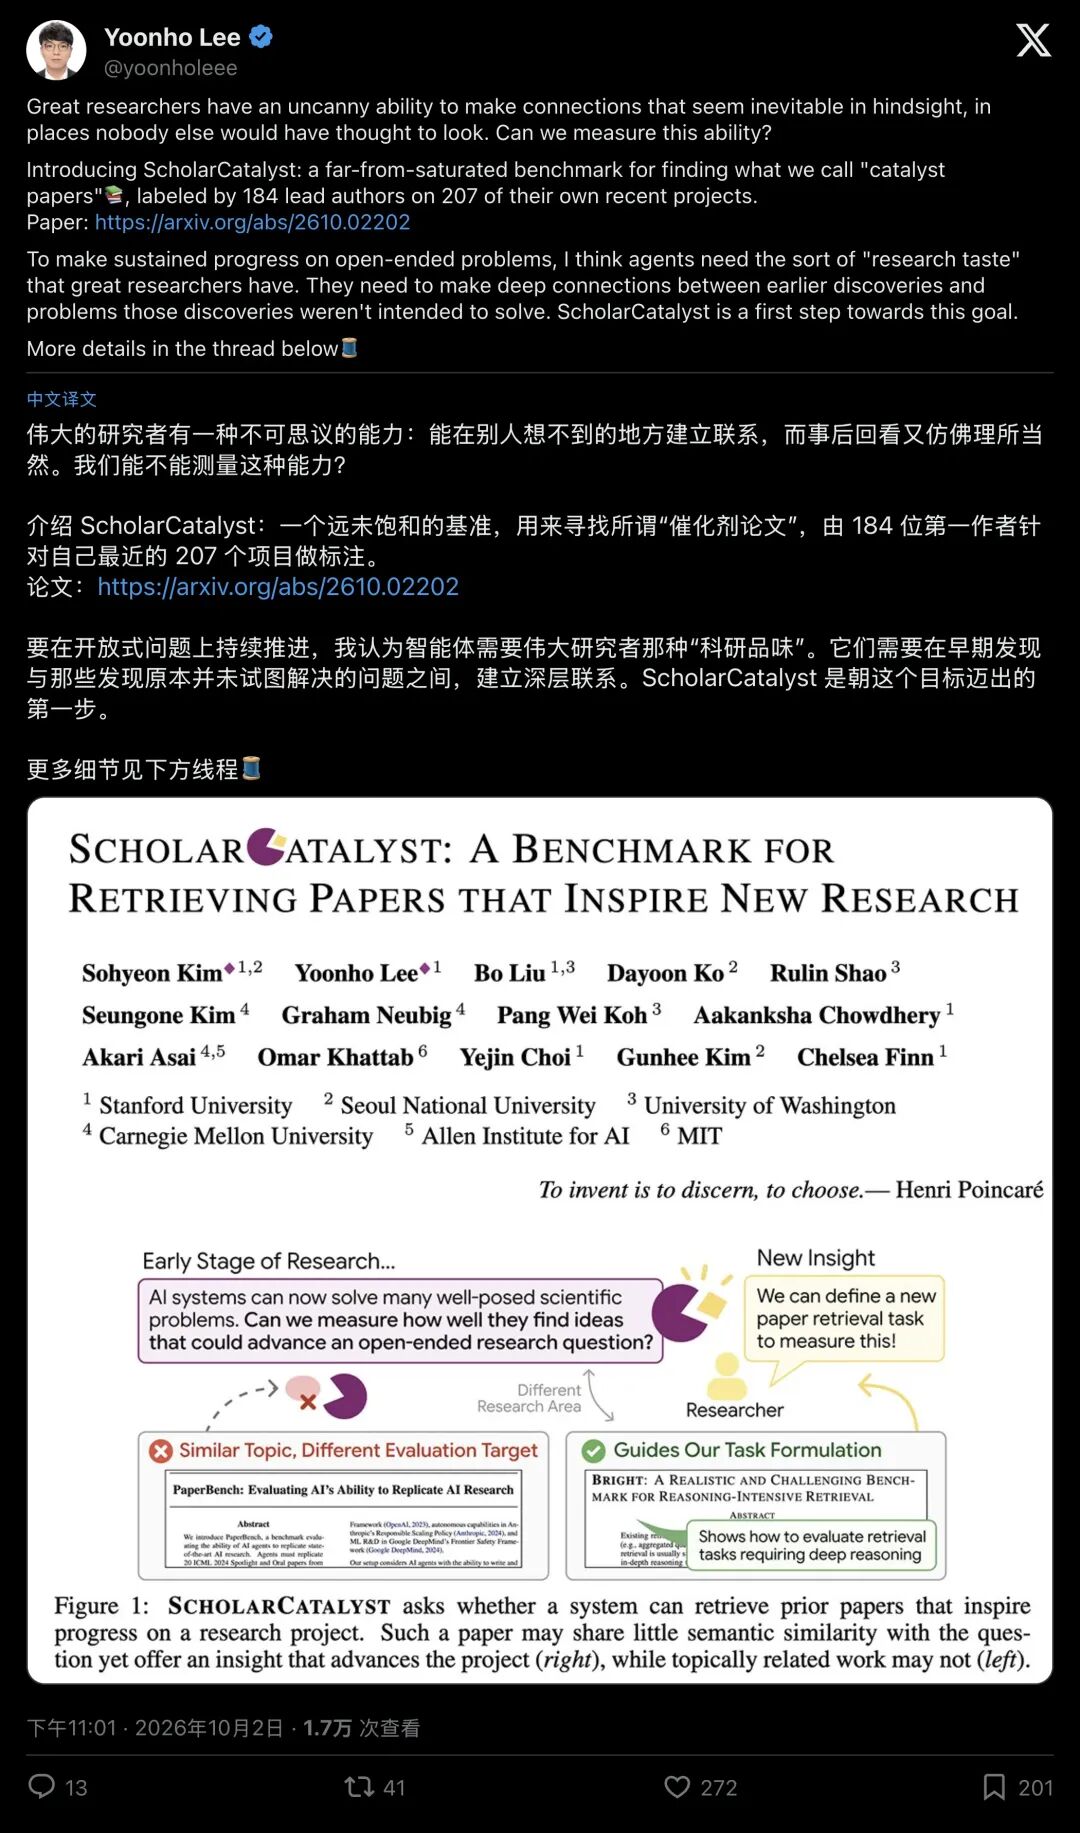
▲ Yoonho Lee 的发布帖,直指“催化剂论文”与科研品味的核心定义
这一统计结果揭示了文献引用的复杂现实。为什么没引?有时候,灵感来自于作者数年前读过的一篇泛读文章;有时候,是一篇其他领域的旧文让作者意识到“此路不通”,从而避开了致命陷阱;还有的时候,它仅仅是提供了一种思维框架,最终在论文定稿时被更工整的文献所替代。
同时,作者认可的催化剂论文中,有近半数(49.5%)来自该课题所属的主题领域之外。
现行的科学数据标注方法若过度依赖“终稿引用关系”或“语义相似度”,就会出现方向性偏差:模型学到的大多是成稿后的规范修饰,难以捕捉研究者在摸索初期获得的原始启发。
04.双雄对决:两所顶尖机构的学术哲学碰撞
就在 ScholarCatalyst 引发震动的同时,学术界的另一座重镇也亮出了自己的武器。
2026 年初秋,来自艾伦人工智能研究所(AI2)与希伯来大学的著名学者 Tom Hope 团队,公开了他们的独立力作:RATIO。
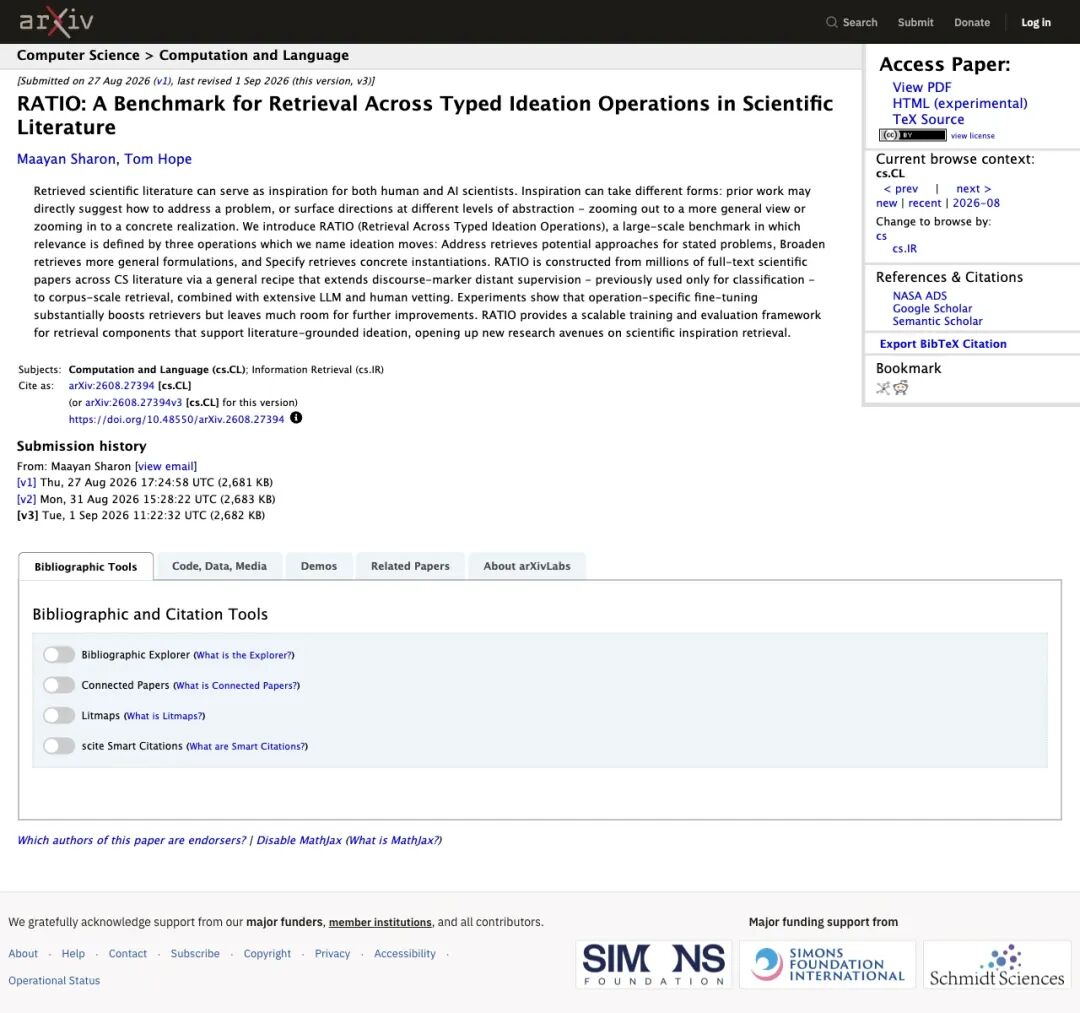
▲ Tom Hope 团队的 RATIO 预印本,开辟了类型化构思操作的检索新路
一时间,科学人工智能领域最聪明的两拨人,在 Twitter 上展开了极具深度的思想交锋。
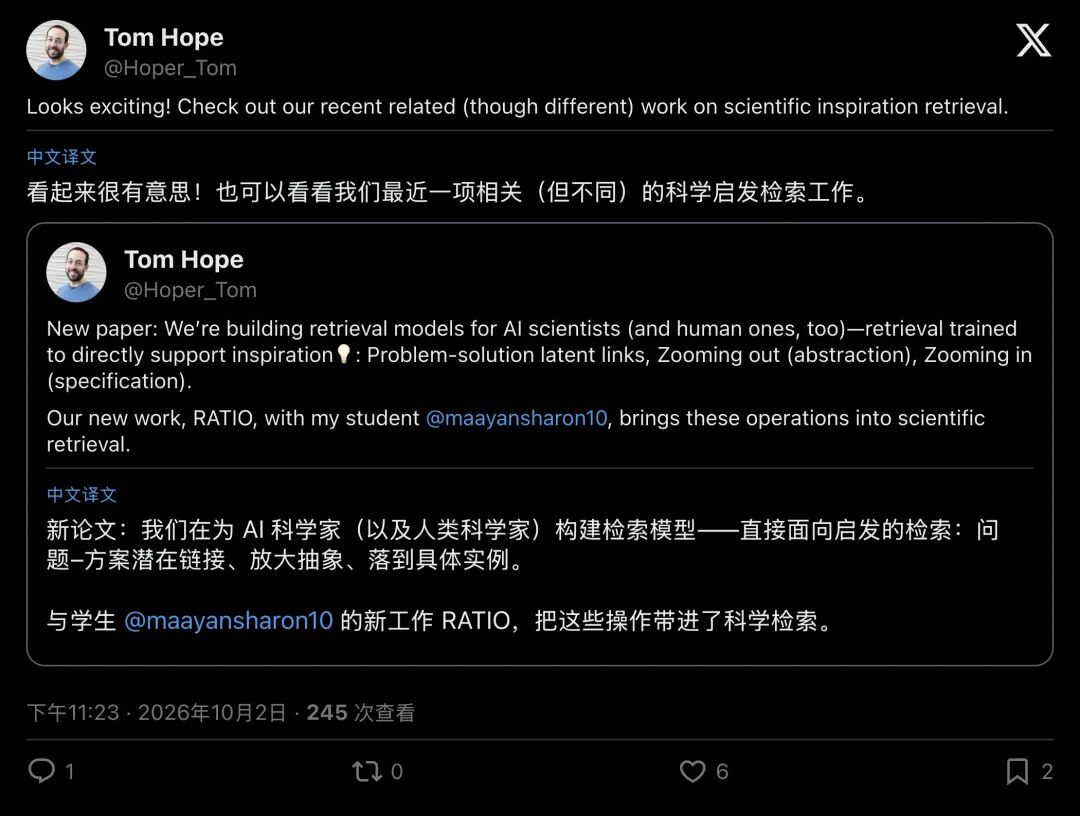
▲ Tom Hope 引用并讨论 ScholarCatalyst,指出两条路径的互补性
这场交锋的背后,折射出两种截然不同的 AI 进化哲学:
流派一:RATIO 的“计算构思学”(可扩展的理性主义)
Tom Hope 团队认为,灵感虽然看似神秘,但可以被拆解为标准认知操作。他们定义了三种跃迁动作:
- 解决(Address)
:面向具体痛点寻找解法; - 拉远视角(Broaden)
:遇到瓶颈时向上抽象,寻找通用的数学框架; - 聚焦落地(Specify)
:将形而上的构想向下落实到具体的工程物理实例。
为了实现规模化,RATIO 放弃了昂贵的人工作坊,利用算法从数百万篇文献的话语连接词(Discourse Markers)中进行“远监督”挖掘。它的优势在于规模无限大,能喂饱几十亿参数的稠密网络进行预训练;但它的软肋在于,机器依然只能挖掘“前人显式写在纸面上的逻辑关系”。
流派二:ScholarCatalyst 的“认知现象学”(高保真的经验主义)
而斯坦福团队则坚定地守护着人类直觉的堡垒。他们认为,仅从文本表面挖掘连接词容易停留在字面逻辑。科研品味依赖顶尖科学家在一线积累的默会认知与高价值难负例。它的优势在于每一条数据都是含金量拉满的“真金白银”;但它的局限也很致命,无法规模化,全球顶会的一作就那么多人,谁有空天天陪大模型标数据?
05.终局推论:没有品味的狂暴算力,只是一台复印机
这场关于“科研品味”的大讨论,最终将所有人的目光引向了同一个核心命题:
随着 AI 逐渐接管代码编写与常规实验,未来的科学竞争,究竟在比什么?
合作者 Bo Liu(Benjamin Liu)在转发主帖时留下的那句评论,或许道破了未来十年的天机:
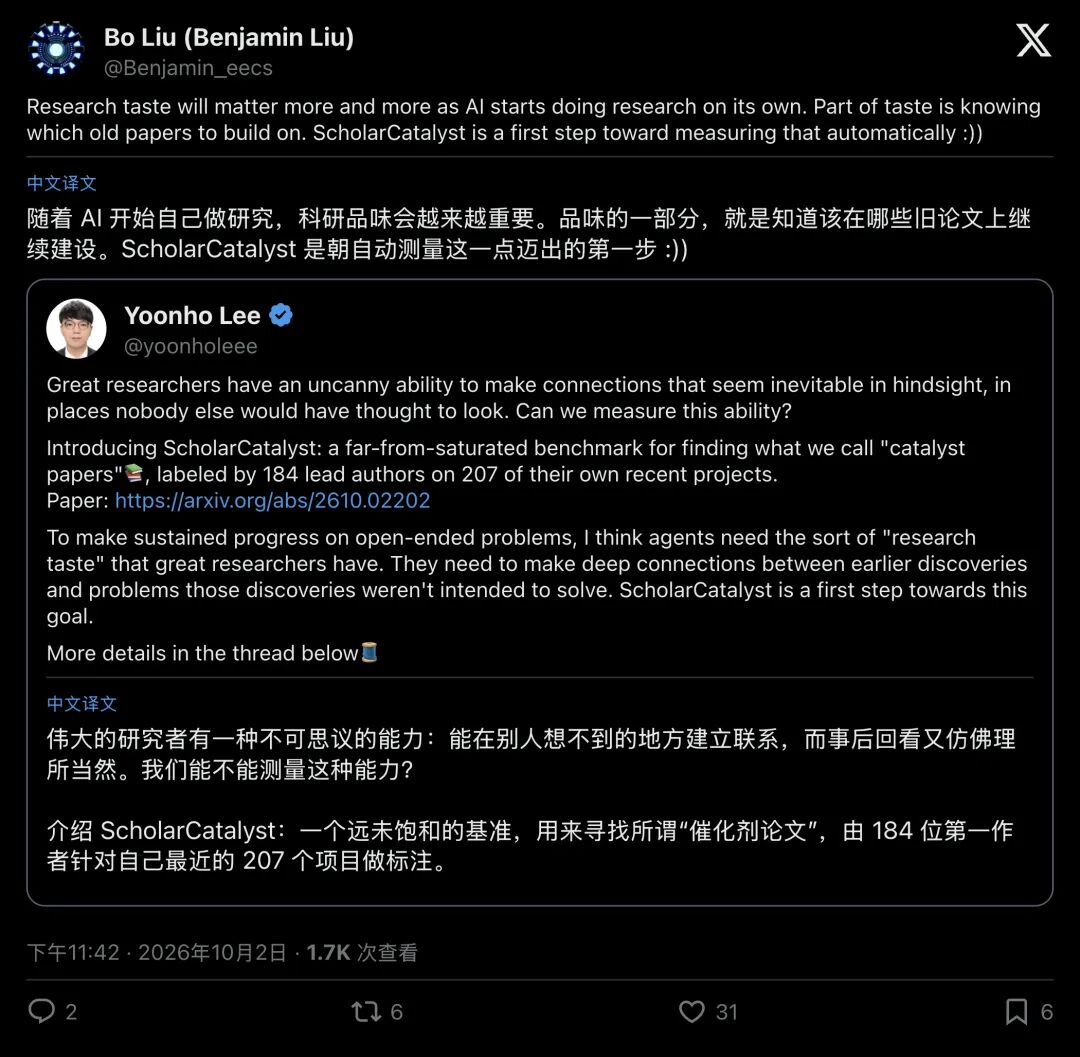
▲ 合作者 Bo Liu 的深刻洞察:随着 AI 自主科研能力的推进,科研品味成为决定高度的核心要素
“当 AI 开始自己做研究时,科研品味不但不会贬值,反而会变得前所未有地重要。品味的一部分,就是知道到底该站在哪些旧论文的肩膀上继续建造。”
今天的很多深度研究智能体,本质上是在用巨大的算力堆砌“勤奋的平庸”。它可以在五秒钟内读完两百篇论文,并写出一份格式无可挑剔的综述;但在面对一个前沿的全新危机时,它选不出那一篇十年前被埋没在冷门期刊里、却能逆转乾坤的“解药”。
未来的技术演进,已经给出了清晰的路线图:模型或许可以借助 RATIO 的海量抽象运算完成跨领域跳转训练,但终究要在 ScholarCatalyst 设立的真实基准面前,接受学者深层直觉的检验。
机器可以持续提升计算通量,而科学发现的突破高度依赖直觉筛选而非盲目穷举。
科学探索需要在广阔的假设空间中,凭借敏锐的审美直觉定位决定性的拼图。在算法具备同等鉴别能力之前,突破性研究的火种依然由人类的灵感点燃。