ARTICLE · 1126691
AI智算网络01、一个亿买的GPU集群慢了3倍真凶竟是交换机的一个参数
🌐 AI智算网络系列 · 第01篇
💥 一个亿买的GPU集群慢了3倍真凶竟是交换机的一个参数
AI智算网络系列开篇 · 从一次真实排障,讲清网络怎么决定训练效率传统网工该往哪转,文末给你一条6个月路径
📅 2026年更新 · ⏱️ 阅读约15分钟 · 🎯 适合传统网工转型 · 🆓 免费开篇
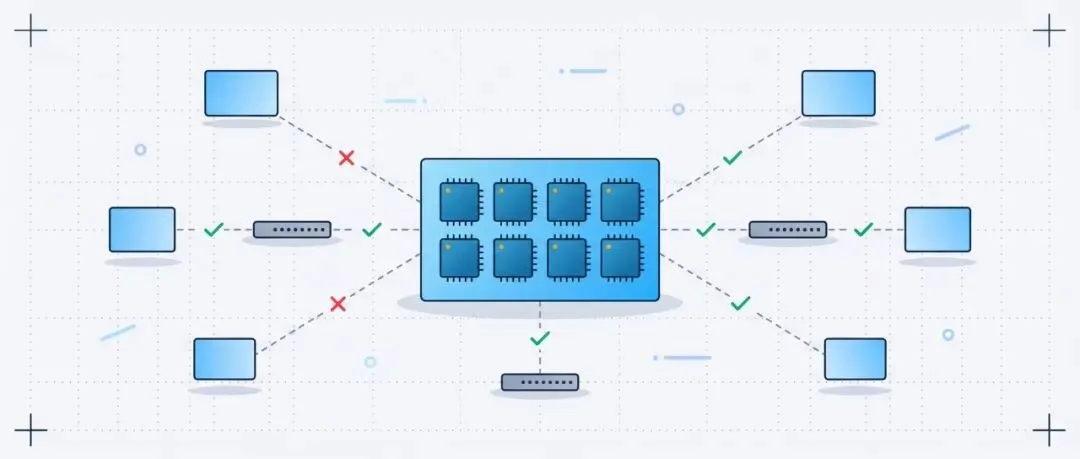
👆 封面:一台8卡GPU服务器与周边节点互联——绿勾=链路健康,红叉=丢包链路,这正是智算网络要解决的问题
📑 目录导航
1一个真实故事——千卡集群训练慢3倍的真凶
2AI训练的通信本质——每一步都在求网络
3为什么传统以太网扛不住——TCP/IP的3个硬伤
4智算网络的3个核心诉求——大带宽、低延迟、零丢包
5智算网络 vs 传统DC网络——5大本质区别
6学习路径建议——6个月从网工到智算网工
1一个真实故事——千卡集群训练慢3倍的真凶
🔹 去年夏天,我接到一个朋友电话,声音发愁。他们公司刚花了一亿多搭了个千卡GPU集群,准备训一个国产大模型。上线压测那天,结果让所有人傻眼——AllReduce带宽只有理论值的30%,训练速度比同规模集群慢了整整3倍。
排查过程挺戏剧。GPU没问题、服务器没问题、光模块都是全新400G。运维团队一开始怀疑是NCCL配置,调了一周水线参数,提升不到5%。最后请来一个懂网络的老师傅,让他抓了半小时包,指着屏幕上一片密集的PFC pause frame说:「你们这个网络在不停打嗝」——某台ToR交换机的PFC水线设低了,整网每秒被反压上千次,带宽根本跑不起来。
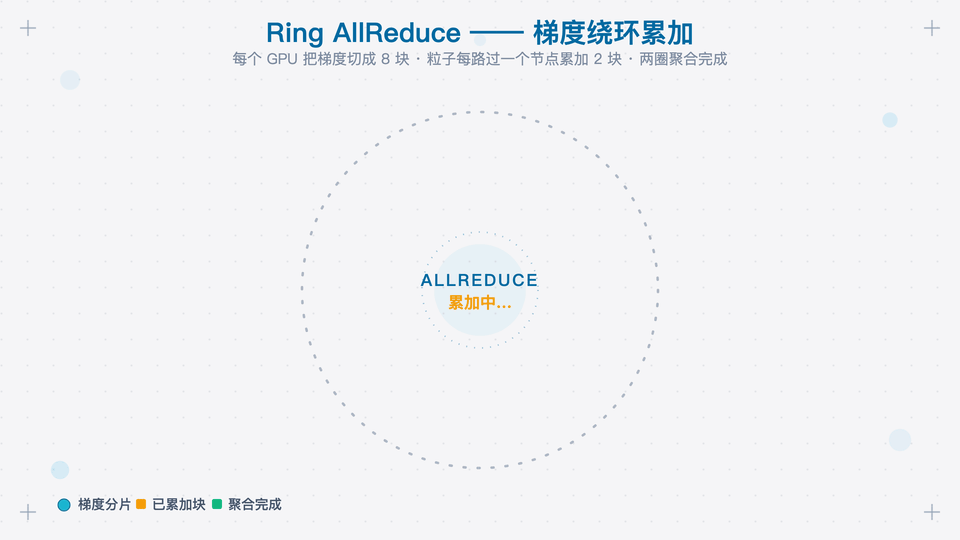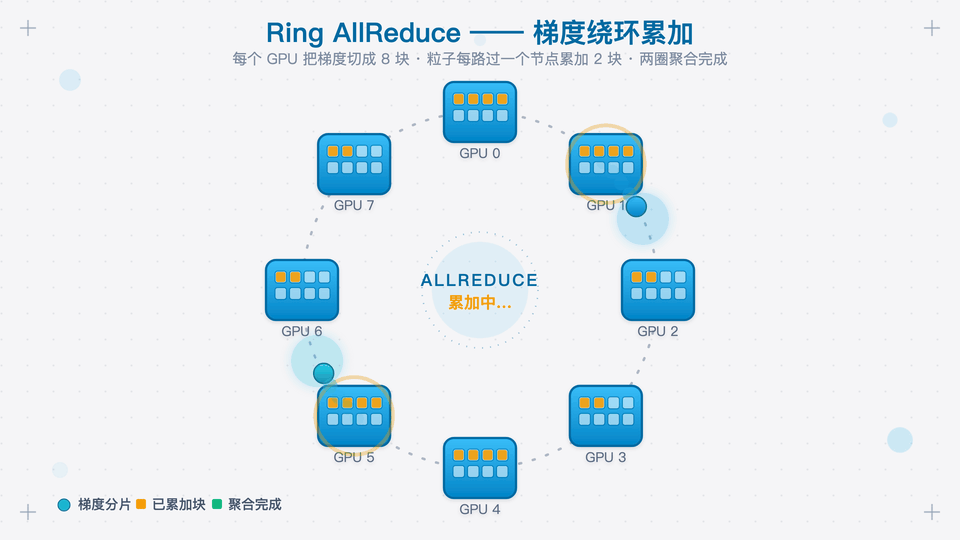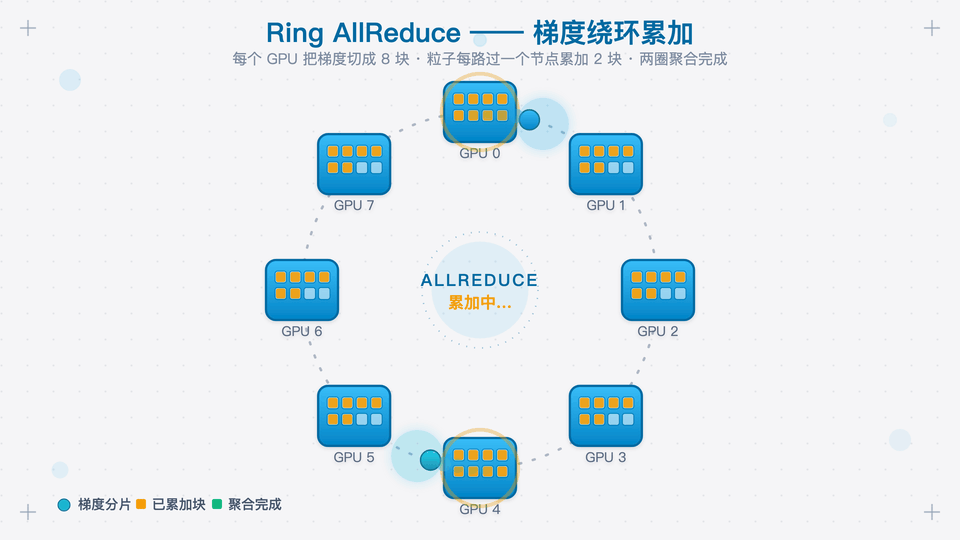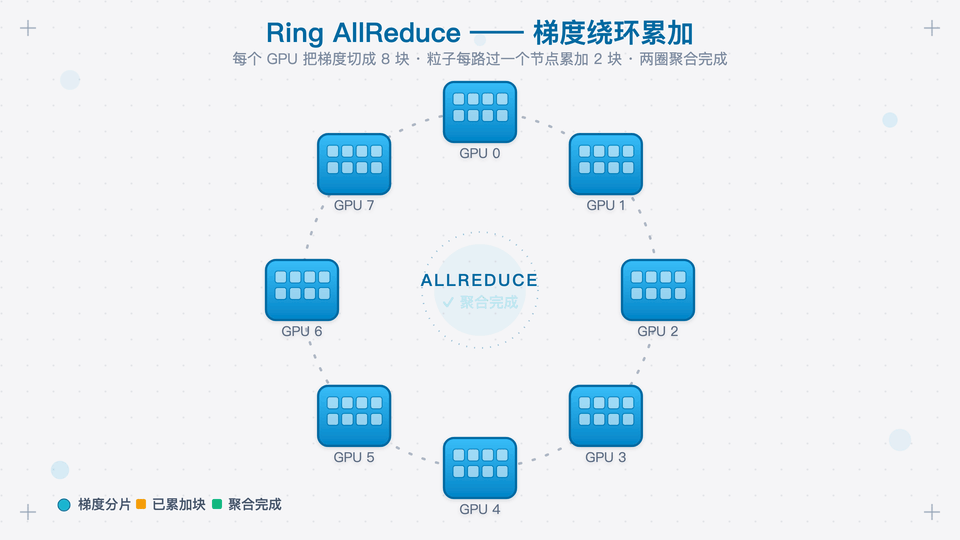
👆 动图:8个GPU围环,梯度分片粒子绕环流动,每路过一个节点累加2块,两圈聚合完成
改完水线,再压测,AllReduce带宽从30%飙到85%,训练速度直接翻了3倍。一亿多的集群,因为一个交换机参数没调对,白白烧了半个月电费。这件事让我意识到:智算时代,网络不再是后台管道,网络就是算力本身。
⚠️ 这不是个例
这是智算中心的典型故障:硬件全是最贵的,但网络调参没到位,算力就跑不出来。我后来在好几个客户那儿见过类似场景——80%的智算性能问题,根因都在网络,不在GPU、不在服务器。这就是为什么我们需要专门学「智算网络」。
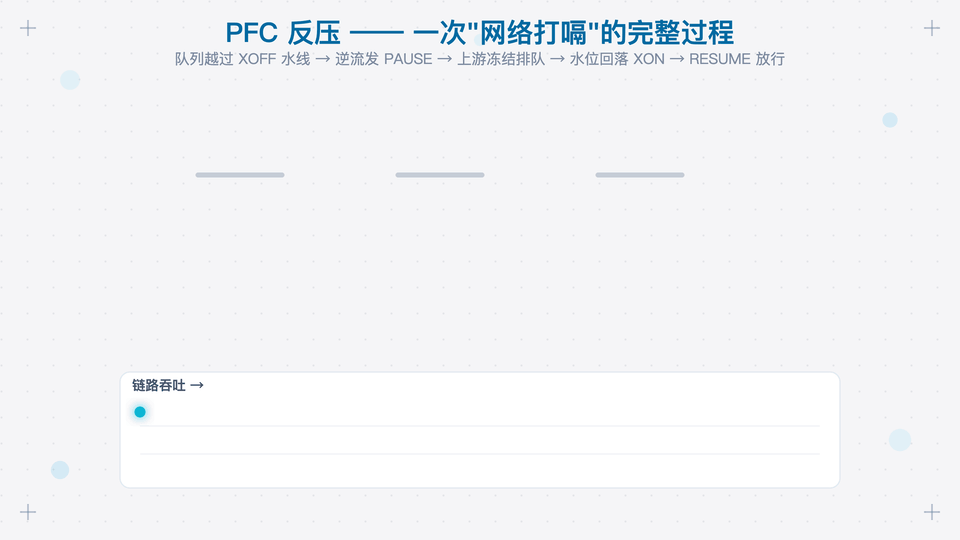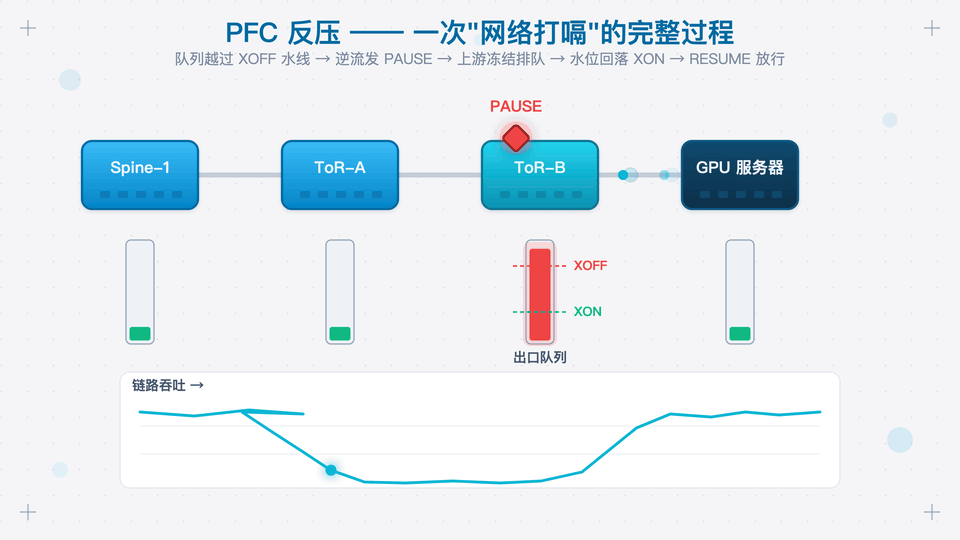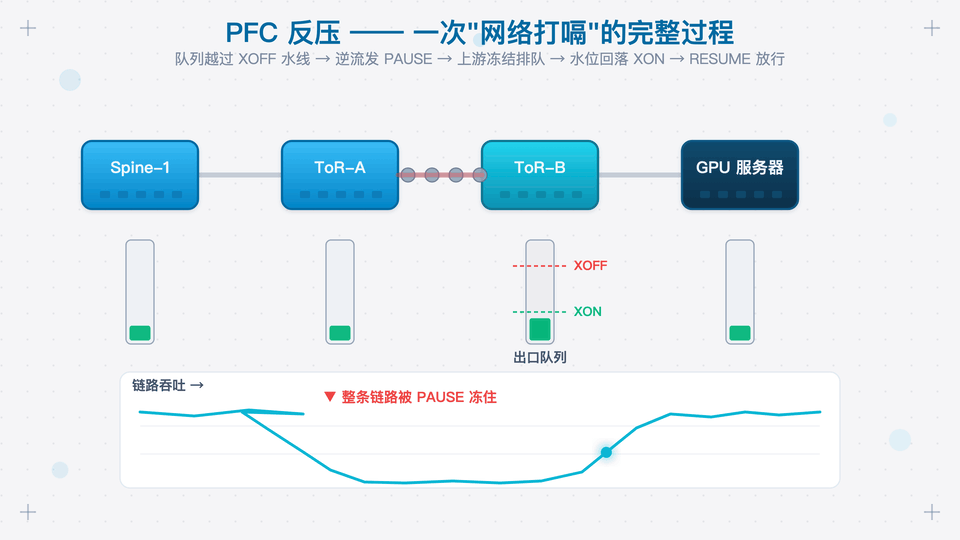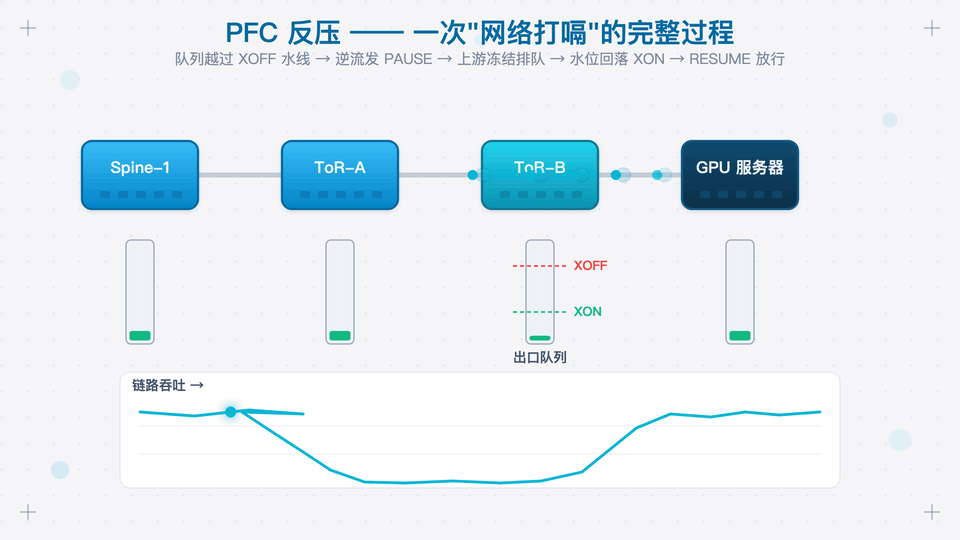
👆 动图:ToR队列越过XOFF水线→逆流发PAUSE帧→上游冻结排队→水位回落→RESUME放行,底部吞吐曲线同步"打嗝"
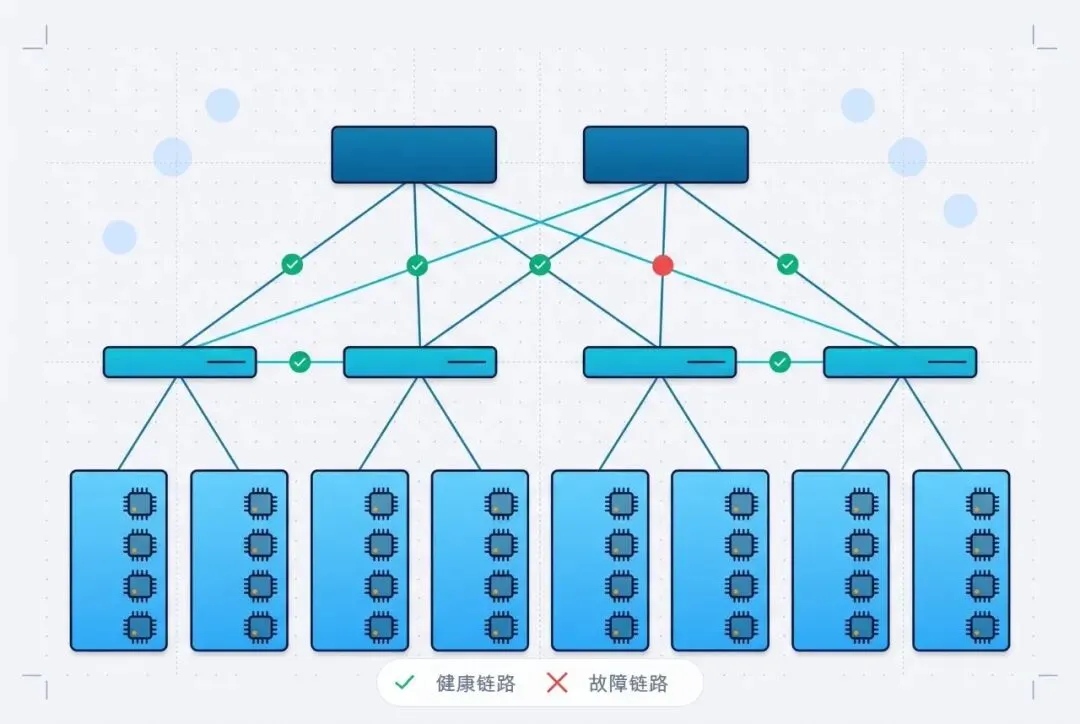
👆 静态图:千卡集群 Fat-Tree 组网全景——底层8台GPU服务器 → 中层4台ToR交换机 → 顶层2台Spine,绿勾=健康链路,红点=单链路故障点
2AI训练的通信本质——每一步都在求网络
🔹 要理解智算网络,得先搞懂一件事:大模型训练为什么这么吃网络? 我们先看一次训练里到底发生了什么。
大模型训练用的是「数据并行」——把一堆GPU卡分到多台服务器上,每张卡吃一批数据,各自算反向梯度,然后把所有梯度汇总取平均,再同步给每张卡。这个过程叫 AllReduce,是集合通信的一种。
打个比方。想象你有100个工人一起做同一份作业的不同部分,做完之后得对答案。每个人都要把自己算的结果告诉其他人,其他人也要听到所有人的结果才算完成。这100个人互相说话的数据量,远比一个人闷头算的数据量大得多——这就是「通信开销」。
💡 生活类比:AllReduce就像开早会
AllReduce就相当于100个人的早会,每个人都要把自己昨天的进度同步给所有人。最笨的办法是每人把自己的消息对其他99人各说一遍——队伍越大,每个人要说越多。聪明的办法是大家围成一圈,每人只跟左右邻居传话,传两圈所有人都拿到了全量消息——不管队伍多大,每人只需传不到一份自己消息的量。这就是后面会讲的 Ring AllReduce:每张卡只需收发 (N-1)/N × 梯度大小 的数据,几乎与集群规模 N 无关。但无论哪种办法,这100个人之间的「说话」量都比「干活」量大,说话靠的就是网络。
一次训练迭代的三步走
📝 第一步 前向传播:每张卡吃一批数据,跑一遍模型,算出预测值。这步几乎不通信。
📝 第二步 反向传播:算预测值和真实值的误差,反推每个参数该往哪调。这步也不怎么通信。
📝 第三步 梯度同步(AllReduce):每张卡把自己算的梯度汇总、取平均,再发给所有人。这一步网络压力最大,也是智算网络的瓶颈所在。
一个训练任务要做几万次这样的迭代,每一次都要来一次 AllReduce。大模型的梯度动辄几十GB,千卡集群一次 AllReduce 要在网络上搬几十GB数据。如果网络慢了,GPU就只能干等——GPU越贵,等网络的时间越亏。
3为什么传统以太网扛不住——TCP/IP的3个硬伤
🔹 既然训练就是要搬数据,那用传统以太网不就行了?毕竟我们现在互联网不也跑得好好的。答案是:不行,差得远。传统以太网扛TCP/IP协议栈这套,在智算场景下有3个硬伤。
硬伤一:内核协议栈开销——数据要绕 CPU一圈
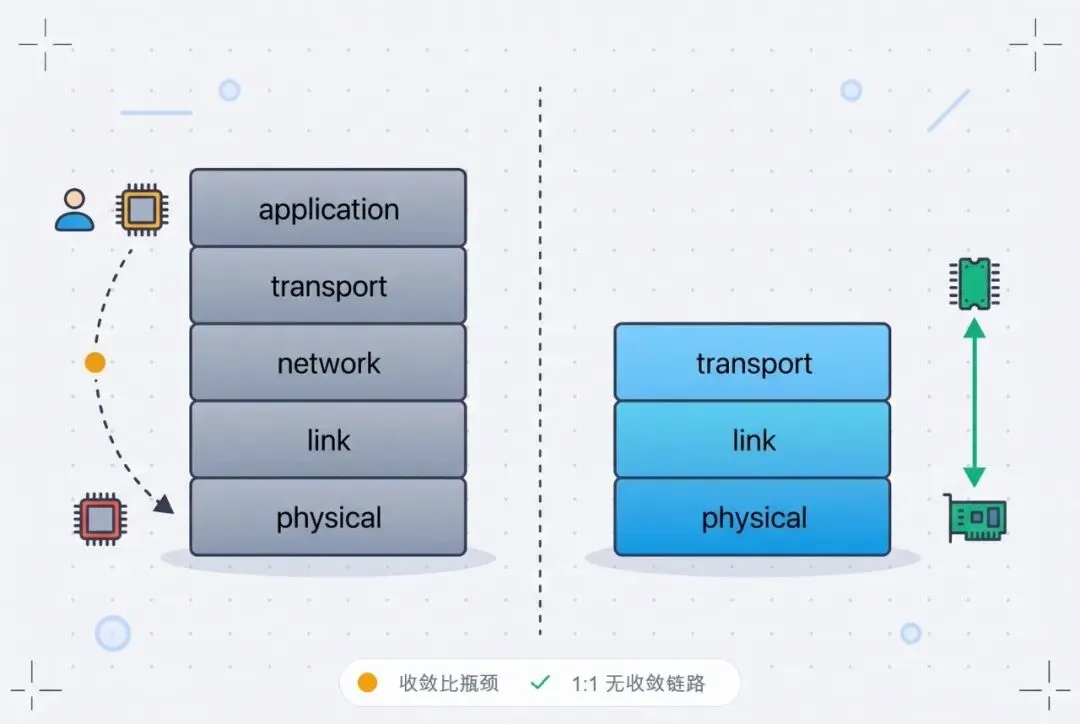
传统TCP/IP通信,数据从应用层出去要经过:用户态 → 系统调用 → 内核协议栈 → 网卡驱动 → 网卡 → 网络 → 对端网卡 → 内核协议栈 → 用户态。这中间数据要拷贝好几次,CPU全程参与。
打比方,TCP/IP就像你给同事传文件,但办公室规定:你不能直接递,必须先交前台,前台登记后转收发室,收发室再派快递,对方收到后也要走一遍同样流程。文件本身100KB,但你走流程花的时间够传10MB。小数据无所谓,大数据就是灾难。
硬伤二:丢包重传——一次丢包,整批重来
TCP是可靠传输,丢了就重传。但传统以太网默认「允许丢包」——队列满了就丢,靠TCP端到端重传兜底。互联网这么做没问题,看网页慢一点无所谓。但智算训练里,一次丢包意味着整个梯度同步要等最慢的那个流,AllReduce带宽直接砍半。
更狠的是RDMA(智算网络的灵魂协议)对丢包的容忍度极低——丢一个包会引发连锁重传:早期网卡按Go-Back-N把丢包点之后的数据整批重传,现代网卡虽有选择性重传缓解,但相对训练迭代的节奏,代价依然高昂。千卡集群一次AllReduce要搬几十GB,中途丢包,迭代速度肉眼可见地掉。万卡训练一天电费几十万——网络每停一分钟,烧的都是真金白银。
⚠️ 常见误解
很多人觉得「丢包0.1%是正常的嘛,互联网天天丢」。在传统DC这没错,在智算DC这是灾难。智算网络的设计目标是丢包率小于0.001%,最好零丢包。这跟传统网络是完全不同的工程哲学。
硬伤三:拥塞控制失控——TCP把网络当黑盒
TCP的拥塞控制是「猜」——发快了看有没有丢包,丢包了就降速。这种「丢了才知道堵」的被动策略,在互联网这种延迟大、波动大的场景下是合理的妥协。但智算网络里,交换机的队列一旦开始积压,就要立即告诉发送端「慢点」,不能等丢包了才反应——这叫「主动拥塞通知」,是智算网络的标配。
传统TCP把网络当黑盒,慢启动-拥塞避免这套算法在微秒级延迟的智算网络里反应太慢。等它发现丢包降速时,交换机队列已经爆了,RDMA已经触发Go-Back-N重传了——损失已经发生了。
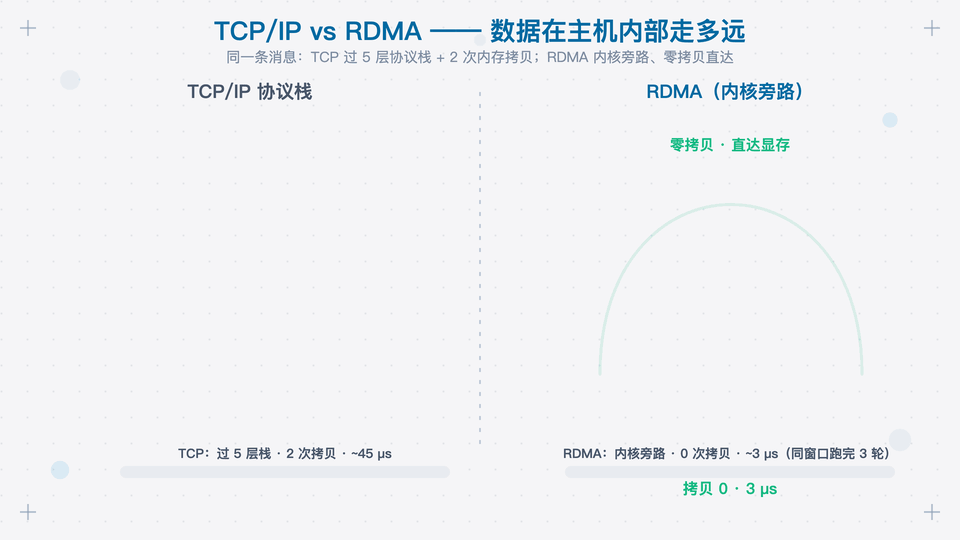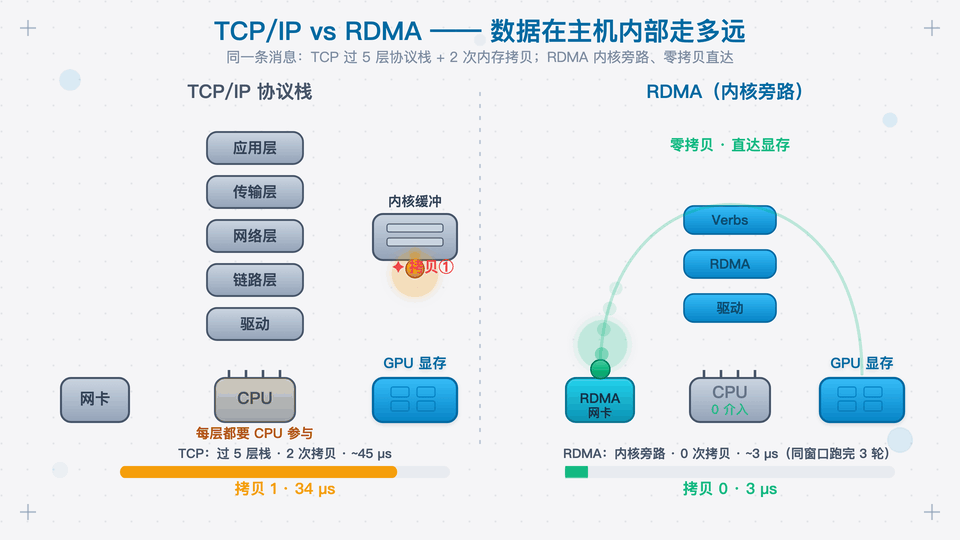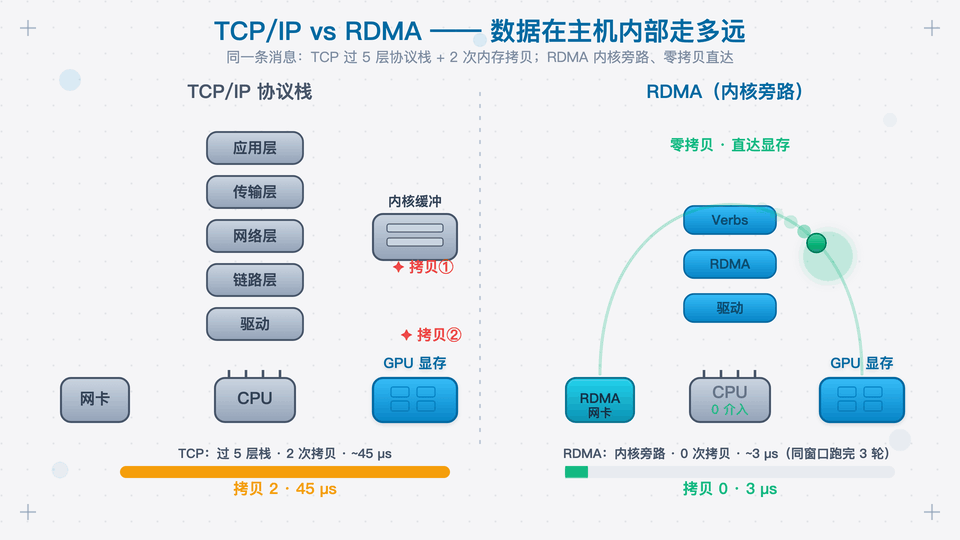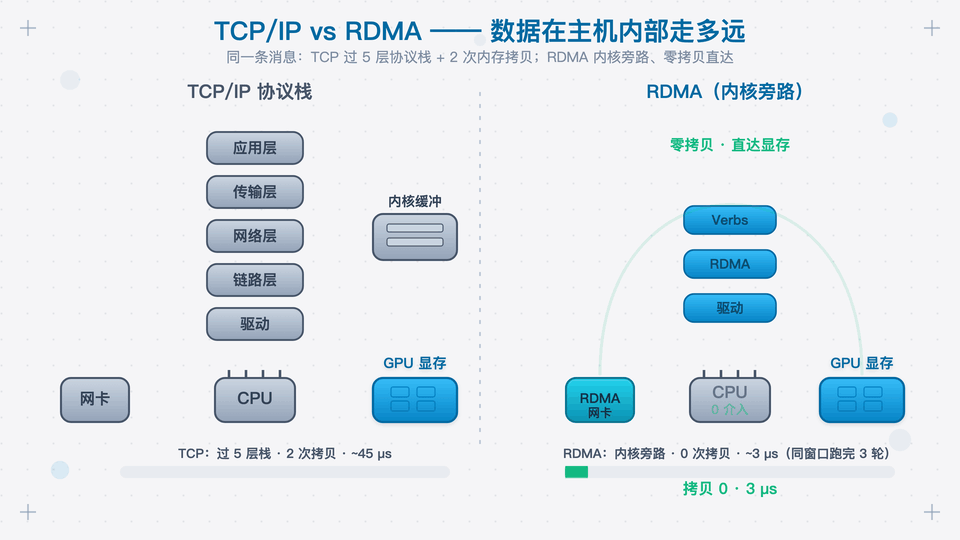
👆 动图:左侧TCP/IP 5层栈数据绕CPU(琥珀慢路径)vs 右侧RDMA 3层栈直连(绿色快路径)
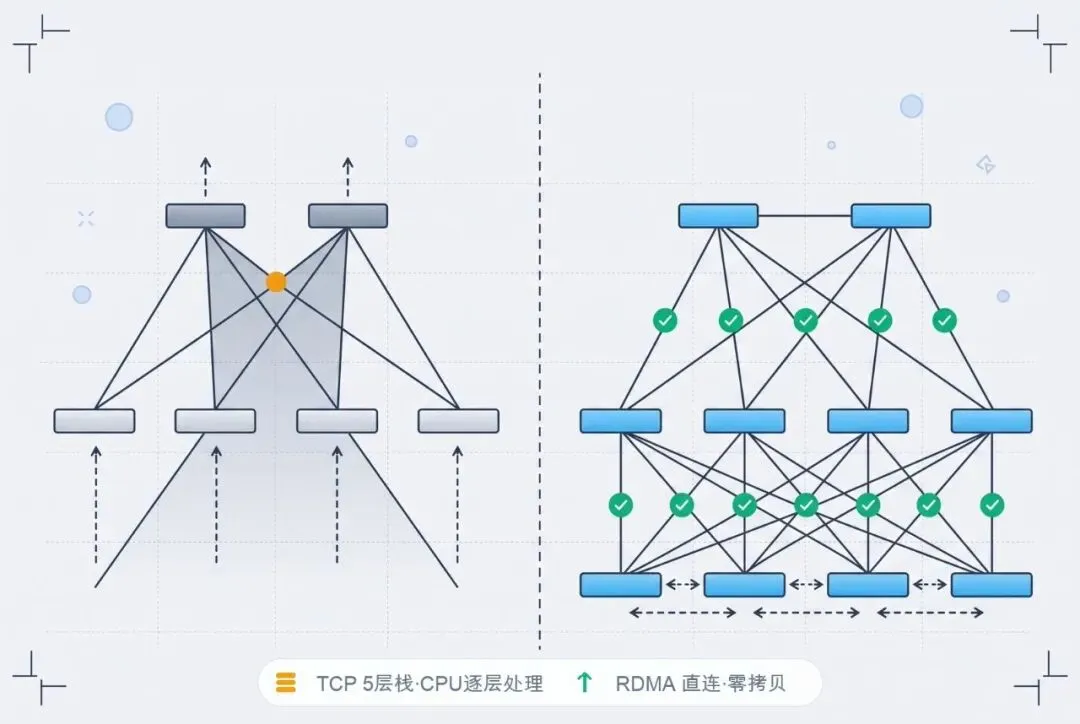
👆 静态图:左侧TCP 5层协议栈(灰,橙色虚线路径=绕CPU慢)vs 右侧RDMA 3层栈(蓝,绿色直连箭头=内核旁路快)
4智算网络的3个核心诉求——大带宽、低延迟、零丢包
🔹 既然传统以太网不行,那智算网络到底要什么?三个硬指标,一个都不能少。
| 400G/端口 | ||
| 微秒级(μs) | ||
| <0.001% | ||
大带宽——单端口400G只是起点
千卡集群一次 AllReduce 要搬几十GB梯度。如果网络是100G带宽,搬运时间会占整个迭代的60%以上——GPU有大半时间在等网络。把带宽提到400G,通信占比能压到20%以内,GPU才真正「跑起来」。所以现在智算交换机起步就是400G,明年普及800G,再往后是1.6T。
低延迟——微秒级之争
AllReduce有个特性:整体速度取决于最慢的那一跳。哪怕99%的链路都是0.5μs延迟,只要有一条链路是5μs,整批数据就要等这条链路。所以智算网络对延迟的要求不是「平均低」,而是「最差也低」——也就是低抖动。这跟传统DC追求「平均延迟低」是完全不同的指标。
零丢包——无损网络的由来
RDMA对丢包零容忍,但以太网天生会丢包(队列满了就丢)。怎么办?智算网络搞了一套「无损网络」机制——PFC(优先级流控)让下游堵了能通知上游别发,ECN(显式拥塞通知)让交换机发现水位高了能打标通知端点降速。这套机制我们第05篇会专门图解,这里先记住一句话:零丢包不是天生就有的,是靠PFC+ECN硬撑出来的。
🎁 今晚就能试:2条命令,看你机房有没有在"打嗝"
开篇故事里那种"网络打嗝",其实现在就能在你自己的设备上查。交换机侧和服务器侧各一条:
# 服务器侧:看网卡收发了多少PFC pause帧(Linux)ethtool -S eth0 | grep -i pause# 交换机侧:看接口pause统计(华为CE/CloudEngine)display interface | include pause💡 pause计数持续增长≠一定有故障,但它非零就说明网络在反压——训练变慢时先查这里。完整的4个关键计数器和排障四步法,第15篇《PFC排障实战》给你整套脚本,先把这两条存下来。
5智算网络 vs 传统DC网络——5大本质区别
🔹 同样叫「数据中心网络」,智算DC和普通DC从架构到运维完全是两码事。下面这张表是我踩了一年多坑总结出来的,每一行都是一个认知转变:
| 东西向P2P全互联 | ||
| Fat-Tree(1:1无收敛) | ||
| RDMA(内核bypass) | ||
| 延迟+抖动零容忍 | ||
| 丢包率、微秒级延迟 | ||
区别一:流量模型变了——从南北向到东西向全互联
传统DC流量是「南北向」——用户从外网访问服务器,流量从边缘进入。智算DC流量是「东西向P2P全互联」——每张GPU都要跟其他所有GPU同步梯度,任意两点之间都可能有大流量。这意味着不能像传统DC那样「上层收敛」,必须做到1:1无收敛比。
区别二:组网架构变了——从Spine-Leaf到Fat-Tree
Spine-Leaf允许收敛比(比如1:3),上层带宽比下层小,省成本。但智算要1:1全互联,传统Spine-Leaf扛不住——所以改用 Fat-Tree(胖树),每层带宽递增,消除瓶颈节点。Fat-Tree的k值推导和层级计算,我们在第10篇会专门讲。
区别三:传输协议变了——从TCP/IP到RDMA
这个前面已经讲过,TCP/IP内核开销太大。RDMA(Remote Direct Memory Access,远程直接内存访问)的核心是绕过CPU和内核——网卡直接读写远端内存,CPU不参与,零拷贝。这就是智算网络速度的根源。RDMA有三个流派:iWARP、RoCEv2、InfiniBand,下一篇我们会专门对比。
💡 生活类比:RDMA就是「门到门快递」
TCP/IP像「公司间发文件走收发室」——文件要先到前台、转收发室、派快递、对方收发室接收、再转交本人。RDMA像「两个部门直接打通一条传送带」——文件从你手上直接传到对方手上,前台、收发室、快递员全不参与。传送带就是网卡的RDMA引擎,绕开所有中间环节。
区别四:性能指标变了——从「通不通」到「快不快、丢没丢」
传统DC网络运维,主要看「链路通不通、可用性99.99%」。智算DC运维要看丢包率(要小于0.001%)、看微秒级延迟、看PFC pause帧计数。同样是「监控」,监控的指标和阈值完全不同。传统网工到智算网工,最大转变就是指标体系的转变。
区别五:运维重点变了——从连通性到丢包率
传统网络排障,第一步永远是ping,看通不通。智算网络排障,ping通了不代表没问题——丢包率0.01%在ping里根本看不出来,但训练就是跑不快。所以智算网络排障要从「看连通」转向「看丢包、看延迟、看PFC/ECN计数器」,这是思维方式的根本转变。
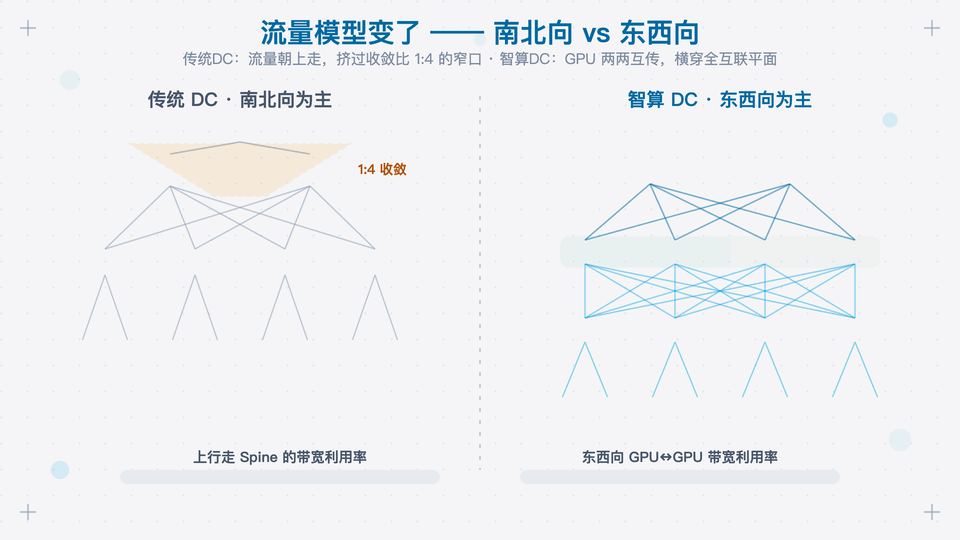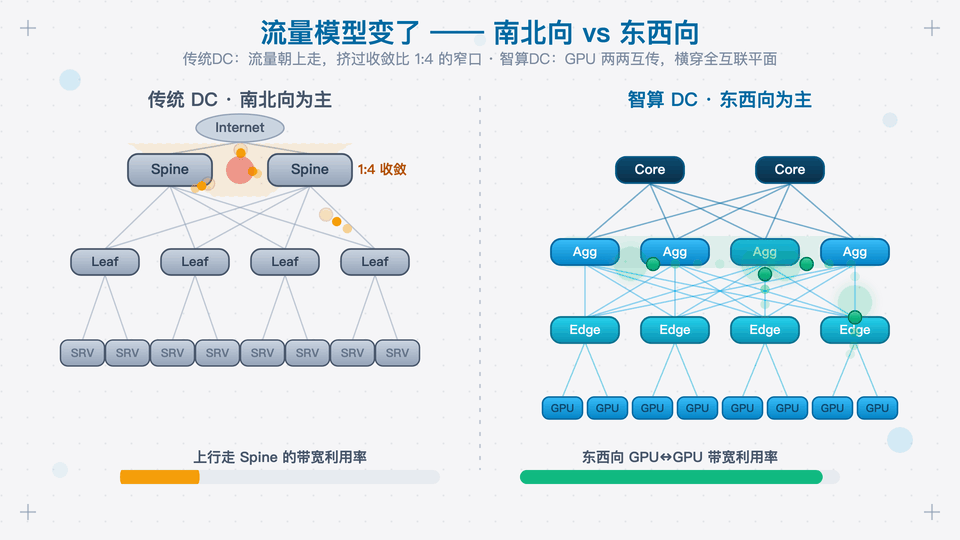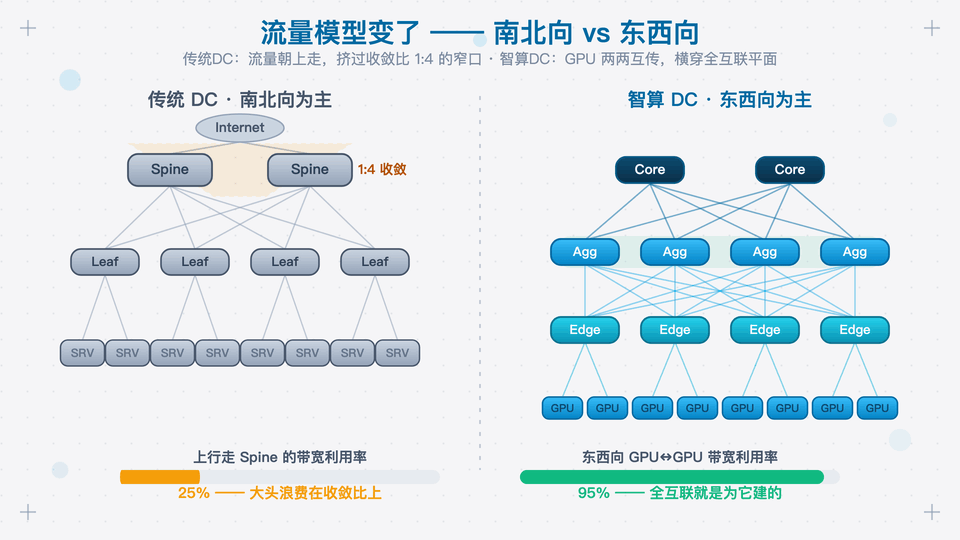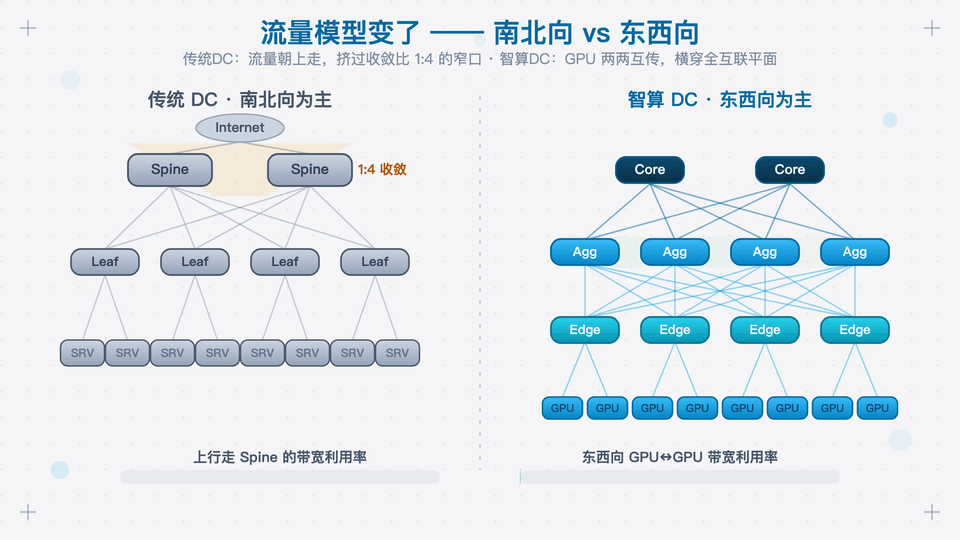
👆 动图:左侧传统DC南北向垂直流量(琥珀瓶颈)vs 右侧智算DC东西向P2P并行流量(绿色)
👆 静态图:左传统DC南北向流量挤过收敛窄口(灰+琥珀点=瓶颈)vs 右智算DC东西向全互联(蓝+绿勾=1:1无收敛)
6学习路径建议——6个月从网工到智算网工
🔹 看到这里,传统网工朋友可能会问:我要转智算,从哪开始?我给一条亲测可行的6个月路径,分4个阶段,每阶段1.5个月。
阶段一(第1-1.5个月):建立智算认知
读这个系列的第01-05篇,把智算网络的基本概念吃透:什么是RDMA、为什么用RoCEv2、PFC/ECN/CN三件套怎么协作。这阶段不碰命令、不碰代码,先建立「为什么」的认知,再去看「怎么做」才不会懵。
阶段二(第2-3个月):吃透协议和组网
读第06-12篇,把RoCEv2报文封装、IB vs RoCEv2选型、Fat-Tree组网、万卡层级设计啃下来。这阶段开始有命令行了,建议搭个小环境(两台支持RoCEv2的交换机+两台带Mellanox网卡的机器)抓包验证。抓一次RoCEv2报文,胜读十篇文档。
阶段三(第4-4.5个月):运维实战
读第13-19篇,学国产方案、PFC排障、ECN调优、丢包监控、NCCL pattern分析。这阶段要能用Python/Ansible做智算交换机批量配置和监控(正好联动我的「网工Python实战」系列)。会配是一回事,会调才是真本事。
阶段四(第5-6个月):交付和压测
读第20-24篇,学自动化批量配置、Fat-Tree脚本生成、健康检查、千卡交付全流程、验收压测。这阶段的目标是:能独立带一个中小规模智算网络项目,从设计到实施到验收。
✅ 验证学习成果的标准
能用一张纸画出千卡Fat-Tree拓扑图(k值、交换机数、线缆数都能算出来)。
能用tcpdump抓到RoCEv2报文并解释每个字段的含义。
能用nccl-tests压测一个集群,并从结果判断是网络问题还是GPU问题。
这条路径不快也不慢,关键是每一步都动手,光看不做永远学不会。本系列24篇,就是按这条学习路径来设计的——基础认知 → 技术底座 → 架构设计 → 运维实战 → 自动化 → 交付案例,每个板块对应一个学习阶段。
老规矩,开篇不堆命令、不写脚本——全文只有第4章那 2 条 pause 检查命令,是留给你今晚就能动手的钩子。把「为什么」讲清楚,剩下的「怎么做」,从下一篇开始进入硬核技术——先讲清楚RDMA的三个流派到底怎么选。
📚 关于本系列
《AI智算网络》共 24 篇:基础认知 → 技术底座 → 架构设计 → 运维实战 → 自动化 → 交付案例,按 6 个月转型路径编排。点击文章上方合集标签一键追更,不错过任何一篇。
💬 聊聊你的机房
你机房现在最大的端口速率是多少?10G、25G,还是已经上 100G/400G 了?评论区报个数字,看看传统网工离智算网络到底有多远。
🔮 下篇预告
第02篇:拆开一台8卡GPU服务器——NVLink、NVSwitch和机间组网一张图看懂
📌 从「一台服务器」到「万卡集群」,把GPU集群的物理结构一次讲透
📌 附赠:千卡集群端口速算公式卡——给定卡数,3步算出交换机和线缆数
XOps之路
AI智算网络系列 · 让网络工程师看见算力时代的未来 🚀
🧡 如果这篇文章对你有帮助,欢迎点赞、在看、转发三连!
© 2026 XOps之路 · All rights reserved