ARTICLE · 1130680
AI开始从聊天工具变成真正的数字员工:OpenAI Dots全天候工作,Anthropic豪赌算力,AMD买下世界模型,Manus和Gemini补齐身份与时间
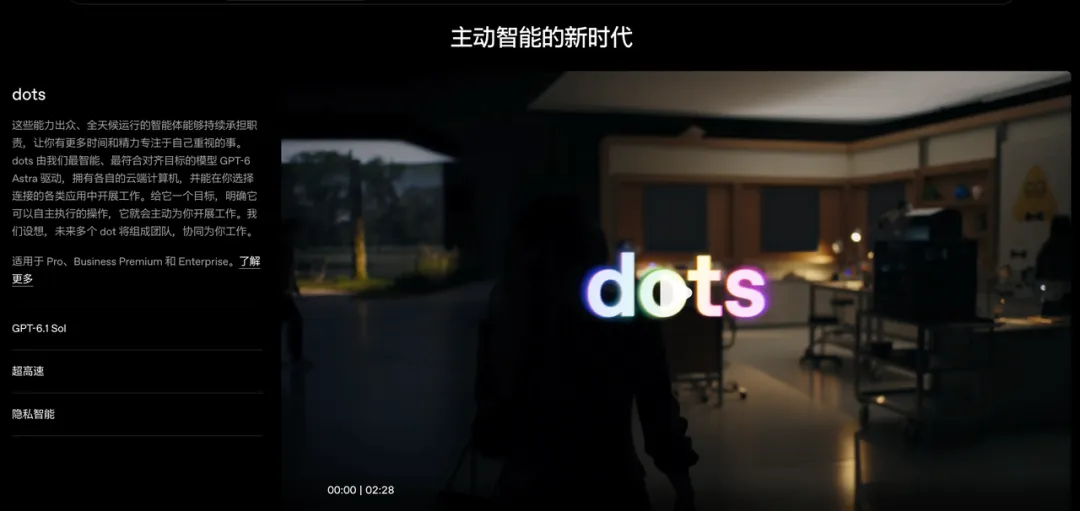
OpenAI 这次真的给 ChatGPT 配上了一个“常驻小助手”。Dots 已经面向符合条件地区的 Pro 和 Business Premium 用户开放,第一次创建不用额外付费。打开 ChatGPT 桌面端或网页版,创建一个 Dot、连接需要的应用,再告诉它目标和哪些事情可以自己做,它就能拥有自己的云端电脑,24 小时继续替你跑任务。
它瞄准的也很明显:Grok Bot、Muse 这一波个人 Agent。大家已经不满足于做一个“你问我答”的聊天机器人,而是开始抢那个能长期待在你身边、记着事情、自己干活的位置。
个人 AI 助手大战,终于从“谁更会聊天”卷到了“谁更会替你过日子”。
hey 吾友😊,欢迎来到由JoinAI|卓印智能算法团队出品的:「太阳底下AI有新鲜事儿」周刊。
我们将以「AI构建者」独有的技术视角和克制,为你精心筛选出每周Top 3:论文、项目与动态,这里不关心热点流量的幻觉,只追踪真正值得关注的技术与趋势,这里不会只宣扬AI的好,同样也会揭露AI的问题。
全文字数:12059|阅读时长:5-7分钟|推荐阅读方式:收听
EVO-WAM|世界动作模型开始从“生成未来”走向“利用自己生成的经验继续学习”
EVO-WAM 让 World-Action Model 自己生成 Video–Action–State 轨迹,再用 VLM 判断任务是否完成、用 Inverse Dynamics Model 检查动作与视频变化是否一致,只把通过双重验证的轨迹重新用于训练。Cosmos3 在 7 个未见 RoboTwin 2.0 任务上从 26.9% 提升到 68.0%,真实世界长时序任务从 20.0% 提升到 76.7%。它释放出的信号是:机器人模型正在尝试把“世界模型的想象能力”直接变成新的训练数据,未来具身智能的数据 Scaling 可能不只依赖更多真人示范,还会越来越依赖模型自主生成、验证和筛选经验。
VISTA|多模态Agent开始拥有可以随时回看的“视觉记忆”
MIT 提出 VISTA,不训练新的视觉模型,而是给通用多模态模型增加一套长期视觉交互 Harness:当前环境直接以原始图片输入,所有历史画面无损保存,Agent 可以主动重新查看旧帧、局部区域甚至像素,再配合文本笔记维护规则与假设。Claude Opus 5.0 在 ARC-AGI-3 公开游戏中完成全部 25 个游戏,GPT-5.6 Sol 也达到 98.27。它释放出的信号是:长时 Agent 的 Memory 不一定都要压缩成文字,GUI、Computer Use 和机器人可能需要保留“原始视觉证据”,让模型在需要时重新观察过去,而不是只依赖越来越长的 Context Window。
Sigma|Diffusion LLM开始从离散Token走进连续潜空间
Sigma 将文本扩散过程放到学习得到的连续 Embedding 空间,通过 ODE/SDE 轨迹完成生成,并把 Continuous Diffusion Language Model 扩展到 3B 和 8B 规模。连续空间让模型可以更自然地使用 Guidance、Score Temperature 和不同采样步数,并通过 AR 模型权重 Warm Start 降低训练难度。它释放出的信号是:Diffusion LLM 的路线正在进一步分化,未来除了 Mask Token 式离散扩散,连续潜空间也可能成为一条独立路线,把图像扩散领域成熟的 Steering、Few-step Distillation 和采样控制方法带进语言模型。
Clef|Agent开始把高频决策交给“不说话”的System One模型
Cloudflare 开源 Clef,可直接接收文本、JSON、图片或视频,并输出 Boolean、Choice、Score 及对应概率,而不需要逐 Token 生成自然语言。模型基于冻结的 Qwen3.8-27B Backbone,通过专门的 Joint Schema Head 完成结构化判断;Clef-flash 的官方 Median Latency 进一步降到 38.8ms。它释放出的信号是:Agent 架构正在从“什么都调用生成式 LLM”转向分层设计,路由、分类、风控、排序和 Tool Selection 等 Hot Path 很可能逐渐交给更快、更便宜、更容易校准的专用决策模型。
Strata|125B级模型开始尝试跑进普通游戏PC
Strata 通过 GPU、CPU、RAM 和 SSD 分层协同,让超出显存容量的大型 MoE 模型在单张 12–24GB 显卡的普通 PC 上运行,并提供本地 OpenAI/Anthropic 兼容 API、MCP、Web UI 和 Coding Agent 接入。官方测试中,RTX 5070 12GB 配合 64GB RAM 运行量化模型时,短文本生成约 94 tokens/s。它释放出的信号是:本地大模型正在从“跑一个小模型”走向“用消费级硬件承载超大 MoE”,如果分层加载、Expert Placement 和量化继续进步,个人 Agent 的算力底座可能越来越多地回到用户自己的电脑。
Ponytail|Coding Agent开始学习“少写代码也是一种能力”
Ponytail 是一套面向 Coding Agent 的极简工程 Skill,要求模型先判断功能是否真的需要,再依次检查现有实现、标准库、平台原生能力和已有依赖,最后才新增最小必要代码。项目提供 Review、Audit、Debt、Gain 等 Skills,在官方有限测试中平均减少 54% LOC、22% Token、20% 成本和 27% 时间。它释放出的信号是:Vibe Coding 的下一阶段不只是让 Agent 写得更多更快,而是开始通过 Skill 和 Harness 约束“不要过度开发”,工程质量可能越来越取决于 AI 是否学会克制。
OpenAI Dots|个人Agent开始从“等你提问”变成“长期替你负责”
OpenAI 在 DevDay 2026 发布 Dots,每个 Agent 拥有独立云端电脑,可以在用户离线时继续执行任务,并通过插件生态连接外部应用;用户不再需要不断给出下一步指令,而是设定长期目标、权限和边界,让 Agent 持续推进。与此同时,负责 Codex 与 ChatGPT Work 的 Tibo Sottiaux 承诺未来 28 天每天要么推出一项重要改进,要么进行一次 Usage Reset。它释放出的信号是:个人 Agent 的竞争已经从模型能力进入“体验与信任”阶段,长期运行、稳定性、额度、记忆和权限管理,正在变得和 Benchmark 一样重要。
Claude Sonnet 5.5|模型越来越便宜,AI公司却越来越像重资产基础设施公司
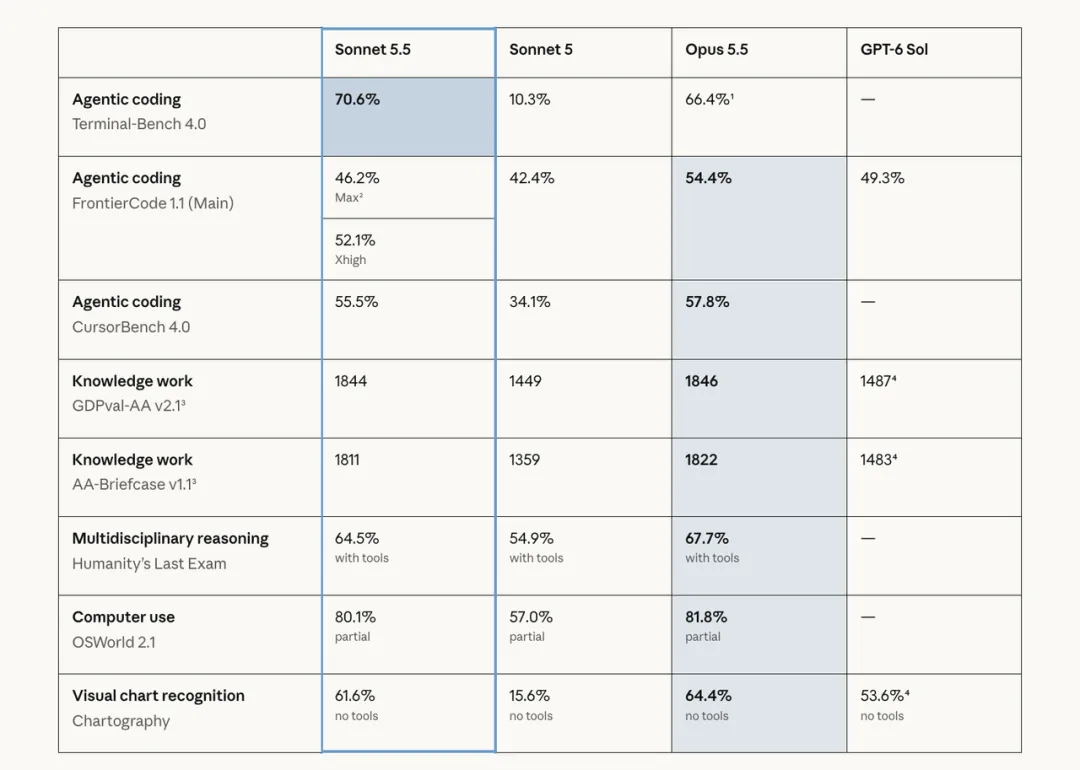
Anthropic 发布 Sonnet 5.5,输出速度提升超过 30%,多数任务实际成本最高下降 30%,Terminal-Bench 4.0 达到 70.6%,甚至超过 Opus 5.5 的 66.4%。但与此同时,IPO 文件显示 Anthropic 已承诺未来约 5180 亿美元的云计算和数据中心等基础设施投入。它释放出的信号是:AI 正出现一种越来越明显的经济反差——用户侧的 Cost per Task 持续下降,但模型公司的底层算力投入却越来越重,前沿实验室正在从“软件公司”逐渐变成云、数据中心和能源基础设施公司。
World Labs、Cue与Gemini 4 Argon|下一代Agent开始同时获得“世界、身份和时间”
AMD 宣布以约 82 亿美元收购 World Labs,把 Spatial Intelligence 和 World Model 纳入芯片公司的战略资产;Manus Cue 让每个 Agent 拥有自己的邮箱、电话号码、钱包和电脑;Gemini 4 Argon 则把单次输出上限提升至 100 万 Token,让一次 Agent Trajectory 可以持续更久。三条新闻放在一起看,指向的是同一个变化:过去行业主要给 AI 造越来越聪明的“大脑”,现在开始补齐真正工作的条件——可理解和操作的世界、长期存在的数字身份,以及足够长的执行时间。
遇到很难描述清楚的任务时,不要一直补充规则。直接给 AI 2~5 个你满意的例子,让它先总结这些例子的共同结构、判断标准和隐藏规律,再去处理新任务。
《Encore: Few-Shot Agentic Discovery of Manipulation Strategies》发现,很多任务真正关键的信息并没有写在指令里。与其不断增加说明,不如让 Agent 从少量示范中自己推断隐藏规则,再据此完成任务。
这对日常使用 AI 也一样:当你发现“怎么解释都不对”时,示例往往比更长的提示词更有效。
先分析下面这些我满意的例子,总结它们共有的结构、风格和判断标准,再按照这些规律完成新任务。不要只模仿表面格式,要提炼背后的规则。

链接:https://arxiv.org/abs/2609.38057
推荐指数:🌟🌟🌟🌟🌟
一句话导读:
EVO-WAM 让 World-Action Model 自己生成视频—动作轨迹,再用 VLM 检查任务是否完成、用 IDM 验证动作与视频是否一致,将通过验证的经验重新用于训练,在不增加专家示范的情况下持续适应新任务。
⚽️ 推荐理由:EVO-WAM 探索了 WAM 很关键的一步:模型能否利用自己的“想象经验”继续学习。现有 WAM 可以同时预测未来视频和动作,但生成的视频可能没有真正完成任务,视频看起来正确时,动作也可能与画面变化不一致。EVO-WAM 为生成经验增加两层验证,只留下任务完成且 Video-Action 一致的轨迹片段,再与原始数据混合进入下一轮训练。整个自训练过程无需执行候选动作,也不需要额外收集专家 Demonstration。这个设计为机器人模型提供了一条低成本 Task Adaptation 路线,也把 WAM 的视频生成能力进一步转化成可用于策略训练的数据来源。
新任务数据不足:机器人遇到未见任务时,继续依赖专家遥操作采集新 Demonstration 成本很高,限制了策略快速适应新任务的能力。
生成视频会出错:WAM 能预测未来视频和动作,但生成结果可能没有完成目标,也可能出现物体消失、重复等视觉不一致现象。
动作也需验证:一段未来视频即使视觉上完成了任务,对应动作仍可能无法产生画面中的状态变化,因此不能直接把所有生成轨迹作为训练数据。
自主生成经验:模型进行完整的自回归 Video-Action-State Rollout,并通过 Anchored Multi-frame Context 和状态预测维持长轨迹生成,为未见任务产生新的候选经验。
双重轨迹验证:VLM 检查任务完成、物体一致性和机器人状态,Inverse Dynamics Model 根据视频重建动作,通过 Action Reconstruction Error 判断视频与动作是否匹配。
迭代提升策略:验证后的 Prefix 与原始数据混合继续微调模型。Cosmos3 在 7 个未见 RoboTwin 2.0 任务上从 26.9% 提升至 68.0%,真实世界 3 个长时序组合任务从 20.0% 提升至 76.7%。
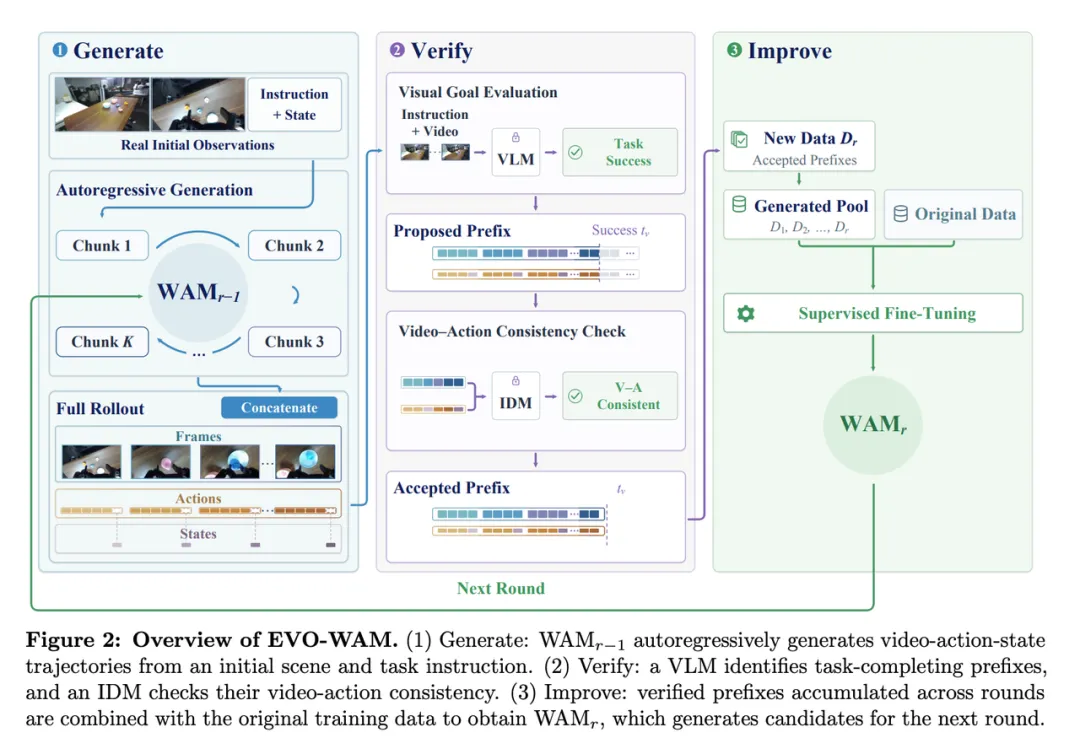
EVO-WAM 的实验结果说明,WAM 生成的未来轨迹可以成为策略改进的数据来源,前提是对这些数据进行严格筛选。VLM 与 IDM 分别控制任务完成质量和动作一致性,验证后的经验在多轮训练中带来明显收益。实验同时覆盖 Cosmos3、DreamZero、RoboTwin 2.0 和真实机器人,结果具有一定完整性。当前方法仍高度依赖验证器质量,VLM 可能误判任务完成状态,IDM 也只能判断动作与视觉变化是否一致,无法保证所有生成状态都符合真实物理过程。部分任务在中间迭代轮次也会出现性能波动。后续更重要的问题是验证系统能否随任务复杂度一起扩展,以及大量自生成经验累积后如何控制错误传播。

链接:https://arxiv.org/abs/2610.02200
推荐指数:🌟🌟🌟🌟🌟
一句话导读:
MIT 提出 VISTA,通过原始视觉输入、自由语言推理和可主动检索的无损视觉记忆,让通用多模态模型在长时序交互中持续理解环境,Claude Opus 5.0 完成 ARC-AGI-3 全部 25 个公开游戏并取得 100 RHAE。
⚽️ 推荐理由:VISTA 展示了 Harness 对多模态 Agent 能力的影响。系统没有训练新的视觉模型,也没有为每个游戏编写专门的世界模型,而是给通用多模态模型提供一套更适合长期视觉交互的接口:当前环境以原始图片输入,历史画面完整保存在外部视觉记忆中,模型可以主动查看任意旧帧、局部区域甚至像素,并通过简短文本笔记维护自己对环境规则的理解。这样可以避免长交互过程中早期视觉信息随着 Context 压缩而丢失。对于 Computer Use、GUI Agent 和具身智能,这种“视觉记忆 + 主动检索”的设计具有很强的可迁移性。
交互规则未知:ARC-AGI-3 不提供游戏目标、物体定义和环境规则,Agent 只能不断观察动作结果,自己推断状态变化和可能目标。
视觉历史易丢:长时间交互会积累大量视觉状态,依赖 Context Window 和 KV Cache 时,早期图片可能被压缩或移出上下文,重要细节难以再次检查。
长期推理需记忆:Agent 经常需要把当前状态与几十步之前的画面比较,确认某个动作究竟改变了什么,因此需要能够主动重新访问原始观察。
原图直接感知:Agent 直接读取环境返回的 PNG,不先转成符号状态或程序表示;需要观察细节时,还能放大指定区域继续进行视觉推理。
无损视觉记忆:所有历史 Frame 都按 Turn 和 Frame Index 原样保存,inspect 可以重新查看旧帧或局部区域,read_pixels 可以读取精确像素,模型自己决定什么时候检索。
长时交互显著提升:Opus 5.0 完成全部 183 个 Level、25/25 个游戏,RHAE 达到 100,使用 7,542 次环境动作,而首次人类玩家基准为 17,135 次;GPT-5.6 Sol 也达到 98.27。
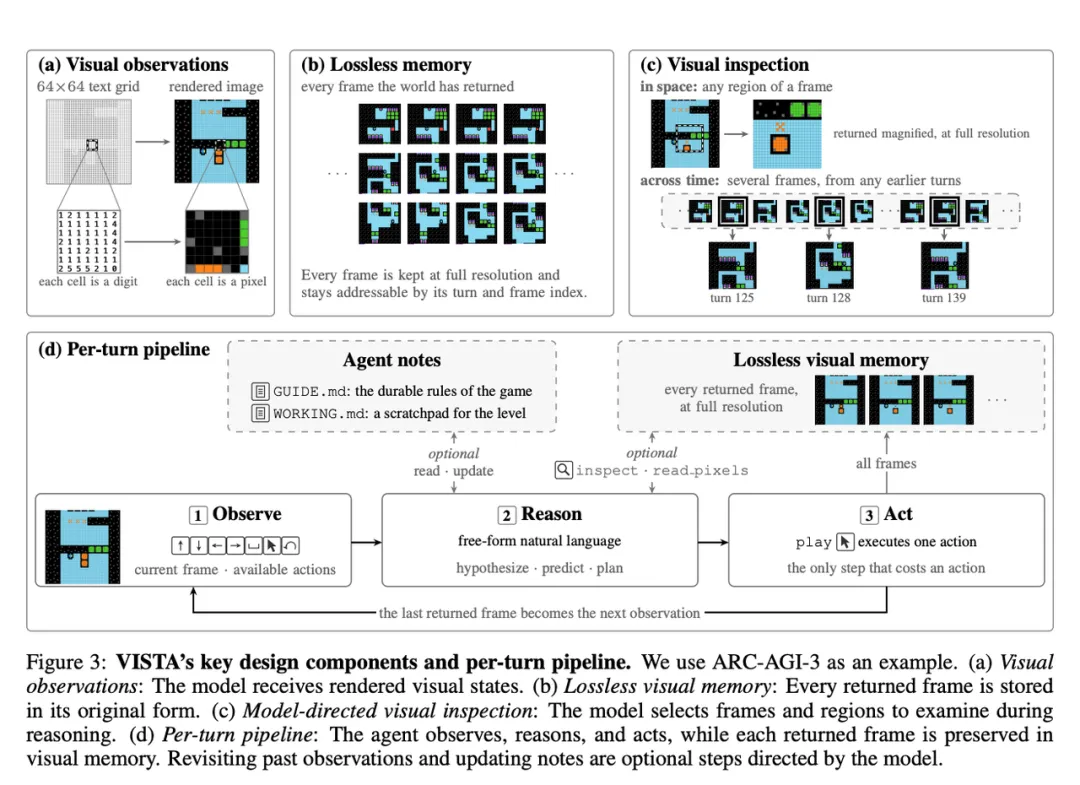
VISTA 的亮点在于方法足够简单,主要能力来自基础多模态模型和 Harness 的组合。无损视觉记忆保留原始证据,模型可以反复检查过去,而文本笔记承担抽象规则和当前假设,两种记忆形式形成清晰分工。实验中 Opus 5.0 和 GPT-5.6 Sol 都获得接近满分的结果,说明效果并非完全绑定单一模型。需要谨慎解读 ARC-AGI-3 的公开集结果:作者明确指出,测试模型发布时间晚于公开游戏发布,因此不能排除训练数据中见过这些环境的可能,真正的泛化仍需私有测试集验证。目前任务也主要是视觉游戏,与真实 GUI、Web 和机器人环境中的噪声、连续控制及失败恢复还有明显距离。

链接:https://arxiv.org/abs/2610.02665
推荐指数:🌟🌟🌟🌟🌟
一句话导读:
Sigma 将语言扩散过程放入低维连续 Embedding 空间,用可操控的 ODE/SDE 轨迹完成文本生成,并首次把 Continuous Diffusion Language Model 扩展到 3B 和 8B 规模。
⚽️ 推荐理由:Sigma 为 Diffusion LLM 提供了另一条扩展路线。目前主流 Diffusion Language Model 多在离散 Token 或 Mask 空间完成迭代生成,虽然支持并行解码,但离散状态不连续,采样轨迹的控制、Guidance 和少步推理更加困难。Sigma 把生成过程放入学习得到的连续 Token Embedding 空间,让语言生成拥有类似图像扩散模型的 ODE/SDE 轨迹,可以直接调整 Guidance、Score Temperature 和采样步数。团队进一步把模型扩展到 3B/8B,并利用预训练 Autoregressive Model 权重进行 Warm Start。它提供了一个值得关注的问题:未来 Diffusion LLM 的竞争可能不只发生在 Mask Token 方案,连续潜空间也可能形成独立技术路线。
离散轨迹难控制:Masked Diffusion 可以并行更新多个 Token,但生成空间仍是离散、高维状态,难以像连续扩散一样平滑控制生成轨迹。
少步生成仍困难:Diffusion LLM 的效率取决于 Function Evaluation 数量,降低采样步骤通常会带来明显性能下降,因此质量和计算量之间需要更灵活的平衡。
连续路线未规模化:Continuous Diffusion 在文本生成中已有探索,但此前缺少与数十亿参数语言模型规模相匹配的系统验证;Sigma 将这一路线扩展至 3B 和 8B。
连续空间扩散:Sigma 对 Gaussian-corrupted Token Embedding 进行联合去噪,同时学习适合生成的 Embedding Geometry,通过低维 ODE/SDE Latent Trajectory 完成语言生成。
复用AR初始化:模型采用 Blockwise Likelihood Optimization,并使用已有 Autoregressive Model 权重 Warm Start,降低大规模 Continuous Diffusion 从头训练的难度。
推理可以调控:Classifier-Free Guidance 和 Score Temperature 可调整生成质量与多样性;Sigma 在 GSM8K、Minerva、HumanEval、MBPP 等任务上达到与离散扩散模型具有竞争力的结果,SFT 后进一步覆盖 MATH-500 和 AIME,同时在较低 NFE 下呈现更平滑的性能下降。
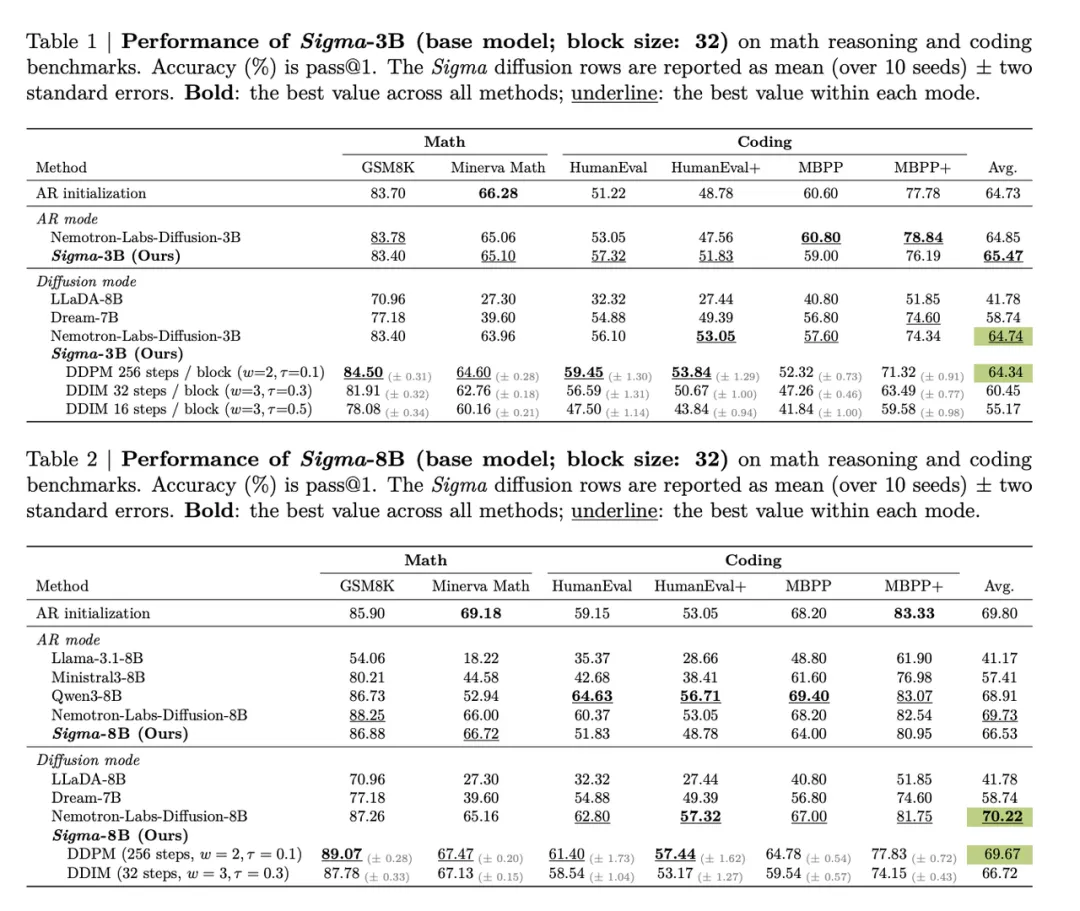
Sigma 的研究意义主要来自“连续化”之后获得的可操控性。Embedding-space Steering、ODE/SDE Sampling 和 Few-step Distillation 都可以直接利用连续生成领域已经成熟的方法,这可能为 Diffusion LLM 的推理加速打开更大的设计空间。3B 和 8B 的实验也说明 Continuous Diffusion 已经能够进入真正的大模型规模。从目前公开实验看,验证重点仍集中在数学与代码任务,通用知识、Instruction Following、Agent 和超长文本生成还缺少同等规模的比较。论文强调 NFE 减少后的 Graceful Degradation,但 NFE 并不等同于真实服务延迟,连续模型在 GPU 上的实际吞吐、Batch Efficiency 和 KV Cache 成本仍需要系统层面的进一步评估


链接:https://huggingface.co/Cloudflare/clef
🦄 推荐理由:Clef 是 Cloudflare 推出的开源 System One 决策模型,输入文本、JSON、图片或视频后,可以针对多个问题直接输出 Boolean、Choice 或 Score 等类型化结果和概率。模型不需要逐 Token 生成回答,适合 Tool Routing、分类、排序、风控、客服分流以及 Agent Hot Path 等需要低延迟决策的场景。
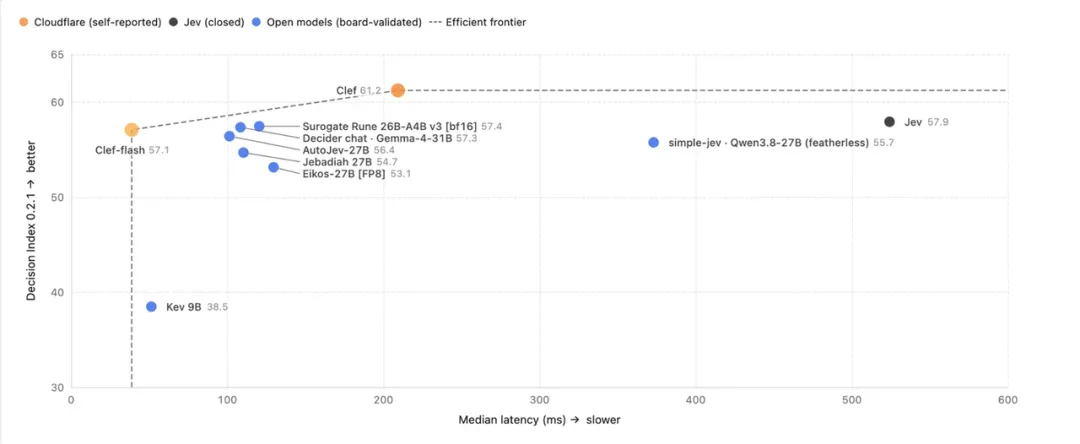
Clef 使用 Qwen3.8-27B 作为冻结 Backbone,通过 LoRA 和专门的 Joint Schema Head 学习结构化决策。推理阶段只进行 Prefill,然后并行计算所有合法 Schema Choice,无需生成中间自然语言。训练加入 Cross-Entropy、Brier Loss 和 RLCD,重点优化分类准确率与概率校准。Cloudflare 的 Decision Index 测试中,Clef 在 BFCL 达到 98.47、API-Bank 达到 91.93、BANKING77 达到 94.20;官方报告 Median Latency 为 209.3ms,相比 Jev 的 524.1ms 更低。另有基于 Qwen3.5-9B 的 Clef-flash,Median Latency 为 38.8ms。项目采用 Apache 2.0,且与 Jev System One API 兼容,适合作为 Agent 中独立的快速决策层。


链接:https://github.com/Niko1221/Strata
🦄 推荐理由:Strata 是一个面向消费级硬件的大模型本地推理引擎,目标是在单张 12–24GB显存的 NVIDIA 或 AMD显卡配合系统内存时,直接运行 125B 级 Qwen3.8-Flash-Next。它提供 Windows/Linux 一键安装、本地 OpenAI/Anthropic 兼容 API,并支持图片输入和 Coding Agent 接入,适合关注大模型本地部署、低成本推理和个人 Agent 基础设施的开发者。
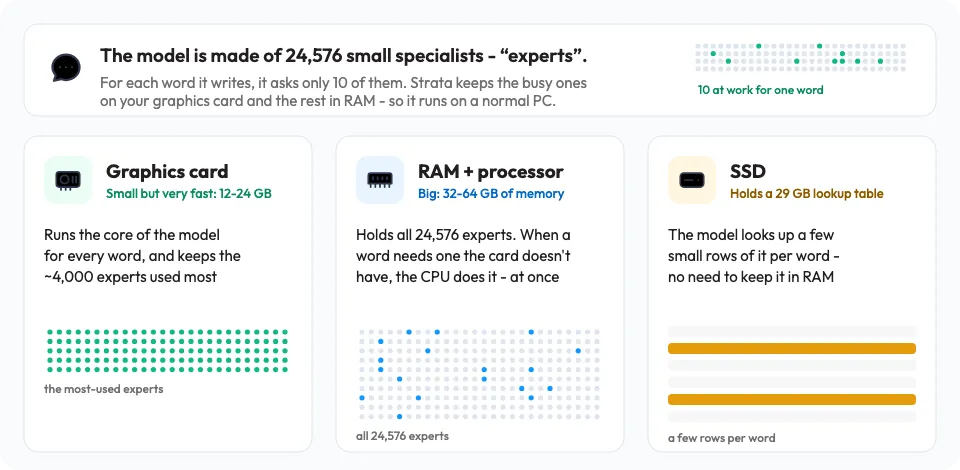
Strata 通过 CPU、GPU、RAM 和SSD 分层协同,让超出显存容量的大型 MoE 模型在普通 PC 上运行。高频使用的 Experts 保留在 GPU,其余 Expert 放在系统内存,同时利用 CPU 参与计算,并把大型查找表放到 SSD;项目还加入 Speculative Decoding 和大块 Prefill 优化,提高长上下文吞吐。官方测试中,RTX 5070 12GB + 64GB RAM 运行 Q2_0 版本时短文本生成约 94 tokens/s,32K Prompt Prefill 达到约 2650 tokens/s。项目支持本地 Web UI、OpenAI/Anthropic API、MCP,以及 Claude Code、Cursor、Codex 等 Coding Agent,采用 MIT License。需要注意,模型首次加载会占用约 35–55GB 系统内存,完整模型下载约 70GB,实际速度也会明显依赖 CPU、内存带宽和量化版本。


链接:https://github.com/DietrichGebert/ponytail
🦄 推荐理由:Ponytail 是一套面向 Coding Agent 的极简工程 Skill,核心原则是先判断功能是否真的需要,再依次检查项目现有实现、标准库、平台原生能力和已有依赖,最后才增加新代码。它针对 Vibe Coding 中常见的过度抽象、重复造轮子和依赖膨胀问题,可以接入 Claude Code、Codex、OpenCode、Gemini、Cursor 等多种 Agent。
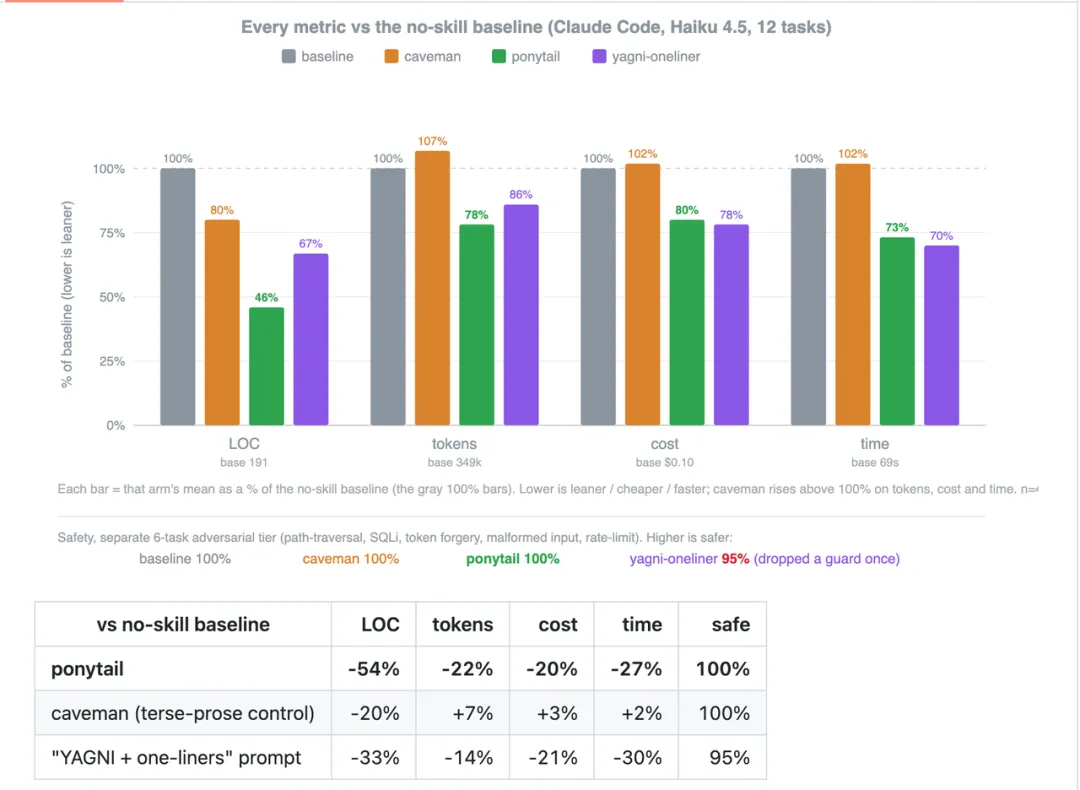
Ponytail 本质上是一套可移植的 Coding Agent Ruleset,并提供 Review、Audit、Debt 和 Gain 等 Skills。Agent 写代码前遵循一套“最小实现阶梯”:先考虑不做、复用现有代码、标准库和平台能力,最后才实现最小必要方案,同时明确保留输入验证、安全、错误处理和可访问性要求。官方在真实 FastAPI + React 仓库上使用 Haiku 4.5 完成 12 个 Feature Task 的测试中,相比无 Skill 基线平均减少 54% LOC、22% Token、20% 成本和 27% 时间,安全测试保持 100%。这些数字来自项目自己的有限 Benchmark,不能直接外推到所有模型和代码库,但它很好地代表了当前 Agent 工程里的一个新方向:开始约束 AI “不要过度开发”。

OpenAI在DevDay 2026正式发布个人AI Agent Dots,将ChatGPT进一步从聊天工具推向能够长期承担任务的个人智能体。Dots由GPT-6 Astra驱动,每个Agent拥有自己的云端电脑,可以24小时持续工作,并通过OpenAI插件生态连接超过4000个应用。
与传统ChatGPT最大的区别,是Dots不需要始终等待用户下一条Prompt。用户可以给它一个长期目标和允许自主执行的范围,让它持续处理任务,并通过ChatGPT、Slack、Teams等入口随时沟通和纠正。
与此同时,负责Codex与ChatGPT Work的Tibo Sottiaux又给团队定下一个激进目标:接下来连续28天,每天要么推出一项对大多数Codex/Work用户有明确价值的改进,要么进行一次完整的Usage Reset。
这意味着Agent竞争正在进入新的阶段:模型能力之外,长期执行能力、使用额度、产品稳定性以及用户是否愿意真正依赖Agent,开始变得同样重要。
Dots让Agent从“对话”变成“持续承担职责”
OpenAI将Dots定义为always-on agents。
每个Dot都拥有自己的云端计算机,可以在用户不在线时继续执行工作,并通过长期反馈逐渐学习用户偏好、工作方式以及对结果质量的要求。
当前用户主要拥有一个Dot,OpenAI设想未来进一步发展成多个Dots组成团队,让不同Agent分别承担研究、执行、整理和跟进等任务。
这种产品形态与传统聊天机器人已经出现明显区别。
过去用户需要不断告诉AI下一步做什么;Dots希望把交互方式改成:给Agent一个目标,然后让它持续推进。
ChatGPT正在变成Agent的工作入口
Dots并不是DevDay上的孤立产品。
OpenAI同时继续强化ChatGPT作为人与Agent协作界面的定位,让Agent能够连接应用、文件和各种外部工具,并把ChatGPT开放成开发者可以直接触达约12亿周活用户的平台。
这意味着ChatGPT未来的竞争对手可能不再只是其他聊天机器人。
它正在尝试成为一种Agent操作系统:用户提出目标,Agent在背后调用不同软件和服务完成工作,而用户主要负责目标定义、授权和最终决策。
一旦这种模式成立,软件的入口也可能发生变化——用户不再主动打开每一个App,而是越来越多地让Agent替自己操作App。
Tibo承诺连续28天“改进或Reset”
OpenAI现在面临的问题是,Agent越来越强的同时,重度用户也开始更加敏感于速度、额度和产品复杂度。
10月4日,Tibo表示团队接下来会重点关注产品简化、提高效率以提供更多Usage、突破性功能以及新模型。
随后他进一步承诺:
未来28天,每一天都要么推出一项对大多数Codex/Work用户有明显价值的改进,要么进行一次完整的Usage Reset。
这里的Reset指的是重新恢复相关使用额度,而不是每天都会重置;承诺本身是“改进”和“Reset”二选一。
这种做法非常少见,相当于把产品迭代直接变成一个每天都能被用户检查的公开进度表。
Agent竞争开始从能力进入体验战
这也反映出AI产品正在经历一个变化。
模型能力快速提高之后,用户对Agent的要求已经不只是“偶尔完成一个惊艳Demo”。
如果一个Agent真的需要替用户持续工作,它就必须足够稳定、额度足够可预测,并且在运行几个小时以后仍然能够保持上下文和任务目标。
Demo做得好是一回事,用户敢不敢把每天的工作交给它,是另外一回事。
因此长期Agent最终竞争的可能是一个综合体验:模型能力、工具调用、记忆、运行时间、价格和稳定性缺一不可。
Dots的发布意味着个人Agent开始真正从概念走向巨头级产品。
过去AI竞争主要围绕模型展开:谁的Benchmark更高、推理更强、价格更低。
Dots代表的下一阶段则是:谁能够拥有用户长期任务,连接用户的数据和软件,并在用户离线时继续替他工作。
而Tibo的28天承诺恰好展示了这场竞争的另一面。
当Agent开始承担真正的工作之后,一个额度突然耗尽、执行中断或者行为不稳定的问题,影响会远比聊天机器人回答错一道题更大。
因此下一阶段Agent战争争夺的不只是能力,也会越来越变成体验与信任的竞争。
OpenAI已经证明自己能够快速推出新的Agent形态,接下来真正需要证明的是:这些Agent能不能成为用户愿意每天依赖的基础设施。

Anthropic发布Claude Sonnet 5.5,在API单价保持不变的情况下,生成速度提升超过30%,多数任务的实际成本最高下降30%。 更值得关注的是,Sonnet 5.5在Terminal-Bench 4.0取得70.6%,甚至超过定位更高的Opus 5.5的66.4%。
几乎同时,Anthropic秘密IPO文件被曝光。Reuters披露,公司计划寻求超过2万亿美元估值,但高速增长背后也伴随着惊人的基础设施投入:Anthropic已经承诺未来投入约5180亿美元用于云计算、数据中心等基础设施。
两条新闻放在一起形成了一个很有意思的反差:
用户使用AI的成本正在越来越低,但训练和运行这些模型的基础设施却越来越昂贵。
AI产业正在进入一个“前端降价、后端重资产化”的新阶段。
Sonnet开始把Opus能力下放
Claude Sonnet 5.5保持Sonnet 5原有价格:每百万输入Token 2美元,输出Token 10美元,Cache Read为0.2美元。
但模型本身效率明显提高。
Anthropic表示,新模型输出速度提升30%以上,并且由于完成同样任务通常需要更少Token,单任务成本最高能够下降30%。
在Terminal-Bench 4.0上,Sonnet 5.5取得70.6%,超过Opus 5.5的66.4%;GDPval-AA成绩也已经非常接近Opus。
它甚至成为首个仅依靠游戏截图完成《宝可梦 红》的Sonnet模型,说明长程视觉任务和持续执行能力也在明显提升。
不过Anthropic同时强调,Opus仍然更适合复杂、开放式和需要持续判断的任务。Sonnet真正的优势不是全面替代Opus,而是把越来越多旗舰能力带到更便宜、更快速的模型上。
Agent模型开始追求“单位任务效率”
这与过去几代模型的Scaling方式有明显区别。
以前提高能力,通常意味着使用更大的模型、更多Thinking Token和更高推理成本。
现在厂商开始同时优化另一个指标:
完成一件事情到底需要多少钱。
如果Sonnet能够以更低推理成本完成过去只有Opus才能处理的Coding和Agent任务,那么企业部署AI时能够覆盖的工作量就会迅速增加。
这也是为什么Anthropic反复强调“每个任务的成本”,而不仅仅是API每百万Token价格。
AI模型价格竞争正在从Token Price逐渐进入Cost per Task。
Anthropic IPO暴露真正的AI成本
模型越来越便宜,并不意味着Anthropic自己的成本也越来越低。
Reuters获得的IPO文件显示,Anthropic 2025年收入约为45.9亿美元,相比前一年增长约12倍,但经营亏损仍超过80亿美元。
报道中广泛传播的约420亿美元净亏损,也容易被误解。
其中约340亿美元来自可转换融资工具价值变化产生的会计费用,并不意味着公司一年真正烧掉了420亿美元现金。
真正值得关注的,是未来计算资源投入。
Anthropic披露的云计算、数据中心等多年基础设施承诺约为5180亿美元,而公司2025年底现金及短期投资约为203亿美元。
这说明前沿模型竞争正在越来越像一场基础设施战争。
AI公司正在从实验室变成基础设施巨头
Anthropic的商业结构也开始越来越复杂。
IPO文件显示,公司对少数大型客户仍存在较高依赖,同时大量收入也通过Amazon、Google等云合作伙伴产生。
与此同时,七名联合创始人计划通过Founder LLC继续掌握50.1%的投票权,以保持对长期战略的控制。
这意味着Anthropic正在做一件很矛盾的事情:
一方面,它希望把Claude变成越来越便宜、越来越普及的企业基础能力;
另一方面,要支撑这种低价和大规模使用,又必须提前锁定规模巨大的算力和数据中心资源。
AI实验室因此正在逐渐变成一种新型基础设施公司。
Sonnet 5.5和Anthropic IPO其实讲的是同一件事情的两面。
对于用户而言,AI正在迅速变便宜。
更强模型不断下放,单位Token价格下降,完成一个Agent任务需要的Token也越来越少。
但对于模型公司而言,情况完全相反。
更长的上下文、更大的强化学习、更复杂的Agent环境以及数以亿计用户的推理需求,都要求建设越来越昂贵的基础设施。
这可能形成未来AI行业最重要的经济规律之一:
模型能力会逐渐商品化,推理价格会持续下降,但支撑这些低价AI的大规模算力基础设施会越来越集中、越来越昂贵。
换句话说,AI公司表面上越来越像软件公司,底层却正在越来越像能源、云计算和数据中心公司。
Claude越来越便宜,而Anthropic却需要投入数千亿美元,正是这一趋势最直观的缩影。

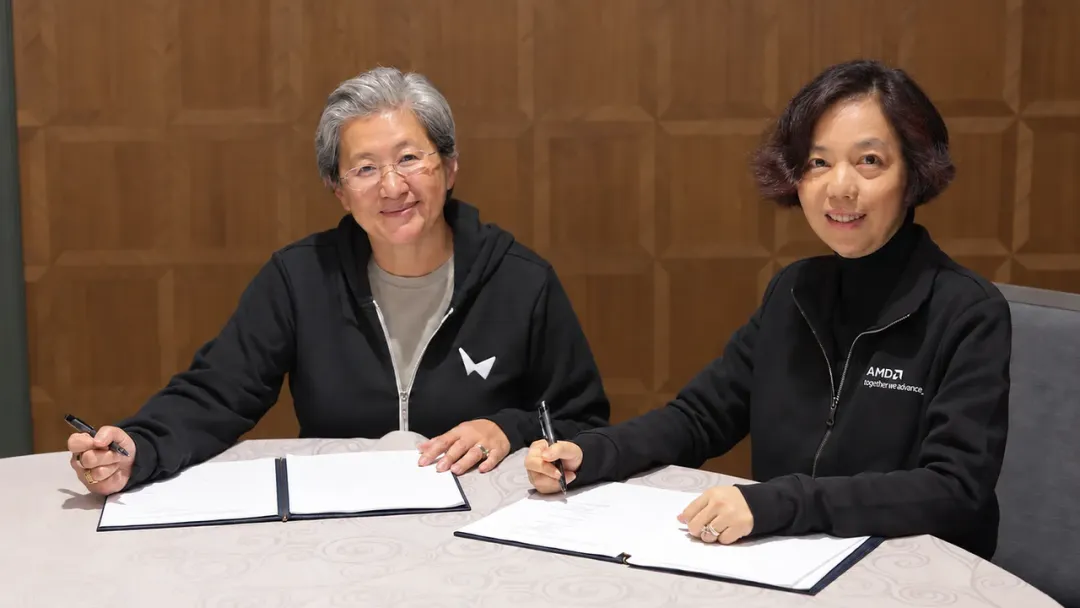
AMD宣布以82亿美元全股票交易收购李飞飞创办的World Labs;Manus推出2.0与个人Agent应用Cue,让每个Agent拥有自己的邮箱、电话号码、钱包和电脑;Google则发布Gemini 4 Argon,将单次输出上限从6.4万Token直接提升至100万Token。
三条新闻表面上分别属于芯片、Agent和大模型,但实际上指向了同一个方向:
下一代AI正在同时获得“世界、身份和时间”。
World Labs试图让AI理解和模拟三维世界;Cue让Agent从一个临时Session变成拥有独立数字身份的执行主体;Gemini 4 Argon则让模型可以在一次Trajectory里连续工作数十万乃至上百万Token。
过去几年我们主要是在让AI拥有更聪明的“大脑”,现在产业开始为这个大脑补上真正工作的环境。
AMD花82亿美元买下“空间智能”
AMD宣布以约82亿美元收购World Labs,交易采用全股票形式,预计在2026年底前完成,仍需经过监管审批。
交易完成后,World Labs创始人李飞飞将成为AMD执行副总裁兼首席科学家,并直接向CEO苏姿丰汇报。
World Labs研究的重点不是传统LLM,而是Spatial Intelligence和World Model:让AI能够理解、生成、重建和模拟三维环境,并进一步应用到机器人、设计和物理世界交互。
这笔交易对AMD的意义,也不仅仅是“买下一家AI创业公司”。
过去芯片厂商主要等模型公司产生新的Workload,再去优化GPU;收购World Labs以后,AMD可以更早参与世界模型和Physical AI研究,让下一代算法需求直接反过来影响芯片和软件路线图。
World Model开始成为芯片公司的战略资产
AMD此前已经投资World Labs,双方也一直使用AMD GPU进行训练与推理优化。
现在选择直接收购,说明空间智能正在从研究方向变成芯片厂商认为足够重要的战略领域。
原因很简单。
今天的大部分AI计算来自LLM训练和推理,但如果未来机器人、自动驾驶、游戏、数字孪生和3D生成全面进入World Model时代,需要处理的视频、空间数据和实时模拟计算可能远高于文本模型。
对AMD而言,买World Labs也是在提前押注下一代GPU到底会跑什么任务。
Manus开始给每个Agent一个“身份”
如果World Labs解决的是AI所在的“世界”,Manus Cue解决的则是Agent“是谁”。
Manus 2.0推出新的Agent Harness Cascade。在官方公布的一组测试配置中,相比上一代系统,Cascade的Token消耗降低23.2%,任务时间缩短28.2%,运行成本降低32%。
同时新增Cloud Computer、事件触发式Automations以及Computer Use,让任务能够在独立云端环境中长期运行,也可以根据邮件、Slack、日历或其他外部事件自动启动。
更有意思的是独立应用Cue。
Cue中的每个Agent都拥有自己的邮箱、电话号码、钱包和电脑。它可以发送消息、接听电话、在用户设定的预算范围内付款,并在自己的计算环境里完成任务。
多个Agent还可以组成群聊,互相交接工作。
这意味着Agent正在从一个临时模型Session,逐渐变成网络世界中的独立执行主体。
“数字身份”可能成为Agent的重要基础设施
邮箱、电话号码、钱包和电脑看起来像几个产品功能,背后的意义其实更大。
传统AI助手没有真正的身份。
它替你写邮件,但邮件依然由你发送;它建议你购买什么,但最终支付还是需要你自己完成。
当Agent拥有独立邮箱、通信渠道、计算环境甚至受限钱包之后,它第一次具备了持续参与现实工作流的条件。
未来Agent基础设施可能不仅要解决模型推理,还要解决:
Agent是谁、代表谁、拥有什么权限、可以花多少钱,以及出了问题由谁负责。
身份系统可能因此成为Agent时代和模型本身同样重要的一层。
Gemini 4 Argon让一次任务输出100万Token
Google则从“时间”这个维度扩展Agent。
Gemini 4 Argon将模型的单次输出上限从64K提升到100万Token。Google认为,更长的输出空间允许模型在一次Trajectory中持续进行数十万Token的推理、代码执行和结果修正。
这里真正重要的并不是“AI一次能写一本书”。
对于Agent来说,Output Token实际上可以代表它一次持续工作的长度。
过去模型执行几十步、生成大量代码或者连续调用工具以后,经常需要结束当前Trajectory重新开始;如果一次运行能够延伸到数十万甚至100万Token,Agent就有可能在一个连续任务里完成更多轮的:
规划 → 执行 → 检查 → 修改 → 再执行。
在长程软件工程Benchmark DeepSWE v1.1上,Gemini 4 Argon达到77.9%。
Google也将其重点应用方向放在大规模代码迁移、复杂算法、法律、金融和网络安全等需要长期连续工作的专业任务。
Agent开始获得真正工作的完整条件
把这三条新闻放在一起,会看到一个很明显的变化。
过去我们主要在训练一个越来越聪明的模型。
但聪明并不足以构成一个真正可以工作的Agent。
它还需要:一个能够理解和操作的世界;一个长期存在的数字身份;以及足够长的时间完成复杂任务。
World Labs、Cue和Gemini Argon恰好分别在补这三层能力。
这也意味着Agent的Scaling正在从单纯提高模型参数和Benchmark,扩展到环境、身份、权限、运行时间和基础设施。
下一代Agent正在从“大模型加工具调用”,逐渐变成真正的数字执行主体。
World Model让AI能够理解和预测外部环境;独立邮箱、钱包和电脑让Agent拥有可以持续参与工作流的身份;百万Token级Trajectory则让它能够把一个复杂任务真正做到底。
这三种能力结合以后,AI产品形态会发生很大变化。
过去用户的角色是不断操作软件,AI提供建议。
未来可能逐渐变成:
用户负责设定目标和边界,Agent拥有身份、环境和时间,自己去完成中间的大部分工作。
所以AMD收购World Labs、Manus推出Cue和Gemini 4 Argon真正共同指向的,不是三个独立的新产品。
而是一个更大的趋势:
我们已经花了几年时间给AI造“大脑”,现在整个行业开始给这个大脑补上世界、身份和时间。

1.1 https://arxiv.org/abs/2609.38057
1.2 https://arxiv.org/abs/2610.02200
1.3 https://arxiv.org/abs/2610.02665
2.1 https://huggingface.co/Cloudflare/clef
2.2 https://github.com/Niko1221/Strata
2.3 https://github.com/DietrichGebert/ponytail
3.1 https://openai.com/zh-Hans-CN/index/devday-2026-recap/
3.2 https://www.anthropic.com/claude-sonnet-5-5
3.3 https://www.worldlabs.ai/blog/amd-announcement