ARTICLE · 1132852
别把大模型项目当成普通软件做!拆解“AI原生应用”造价的三个荒诞与现实
别把大模型项目当成普通软件做!拆解“AI原生应用”造价的三个荒诞与现实在过去的软件造价咨询现场,只要客户说要做一个“信息管理系统”,造价工程师心里就有底:数一数外部输入(EI)、外部输出(EO)、逻辑文件(ILF)……套上标准的公式,人月和预算就出来了。 然而,近两年来,随着各大企业全面拥抱大模型,客户的需求变成了:“我们要搞一个大模型智能助手”、“帮我们做一个基于 RAG 的企业专属知识库问答系统”、“弄几个能自动流转的 AI Agent”。 当造价专家拿着传统的《软件开发成本度量》标准去翻看这些“AI 原生应用”的需求规格说明书时,集体陷入了沉思:界面依然是一个简单的对话框,没有复杂的表单录入,没有繁琐的按钮交互,按照传统功能点去数,规模几乎等于零。但为什么一个简单的 AI 知识库系统,软件开发商一开口就要价大几十万甚至上百万? 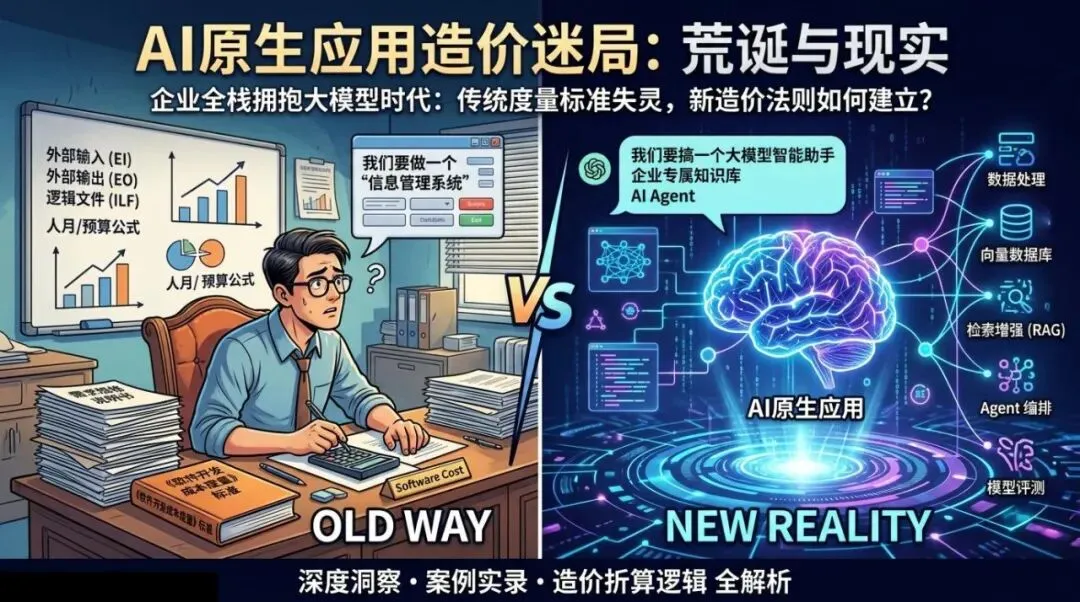
难道,这又是一个“智商税”项目?今天,我们就来扒一扒 AI 原生应用造价背后的荒诞与现实。 在传统软件工程中,价值依附于“功能”;而在 AI 原生应用中,软件的价值彻底向“数据、算法与服务”倾斜。这导致传统造价体系遭遇了三重降维打击: 界面极简,复杂度极高 “黑盒特性”让工作量无法预估 面对审计部门的质问和传统计价规则的失效,行业内的顶尖造价专家开始摸索一套全新的AI 应用造价折算逻辑。一个健康的 AI 原生应用造价底稿,往往由以下四个硬核板块重新拼装而成: AI 项目有一句名言:“Garbage in, garbage out(垃圾进,垃圾出)”。 企业内部的 PDF、Word、扫描件、甚至带有方言的语音记录,绝不能直接塞给大模型。 造价折算点:海量非结构化数据的清洗、多模态解析、向量化构建与数据库索引调优,需要消耗大量的数据工程专家工时,这必须作为独立的造价大项进行计列。 单纯调用一个商业大模型 API(如 GPT-4 或国内主流大模型)并不贵,贵的是将大模型与企业核心业务打通的“胶水代码”与工作流编排。 比如通过 LangChain 或 LlamaIndex 构建复杂的多 Agent 协同工作流、实现多轮对话的上下文记忆、设计严密的意图识别与安全拦截网。 造价折算点:这部分工作量应按照“业务逻辑复杂度与接口集成度”折算为专项系统集成工时。 AI 应用上线从来不是终点,而是“噩梦的开始”。 怎么评估大模型回答的准确率从 70% 提升到 95%?如何防范恶意用户的 Prompt 注入攻击(越狱测试)? 造价折算点:AI 应用必须引入专门的评估框架(如 Ragas、LLM-Eval)进行成千上万次的自动化攻防测试与人工抽检。这部分“模型对齐与评测服务费”,应当成为决算审计中的常规计费科目。 从信创改造的“全栈异构重构”,到如今 AI 原生应用的“数据与算法重估”,软件造价行业正在经历一场前所未有的观念重塑。 如果继续用老眼光去看待 AI 项目,认为“界面没变就不值钱”,不仅会逼死用心做技术落地的承建方,也会让企业在数字化浪潮中错失真正的智能化红利。未来的造价底稿,不再是对屏幕上几个按钮的定价,而是对数据治理、架构编排与智能系统稳定性的深度买单。
一、 传统度量的“滑铁卢”:当软件没有了“显性功能”
二、 重新锚定:AI 原生应用究竟该怎么算账?
1. 数据资产治理与向量化成本
2. 检索增强与工作流编排成本
3. “长效调优与对抗测试”服务费
三、 结语:告别“数功能点”的旧时代
💬 互动留言板: 你们在做大模型或 AI 知识库项目预算时,遭遇过财务或审计的灵魂拷问吗?你是如何向他们解释这笔费用的?欢迎在评论区分享你的绝招!