ARTICLE · 1136422
一文讲透 AI 算力平台 8 个核心概念:GPU、显存、NVLink、InfiniBand、调度、存储、容器、监控
“【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/[1]
欢迎关注【魔方AI空间】👇
AIGC技术交流社区(涵盖AI绘画、AI视频、6大模型、AI多模态、数字人、具身智能等AIGC干货资源及教程)欢迎大家加入:
“本文聚焦于 AI 算力平台的 8 个核心概念:GPU、显存、NVLink、InfiniBand、调度、存储、容器和监控。沿着一次分布式训练任务的执行过程,读者可以看清这些组件怎样协同工作,并初步判断:训练慢,究竟是卡没算起来,还是整条系统路径中的某一环在拖后腿。
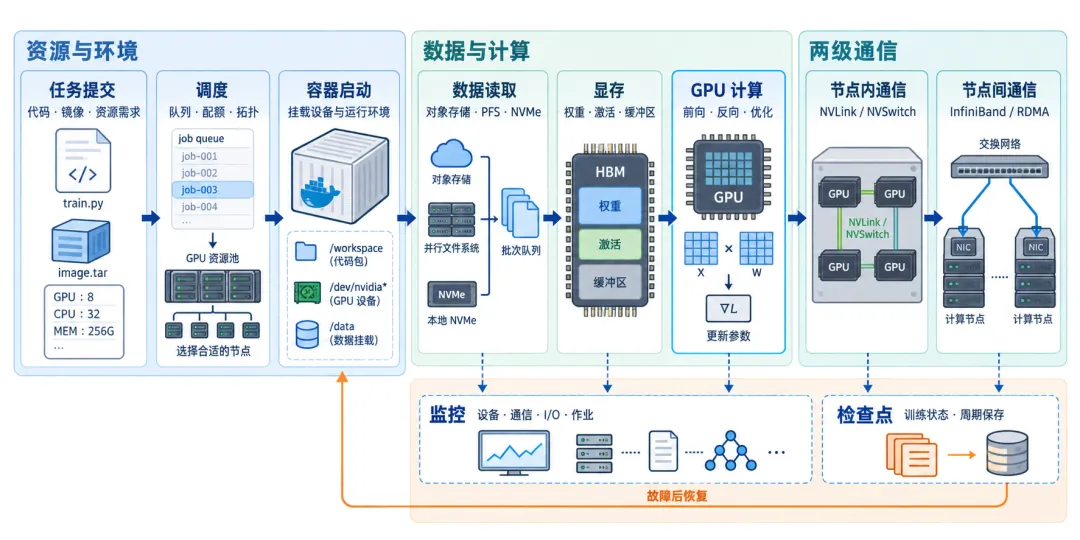
图 1:一次训练任务从提交到运行、同步、监控和检查点保存,要经过一条相互依赖的完整系统路径。
01GPU:峰值算力,不等于训练速度
“通俗理解:GPU 像一座同时开着大量生产线的工厂。任务足够并行,数据又能及时送到,生产线才真正忙得起来。
CPU 和 GPU 在硬件设计上各有侧重。CPU 擅长以较低延迟处理复杂控制逻辑;GPU 用大量并行线程换取整体吞吐。神经网络中的矩阵乘法、卷积和 Attention 包含大量重复的张量计算,正适合后者。
在 CUDA 的执行模型里,GPU 由多个 Streaming Multiprocessor(SM) 组成,线程以 warp、线程块等形式被调度到 SM 上。Tensor Core 专门加速矩阵乘加,是现代 AI 训练获得高吞吐的重要硬件单元。CUDA Programming Guide[2] 对这套执行与内存模型有更完整的说明。
FLOPS(每秒浮点运算次数) 描述的是理论计算上限。实际任务能跑到多快,还取决于几件更具体的事:
· 算子能否形成足够大的并行工作量;
· 张量尺寸、精度和布局是否适合 Tensor Core;
· 显存能否及时把数据送到计算单元;
· 多卡训练时,其他 GPU 和网络能否按时完成同步。
大规模矩阵乘法通常更容易发挥 Tensor Core;大量小算子、频繁的 CPU-GPU 同步和不规则访存,则会让 GPU 一次次停下来。同一张卡运行不同模型,实际吞吐差出几倍并不奇怪。
排查 GPU 性能,可以先分清四种状态:
· 计算受限:计算单元已经很忙,提升计算能力或使用较低精度可能有效;
· 显存带宽受限:大量时间花在搬运数据,更多 Tensor Core 也吃不到足够的数据;
· 通信受限:多卡同步进入关键路径,GPU 在等待其他设备或网络;
· 输入受限:存储、CPU 预处理或 DataLoader 供给太慢,下一批数据没有及时到位。
所以,GPU 利用率不能单独代表训练效率。监控显示 100% 活跃,只说明采样窗口内 GPU 有工作,不代表 Tensor Core、显存带宽和多卡并行都处在理想状态。模型吞吐、单步耗时,以及计算、通信、输入各自占用的时间,通常更有判断价值。
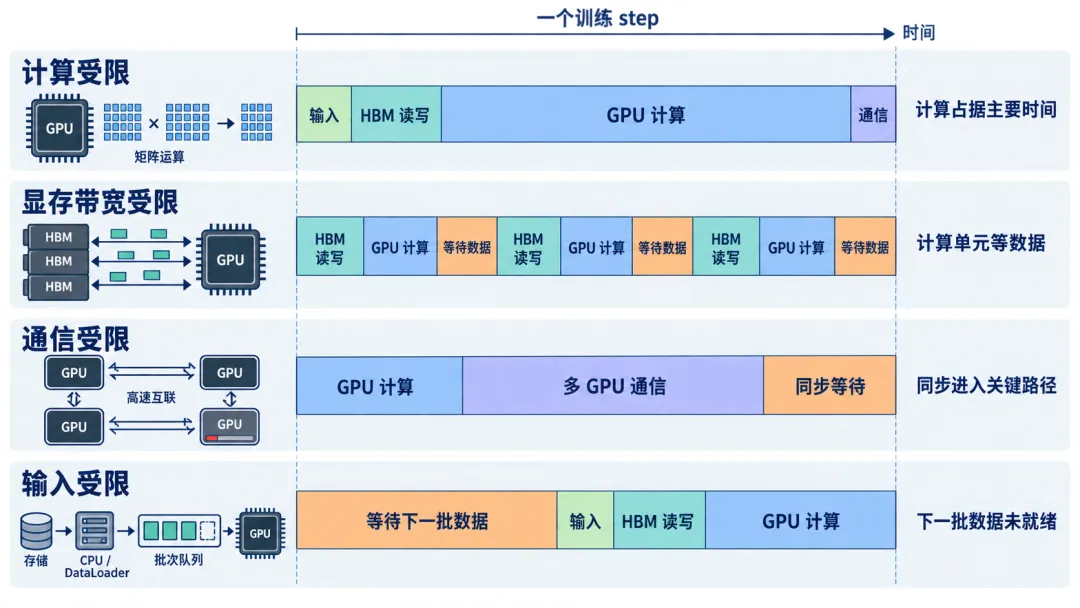
图 2:峰值 FLOPS 只是上限;训练单步究竟耗在哪里,要看计算、搬运、通信和输入在时间线中的占比与等待关系。
02显存:既决定放不放得下,也决定喂不喂得饱
“通俗理解:显存容量决定模型和中间状态能不能装下,显存带宽决定 GPU 取数据够不够快。
谈模型规模时,人们最先想到参数。但在训练阶段,参数只占显存用量的一部分。
一项训练通常还要保存梯度、优化器状态、前向传播留下的激活、通信缓冲区、临时张量,以及框架分配器保留但当前没有实际使用的空间。
以 BF16 保存 70 亿参数为例,权重本身约占 14 GB。加入梯度、Adam 优化器状态、可能存在的 FP32 主权重和激活后,实际显存需求会高出许多,还会随 batch size、序列长度和网络结构变化。只拿“参数量 × 每个参数的字节数”估算训练显存,通常会低估不少。
多张卡的显存不会自动相加
每张 GPU 都有自己的物理显存。数据并行(DP)会在各张卡上保留模型副本,再分别处理不同数据;它提高了计算吞吐,却不会减少单卡保存模型所需的空间。
模型状态要分布到多张卡,需要明确的切分策略:
· 张量并行(TP):把一层中的张量计算切到多张 GPU;
· 流水线并行(PP):把不同网络层放到不同 GPU;
· ZeRO/FSDP:切分参数、梯度或优化器状态;
· CPU/NVMe Offload:把部分状态移出显存。
这些方法都在容量和速度之间交换条件。切分越细,跨卡通信通常越多;Offload 能节省显存,却会把部分数据送进更慢的传输路径。
OOM 只是最明显的问题
容量不足会报 OOM,带宽不足则常表现为“模型能跑,但跑不快”。GPU 的寄存器、共享内存、L1/L2 Cache 与全局显存构成分层内存系统。算子频繁访问全局显存,或者访问无法有效合并时,计算单元就会等数据。NVIDIA 的 CUDA Best Practices Guide[3] 因此把有效带宽列为性能分析的重要指标。
常见的省显存方法也各有价格:混合精度要处理数值稳定性,激活检查点用重复计算换空间,缩小 batch size 可能降低吞吐,ZeRO/FSDP 会增加通信,Offload 则依赖更慢的主机内存或 NVMe。
Unified Memory 能简化 CPU 与 GPU 多物理内存空间的管理,却不能把主机内存变成与 HBM 同速的显存。页迁移、数据放置和访问位置仍会影响性能。CUDA Unified and System Memory 文档[4] 也明确强调,数据留在实际访问它的处理器所连接的内存中,通常才能获得更好的性能。
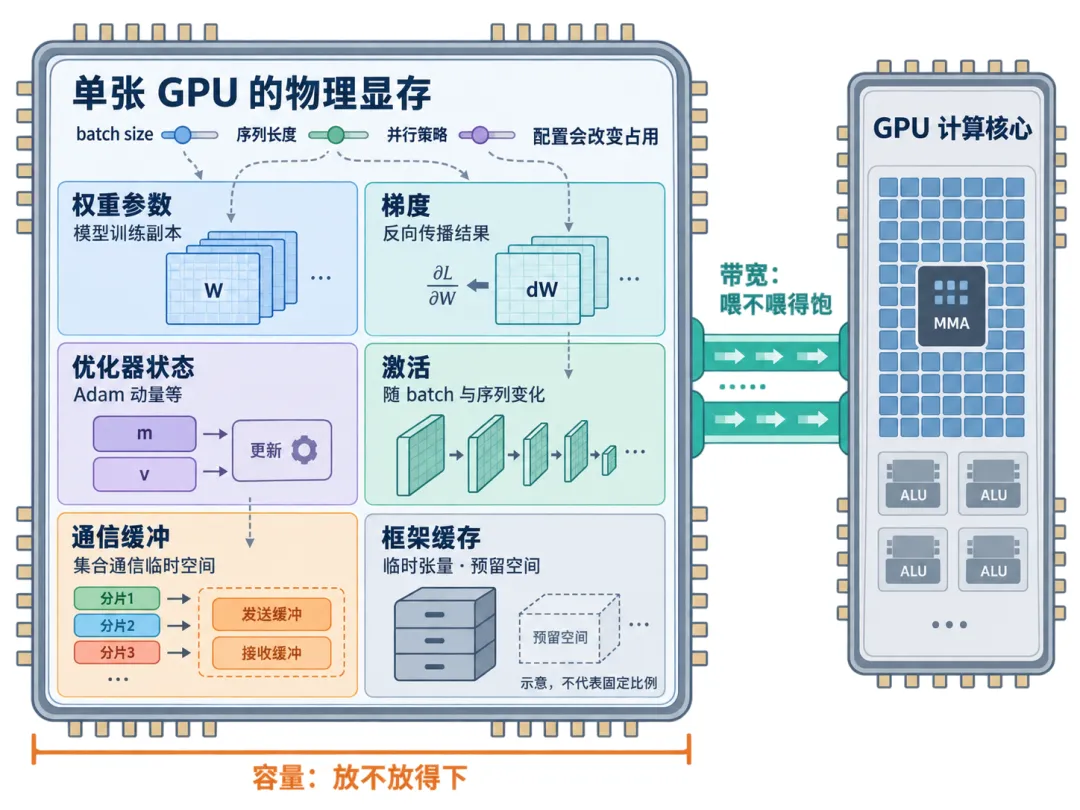
图 3:训练显存不只装参数,还要容纳梯度、优化器状态、激活、通信缓冲和框架缓存;各部分大小会随训练配置变化。
03NVLink:节点内 GPU 怎样快速交换数据
“通俗理解:NVLink 是 GPU 之间的高速通道。它能加快通信,却不会自动把多张 GPU 变成一张没有边界的超级 GPU。
单机多卡训练并非每张 GPU 各算各的。数据并行要同步梯度,张量并行要交换中间结果,流水线并行也要在不同阶段之间传输激活。模型并行切得越细,通信越容易进入每一步训练的关键路径。
一台 GPU 服务器内部通常同时存在四个容易混淆的角色:
· PCIe 是通用设备互联,连接 GPU、NIC、CPU 和其他设备;
· NVLink 提供 GPU-GPU 或特定 CPU-GPU 的高带宽连接;
· NVSwitch 把多条 NVLink 组织成交换结构,让更多 GPU 位于同一高速互联域;
· NCCL 是集合通信软件库,提供 AllReduce、AllGather、ReduceScatter、Broadcast 等操作。
NVLink 是底层互联,NCCL 负责组织通信。NCCL 会识别硬件拓扑,根据 GPU 之间的实际连接选择通信路径和算法。NCCL 官方文档[5] 将其定义为面向多 GPU 的集合通信库。
都是 8 张 GPU,拓扑可能完全不同
如果 8 张 GPU 位于同一 NVSwitch 域,GPU 之间的路径通常更均衡。如果它们分布在不同 PCIe Switch、不同 CPU Socket,通信可能经过更长的路径,并受到 NUMA 位置影响。
调度器只满足“分到 8 张 GPU”还不够。卡数正确、拓扑不合适,训练照样会慢。
排查节点内通信,可以先用 nvidia-smi topo -m 查看 GPU、CPU 和 NIC 的关系,再用 P2P 或 NCCL 微基准验证实际带宽。DCGM 的 Topology and NVLink[6] 文档区分了拓扑、链路状态、流量和错误:链路显示 Up,只能说明它处于连接状态,不能证明应用已经跑满带宽。
NVLink 也不等于无条件共享显存。远端 GPU 内存访问仍受拓扑、时延、带宽和软件支持限制。训练框架依旧要明确怎样切分模型、放置张量和组织通信。
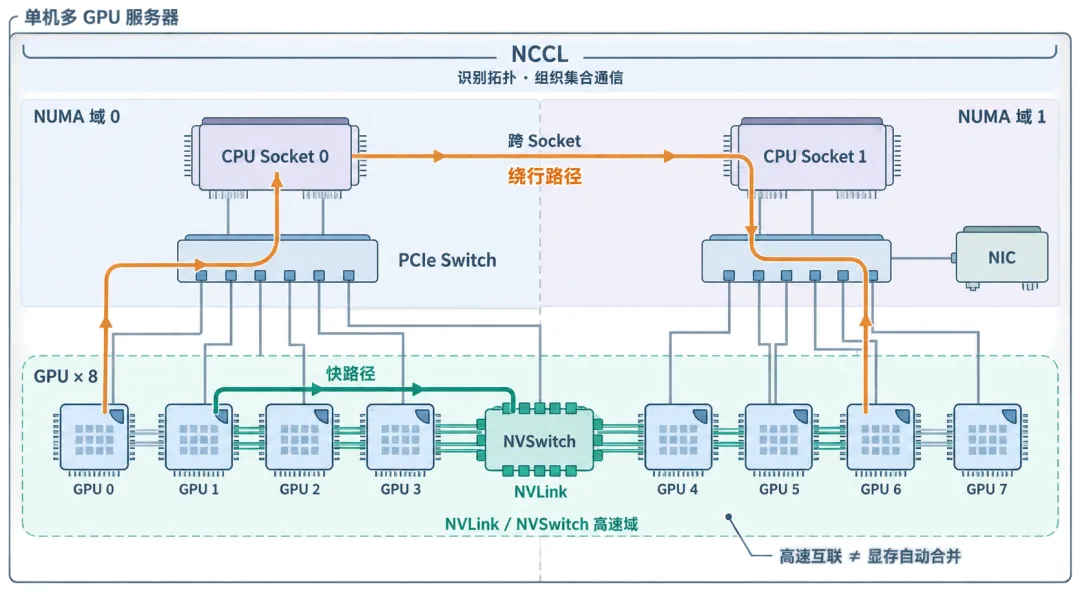
图 4:单机多 GPU 的通信速度取决于真实连接:NVLink/NVSwitch 提供节点内高速路径,跨 PCIe Switch 或 CPU Socket 的绕行会增加代价。
04InfiniBand:多台 GPU 服务器怎样一起训练
“通俗理解:NVLink 主要连接一台服务器里的 GPU,InfiniBand 则把多台服务器连成一个低时延、高带宽的训练集群。
训练规模超过单台服务器后,梯度、参数分片或中间张量需要跨节点交换。同步训练还有一个麻烦:一个 rank 变慢,其他 rank 往往只能等它。
节点间网络因而不只追求端口带宽,还要控制时延、拥塞、重传和尾部波动。
InfiniBand 是 HPC 与 AI 集群常见的高性能网络体系。它支持 RDMA,让网卡直接访问已经注册的内存区域,从而减少 CPU 参与和额外拷贝。在硬件、驱动、拓扑和软件栈满足条件时,GPUDirect RDMA 还能在 GPU 与网卡之间建立更直接的数据路径。
这里减少的是数据面的 CPU 参与和 bounce buffer,并非整个通信过程“完全不经过 CPU”。控制面、内存注册和路径建立仍由软硬件栈共同完成。
本地 GPU 显存 ↓ PCIe / GPUDirect RDMA本地 NIC ↓ InfiniBand 交换网络远端 NIC ↓ PCIe / GPUDirect RDMA远端 GPU 显存InfiniBand 与 RoCE 有相似目标,但不是同一种网络
两者都能承载 RDMA,链路层、交换网络配置、拥塞管理和诊断工具却不同。RoCE 运行在以太网上,通常需要正确配置 PFC、ECN 等流控和拥塞机制;配置不当时,训练吞吐可能波动,尾延迟也会升高。
NCCL 的 Networking Troubleshooting[7] 文档会分别检查 InfiniBand 与 RoCE 的链路状态、端口速率、RDMA 统计、重传和拥塞指标。两者都支持 RDMA,排障方法却不能直接照搬。
端口标称 400 Gb/s,也不代表应用一定能获得同等吞吐。GPU-NIC 是否处于合适的 NUMA/PCIe 拓扑、多 rail 是否配置一致、交换网络是否阻塞、NCCL 是否选对接口、并行策略产生多少通信量,都会影响最终结果。
实用的验证顺序是:先用 RDMA 带宽和时延工具检查底层网络,再用 NCCL Tests 检查集合通信,最后回到真实模型的 step time。底层网络正常而 NCCL 慢,和 NCCL 正常但模型扩展效率差,是两个层次的问题。
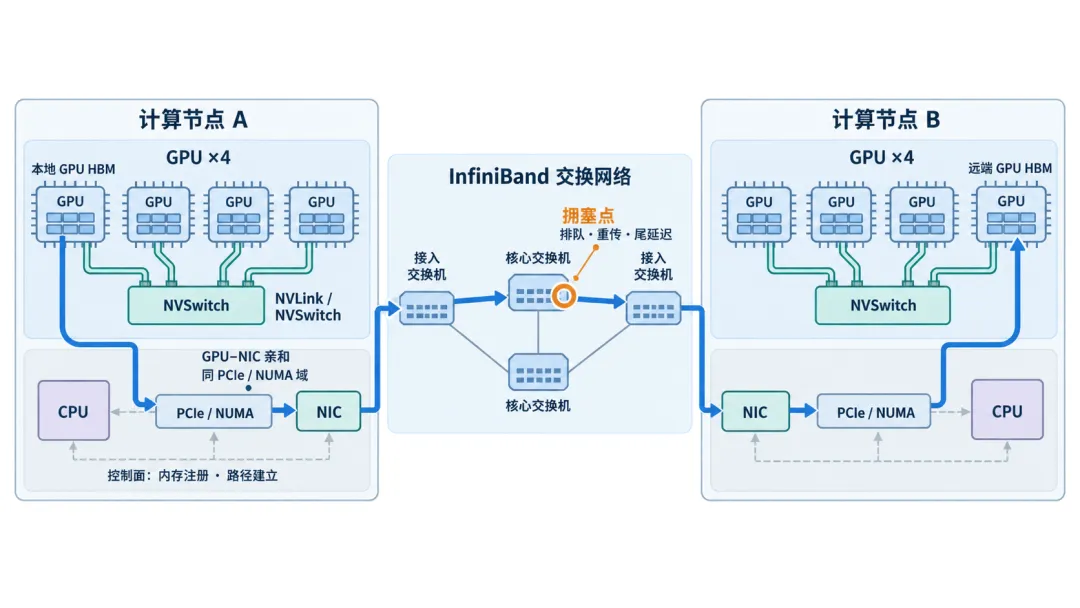
图 5:分布式训练要同时经过节点内与节点间两层互联;GPU–NIC 拓扑、RDMA 路径和交换网络拥塞都会影响同步时间。
05调度:分到几张卡,只是第一步
“通俗理解:调度器不只决定谁先用 GPU,还要决定任务用哪几张卡、落在哪些节点,以及 GPU 与 CPU、NIC、存储路径是否匹配。
用户提交作业时,通常会声明 GPU 数量和型号、CPU、主机内存、运行时长等需求。调度器要从集群中找到满足条件的资源,同时处理队列、配额、优先级和公平性。
在 Slurm 中,GPU 可以作为 GRES(Generic Resource)被发现、申请、绑定和核算。Slurm GRES 文档[8] 还涉及 GPU 亲和、MIG、MPS 等能力。
Kubernetes 则通过 Device Plugin 等机制,把 GPU 作为扩展资源暴露给 Pod。Kubernetes GPU Scheduling[9] 解决了 GPU 资源发现与分配的基础问题。训练平台通常还要补上队列、成组调度、拓扑感知和多租户治理。
为什么分布式训练需要成组调度
一个 32 卡任务如果需要同时使用 4 个节点,就不能先启动其中两个节点,再让它们占着资源等待另外两个。
Gang Scheduling 解决的是“整组资源同时满足”:所需 worker 要么一起启动,要么暂时都不启动。它减少了部分资源被无效占用,但大任务也可能因此等得更久。
调度器还要面对彼此冲突的目标。小作业容易填入资源碎片,能抬高表面利用率;大作业则需要连续、拓扑合适的节点。回填、配额、优先级、抢占和公平共享,都在利用率与等待时间之间做取舍。
GPU 也不一定只能整卡独占:
调度难就难在:既要让任务拿到适合其计算和通信模式的资源,又要控制碎片、排队与相互干扰。
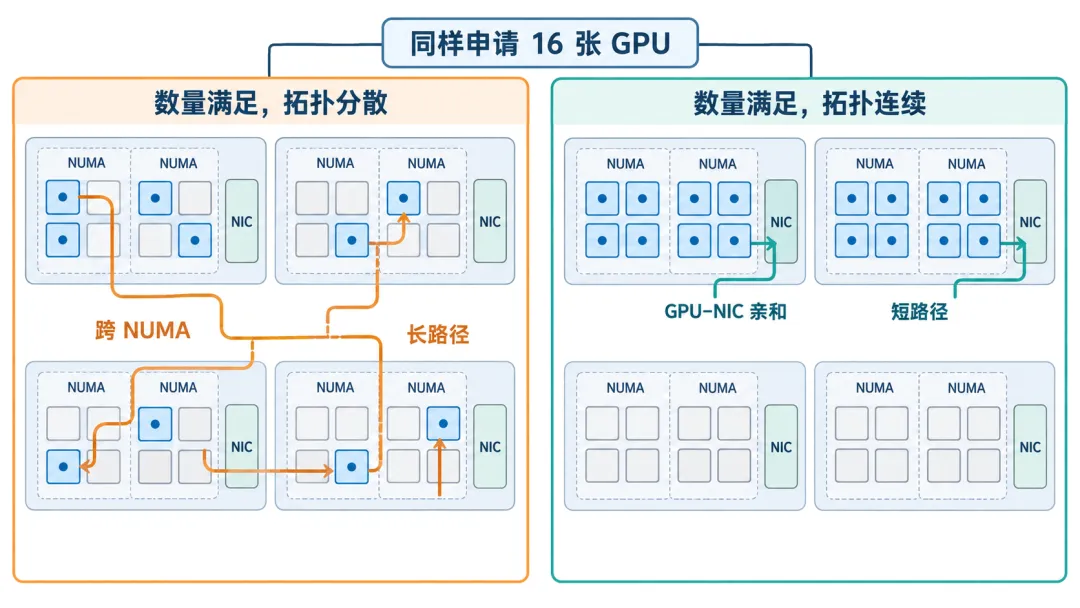
图 6:调度器不仅要凑够 GPU 数量,还应尽量选择拓扑连续、GPU–NIC 亲和的节点,避免跨 NUMA 和碎片化放置。
06存储:GPU 为什么会等数据和检查点
“通俗理解:GPU 是计算引擎,存储是供料系统。数据送得不够快,再贵的 GPU 也只能停下来等。
训练平台里的 I/O 至少有三种形态:持续并发读取数据集,周期性写入和恢复大体量检查点,以及持续产生体量较小的日志与指标。一个“存储带宽”概括不了它们。
大文件顺序读取主要关心吞吐,大量小文件则会频繁触发目录遍历、open、stat 等元数据操作。即使文件系统标称总带宽很高,元数据服务也可能先被打满。
平台常见的三类存储,各有自己的位置:
Lustre Operations Manual[10] 将元数据服务、对象存储目标和文件条带分开设计。它既解释了并行文件系统如何聚合吞吐,也说明文件布局和元数据为什么需要分别优化。
实际平台往往把对象存储、并行文件系统和本地 NVMe 组合起来:对象存储负责容量和长期保存,共享文件系统承载训练热数据与检查点,本地 NVMe 提供缓存和临时空间。三者处在不同的数据层级。
数据格式有时比换硬件更重要
如果数据集由几千万个小文件组成,只升级存储设备仍可能解决不了元数据压力。把样本打包成 shard、采用顺序读取格式、增加预取并合理配置 DataLoader,往往更直接。
CPU 解码、数据增强和 pinned memory 也处在输入路径上。看到 GPU 利用率周期性下跌,问题未必在磁盘,也可能是 CPU 预处理跟不上。
检查点会制造另一种压力。多节点训练在同一时刻写入参数和优化器状态,会形成突发流量;同步写入直接拉长训练停顿,异步写入虽然能减轻停顿,却要额外处理一致性、后台带宽和恢复完整性。
GPUDirect Storage[11] 可以在支持的软硬件配置下,减少存储与 GPU 缓冲区之间的额外 CPU bounce buffer。它适合较粗粒度的数据传输,但不会自动解决小文件、元数据、数据布局和上游存储能力。
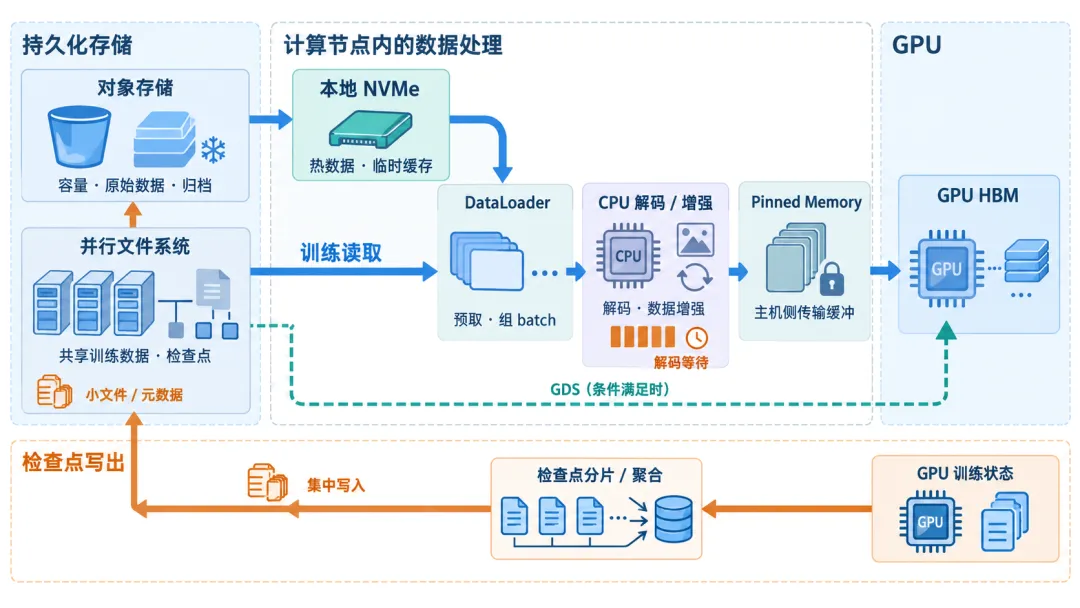
图 7:训练数据从持久化存储经过可选缓存、DataLoader 和 CPU 预处理进入 GPU 显存;检查点沿反向路径写出,小文件、解码和突发写入会在不同位置形成等待。
07容器:封装环境,不等于封装整台机器
“通俗理解:容器把代码、框架和依赖带到计算节点,GPU 驱动、设备、网络和存储仍由宿主机与平台提供。
AI 训练镜像通常包含 Python、训练代码、PyTorch 等框架、CUDA 用户态库、NCCL 和项目依赖。镜像让相同环境能在不同节点重复启动。
但容器没有封装整台服务器。Linux 内核、GPU 驱动、真实的 GPU 与 NIC、设备权限、网络命名空间,以及 NUMA、PCIe、NVLink 等硬件拓扑,仍来自宿主机。
NVIDIA Container Toolkit[12] 用来配置 Docker、containerd、CRI-O 等容器运行时对 NVIDIA GPU 的访问。调度器先决定任务能使用哪些 GPU,运行时再把相应设备和驱动能力提供给容器。
镜像能启动,多机训练仍可能失败
除了 GPU 设备,多节点训练还要检查:
· RDMA/InfiniBand 设备是否暴露进容器;
· /sys 中的 PCI 拓扑是否正确可见;
· 共享内存大小是否足够;
· NCCL、CUDA 用户态库与宿主机驱动是否兼容;
· memlock、capability 和安全策略是否允许所需操作。
容器不会自动改善 GPU-NIC 亲和,也不会修复底层网络配置。镜像一致,只解决了可复现问题的一部分。
更稳妥的实验记录至少应包括镜像 digest、代码提交、数据版本、训练参数、框架版本和宿主机驱动环境。只记录镜像标签并不可靠,因为标签可能被覆盖。
镜像大小也会影响作业启动。几十 GB 的镜像在大量节点上同时拉取,可能把镜像仓库和节点网络变成新瓶颈。镜像分层复用、节点缓存和预热,因而也是平台工程的一部分。
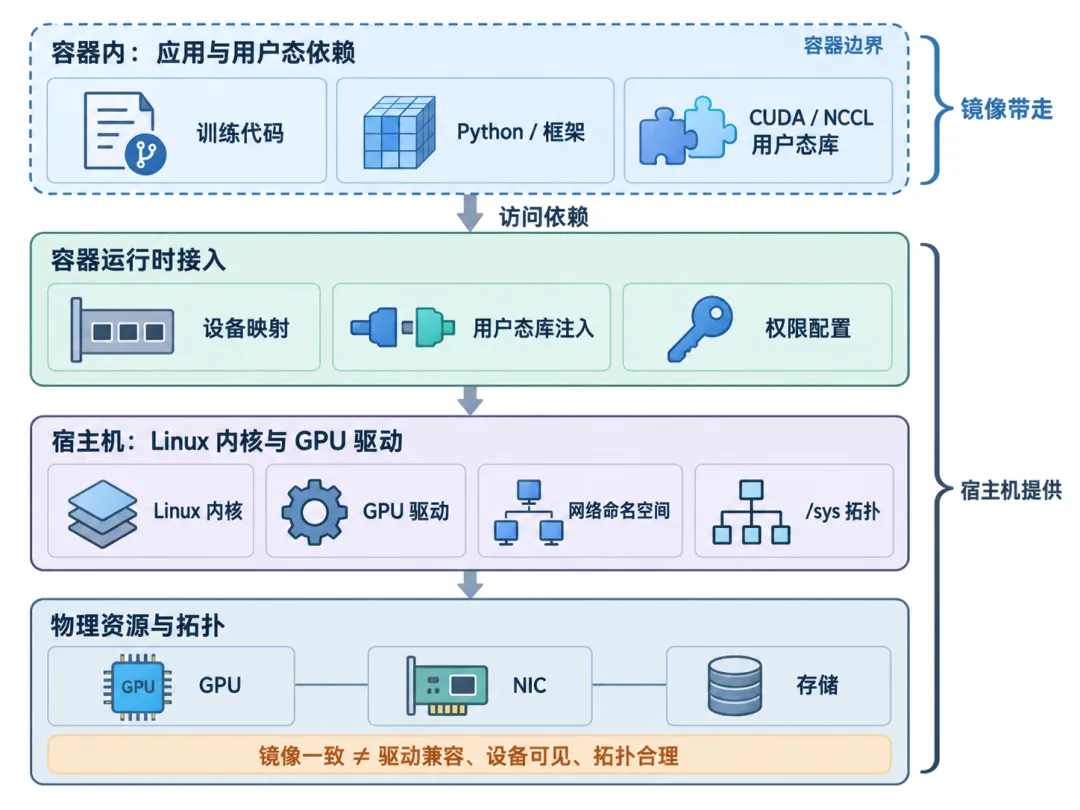
图 8:容器带走的是应用环境,不是整台机器;设备映射、驱动兼容、网络能力和硬件拓扑仍取决于宿主机与平台配置。
08监控:不只看 GPU 忙不忙,还要知道它在等什么
“通俗理解:监控要回答的不只是 GPU 利用率多少,还要说明它在算什么、在等什么、为什么变慢,以及问题属于哪项作业。
一套只展示 GPU 利用率、温度和显存占用的仪表盘,很难支持分布式训练排障。更完整的监控至少要把五层信息放到一起。
设备层:GPU 是否健康
观察 GPU 活跃度、显存使用、功耗、温度和时钟,也要记录 ECC 错误、Xid、降频、掉卡,以及 MIG 或共享 GPU 的资源归属。
通信层:GPU 是否在等其他 GPU
节点内要看 NVLink/NVSwitch 的链路、流量和错误,节点间要看 InfiniBand/RDMA 的端口状态、重传、拥塞和吞吐。再把这些指标与 NCCL 集合通信耗时、慢 rank 和尾延迟对应起来。
数据层:GPU 是否在等输入
文件系统吞吐、IOPS、元数据时延、本地缓存命中率、DataLoader 队列、CPU 解码,以及检查点写入时间,都可能解释 GPU 为什么停下来。
作业层:问题到底属于谁
设备指标需要关联作业 ID、Pod、队列、租户、节点、rank 和训练 step。否则仪表盘只能告诉你“GPU 3 的利用率下降”,却无法回答是哪项训练、哪个进程、哪一段执行出了问题。
DCGM Exporter[13] 可以把 DCGM 采集的 GPU 遥测转换为 Prometheus 指标,并可在 Kubernetes 环境中附加 Pod 等工作负载信息。它还要与调度、网络、存储和训练框架指标组合,才能提供完整的排障上下文。
平台层:机器很忙,不代表任务有效推进
平台还应统计作业排队与启动时间、任务成功率、失败原因、检查点恢复成功率、有效 GPU 小时,以及因数据等待、通信和故障浪费的 GPU 小时。
集群利用率很高,如果任务长期排队、频繁失败或单步吞吐很低,平台仍谈不上高效。比“GPU 忙了多久”更重要的问题是:这些 GPU 时间换来了多少有效训练进展。
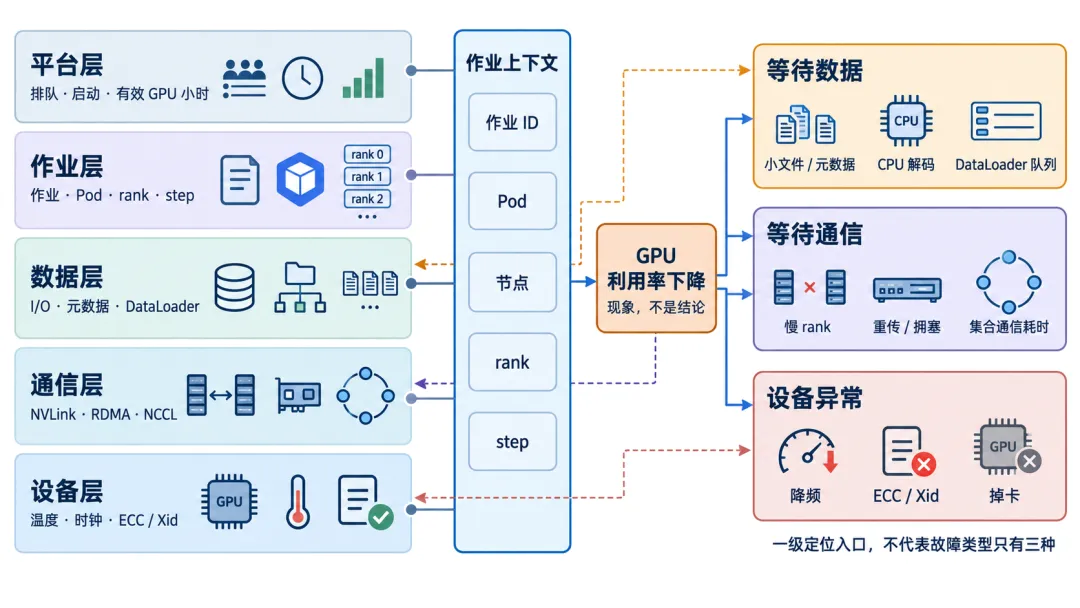
图 9:五层指标通过作业、Pod、节点、rank 和训练 step 关联起来后,才能从 GPU 利用率下降继续检查数据等待、通信等待或设备异常。
一次训练任务,怎样经过整套平台
以一项 4 节点、每节点 8 张 GPU 的训练任务为例:
1. 用户提交代码、镜像、GPU 数量、CPU、内存和存储需求;
2. 调度器检查队列、配额、节点健康和拓扑,选出 4 个合适节点;
3. 容器被拉取并启动,GPU、RDMA 设备、数据目录和检查点目录进入运行环境;
4. 存储提供训练数据,DataLoader 在 CPU 上预取、解码并整理 batch;
5. 数据进入显存,GPU执行前向和反向计算;
6. 同一节点内的 GPU 通过 NVLink/NVSwitch 交换梯度或中间张量;
7. 不同节点之间通过 InfiniBand/RDMA 完成集合通信;
8. 监控记录设备、通信、I/O、训练 step 和故障信息;
9. 训练周期性写入检查点,发生故障后从最近的有效状态恢复。
沿着这条执行路径,也能得到一套基本的排障顺序:
训练变慢├── GPU 活跃度低│ ├── DataLoader / CPU 预处理慢│ ├── 存储吞吐或元数据慢│ └── 进程在等待通信或同步├── GPU 活跃度高,但模型吞吐低│ ├── 算子没有有效使用 Tensor Core│ ├── 显存带宽受限│ └── 单个慢 rank 拖住整体├── 多卡扩展效率差│ ├── 节点内 NVLink / PCIe 拓扑不佳│ ├── 节点间 InfiniBand / RDMA 异常│ └── 并行策略产生的通信量过大└── 作业频繁失败 ├── 容器、驱动、CUDA 或 NCCL 不兼容 ├── GPU、NVLink、NIC 或存储存在健康问题 └── 检查点与恢复机制不完整最后
评估一套 AI 算力平台,只问 GPU 数量和单卡峰值算力,远远不够。
任务提交后要排队多久,拿到的 GPU 拓扑是否合理,数据能不能按时进入显存,多机同步是否稳定,训练中断后能否恢复,问题发生时能否找到对应的节点、链路和作业——这些问题更接近平台的真实水平。
GPU 给出了计算能力的上限。显存、互联、调度、存储、容器和监控,决定这些算力有多少能转化成训练进展。
一项任务能够顺利启动、持续运行,遇到问题找得到原因,发生故障还能从检查点恢复,这套昂贵的硬件才算真正用起来了。
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 |
参考链接
1. https://ai-mzq.github.io/From-Zero-to-AGI/:https://ai-mzq.github.io/From-Zero-to-AGI/
2. CUDA Programming Guide:https://docs.nvidia.com/cuda/cuda-programming-guide/01-introduction/programming-model.html
3. CUDA Best Practices Guide:https://docs.nvidia.com/cuda/cuda-c-best-practices-guide/index.html
4. CUDA Unified and System Memory 文档:https://docs.nvidia.com/cuda/cuda-programming-guide/02-basics/understanding-memory.html
5. NCCL 官方文档:https://docs.nvidia.com/deeplearning/nccl/
6. Topology and NVLink:https://docs.nvidia.com/datacenter/dcgm/latest/learn/core-services/topology-and-links.html
7. Networking Troubleshooting:https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/troubleshooting/networking_troubleshooting.html
8. Slurm GRES 文档:https://slurm.schedmd.com/gres.html
9. Kubernetes GPU Scheduling:https://kubernetes.io/docs/tasks/manage-gpus/scheduling-gpus/
10. Lustre Operations Manual:https://doc.lustre.org/lustre_manual.pdf
11. GPUDirect Storage:https://docs.nvidia.com/gpudirect-storage/overview-guide/index.html
12. NVIDIA Container Toolkit:https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/index.html
13. DCGM Exporter:https://docs.nvidia.com/datacenter/dcgm/latest/reference/command-line-reference/dcgm-exporter.html
14. NVIDIA CUDA Programming Guide:https://docs.nvidia.com/cuda/cuda-programming-guide/index.html