ARTICLE · 1147854
国产CAE仿真软件茉莉平台深度解析:核心算法、应用场景与UltraLAB硬件配置推荐(2026)
核心结论:CAE仿真计算是"CPU主频、内存带宽与容量、缓存命中率、并行扩展、存储I/O"五重敏感型负载。
前处理/后处理要高频,隐式求解要全核高频+大缓存,流体/显式动力学要多核+高带宽内存,超大规模要双路水冷平台——硬件配置必须跟着求解器特性走。本文硬件方案全部取自《UltraLAB图形工作站基准配置表2026v3》真实报价。
目录
引言:国产CAE的"平台化"突围 AI分析:茉莉平台技术架构与计算特点 主要核心算法及计算特点 主要应用场景 软件清单:茉莉平台仿真环境全栈 UltraLAB硬件配置推荐:基于2026v3报价表的四级方案 常见问题硬件配置分析(FAQ) 总结与选型结论
一、引言:国产CAE的"平台化"突围
CAE(计算机辅助工程)仿真的本质,是把物理学规律与工程学科理论模型经数学处理后固化为可求解的计算机程序——其底层是物理学与数学,核心是求解器。
长期以来,高端CAE市场被国外商业软件垄断。而在中国工程物理研究院高性能数值模拟软件中心(CAEP-SCNS),一支团队从2013年起走了一条不同的路:不是做单点软件,而是做一个高性能CAE软件快速研发通用平台——"茉莉平台"(Jasmine Platform)。
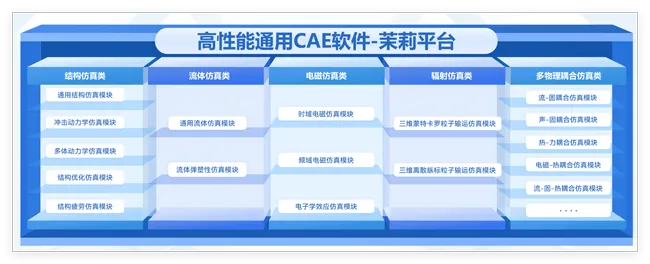
平台定位: 茉莉平台以"三高一快"(高产出、高置信、高效能、快速研发)模式,支撑重大装备行业用户在 6~12个月内快速建立专用高性能CAE软件系统,获得超过商业软件 1~2个量级 的计算能力。目前已支撑核、航空、航天、航发、船舶、兵器、机械、能源等领域的 50~60 余家装备单位,相关成果获国家科技进步奖、国家技术发明奖3项。
为什么叫"平台"而不是"软件"?因为茉莉平台解决的是一个更根本的问题:让拥有物理模型与工程Know-how的行业用户,不必从零写并行代码,就能把自己的算法快速产品化为高性能仿真APP。其市场化主体为中国久远高新技术装备有限公司CAE软件事业部(北京)与四川中久数创科技有限公司(成都)。
对最终用户而言,这意味着两件事:其一,国产替代不再只是"换界面",而是算力维度的跃升;其二,平台再先进,也要跑在硬件上——选对工作站,茉莉平台的并行能力才能完整释放。这正是本文后半部分要解决的问题。
二、AI分析:茉莉平台技术架构与计算特点
2.1 三大架构:把"共性"沉淀为平台
茉莉平台由三大部分及各自的标准化开放编程接口组成:
| 并行编程框架 | |||
| 离散中台 | |||
| 交互引擎 |
2.2 计算特点:四类负载,四种硬件脾气
选型启示: CAE工作站最常见的误区是"核数至上"。实际上:网格划分等你要盯着的操作,吃的是单核主频(如UltraLAB 24核5.5GHz超频平台);电磁频域、结构静力等隐式求解吃缓存与内存带宽(如霄龙7003X系列768MB大三缓);MPI流体/爆炸冲击吃总核数与并行效率(如128~256核双路水冷平台)。先定位你的主要求解类型,再定硬件。
三、主要核心算法及计算特点
3.1 学科解算器与数值方法
茉莉平台离散中台集成多学科学科共性PDE解算器,覆盖结构、流体、电磁、传热、燃烧 6 大类学科方向:
3.2 并行编程框架:从单机到万核
- 网格并行
:结构网格(块剖分+重叠区通信)与非结构网格(图剖分)两类并行范式统一封装; - 组合几何并行
:面向粒子输运的异步独立粒子追踪,天然适合大规模并行; - 并行I/O
:支持海量网格与结果文件的并行读写,checkpoint重启机制保障长时程计算可靠性。
工程验证: 平台模式已支撑聚变能源、航空发动机、水利水电等 11 个应用领域的 137 款超算软件快速研发——用户不必重复造"并行轮子",把精力集中在物理模型与行业Know-how上。
四、主要应用场景
趋势观察: 2026年的CAE正在与AI双向融合——一方面,大模型Agent开始通过MCP等协议操作仿真软件(自动生成网格、批量提交工况、智能Debug);另一方面,仿真数据成为训练AI代理模型(Surrogate/ROM)的高价值燃料。茉莉平台的开放接口架构,天然适合接入这类AI工具链。无论哪种路径,本地算力底座都是刚需。
五、软件清单:茉莉平台仿真环境全栈
5.1 平台与学科软件层
5.2 部署环境建议
- 操作系统:
Ubuntu 22.04/24.04 LTS 或国产麒麟/统信 UOS(信创环境) - 并行环境:
MPI + OpenMP 混合并行;GCC/Intel编译器双环境 - 远程可视化:
TurboVNC / NICE DCV,支撑图形工作站远程提交与交互 - 文件系统:
本地NVMe热数据 + 并行文件系统(集群)
六、UltraLAB硬件配置推荐:基于2026v3报价表的四级方案
方案A:前处理与轻量仿真工作站(¥25,500 ~ ¥52,000)
适合: 几何清理、网格划分(千万级以下)、百万网格结构/流体单场、教学科研入门、APP开发调试。
| A350156128-MCX(推荐) |
方案A说明: 前处理与GUI交互是单核高频负载,24核5.5GHz超频+水冷是网格划分效率的保障;128GB内存覆盖约3000万~5000万网格规模;RTX5070Ti支撑大规模模型流畅渲染。
方案B:单场大规模求解工作站(¥59,990 ~ ¥145,000)
适合: 千万级网格流体/结构、显式动力学、电磁频域/时域仿真,高校与院所课题组主力机。
| 电磁仿真(频域)高速计算 | |||
| GR450P15192-MCX(推荐) |
方案B说明: 两条技术路线——大缓存路线(霄龙7003X,768MB三级缓存显著缓解稀疏求解访存瓶颈,电磁频域/结构静力首选);全核高频路线(线程撕裂者7000X系列5.0GHz全核超频+双冷排水冷,时域算法/显式计算首选)。64核5.0GHz是单机CAE并行扩展的甜点区。
方案C:多物理耦合与大规模流体工作站(¥165,000 ~ ¥275,000)
适合: 128核级Fluent流体、多物理场耦合、亿级网格、燃烧/传热强耦合、课题组共享。
| EX660 230256-MCX(推荐) | 流体、碰撞、爆炸仿真计算 | ||
| 128核Fluent航空气动流体仿真 |
方案C说明: 128核是CAE MPI并行单机扩展的上限区:核数翻倍必须匹配内存带宽(12通道DDR5)与大缓存,否则扩展效率骤降。48GB专业卡兼顾亿级网格后处理与AI辅助计算。报价表明示128核4.1GHz机型可跑Fluent航空气动流体仿真与分子动力14B推理。
方案D:双路全水冷超算平台(¥89,990 ~ ¥999,950)
适合: 64~256核多物理场耦合、亿级以上网格、全系统级仿真、团队级共享算力与AI模型服务。
| 大规模有限元分析(显式算法、时域算法) | |||
| AlphaPro660 242640-MCD(旗舰推荐) | 最快的超大规模有限元:结构动态、电磁、流体、冲击爆炸、蒙特卡洛 | ||
方案D说明: 双路EX660/EA660全水冷系列覆盖64256核;AlphaPro660超级图形工作站主打192核4.2GHz全核高频+超大缓存(蒙特卡洛/显式有限元最优)与极速IO(14GB/s NVMe Gen5)。256核机型支持多模型并发,可作为510人团队AI模型服务平台。
七、常见问题硬件配置分析(FAQ)
看你的瓶颈环节。几何清理、网格划分、后处理交互是单核高频负载(选24核5.5GHz超频的A350);电磁频域、结构静力吃缓存与带宽(选768MB大缓存的霄龙7003X/9004X);MPI流体/爆炸冲击吃总核数(选128~256核双路EX660/AlphaPro660)。单机甜点区是全核5.0GHz的32~64核(GR450P系列)或128核双路。
经验法则:每100万网格单元约需2~4GB内存(双精度、含求解器开销)。500万网格建议96GB~128GB(A350高配);3000万~5000万网格建议192GB~256GB(GR450P/AE450);亿级网格需512GB~768GB(EX660/AlphaPro660);1.5TB内存(AlphaPro660 T61)可支撑超大规模全内存求解。内存不足触发swap,性能暴跌10倍以上。
隐式求解的稀疏矩阵运算有大量随机访存,768MB三级缓存(霄龙7573X/7773X/9684X)可显著降低内存访问瓶颈,电磁频域、结构静力、EDA后仿真收益可达30%以上。UltraLAB AE450与EX660系列提供多款大缓存机型(¥59,990起)。
分两层看:前处理/后处理(几何渲染、亿级网格云图)强依赖GPU图形性能;求解加速方面,显式动力学、CFD、电磁FDTD等部分求解器支持GPU加速。报价表中RTX PRO 5000 48GB/72GB、RTX PRO 6000 96GB机型即为"CAE+AI双负载"设计;纯隐式结构求解仍以CPU+内存带宽为王。
三个信号:① 单机内存装不下网格;② 单机核数翻倍但wall time几乎不降;③ 团队排队等算力。此时升级双路EX660/EA660(64~256核全水冷,¥89,990起)或AlphaPro660(192~256核,¥330,000起),并配Slurm调度与高速IO。注意:网格太小的算例上多核平台反而更慢,并行效率取决于问题规模。
茉莉平台基于MPI/OpenMP并行框架,对CPU主频、缓存、内存带宽/容量、高速I/O敏感,与主流商业CAE硬件画像一致。差异在于信创环境适配:建议选用完成国产OS(麒麟/统信)兼容性验证的平台;UltraLAB全部工作站支持本地部署大模型,可远程测试验证。
八、总结与选型结论
8.1 选型路线一张图(按2026v3报价表真实价格)
¥5.2万   A350 24核5.5GHz+128GB    →  前处理/千万级网格/单场入门
¥6~14.5万 AE450大缓存 或 GR450P全核5GHz →  电磁频域/结构静力/显式动力学
¥11.2~27.5万 128核EX660/AE450     →  Fluent流体/碰撞爆炸/多物理耦合
¥9~42万  EX660/EA660双路全水冷    →  64~256核团队共享/极限IO
¥33~100万 AlphaPro660 192~256核   →  超大规模有限元/蒙特卡洛/CAE+AI一体平台
8.2 结论
国产CAE的价值不止于"替代":茉莉平台的平台化模式,让用户在6 12个月内获得超商业软件12个量级的计算能力;硬件跟着求解器特性走:高频给前处理(A350 5.5GHz)、大缓存给隐式求解(霄龙7003X/9004X)、全核高频给时域显式(GR450P 5.0GHz)、多核+带宽给MPI流体(128核EX660)、双路超算给团队共享(AlphaPro660); UltraLAB四级方案覆盖¥25,500~¥999,950全价位带,所有机型支持本地大模型部署与远程测试,可按茉莉平台学科方向与网格规模定制。
选型理念: 采购前请准备三项信息——主要学科方向(结构/流体/电磁/耦合)、典型网格规模与时间步数、单机还是团队共享。UltraLAB可据此对CPU主频/核数/缓存、内存容量与通道、NVMe分层、GPU显存、网络与散热进行定制化设计,并提供编译器、MPI与调度环境预装调优,实现"求解器匹配优先于参数堆砌"。
8.3 写在最后
CAE软件的自主化,卡的不只是算法,还有"算法跑在什么硬件上"。当茉莉平台把并行框架、PDE解算器与交互引擎做成"公共底座",硬件就成了决定体验的最后一公里——网格划得快不快、隐式求解喂不喂得饱、checkpoint写不写得出、亿级网格渲染卡不卡,全部是工程问题。
选对一台工作站,就是让国产CAE的每一分并行能力,都转化为你的研发效率。