ARTICLE · 1150053
AI Agent * Python爬虫进阶!从网页采集到JS逆向!
AI Agent * Python爬虫进阶!从网页采集到JS逆向!
经管实证最让人头疼的,可能不是不会跑回归,而是好不容易有了一个idea,却发现数据根本拿不到。现在越来越多经管顶刊研究开始从网站平台、企业公告、政策文本、招聘信息、专利、社交媒体等海量互联网数据中寻找新的研究对象、构建新的实证变量。很多让人眼前一亮的选题,背后往往都有一套传统数据库无法直接提供的独特数据。
但真正轮到自己做研究时,最容易卡住的恰恰是数据这一关:有了idea,却不知道数据从哪里找;找到了网站,却不知道如何批量获取;好不容易跑通一次,又很难稳定复现和持续更新。这也是为什么Python数据采集越来越成为经管实证研究中非常重要的一项基础能力,很大程度上也决定了实证选题和变量创新的边界。
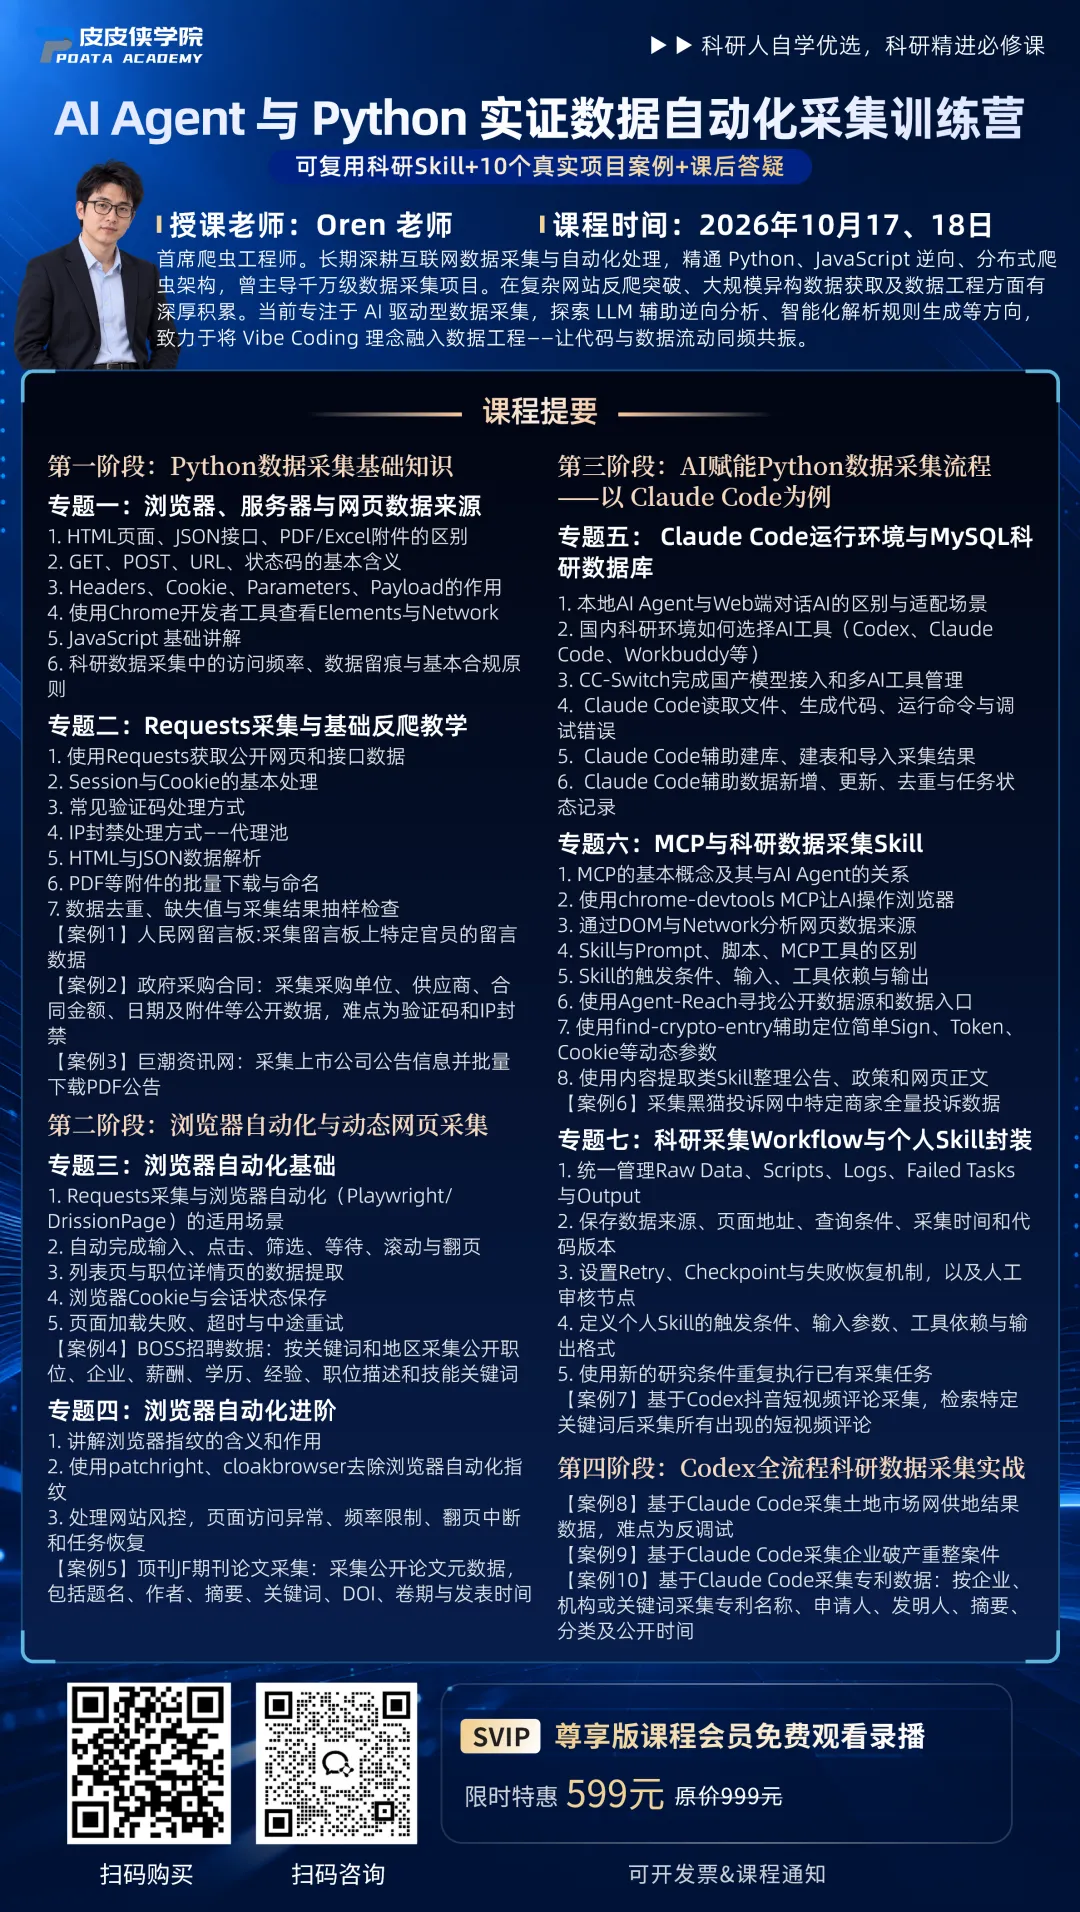
也正因如此,我们推出 《AI Agent 与 Python 实证数据自动化采集训练营》。课程不从大量Python语法和抽象爬虫原理讲起,而是围绕真实科研数据怎么找、怎么采、怎么形成可用的实证数据集展开,以10个真实科研数据采集项目贯穿教学,覆盖多类型网站与多种科研数据场景。从Requests网页与接口采集、PDF批量获取,到Playwright/DrissionPage浏览器自动化,再到ClaudeCode + MCP驱动的AI Agent采集,带着学员实操政府采购、巨潮资讯、BOSS招聘、土地市场、专利数据等代表性项目。进一步将AI Agent与Skill、Workflow结合,让学员面对新的研究问题时,能够自己寻找数据源、设计采集方案、批量构建数据,并持续复用已有工作流。最终希望学员通过这门课程,能够实现让Python爬虫和AI Agent真正成为拓展新数据、新变量、新选题的实证研究工具。
01 课程概览 课程名称:AI Agent与Python实证数据自动化采集训练营 课程时间:2026年10月17-18日,上午9:00-12:00,下午14:00-17:00 授课形式:线上直播+课后回放+课程资料+答疑 报名方式: 
课程优势: (1)10个真实项目案例:全程演示讲解,覆盖招聘就业、学术文献、政务公开、贸易金融、舆情媒体、地理与环境六大领域。 (2)难度阶梯式设计:从静态页面到反爬对抗,难度依次递进。 (3)「知识点+真实案例+课后产出」闭环:不讲空语法,学员每讲完即交付可运行脚本与真实样本数据。 02 授课团队 Oren 老师, 首席爬虫工程师。长期深耕互联网数据采集与自动化处理,精通 Python、JavaScript 逆向、分布式爬虫架构,曾主导千万级数据采集项目。在复杂网站反爬突破、大规模异构数据获取及数据工程方面有深厚积累。当前专注于 AI 驱动型数据采集,探索 LLM 辅助逆向分析、智能化解析规则生成等方向,致力于将 Vibe Coding 理念融入数据工程——让代码与数据流动同频共振。 03 课程大纲 第一阶段:Python数据采集基础知识 专题一:浏览器、服务器与网页数据来源 浏览器与服务器如何通过请求和响应传递数据 HTML页面、JSON接口、PDF/Excel附件的区别 GET、POST、URL、状态码的基本含义 Headers、Cookie、Parameters、Payload的作用 使用Chrome开发者工具查看Elements与Network JavaScript基础讲解 判断网站适合直接请求还是浏览器自动化 科研数据采集中的访问频率、数据留痕与基本合规原则
专题二:Requests采集与基础反爬教学 1. 使用Requests获取公开网页和接口数据 2. Session与Cookie的基本处理 3. 常见验证码处理方式 4. IP 封禁处理方式——代理池 5. HTML与JSON数据解析 6. PDF等附件的批量下载与命名 7. 数据去重、缺失值与采集结果抽样检查 【实战案例1】人民网留言板:采集留言板上特定官员的留言数据。 【实战案例2】政府采购合同:采集采购单位、供应商、合同金额、日期及附件等公开数据。难点为验证码和 IP 封禁。 【实战案例3】巨潮资讯网:采集上市公司公告信息并批量下载PDF公告。 第二阶段:浏览器自动化与动态网页采集 专题三:浏览器自动化基础 1. Requests采集与浏览器自动化(Playwright/DrissionPage的适用场景) 2. 自动完成输入、点击、筛选、等待、滚动与翻页 3. 列表页与职位详情页的数据提取 4. 浏览器Cookie与会话状态保存 5. 页面加载失败、超时与中途重试 【实战案例4】BOSS招聘数据:按关键词和地区采集公开职位、企业、薪酬、学历、经验、职位描述和技能关键词。 专题四:浏览器自动化进阶 1. 配置合规代理IP 2. 讲解浏览器指纹的含义和作用 3. 使用patchright、cloakbrowser等Python指纹浏览器库去除浏览器自动化指纹 4.处理网站风控,页面访问异常、频率限制、翻页中断和任务恢复 【实战案例5】顶刊JF论文采集:采集The Journal of Finance期刊公开论文元数据,包括题名、作者、摘要、关键词、DOI、卷期与发表时间。难点在于 IP 质量和浏览器环境。 第三阶段:AI赋能Python数据采集流程—以Claude Code为例 专题五:Claude Code运行环境与MySQL科研数据库
1. 本地AI Agent与Web 端对话AI的区别与适配场景 2. 国内科研环境如何选择 AI 工具(Codex、Claude Code、Workbuddy 等) 3. CC-Switch 完成国产模型接入和多 AI 工具管理 4. Claude Code读取文件、生成代码、运行命令与调试错误 5. Python、Node.js运行环境与项目依赖 6. MySQL数据库、数据表、主键与唯一ID 7. Claude Code辅助建库、建表和导入采集结果 8. Claude Code辅助数据新增、更新、去重与任务状态记录 专题六:MCP与科研数据采集Skill 1. MCP的基本概念及其与AI Agent的关系 2. 使用chrome-devtools MCP让AI操作浏览器 3. 通过DOM与Network分析网页数据来源 4. Skill与Prompt、脚本、MCP工具的区别 5. Skill的触发条件、输入、工具依赖与输出 6. 使用Agent-Reach寻找公开数据源和数据入口 7. 使用find-crypto-entry辅助定位简单Sign、Token、Cookie等动态参数 8. 使用内容提取类Skill整理公告、政策和网页正文 【实战案例6】采集黑猫投诉网中特定商家全量投诉数据,难点在于加密参数 专题七:科研采集Workflow与个人Skill封装 1. 统一管理Raw Data、Scripts、Logs、Failed Tasks与Output 2. 保存数据来源、页面地址、查询条件、采集时间和代码版本 3. 将年份、关键词、地区、企业等研究条件参数化 4. 设置Retry、Checkpoint与失败恢复机制 5. 设置必要的人工审核节点 6. 定义个人Skill的触发条件、输入参数、工具依赖与输出格式 7. 使用新的研究条件重复执行已有采集任务 8. 自动更新MySQL数据并生成任务总结 【实战案例7】基于Claude Code抖音短视频评论采集,检索特定关键词后采集所有出现的短视频评论 第四阶段:Claude Code全流程科研数据采集实战 【实战案例8】基于Claude Code采集土地市场网供地结果数据,难点为反调试。 【实战案例9】基于Claude Code采集企业破产重整案件。 【实战案例10】基于Claude Code 采集专利数据采集:按 企业、机构或关键词采集专利名称、申请人、发明人、摘要、分类及公开时间,难点为 Cookies 和 IP 封禁。 04 课程报名 课程价格 拼团价:699元/人(3人起) 原价:999元/人
可按照实际支付金额开具电子发票 价格包含:直播课程+录播回放+课程资料+课程答疑(仅开课前支付能进答疑群) 如有以下优惠,购买前找客服领取优惠券。 (1)优惠一 普通用户转发本推文到朋友圈/皮皮侠数据会员,私聊客服可获八折优惠券。 (2)优惠二 尊享版超级课程会员可在直播结束后免费学习此录播课程;如需直播+答疑+录播,超级课程会员可折扣购买该课程。 扫码成为超级课程会员 
经管实证最让人头疼的,可能不是不会跑回归,而是好不容易有了一个idea,却发现数据根本拿不到。现在越来越多经管顶刊研究开始从网站平台、企业公告、政策文本、招聘信息、专利、社交媒体等海量互联网数据中寻找新的研究对象、构建新的实证变量。很多让人眼前一亮的选题,背后往往都有一套传统数据库无法直接提供的独特数据。
但真正轮到自己做研究时,最容易卡住的恰恰是数据这一关:有了idea,却不知道数据从哪里找;找到了网站,却不知道如何批量获取;好不容易跑通一次,又很难稳定复现和持续更新。这也是为什么Python数据采集越来越成为经管实证研究中非常重要的一项基础能力,很大程度上也决定了实证选题和变量创新的边界。
也正因如此,我们推出 《AI Agent 与 Python 实证数据自动化采集训练营》。课程不从大量Python语法和抽象爬虫原理讲起,而是围绕真实科研数据怎么找、怎么采、怎么形成可用的实证数据集展开,以10个真实科研数据采集项目贯穿教学,覆盖多类型网站与多种科研数据场景。从Requests网页与接口采集、PDF批量获取,到Playwright/DrissionPage浏览器自动化,再到ClaudeCode + MCP驱动的AI Agent采集,带着学员实操政府采购、巨潮资讯、BOSS招聘、土地市场、专利数据等代表性项目。进一步将AI Agent与Skill、Workflow结合,让学员面对新的研究问题时,能够自己寻找数据源、设计采集方案、批量构建数据,并持续复用已有工作流。最终希望学员通过这门课程,能够实现让Python爬虫和AI Agent真正成为拓展新数据、新变量、新选题的实证研究工具。
浏览器与服务器如何通过请求和响应传递数据 HTML页面、JSON接口、PDF/Excel附件的区别 GET、POST、URL、状态码的基本含义 Headers、Cookie、Parameters、Payload的作用 使用Chrome开发者工具查看Elements与Network JavaScript基础讲解 判断网站适合直接请求还是浏览器自动化 科研数据采集中的访问频率、数据留痕与基本合规原则
拼团价:699元/人(3人起) 原价:999元/人