ARTICLE · 1150048
家里这台旧电脑,跑起了 7440 亿参数的 AI 大模型(GitHub推荐 JustVugg/colibri)
备稿日期:2026-10-10 | 栏目:GitHub精品推荐 | 项目:JustVugg/colibri | Star:40,818(2026-10-10核实)| 协议:Apache-2.0 | 项目链接:https://github.com/JustVugg/colibri
前几天 GitHub trending 上有个项目把我看愣了:一个纯 C 语言写的小引擎,号称能在你家里的普通电脑上跑起 7440 亿参数的大模型。4.1 万 star,README 还有中文版。我第一反应是不信——直到我搞懂了它背后的门道。
跑大模型,曾经是个"富人游戏"
先说个背景。7440 亿参数的 GLM-5.2 这类顶级开源模型,完整跑起来要几百 GB 显存,那是几十万的 GPU 服务器干的活。普通人想亲手摸一下这种级别的模型,基本没门。
colibri 要干的,就是把这扇门踹开。
它是怎么把大象塞进冰箱的
门道藏在"混合专家"四个字里。
现在顶尖的开源大模型基本都是 MoE 架构:模型里养着几十上百个"专家",但每次回答问题,只喊其中几个起来干活。GLM-5.2 有 7440 亿参数,真正参与一次回答的,大概只有 5% 左右。
colibri 赌的就是这一点。它把"常用部分"塞进内存,把不常用的专家权重扔在硬盘里,生成回答时按需从硬盘流式读进来。官方承诺得很硬气:缺显存只降速,不偷偷改模型精度。
这么一折腾,门槛从"几十万的 GPU 服务器"掉到了"一台 8GB 内存的旧笔记本"。Windows 上下载 ZIP 双击 START-HERE.bat,Linux/macOS 跑个 start-here.sh,脚本自动检测硬件、推荐适配的模型,一路下载断点续传,全程中文提示。
上手之后,体验分两面说
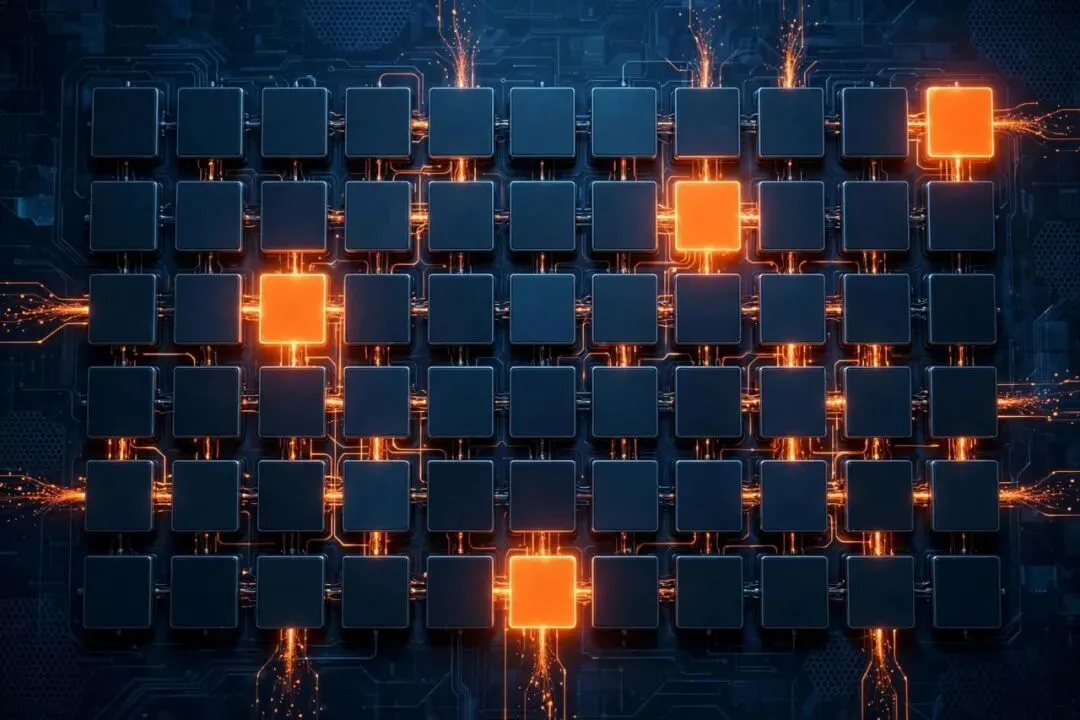
先说好的。`coli chat` 直接开聊,`coli web` 还能在浏览器打开一个仪表盘——每个专家的"点火"过程实时可视化,哪个专家被喊起来干活了,一眼看穿。想搞懂 MoE 到底怎么回事的人,这比看一百篇论文直观。
生态野心也不小:对外暴露 OpenAI/Anthropic 兼容接口(http://127.0.0.1:8000/v1),能接到自己的 AI 应用里;支持 MCP Server,连上 AI 编程助手还能自动装机。GLM-5.2/5.3、DeepSeek V4 Flash、Kimi K3、Qwen3 全系,国产主流大模型基本全覆盖。
但丑话说前面:慢,是真慢。纯 CPU 解码只有 0.05 到 1.8 tok/s,普通笔记本上冷启动极慢——能跑,但龟速,跟云端 API 完全没法比。硬盘占用也吓人:744B 模型要下 429GB,还得是 NVMe 硬盘才跟得上。另外提醒一句,Qwen-Image-2.1 标的是非商业许可,别拿去商用。
谁适合折腾它
想亲手摸一下顶级开源模型长啥样的 AI 爱好者,可以试试——"我家电脑跑起了 7440 亿参数"这种体验,本身就值回折腾。隐私敏感的人也合适,数据不出本机,断网都能跑。个人开发者更可以玩玩,零费用,还能接到自己的应用里。
跟 ollama 比呢?ollama 跑的是几十 B 的小模型,colibri 直接挑战 744B 级别——这不是一个量级的故事。它的差异化就一句话:小引擎,扛大模型。
项目地址:https://github.com/JustVugg/colibri
Star:40,818(2026-10-10)| 协议:Apache-2.0 | 语言:C | 安装:Windows 下载 ZIP 双击 START-HERE.bat;Linux/macOS 执行 git clone 后运行 ./start-here.sh,按提示选模型
(配图1:旧笔记本跑起 744B 大模型的冲击画面;配图2:MoE 专家"点火"仪表盘示意)