ARTICLE · 1155636
这个 4.4 万 star 的 AI 审代码工具,为什么宁可漏报,也要把 token 打到 1/9?
一次改动牵涉很多文件时,AI 审查最难确认的往往不是“它报了几条问题”,而是:它到底看了哪些文件,评论有没有落到正确位置,换一套提示词结果会不会变。这些本该可复现的流程,不能完全交给模型临场决定。
GitHub 上的 alibaba/open-code-review 正是冲着这个问题来的。截至 2026 年 10 月 6 日抓取的 GitHub 页面,它有 43,886 个 stars、3,164 个 forks;项目仍在持续更新。它把文件选择、规则匹配、评论定位交给工程逻辑,让 LLM 在受控上下文中检索和判断。
它不是让 AI 审得更全面,而是用确定性流程,让“报出来的问题更准”、token 更少;代价是“真正存在的问题更容易漏掉”。与同底层模型的 Claude Code 对照,平均 token 约为 1/9;对应指标是 Precision、F1 更高,Recall 更低。这正是本文要讨论的工程取舍。
这里的“约为 1/9”是项目 README 对该比较的概括,不是所有模型的固定数字。OpenCodeReview 论文在六个模型后端上报告的 token 降幅为 5~15 倍;具体幅度会随模型和配置变化。
测试集 AACR-Bench 公开可查:50 个开源仓库、200 个真实 PR、10 种编程语言,经 80 多位资深工程师交叉验证,包含 1,505 条专家验证的问题。下文的比较都以这组基准和项目公开说明为范围,不把它写成所有团队都会复现的结果。
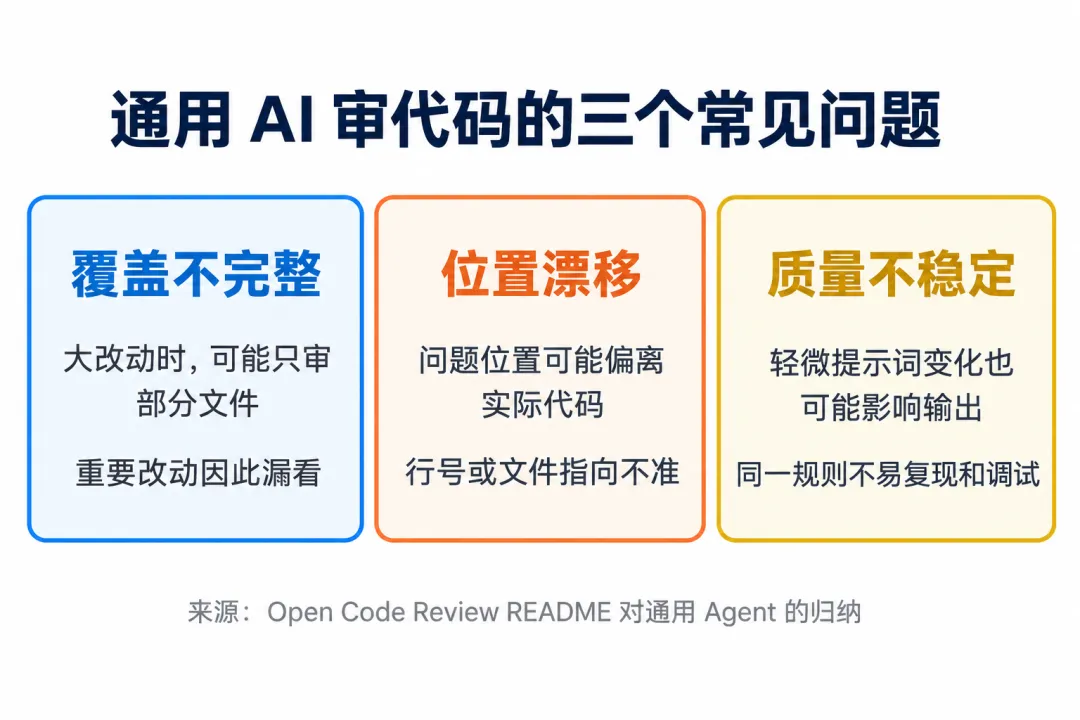
▲ 通用 AI 审代码的三个常见问题:覆盖不完整、位置漂移、质量不稳定
0101 通用编码工具审代码,会出三种事
这不是说通用 Agent 不会审代码,而是它们在缺少流程约束时,容易出现三类问题。
第一类:看不全。 改动一大时,模型可能只审其中一部分文件;如果没有明确的覆盖规则,重要改动就可能漏看。
第二类:行号漂移。 问题描述可能成立,评论的位置却可能偏离实际代码;行号或文件指向一旦不准,复核成本就会落到审查者身上。
第三类:质量忽高忽低。 用自然语言写规则时,轻微的提示词变化也可能影响输出;同一条审查规则难以复现和调试。
项目 README 的归因是:纯语言驱动的审查流程缺少硬约束。
0202 换了个做法:流程交给代码,判断交给模型
开头提到的 alibaba/open-code-review,项目 README 称它源自阿里内部使用两年的 AI 代码审查助手;公开版本提供简体中文文档和可配置的模型端点。它的重点不是让模型“什么都不做”,而是把可复现的流程约束交给工程逻辑。仓库链接:alibaba/open-code-review
第一部分是文件选择。哪些文件需要审、哪些可以过滤,由规则和工程逻辑决定,而不是完全交给模型权衡。
第二部分是文件打包。相关文件被打包成同一个审查单元;项目文档以中英文语言包为例。每个单元可由独立子任务处理,避免把所有改动粗暴塞进一个上下文。
第三部分是规则匹配。按文件特征匹配适用规则,而不是把全部规则都塞给模型自行挑选。模板化匹配的目标是让规则选择更稳定、可预测。
第四部分是位置模块和独立反思。位置模块把评论落到实际代码;独立反思只看 diff,过滤那些被 diff 直接否定的评论,而不是让模型在同一上下文里重复确认自己。
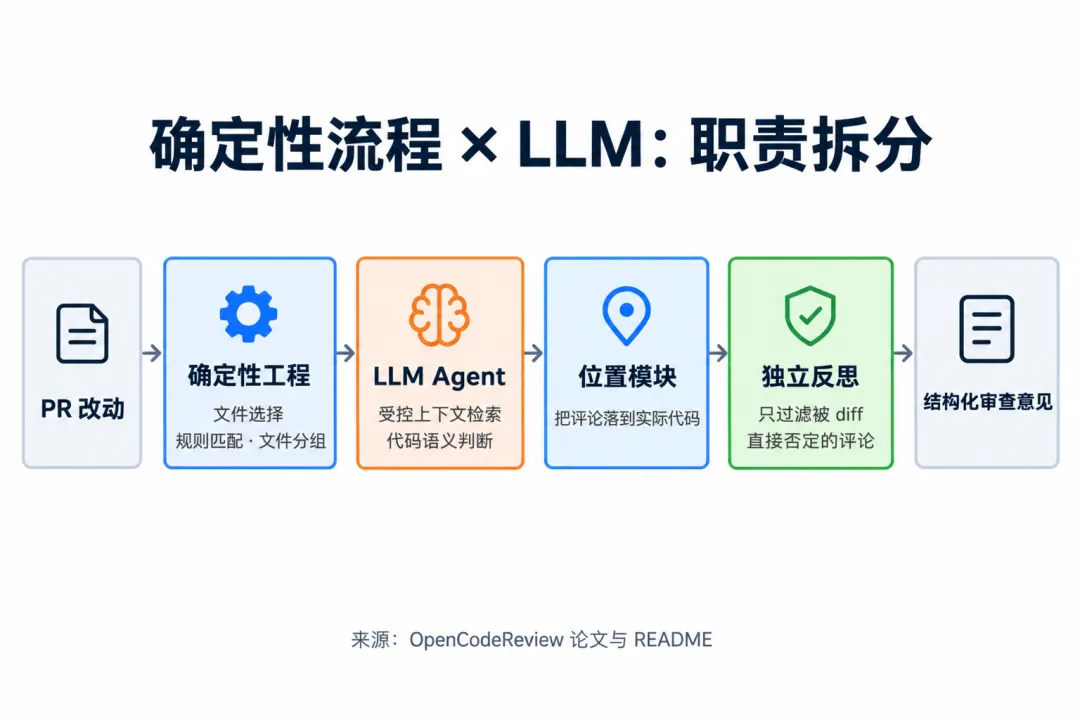
▲ 职责拆分:确定性工程、受控检索与判断、位置模块、独立反思
在这套拆分里,模型仍负责受控的上下文检索和代码语义判断;它不再独自决定全部流程。
0303 那张取舍表
换完之后跑出来的结果,是张有得有失的表。
Precision 上去了。 在项目公开的对照中,它报出来的问题里,是真问题的比例高于 Claude Code。少误报的价值很实际:审查者不用把大量时间花在筛噪音上。
F1 上去了。 Precision 和 Recall 合起来算的 F1 也更高;这仍是该基准、该对照范围内的结果。
开销约降到九分之一。 README 在与 Claude Code 使用同一底层模型的对照中这样概括;论文跨六个模型后端的结果为少 5~15 倍 token。工程化流程的作用,是在模型外先减少无关内容和无约束探索。
单次审查更快。 项目 README 也报告了更短的审查时间。
然后是最关键的一行。
查全率降下来了——该发现的问题,它比通用工具更容易漏。
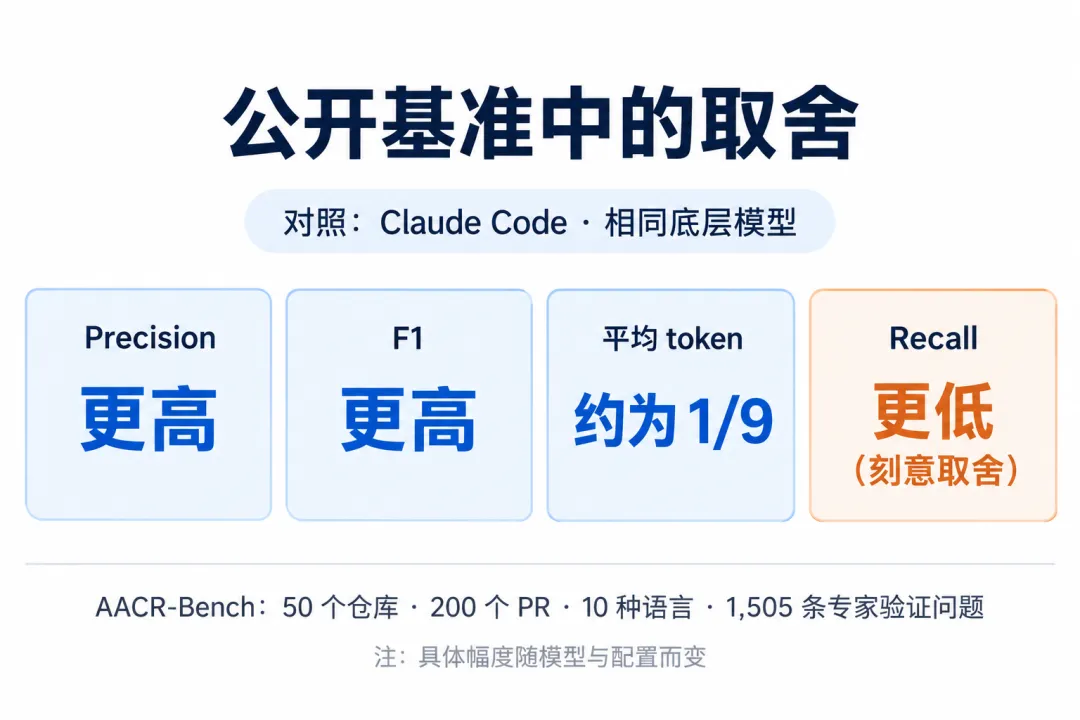
▲ 公开基准中的取舍:Precision、F1 更高,token 约为 1/9,Recall 更低
0404 最重要的一行:它承认自己会漏
这一条在公开文档里写得很直白:查全率低于通用编码工具,这是"宁可漏报、也不误报"的刻意取舍。
一个工具主动承认自己会漏,这在中文内容里很少见。大多数时候看到的都是"准确率提升百分之多少",很少有人把代价那一列也印出来。
但这个取舍是合理的,而且是经过权衡的。把这两条路摆在一起看:
- 宁可误报
:报 20 条,15 条是噪音。看的人要花两小时筛,筛到第 3 次就会开始跳过 AI 的意见。最后这个环节名存实亡。 - 宁可漏报
:只报 5 条,5 条都是真问题。看的人五分钟看完,每一次都认真看。剩下的漏网之鱼靠人工交叉审查兜住。
第二条路对重视低噪音的团队可能更可持续。一个审查环节能不能长期存活,取决于看的人还信不信它;而信任是靠“报的每一条都值得看”攒出来的,不是靠“报得多”。
误报消耗的是注意力,漏报消耗的是运气。注意力是有限的,运气不是。
0505 落地:AI 可以当第一道门,不能是最后一道
把这套取舍翻译成团队里能执行的规矩,是三句。
第一句:AI 负责堵低级问题。 空指针没判、异常吞掉了、日志打了敏感信息、命名跟项目规范不一致——这些它做得又快又稳,而且不会因为连续看 20 个文件而疲劳。
第二句:人负责最后一道。 架构层面的取舍、跟业务相关的边界条件、这次改动会不会影响别的服务——这些它看不见,因为它没有这次改动的背景。
第三句:把覆盖范围暴露出来。 这一条可以直接用。在合并请求模板里加一个字段,让审查工具填"这次覆盖了哪些文件、跳过了哪些"。看的人能一眼知道有没有"看不全"——这比看它报了几条问题有用得多。
提示 · 如果暂时没有工具,手动也能做:把审查规则写成模板而不是一段话,把文件清单先列出来再让 AI 逐组看,行号让它只说函数名、不猜行号。这三步手工做,也能拿掉大部分误报。
open-code-review 的 CLI 安装命令是 npm install -g @alibaba-group/open-code-review。它需要配置 LLM 提供商和模型(使用 Delegation Mode 时例外);README 同时提供 Claude Code、Codex、Cursor 等集成文档。它更适合已经有审查规则与责任边界的团队,而不是装完就替代人工合并判断的在线服务。
0606 一张自查清单
照着查一遍自己团队的审查流程:
☐AI 审完之后,有没有人核对过行号是否对得上
☐一次改动超过 20 个文件时,有没有办法知道它到底审了哪几个
☐审查规则是写在一段话里,还是按文件类型分了模板
☐报出来的问题里,上次有多少条被确认是真问题——这个数字有没有人统计
☐报出来的问题,最后一条是不是由人签字合并
☐有没有把"这次覆盖了哪些文件"写进合并请求模板
最后回到开头的取舍。把文件覆盖、规则选择、评论定位这些可复现步骤交给工程逻辑,能让模型把注意力留给代码语义;但 Recall 较低意味着人工仍是最后一道防线。流程拆分提高的是可控性,不是把审查责任交给 AI。
0707 资料与口径
仓库热度:GitHub 页面于 2026 年 10 月 6 日抓取时,alibaba/open-code-review 为 43,886 stars、3,164 forks;这类数字会持续变化。GitHub 仓库
约 1/9:项目 README 对“与 Claude Code 使用相同底层模型”的比较概括为平均 token 约 1/9,同时说明 Precision、F1 更高而 Recall 更低。
5~15 倍:OpenCodeReview 论文报告,在六个模型后端上 token 消耗少 5~15 倍;具体数值会随模型、提示词和配置而变。
基准:AACR-Bench 包含 50 个开源仓库、200 个真实 PR、10 种语言和 1,505 条专家验证问题。本文不把该基准结果外推为所有团队的实际收益。