ARTICLE · 1181319
开源文档解析MinerU从3.0到4.0:统一文档模型、API接口、本地库和更友好的Agent阅读支持
# stars: 80k+ / license: Apache License 2.0https://github.com/opendatalab/MinerU
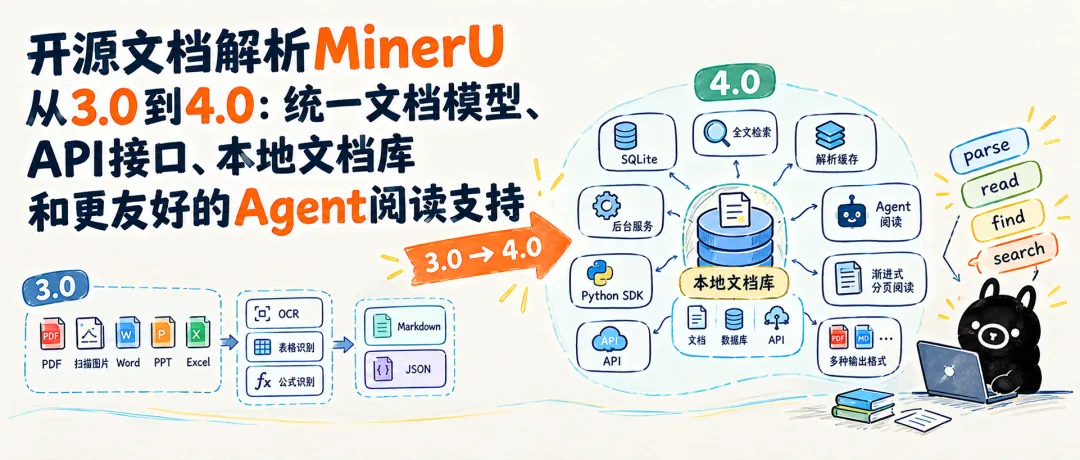
flash:快速预览、索引、原生文本解析。
basic:OCR、公式、表格等基础模型解析。
standard:复杂版面和高质量解析。
advanced:使用相同模型体系,但投入更多推理计算。
DOC/DOCX
PPT/PPTX
XLS/XLSX
RTF
ODT/ODS/ODP
EPUB
OFD
HTML/MHTML
CSV/TSV
# 快速的多格式文档解析与转换引擎https://github.com/myhloli/docvortex
数据库记录:通过SQLite数据库保存保存文件路径、大小、修改时间、SHA256、文档元数据、解析任务、档位、页码范围、状态、错误等信息 全文检索:使用SQLite FTS5保存文件名与解析正文索引,提供全文检索服务。 解析缓存:保存 Middle JSON、Markdown、图片素材等解析产物 后台服务:后台服务负责目录扫描、文件变更检测、入库、解析调度、缓存复用和清理。
files:文件真实路径,同一内容可以对应多个路径 docs:按照SHA256去重后的文档内容身份 parses:某个文档在特定解析档位、页码范围下的解析或者缓存记录
4.x新增了命令族:parse、read、find、search、show、list、watch、scan,以及缓存管理(invalidate、forget、cleanup)与后台服务(mineru server start / status)。
常规的文档解析路径是:
输入 PDF → 一次性解析完整文件 → 返回完整结果对于大型PDF文档比如100页+,一次性加载文档解析结果很容易撑爆上下文,4.x新增的parse命令默认读取PDF前10页并返回续读命令next_request,这类渐进式阅读模式适合Agent“逐页”读取文档,直到找到需要的内容。
mineru parse document.pdf --jsonmineru read <locator>mineru find ...mineru search ...mineru list ...mineru show ...
基于这些命令其实就可以把Agent本地文件操作模式(例如Grep/Edit/Read/Glob工具)映射为MinerU的文档阅读模式。
find / list↓定位目标文档↓parse↓建立或命中解析缓存↓search↓定位相关页面或块↓read locator↓根据 next_request 继续阅读↓带 locator 引用生成回答
注意MinerU自身并没有Agent Loop执行引擎。
4、统一SDK/API
新增无状态Python SDK:
from mineru.parser import parse, parse_asyncresult = parse("document.pdf", tier="standard")print(result.markdown())print(result.to_json())
V1 API服务接口统一为:
/v1/health
/v1/tiers
/v1/uploads
/v1/parse/jobs
/v1/files
# 典型的解析任务流程上传文件 → 创建解析任务 → 轮询任务状态 → 下载结果文件
旧的接口/file_parse、/tasks不再作为V1标准接口了。
5、统一渲染和输出
统一文档模型支持九种渲染目标:
Markdown
HTML
LaTeX
DOCX
EPUB
PDF
Structured Content
Content List V1
Content List V2
PDF 输出新增 AUTO / ORIGINAL / REFLOW 三种布局策略,能够在保留原始几何布局和语义重排之间选择。
6、小模型后端与VLM引擎解耦
在3.x版本的时候,小模型推理引擎主要通过backend/stack选择解析路径,4.x改为分别配置了并移除了stack:
model:small_backend: auto # auto / onnx / torchvlm:engine: auto # auto / llama-cpp / vllm / lmdeploy
基础包开箱即用:小模型走ONNX CPU,VLM使用llama.cpp Vulkan模式;mineru[torch]增加Torch小模型依赖,mineru[full]额外安装vLLM(Linux)或 LMDeploy(Windows);Apple Silicon默认安装Torch并以 llama.cpp 运行 VLM。
其他
截止目前文章完成最新的版本是v4.0.12,从4.0.0到4.0.12还有以下内容的持续增强:
MHTML/MHT 原生解析和预览。 EPUB 预览与章节导航。 V1 task 接口和 Router 负载均衡。 API 任务保留时间、资源回收和 usage 统计。 远端上传大小校验和过期处理。 表格 ONNX CUDA 自动选择。 Torch/ONNX CPU 线程控制。 PDF 原生文本解析性能优化和跨窗口复用。 更严格的 API 输出请求、模型能力和失败任务恢复处理。
4.x最大的变化就是从文档解析工具升级为了文档平台,特别是本地文档库更适合本地结合Agent应用一起使用了。3.x -> 4.x的迁移文档见:
https://opendatalab.github.io/MinerU/reference/migration_4/