ARTICLE · 1184398
我把 AI 助手整体搬了一次家:九个动作,一份可以直接照抄的清单
先说清楚对象。Hermes 是一个可以自托管的 AI 助手:你把它装在自己的服务器上,用 Telegram 这类聊天工具指挥它干活。它和普通脚本最大的区别是「会长」—— 技能、记忆、会话记录、知识库都会随时间沉淀下来。
打个比方:装 Hermes 像租个店面开业,搬 Hermes 像整店搬迁。桌椅好搬,难的是租约、账本,以及那些你忘了自己签过的东西。
所以这篇不讲道理,讲动作:这次整机迁移从头到尾做了九件事。每一步做什么、检查什么、哪里会翻车,都写清楚,最后给你一份可以照着走的清单。
一、全景:九个动作
① 盘点资产 → 分出「三层」 ② 建搬运清单 → 默认全搬 + 显式排除,落成单一文件 ③ 过审计门 → 六项检查,全绿才许动 ④ 新机初始化 → 时区 / 依赖 / 字体 / 浏览器内核 ⑤ 只读差异报告 → 新机 vs 旧机,不动任何一边 ⑥ 分两次传 → 先小状态,后全量(不停机,可反复跑) ⑦ 停机窗口切换 → 只切状态,不动数据 ⑧ 新机验收 → 同一个审计脚本再跑一遍 ⑨ 加固与保留回滚 → 防火墙 / SSH / 自动回滚;旧机不格盘 顺序不是随便排的:①②③ 决定你会不会丢东西,④⑤⑥ 决定切换窗口有多短,⑦⑧⑨ 决定你敢不敢回滚。
下面逐个说。另外先说一句:下面每一版的清单都不是一次成型的,第四节专门讲它被补了七轮的过程。
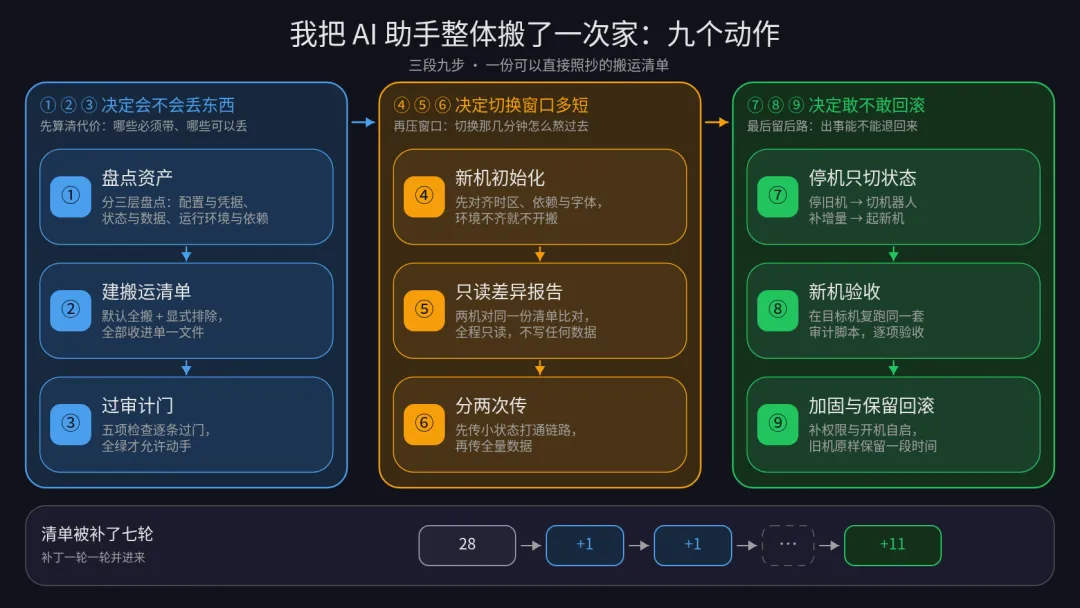
图:九个动作,三段三色 —— 前三步决定会不会丢东西,中间三步决定切换窗口有多短,最后三步决定敢不敢回滚。
二、动作①②:盘点,然后分三层
先分类,再动手。 要搬的东西分三层:
判定标准只有一条:能不能重建。 能重建的可以排除;不能重建的,再小也要搬。
然后重点找三类最容易漏的东西,这三类上次全漏了:
一是和主目录同级的文件。 凭据文件、 shell 配置、 SSH 目录 —— 它们不在「 Hermes 目录」里,而在它的旁边。按目录搬运的思路天然扫不到。上次的后果是每次登录报错、 20 个凭据全部重配。
二是软链的目标。 技能目录里有上百个软链,目标却在另一个兄弟目录里。软链本身就是一份依赖声明,但几乎没人把它当清单项看。上次 113 个软链断了 97 个。
三是状态目录。 比如某个抓取任务的历史基线。这类东西丢了不会报错 —— 服务照样起来,任务照样跑,只是数据静默归零,而且不可恢复。
三、动作③:写一张「默认全搬」的清单
这是整套流程里最重要的一个决定。
不要写「要搬哪些目录」,要写「根目录默认全搬,以下除外」。
原因很简单:允许清单天生会漂移 —— 你新增一个目录就忘一次。排除清单不会:忘记加,最多只是多搬一点。
第二个要求:清单必须是一个文件。 它散在多个脚本里的时候,没有任何一处能回答「到底搬什么」。这一条我是被自己打出来的:审计时只对着其中一个脚本看,得出「 11 项没覆盖」的结论,实际上其中三项写在另一个脚本里。
格式可以照抄:
[roots]/root[exclude] # 整目录排除,且必须写理由/root/.npm # 163M npm 缓存,可再生/root/.cache # 通用缓存(例外见 include)[exclude_glob] # 通配排除,作用于任意深度.venv/__pycache__/*_request_dump_*.json[include] # 被排除目录里必须搬的例外/root/.cache/ms-playwright # 浏览器内核,重下极慢加一条规则:排除项必须写理由。 不写理由的排除项,就是下一个漏项。
四、但我要老实说:这张清单不是写出来的,是被事故喂大的
如果你只看到上面那张格式,会以为它一开始就设计好了。不是。
我把这次迁移的提交历史翻了一遍 —— 清单被补了七轮:
.ssh | authorized_keys,把自己锁在门外 | |
| 一次性加 11 条状态目录 | ||
看这个形状:28 → +1 → +1 → …… → +11。
前五轮,每一轮都是「出了事 → 去补一条」。这才是真正的坑 —— 不是某个目录忘了搬,而是修问题的方式:我在用「再补一条」,去修一个「清单天生会漏」的问题。
而且注意第 5 轮:一次补进 11 条。这说明漏掉的不是零星的,是整整一类 —— 只要你按目录去枚举,你就会把一整类东西整体忘掉。
所以第六轮我没再补目录,而是把清单反转了:默认全搬、显式排除、排除项必须写理由。这样下一次「补」,不再需要谁先出一次事故。
而第 7 轮是最值得记的:反转之后仍然补了两次。 一次是机制本身的盲区(新版排除只作用于根目录一级,排不掉嵌套文件);一次是我凭印象判断某个目录里大头是调试日志,实测才发现大头是会话记录本体。换了方法,不等于不会犯错 —— 只是错得更小、更容易发现。
能带走的一条:判断一个迁移方案好不好,不要看它列了多少条,要看「漏了以后,补起来要花多大代价」。如果补一条要改三个脚本、重跑一遍流程,它一定会继续漏;如果补一条只需要改一行、或者根本不用改,它才算是活的。
五、动作③续:加一道审计门
迁移之前跑,六项全绿才允许开始。每一项都对应一类真实翻车:
把它理解成机场安检:它不保证飞机不出事,但它把已知的危险物品拦在地面上。
验收的诀窍:同一个脚本在新机器上再跑一遍,就是验收 —— 不需要写两套检查。
六、动作④⑤⑥:初始化、差异、分两次传
新机初始化(动作④):时区必须与旧机一致 —— 定时任务是按墙钟跑的;然后是系统依赖、中文字体(渲染要用)、浏览器内核。
只读差异报告(动作⑤):新机与旧机对比一遍,纯只读,随时可跑,不动任何一边。
分两次传(动作⑥)。传输用 rsync ,参数别省:
rsync -aHAX --numeric-ids --compress --partial --stats --human-readable --mkpath -aHAX 是在保留权限、扩展属性和硬链接 —— 状态文件丢权限会直接读不出来。
三条禁忌,每条都是血泪:
一、绝不整体同步 .ssh 目录。 会覆盖目标机上的 authorized_keys,把自己锁在门外。只单独同步私钥和公钥。
二、绝不直接复制正在运行的数据库。 会话库在 WAL 模式下直接 cp 会得到损坏文件。要用 sqlite3 <db> ".backup <目标>",而且要等写者停下来。
三、排除运行时残留。 -wal、-shm、锁文件 —— 跟着数据一起过去只会制造假状态。
第一次传小状态( A 层,体积小、落地快、能提早验证),第二次传全量(清单驱动)。全程不停机、可反复跑, rsync 只补增量。
七、动作⑦:停机窗口只切状态
核心原则:把停机时间压到只剩「必须停的事」。
数据在预同步阶段早就传完了,所以停机窗口里只做四件事:
一、停旧机服务。 顺序要固定。
二、切机器人。 同一个 bot 绝不能在两台机器上同时运行 —— 会互相抢占消息,丢消息是必然的。必须单向「停旧 → 启新」,回滚则是「停新 → 启旧」。
三、补最后一段增量。 从停下来到现在产生的那点变化。
四、启新机服务,核对。
⚠️ 一个很容易踩的坑:切换脚本必须在 AI 助手之外的独立终端里跑。因为助手的会话本身就是服务的子进程 —— 你把服务停了,脚本会跟着一起被杀掉,切到一半就断在那里。
八、动作⑧⑨:验收、加固、保留回滚
验收(动作⑧):审计脚本在新机复跑 + 状态读回 + 依赖可导入 + 真实发一条消息看机器人回不回。
加固(动作⑨)。新机在加固之前是「裸奔」的:密码登录开着、没有防火墙 —— 而 22 端口从开机那一刻就在被扫描(实测 fail2ban 一启用就抓到正在爆破的 IP )。顺序是:
先 fail2ban ,再防火墙,最后 SSH 仅密钥。
凡是「可能把自己关在门外」的操作,先挂一个自动回滚定时器。 这样即使配置写错、连接断了,几分钟后系统会自动恢复 —— 你还有机会回去改。
旧机不格盘,保留七天作回滚窗口。验证通过之前,旧机一个字都不删。
九、照抄清单
[ ] 1 盘点资产,分 A/B/C 三层;重点找:同级文件 / 软链目标 / 状态目录 [ ] 2 写清单:根目录默认全搬 + 显式排除(单一文件,排除项必须写理由) └ 并且接受一件事:它一定还会被补。所以把「补起来便宜」当成硬指标 [ ] 3 跑六项审计门,全绿才允许开始 [ ] 4 新机初始化:时区与旧机一致、系统依赖、字体、浏览器内核 [ ] 5 出只读差异报告(不动任何一边) [ ] 6 第一次预同步:先传 A 层小状态,提早验证 [ ] 7 第二次预同步:清单驱动全量,不停机、可反复跑 [ ] 8 停机窗口:停旧 → 切机器人(单向)→ 补增量 → 启新 [ ] 9 新机跑同一个审计脚本 = 验收 [ ] 10 加固(fail2ban → 防火墙 → SSH 仅密钥)+ 自动回滚 + 旧机保留 7 天 十、实测数据与边界
这次的真实数字:清单驱动传输 23 条、约 21.26 GiB;其中一个 313M 的项目,排除掉可再生的虚拟环境和会话数据之后,实际只有 3.1M 需要搬。审计第一次运行就抓出 3 个断链,其中一个来自一个早已删掉的工具。
「看起来很大」和「真正不可再生」,是两件事。
边界:这套流程适用于单机自建 agent + 自建知识库,不适用于集群、多租户或要求零中断的业务 —— 停机窗口仍然需要几分钟。另外要说清楚:审计保证的是源机器这一侧的完整,它不替代目标机器的基础初始化。
参考资料
03_ops 目录下的迁移脚本集与运维日志(含上一次迁移的复盘发现)本文由 AI 辅助创作,作者进行了实测验证和编辑修改。