ARTICLE · 1184671
还在用老方法测算AI应用软件成本?新标即将发布,一文速览T/BSCEA 001-2026(征求意见稿)核心内容

点击上方蓝字关注我们


开篇导读:2025年8月,国务院印发《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11号),从国家到各地“十五五”规划密集出台,差异化部署数据要素和人工智能,人工智能应用密集进入政务与企事业单位的建设清单。那么区别于传统的定制开发软件应用系统,人工智能应用软件的费用构成包括哪些部分;参考传统的软件项目成本度量方式,是否可以准确估算AI软件开发的成本。2026年8月24日北京软件造价评估技术创新联盟针对《系统与软件工程 人工智能应用软件开发 成本度量》(T/BSCEA 001-2026)在其官网(https://www.bscea.org/)向全社会公开征求意见,这一标准的完善和出台可谓行业“及时雨”,本期文章我们就带着大家针对AI软件成本度量的困惑,结合目前已结束意见征求的T/BSCEA 001-2026,同大家一起拆解人工智能应用软件开发的费用测算逻辑。
关键字:人工智能;应用软件开发;费用评估;T/BSCEA 001-2026

《系统与软件工程 人工智能应用开发成本度量》将定于2026年10月28日第十一届中国软件估算大会正式发布,我们首先和大家一起来看下目前已结束意见征求的征求意见稿,为大家在信息化项目人工智能软件开发费用测算中提供相关工作思路。
何谓“人工智能应用软件开发”,参考《系统与软件工程 人工智能应用开发成本度量》T/BSCEA 001-2026(征求意见稿,下同)中给出的定义,具体是指“以人工智能技术为核心,针对人类定义的给定目标,产生诸如内容、预测、推荐或决策等输出的一类应用软件开发活动”。
人工智能应用软件开发成本构成如下图所示(参考T/BSCEA 001-2026 征求意见稿图1重新整理)。相较于传统的软件项目成本,可以看出人工智能应用开发成本构成与其基本保持一致,主要是结合人工智能软件的特点(需要数据集支持和模型搭建)进行了细分和明确。
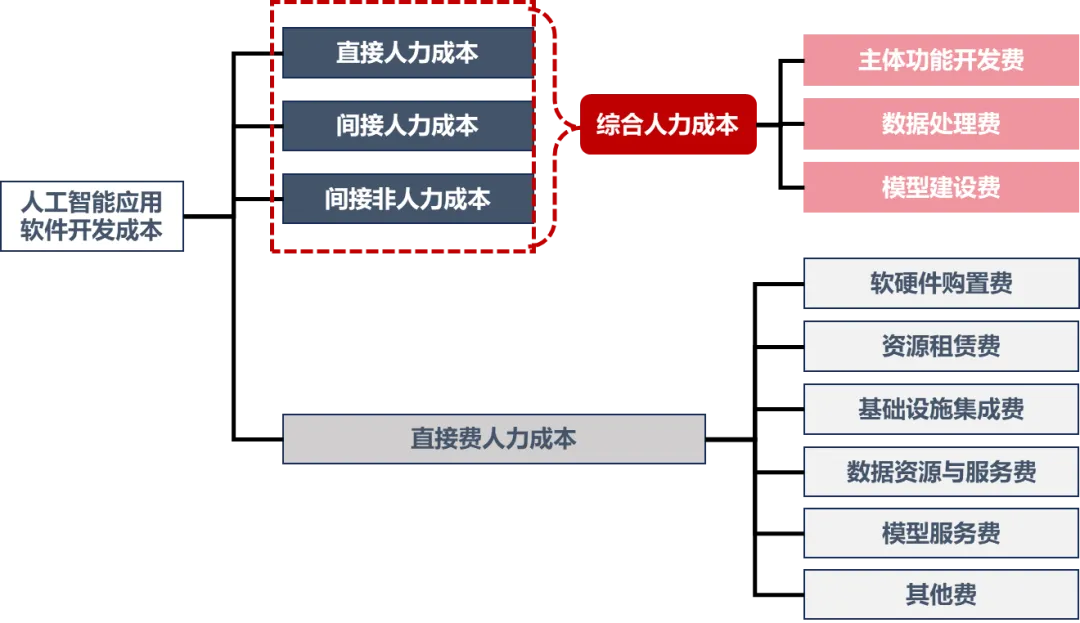

图1 人工智能应用软件开发成本构成
人工智能应用软件开发成本汇总表如下(参考T/BSCEA 001-2026 附录B表B.1重新整理,费用组成部分可根据项目实际情况计取)。
费用评估结果分为了上限、中值和下限,即:所评估的费用是在某一合理的浮动范围区间内,工作中最终结果一般会采用“中值”。

序号 | 费用名称 | 金额(单位:元)-下限 | 金额(单位:元)-中值 | 金额(单位:元)-上限 | 备注 |
一 | 软件开发综合人力成本 | ||||
1.1 | 主体功能开发费 | ||||
1.2 | 数据处理费 | ||||
1.3 | 模型建设费 | ||||
小计(一=1.1+1.2+1.3) | |||||
二 | 直接非人力成本 | ||||
2.1 | 软硬件购置费 | ||||
2.2 | 基础设施集成费 | ||||
2.3 | 模型服务费 | ||||
2.4 | 资源租赁费 | ||||
2.5 | 数据资源建设费 | ||||
2.6 | 其他费用 | ||||
小计(二=2.1+2.2+2.3+2.4+2.5+2.6) | |||||
总计(=一+二) | |||||
根据图1可以看出:主体功能开发费、数据处理费和模型建设费三者共同构成了人工智能应用软件开发成本费用的核心。此外,T/BSCEA 001-2026根据项目特点、费用分类等要素,给出了适合各类费用的评估方法(归纳为类比法、类推法、方程法及经验法4种),适用场景及说明详细如下。

注释: 1、第4-第9项,均属于“方程法”的子方法。 2、针对各项费用,特别需要注意的是评估过程中宜采用不同的方法分别评估并进行交叉验证。 3、类比法是指参考国家或地区公布的产品指导价。 4、类推法是指参考以往类似中标项目或项目合同案例中的有效价格(合同法)或通过市场询价方式确定市场行情价格(市场询价法)。 |
我们重点对主体功能开发费、数据处理费、模型建设费三部分费用测算进行拆解和详细说明。
1
--主体功能开发费--

是为了满足客户人工智能业务需求而开展业务功能开发、人工智能工具与服务平台(包括但不限于:数据工具、模型工具、服务平台与组件)功能开发和优化、人工智能应用集成等软件开发活动产生的综合人力成本。
主体功能开发费使用按国家标准GB/T 36964-2018 功能点方法进行人工智能应用软件规模识别,进一步核算出开发费用。T/BSCEA 001-2026在附录E中给出了一个具体的功能点识别的示例,小编认为这份示例非常标准和易于理解,非常适合初学者对功能点识别方法进行快速学习,摘取了其中部分具有代表性的示例供大家参考。

编号 | 子系统 | 一级 模块 | 二级 模块 | 功能点计数项名称 | 类别 | UFP | 重用程度 | 修改 类型 | US | 备注 |
… | …… | …… | …… | …… | …… | … | …… | …… | …… | …… |
25 | 智能问答系统 | 知识库管理 | 创建知识库 | 知识库文件 | ILF | 10 | 低 | 新增 | 10.00 | |
26 | 知识库创建 | EI | 4 | 低 | 新增 | 4.00 | ||||
27 | 知识导入 | 知识导入 | EI | 4 | 高 | 新增 | 1.33 | |||
28 | 错误日志下载 | EQ | 4 | 低 | 新增 | 4.00 | ||||
29 | 在线测试 | 问答测试 | EO | 5 | 低 | 新增 | 5.00 | |||
30 | 测试结果信息 | ILF | 10 | 低 | 新增 | 10.00 | ||||
31 | 段落管理 | 知识段落信息 | ILF | 10 | 低 | 新增 | 10.00 | |||
32 | 知识段落查看 | EQ | 4 | 低 | 新增 | 4.00 | ||||
33 | 知识段落编辑 | EI | 4 | 低 | 新增 | 4.00 | ||||
34 | 知识段落合并 | EI | 4 | 低 | 新增 | 4.00 | ||||
35 | 知识段落拆分 | EI | 4 | 低 | 新增 | 4.00 | ||||
36 | 知识段落禁用 | EI | 4 | 低 | 新增 | 4.00 | ||||
37 | 知识更新 | 知识库修改 | EI | 4 | 低 | 新增 | 4.00 | |||
38 | 知识删除 | EI | 4 | 低 | 新增 | 4.00 | ||||
39 | 知识库列表查询 | EQ | 4 | 低 | 新增 | 4.00 | ||||
40 | 知识导出 | EQ | 4 | 低 | 新增 | 4.00 | ||||
41 | 图谱关系手动关联 | 知识图谱信息 | ILF | 10 | 低 | 新增 | 10.00 | |||
42 | 图谱关系手动关联 | EI | 4 | 低 | 新增 | 4.00 | ||||
43 | 关系类型自定义 | EI | 4 | 低 | 新增 | 4.00 | ||||
44 | 知识审核与发布 | 知识审核 | EI | 4 | 低 | 新增 | 4.00 | |||
45 | 知识条目发布 | EI | 4 | 低 | 新增 | 4.00 | ||||
46 | 版本回滚 | 版本回滚 | EI | 4 | 低 | 新增 | 4.00 | |||
… | …… | …… | …… | …… | …… | …… | …… | …… | …… | …… |
64 | 智能问答系统 | 应用集成需求 | 与客服系统对接 | 对话记录推送 | 非独立业务功能 | |||||
65 | 基础大模型接入 | 对话信息 | 功能重复,已计数 | |||||||
… | …… | …… | …… | …… | …… | …… | …… | …… | …… | …… |
很多小伙伴对EO和EQ的识别常有困惑,结合表中的例子来说明(以下仅为个人理解,如有异议欢迎评论区留言互动):“问答测试”,此操作由系统内部发起穿越人机交互界面达到用户侧,另须根据测试规则进行复杂运算后生成新的信息,故识别为EO而非EQ;“知识导出”直接为数据库的“读”操作,并没有伴随复杂运算且没有生成新的数据,故识别为EQ而非EO。
功能点识别后仍然需要对其进行工作量调整,进一步折算出软件开发费用,感兴趣的小伙伴可以查阅GB/T 36964-2018具体内容。
2
--数据处理费--

是指为支撑人工智能模型建设而开展的数据工程活动(包括:数据准备、整理、采集、清洗、转换、标注、预处理、数据质量控制、数据安全、存储与管理等)所产生费用中的综合人力成本。
闭坑指南⚠️:如部分数据工程活动不由项目开发方实施,而是通过购买数据或数据服务的方式获取,则相应费用计入直接非人力成本中的数据资源与服务费中,二者不得重复计取。
除计时方程法外,附录C针对数据处理费“基准工时方程法”给出了详细的基准工作量及调整因子,可供信息化咨询设计及造价专业人员在进行费用评估时进行参考,详细如下。

序号 | 典型任务包 | 基准工作量示例(人天) | 影响因素示例 | 影响因素示例说明 | 影响因素分级示例 | 调整因子计算及取值示例 | 备注 |
1 | 传统人工智能的数据处理 | 11~19 | 数据类型DF1.1 | 简单:文本; 一般:图像音频; 复杂:视频、多模态融合; | 简单:-2 一般:0 复杂:2 | AF1=1.0 +(DF1.1+DF1.2 +DF1.3)×0.03 取值范围:0.79~1.21 | |
数据规模DF1.2 | 小规模:样本量<5000 条; 中规模:样本量在5000~5万条; 大规模:样本量>5 万条; | 小规模:-3 中规模:0 大规模:3 | AF1=1.0 +(DF1.1+DF1.2 +DF1.3)×0.03 取值范围:0.79~1.21 | ||||
数据质量DF1.3 | 高:低质量数据占比<5%; 中:低质量数据占比在5~20%之间; 低:低质量数据占比超过20%; | 高:-2 中:0 低:2 | AF1=1.0 +(DF1.1+DF1.2 +DF1.3)×0.03 取值范围:0.79~1.21 | ||||
2 | 智能体建设的数据处理 | 33~53 | 数据类型DF2.1 | 简单:文本; 一般:图像音频; 复杂:视频、多模态融合; | 简单:-2 一般:0 复杂:2 | AF2 = 1.0 +(DF2.1 +DF2.2 +DF2.3)×0.05 取值范围:0.65~1.35 | |
数据规模DF2.2 | 小规模:样本量<5000条;知识库文档≤50份; 中规模:样本量在5000~5万条;知识库文档51~200份; 大规模:样本量>5万条;知识库>200份; | 小规模:-3 中规模:0 大规模:3 | AF2 = 1.0 +(DF2.1 +DF2.2 +DF2.3)×0.05 取值范围:0.65~1.35 | ||||
数据质量DF2.3 | 高质量:低质量数据占比<5%; 中:低质量数据占比在5~20%之间; 低质量:低质量数据占比超过20%; | 高质量:-2 中:0 低质量:2 | AF2 = 1.0 +(DF2.1 +DF2.2 +DF2.3)×0.05 取值范围:0.65~1.35 | ||||
3 | —— | —— | 数据复用程度DR | 无复用:全部数据新增加工; 部分复用:可复用存量数据占比≤50%; 较高复用:可复用存量数据占比>50%; 完全复用:全部使用已处理存量数据; | 无复用:1 部分复用:0.67 较高复用:0.33 完全复用:0 | DR取值范围:0~1.0 | |
4 | —— | —— | 数据处理工具化程度DDT | 无:无工具支持数据处理,全部人工处理; 低:工具支持部分不超过50%,其他需人工; 中:工具支持超过50%; 高:全部采用工具。 | 无:1.0 低:0.67 中:0.33 高:0.17 | DDT取值范围:0.17~1.0 |
表4的内容看起来非常复杂,但其实很好理解,即:结合工作具体实际查找任务包的基准工作量(可以理解为行业平均水平,类似于工程中的定额工作量),并综合数据类型、规模、质量、复用程度、处理工具化程度等具体因素,通过调整因子AF、DR和DDT来进一步核算数据处理任务的工作量。
具体来看T/BSCEA 001-2026给出的示例2:
根据智能体特征查表4对应任务包类型(基准工作量介于33~53这一范围内);各影响因素取值:数据类型DF2.1为-2(文本属于“简单”,对应取值为-2)、数据规模DF2.2为0(6000条属于“中规模”,对应取值为0)、数据质量DF2.3为(“中”对应为0),则调整因子AF2=1.0+(-2+0 +0)×0.05=0.9(符合0.65~1.35这一区间内)。
此外,数据复用程度因子DR为1(无复用对应为“中”,对应取值为1),工具化程度因子DDT为0.67(工具支持不超过50%属于“低”,对应取值为0.67)。
🧮该智能体应用数据处理总工作量=43×0.9×1×0.67/21.75≈1.19人月。
3
--模型建设费--

是指人工智能应用软件开发项目中开发方采用各种人工智能技术进行人工智能模型建设(包括新建和优化)活动所产生费用中的综合人力成本。
避坑指南⚠️:同数据处理费,如果部分人工智能工程活动不由项目开发方实施,而是通过外购第三方模型服务的方式获取,则相应的费用应计入直接非人力成本的模型服务费中,二者不得重复计取。
T/BSCEA 001-2026附录D同样给出了模型建设费的工作量测算方法及参考示例。典型任务包工作量估算的思路和数据建设费类似,即:结合工作具体实际查找任务包的基准工作量(典型的任务包分为:传统机器学习算法模型构建、模型选型与搭建、模型微调、知识库检索增强、提示词工程、智能体编排),并综合模型类型、任务包自研比例、任务包工具支持程度、开发团队经验、技术与工具成熟度等具体因素,通过调整因子TF、SR、TS、SF、MRDF和MRDF来进一步核算数据处理任务的工作量。由于篇幅限制,感兴趣的小伙伴可以具体查看T/BSCEA 001-2026附录D中更详细的内容。
🏁【部分专业术语解释】:参考T/BSCEA 001-2026 征求意见稿整理
★模型微调(model fine-tuning):在预训练模型的基础上,针对特定的下游任务使用特定领域或应用场景的专业或私有数据集进行再训练的过程,使模型适应新的任务要求。
★知识库检索增强(retrieval-augmented generation,RAG):一种通过从外部知识库中检索相关信息来增强和“锚定”大语言模型生成过程的技术,使模型能够基于检索到的上下文信息生成更准确、更新、可验证的答案。
★提示词工程(prompt engineering):通过设计和优化输入给AI模型的提示词(prompt),引导模型产生准确、有用输出的一系列技术和方法,包括指令设计、示例选择、输出格式规范等。
★智能体编排(agent orchestration):在统一系统中协调多个专用AI智能体,以高效实现共同目标的过程,包括任务分配、工作流协调、数据共享和上下文管理,使多个智能体能够协作解决复杂问题。
随着国务院“人工智能+”行动的全面推进,AI应用软件开发已从技术验证期迈入规模化落地期。T/BSCEA001-2026标准的适时出台,不仅为行业提供了一套科学、量化的成本度量工具,更在深层次上推动了AI项目从“拍脑袋报价”向“精细化运营”的范式转变。标准将定于2026年10月28日在第十一届中国软件估算大会正式发布,后续大家关注和可以关注官网信息。
然而,标准落地仅是第一步。面对AI技术快速迭代带来的新场景、新模型,成本度量方法也需持续演进。建议从业者在实际项目中,不仅要严格对标标准条款,更要关注数据处理、模型建设等隐性成本的动态变化,善用调整因子与复用系数,让每一分预算都花在刀刃上。未来,随着标准在更多行业的普及,AI软件的成本管理将变得更加透明、高效,为数智经济的健康发展筑牢根基。
大家的AI项目报价中,软件开发费、数据处理费和模型建设费的占比分别是多少?欢迎评论区留言讨论。



点击阅读原文,了解更多