ARTICLE · 1190968
AI原生组织进步了,谁决定经验怎么用?
2025年,Meta重组AI团队,并在10月裁减约600个岗位。2026年,它先发布Muse Spark模型,再推出个人Agent Muse。到了9月,媒体又报道:Meta开始邀请Applied AI部门的部分员工重新担任Manager。
从压缩部分团队规模,到在Applied AI部门重新安排管理岗位,这些发生在不同团队和阶段的调整,说明组织设计需要不断回应具体问题。Muse的发布也不能证明某一次裁员是正确答案;产品、团队与资源如何接上,才是这个案例值得看的地方。
当越来越多工作由人与AI共同完成,组织需要重新安排的,也包括经验如何积累、判断由谁作出。尤其当AI开始利用过去的工作记录改进下一次工作时,谁能决定这些经验如何被记录、调用和修正?
01 每个人都更快了,公司为什么还在等?
麦肯锡2026年的全球AI调查里,80%的受访者表示AI提高了个人生产力;37%的受访者认为AI对所在企业的息税前利润有正向贡献。两个数字衡量的不是同一件事,却提示我们:个人生产力的改善,转化为企业收益还需要经过更多环节。整件事的交付时间,就是其中一个值得观察的角度。
2026年云栖大会AI Native组织论坛上,阿里巴巴首席人才官蒋芳也谈到类似的落差:工程师写代码更快,端到端开发周期未必同步缩短。超级个体的集合,不会自然成为超级组织。
一个项目可能已经有了方案、原型和代码,仍在等待需求确认、交付责任落实,以及风险承担方式的明确。即使AI加快了部分环节,环节之间的等待和返工仍可能留在那里。
复盘这类项目时,可以把需求确认、责任交接和风险审批的时间点摆出来:工作在哪一步停住,谁能推动下一步,返工又从哪里开始?
个人更快不等于公司更快。环节之间的等待和返工,是个人提效后最容易漏算的时间成本。
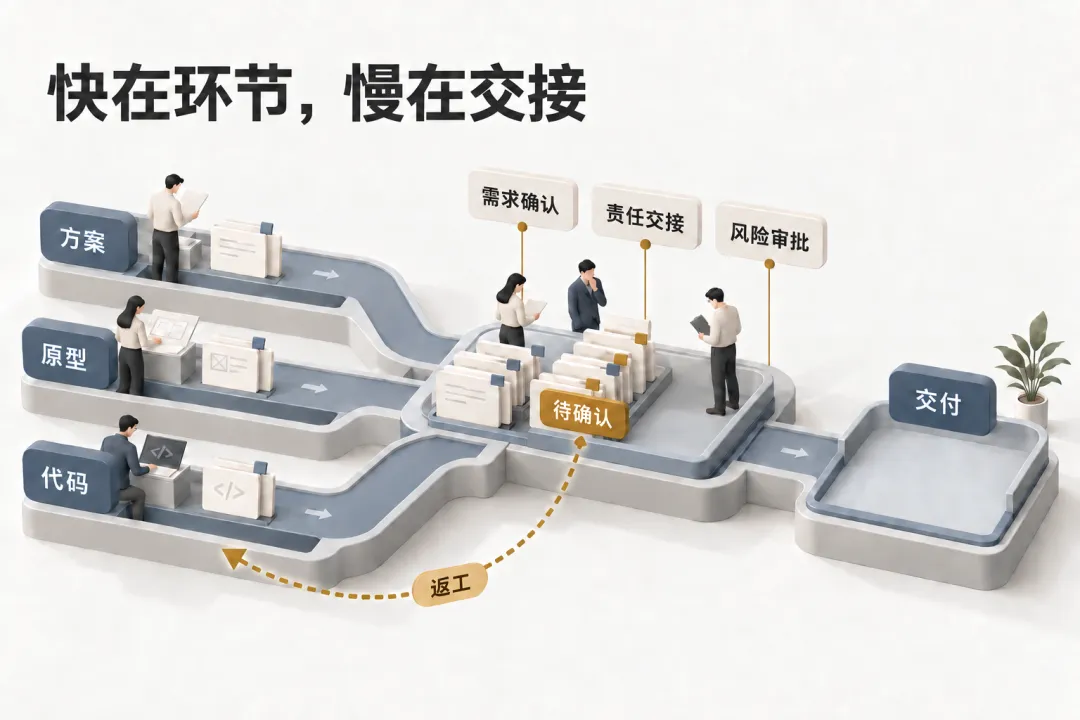
交接中的等待和返工,也要计入整件事的交付时间。
麦肯锡报告还有一组值得注意的观察:它将约6%的受访者归为AI高绩效者,这些受访者表示,所在企业至少5%的息税前利润可归因于AI,并认为AI带来了显著价值。在这一群体中,近四分之三表示已因AI而从根本上重新设计工作流;其他受访者中,约四分之一这样回答。这是一项调查中的相关特征,不能保证改流程就能赚钱。它至少提醒我们,评估AI投入时要看一项工作从开始到交付的完整过程。
02 工作系统开始学习,组织要怎样改变?
等待和返工有不同的成因。职责不清,需要重新安排协作;工具反复出错,则可以把失败记录转化为改进线索。YC的一个内部实践,展示了后一种可能。
YC合伙人Tom Blomfield介绍过一个内部例子:YC用Agent帮助员工查询数据,后来又让另一个Agent检查哪些查询失败,分析缺少的工具或数据视图,并尝试修复。第一次没答好的问题,下一次可能就能回答。
这里的“学习”,具体体现为根据失败记录修改工具或工作流程。系统需要能够读取工作记录、观察结果,也需要有人界定什么可以自动修改,什么必须经过核验。
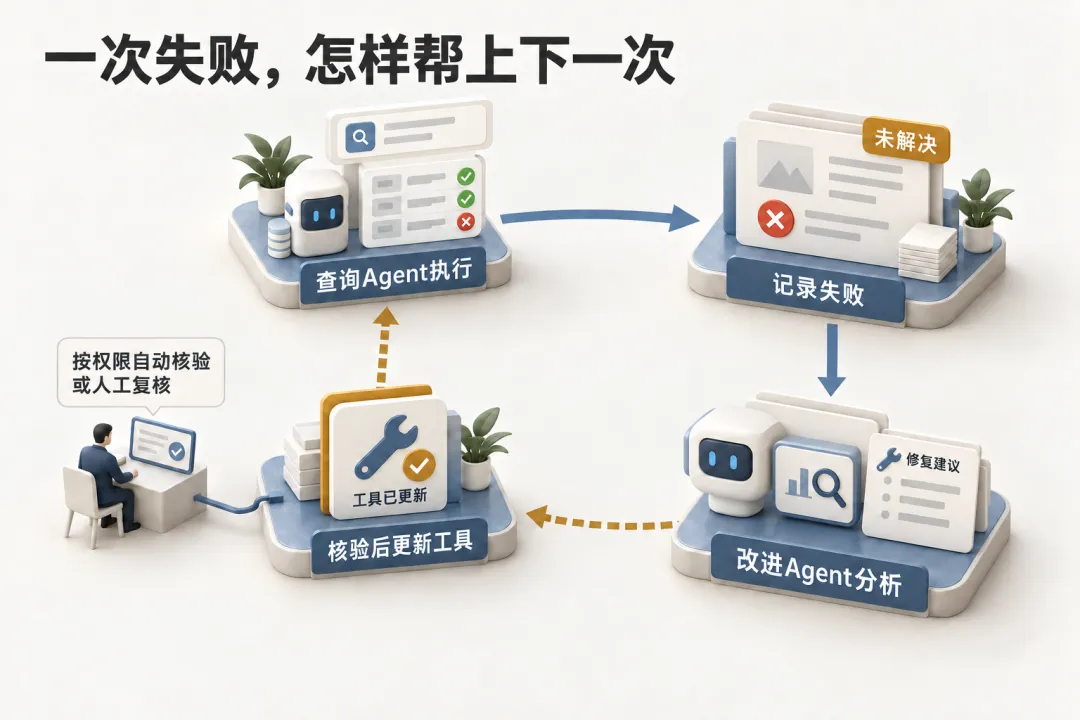
失败留下线索,形成修复建议;经核验的工具更新进入下一轮工作。
Tom还提出“burn tokens, not headcount”:工作增加时,先看能否用更多AI算力扩展产能。这改变了资源配置的选择,却不意味着Token花得越多、员工越少,组织就越有价值。
曾鸣从另一个角度描述未来组织:日常运营尽可能形成由AI执行的端到端闭环;人的工作更多转向在不确定环境中持续形成新认知、提高战略决策质量。随着工作流变化,固定岗位不一定仍是最合适的协作单位;具体任务需要什么能力,可以由人和Agent共同承担。
小禾自己也在经历这样的变化。团队目前只有三个人:巴布负责技术,子推负责产品,我负责运营。过去,我们各自带着团队推进工作;现在,我们按各自擅长的板块分工,与AI共同完成日常工作。
从讨论问题、制定方案到推进执行,AI参与了大部分环节。每个人在自己负责的板块里,把这些环节接起来,承担从想法到交付的完整责任;技术、产品和运营之间仍然需要彼此配合。这是我们在三人团队里探索AI原生组织的具体方式。
这样的工作方式也让我们更关心下一步:与AI讨论过的判断、执行中的反馈,怎样留下来,帮助下一次工作?当经验逐渐进入可使用、可修正的系统,一个不能略过的问题也随之出现:这些经验由谁贡献,谁能调用,又由谁核对和修正?
03 经验进入系统后,人不能从记录里消失
设想一位业务负责人,从第一次丢单开始,逐渐摸清客户为什么接受或拒绝某类方案。她在会议和项目复盘中留下判断理由,团队将这些记录整理成可供AI调用的背景。下一位同事处理相似需求时,不必一切从头摸索。
这对组织有益。但如果系统只保留一条“客户通常这样选择”的结论,原始条件、例外和贡献者的判断过程都被抹掉,下一次就可能用错。如果这样的结论继续被后续任务调用,一次误解就可能被反复放大。让经验能够被追溯和纠正,本身就是组织持续改进的条件。
所以,“让组织拥有记忆”还需要回答更具体的问题:哪些知识应当在团队内共享?客户资料能用于什么任务?经验被提炼后,谁能核对来源、指出失效条件?当AI据此采取行动,谁承担结果?
这些问题关系到经验能否被准确、恰当地复用。只保留结论,容易丢失适用条件;忽略资料的使用范围,也可能把客户信息带入未经授权的任务。组织积累经验的同时,需要保留来源、条件和使用边界。
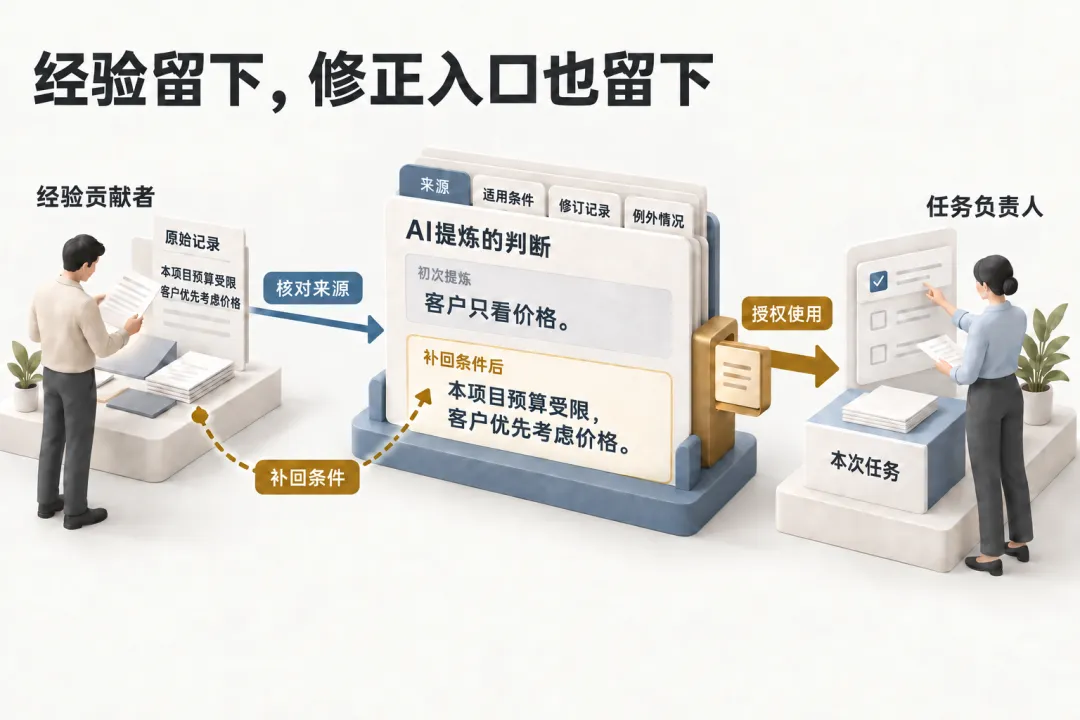
核对原始记录,补回适用条件,再按授权用于具体任务。(假设案例)
同样的控制问题,在面向个人的Agent中更直接:它可能接触用户的邮箱、日历和支付信息。Meta的Muse提供了一个例子:用户可以选择连接哪些应用、授予多大权限;发送邮件或购买商品前,系统会请求批准,并提供操作记录。用户还可以调整访问权限和管理记忆。
这些设计为用户控制AI接触什么信息、采取什么行动提供了入口。还值得继续追问:AI形成建议时依据了哪些信息?它有没有把过时的理解当成现在的偏好?使用者能否在行动之前发现并修正?
04 让组织进步,也让人保有主动权
小禾所说的“认知资产归你”,首先意味着,你应当能够掌握自己提供的资料,并参与核对、修正AI据此形成的理解。对于个人AI,资料用于什么任务、关键行动是否执行,都应当在你的授权范围内;已授权的日常任务则可以交给AI完成。
小禾从用户授权、相关资料的本地留存与导出做起,让用户更方便地保存和使用自己的资料。让AI对人的理解可核对、可修正,是我们继续推进的方向。从保存资料到核对AI形成的理解,用户的主动权需要落实到不同环节。
放到公司里,道理相通,安排却更复杂。组织需要让团队共享经过核对的经验,也需要保护客户信息、辨认人的贡献。
组织可以把这些权限分别安排:经验贡献者核对提炼是否准确,资料和流程负责人按授权确认使用范围,关键行动由明确的业务负责人把关。需要纠正的判断,也应有清楚的反馈和更新路径。人不必守在每一个自动化步骤中,但目标、边界、例外和结果,始终要有清楚的负责人。
AI原生组织没有一张永远适用的结构图。Meta在不同团队中调整组织安排,YC尝试让工作系统从失败中改进,云栖大会强调把个人能力连接成组织能力。对一家正在转型的公司来说,更实际的检验是:整件事有没有更好地完成?上一次工作的结果有没有帮上下一次?当系统越来越能干,人是否仍能看见、修正并负责关键判断?
公司可以在我们睡觉时继续进步。我们也该知道:它从什么经验中学习,为谁工作,谁有权改变它的判断。