ARTICLE · 1197541
【限时招募】把原始文档变成AI能用的数据:北大PKU-DCAI课题组DataFlow,三位领学人各带一群
【限时招募】把原始文档变成AI能用的数据:北大PKU-DCAI课题组DataFlow,三位领学人各带一群
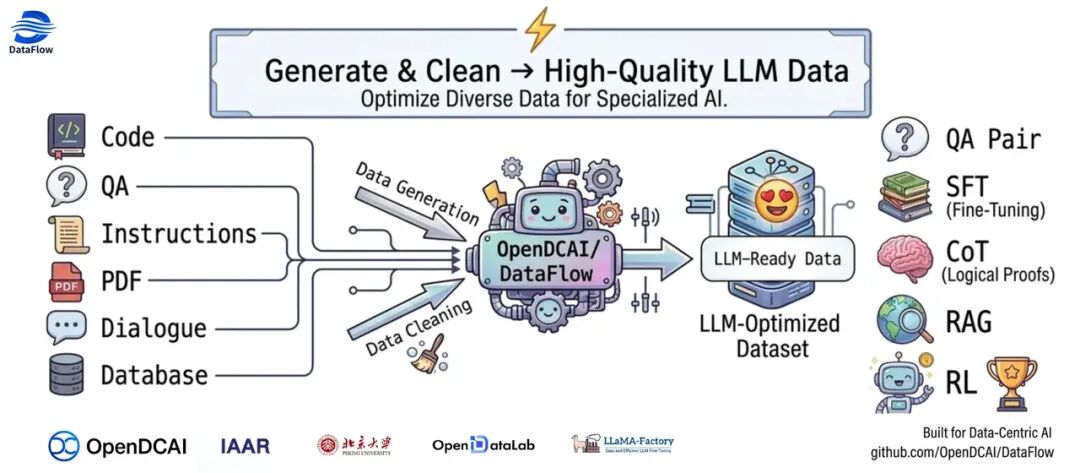
朋友们,我是老马,Datawhale 领学小组的成员。这次给大家带来一门实在的课——DataFlow · AI-Ready Data 实战,由 北京大学计算机学院 PKU-DCAI 课题组 贡献。这门课不讲虚的,就是教你怎样把一堆杂乱的PDF、网页、低质量的问答,变成AI模型真正能消化、能训练的干净数据。
领学的是三位年轻人:陈彦凯、魏杰、刘伟。他们每人带一个学习群,每个群一百六十人,一共四百八十个名额。十月十九号开营,为期大约十八天,跟着他们把七个任务一步步走完。
这门课学什么
现在做AI,大家都盯着模型有多强、算力有多大,却常常忽略了最重要的一件事——数据本身的质量。数据不好,模型再厉害也是白费力气。北大这个课题组专门做了一个叫 DataFlow 的工具,里面有两百来个现成的操作模块,装好就能用。你要做的就是把原始材料扔进去,按步骤跑一遍,出来的就是可以直接拿去训练或者检索的好数据。
具体的七个任务是这样的:
第一件事(两天):把环境和概念弄清楚。什么是AI-Ready Data?什么是数据处理流水线?装好DataFlow,跑通第一个例子。
第二件事(三天):从PDF文件里抽内容,自动生成问题和答案。以后你有一堆论文、报告,就可以批量做成问答对。
第三件事(三天):不光要文字,还要图文混合的多模态数据。比如数学题里的图形、公式,都能一起处理。
第四件事(三天):做RAG(检索增强生成)和Text2SQL的数据合成。想让AI学会查数据库、回答基于文档的问题,这一步少不了。
第五件事(三天):怎么筛选高质量的训练数据。预训练要过滤掉垃圾,微调要合成有用的样本。
第六件事(两天):用DataFlow自带的评测流水线,看看你处理出来的数据到底好不好。
第七件事(两天):自己动手搭一条完整的处理流水线,用网页界面操作,把前面学的串起来。
整个学下来,你不但会用DataFlow,还会懂得什么样的数据才是AI真正需要的。
课程的资料
这门课的所有内容都是开放的,你可以先去看看:
官方仓库(GitHub):https://github.com/OpenDCAI/DataFlow 图文教程(飞书):https://wcny4qa9krto.feishu.cn/wiki/I9tbw2qnBi0lEakmmAGclTysnFd 视频教程(B站):https://space.bilibili.com/3546929239689711
有兴趣的话,点开看看,心里就有数了。
谁来领学
领学的三位——陈彦凯、魏杰、刘伟——他们对DataFlow已经很熟了,每人带一个群,从头到尾陪着大家。你有什么不懂的,在群里问,他们会在。
三个群是分开的,你进哪一个都行,内容是一样的。只是每个群的名额有限,满了就不收了。
怎么进群
下面是三个学习群的二维码,你扫其中一个进去就行。进群之后看公告,里面有详细的学习安排、打卡方式和答疑时间。
学习群一(陈彦凯带队)
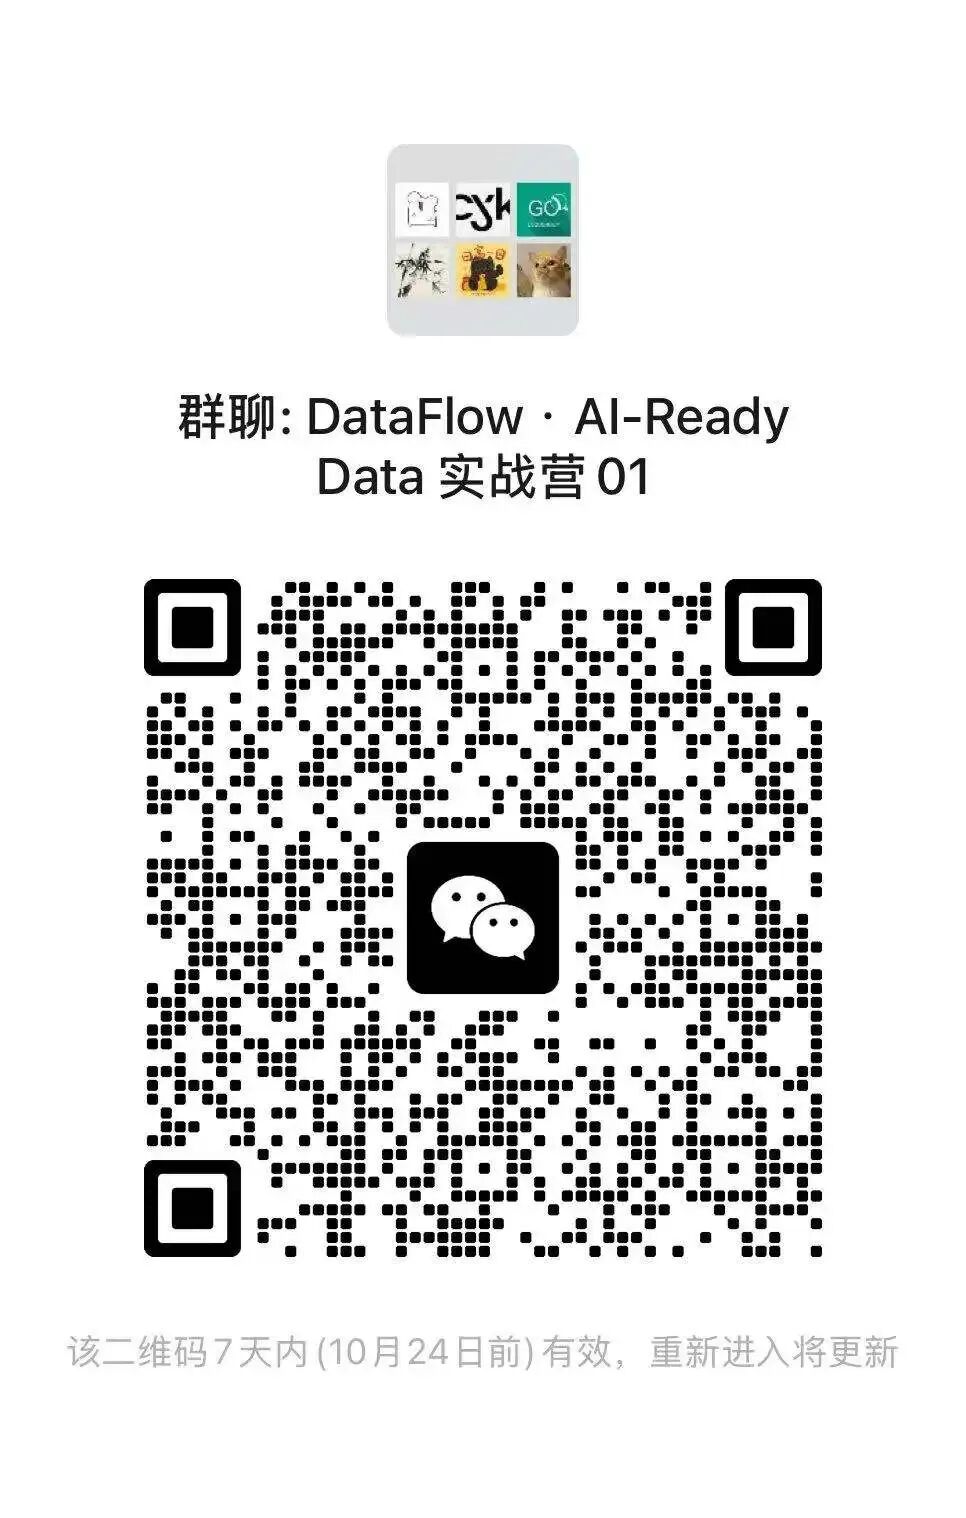
学习群二(刘伟带队)
学习群三(魏杰带队)
最后说两句
我是老马,Datawhale 领学小组的成员。这次还是帮北大课题组这边辅助招募,顺便在群里照应一下大家报名的事。你要是对数据处理感兴趣,或者正在做RAG、做模型训练、做知识库,这门课正好对口。
学东西不怕慢,就怕不动手。十八天,跟着三位领学人,把DataFlow跑熟,以后处理数据就有了趁手的家伙。比起自己瞎摸索,有人带着走总是省力些。
十月十九号开营,三个群一共四百八十个名额,先到先得。挑一个群进去,咱们一块儿把数据这件事做扎实。
💬 领学邀请
欢迎大家将任何你希望社区组队学习的优质资料或主题 推荐给我(老马)。我可以协助招募领学员,或者支持你 成为领学员,带领大家一起学习!
让我们这个学习共同体,能持续生长出更多有价值的深度探索。