ARTICLE · 1247313
不让模型长篇回答,Turion想直接从文档里抽出字段
把文档字段抽出来,少走逐词生成的路
从一份发票里找出编号、金额和联系人,看似只是几个字段。让聊天模型来做,通常还要生成一段JSON,再检查格式、核对数字。Turion Extract alpha选了另一条路:读完文档,直接给每个字段一个有类型的结果。
北京时间10月25日凌晨,Turion AI在Hugging Face上传了这个早期版本的适配器、抽取头和推理代码。它以Gemma 4 12B为基础,输入文本文档与字段定义,通过一次前向计算完成抽取,不走逐词生成答案的路径。
先指出原文在哪里,再组装答案
文本字段由起止位置定位;数字字段可以选择原文数字做有限的加减、计数;日期和时长也有对应处理。找不到内容时,可以返回null。结果通过普通程序组装,目标是让输出类型稳定,同时保留与原文的对应关系。
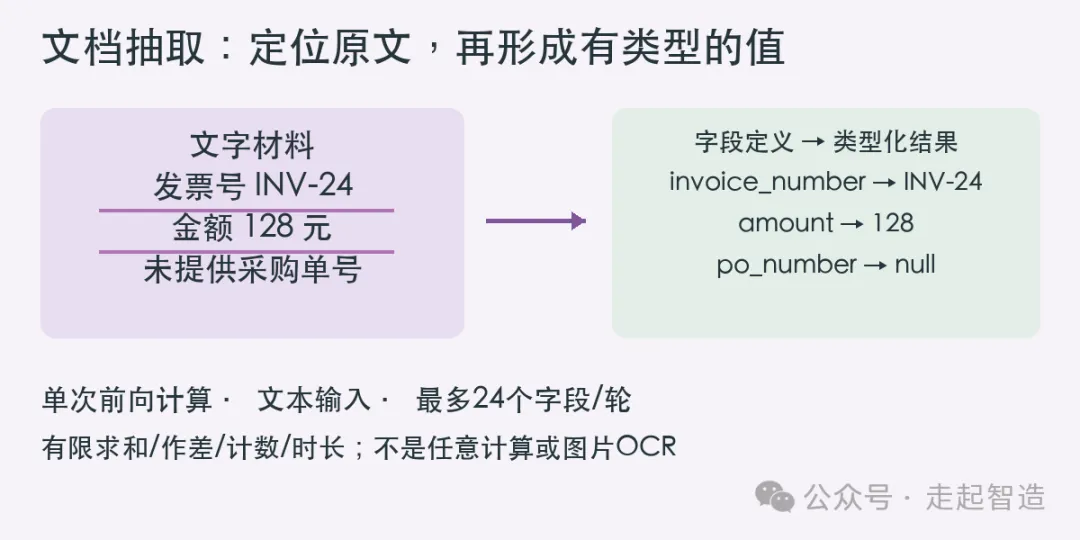
发票号与金额为编辑构造的解释例子,不是模型实际推理输出。
这并不意味着它能完成任意计算。作者列出的范围包括最多三个数字的求和或作差、计数和两个日期时间之间的时长;比例、乘法、平均值、百分比等还不支持。输入也限于文本,不能直接把发票照片当文档交给它。单次请求上限16,384个token,一轮最多处理24个字段。
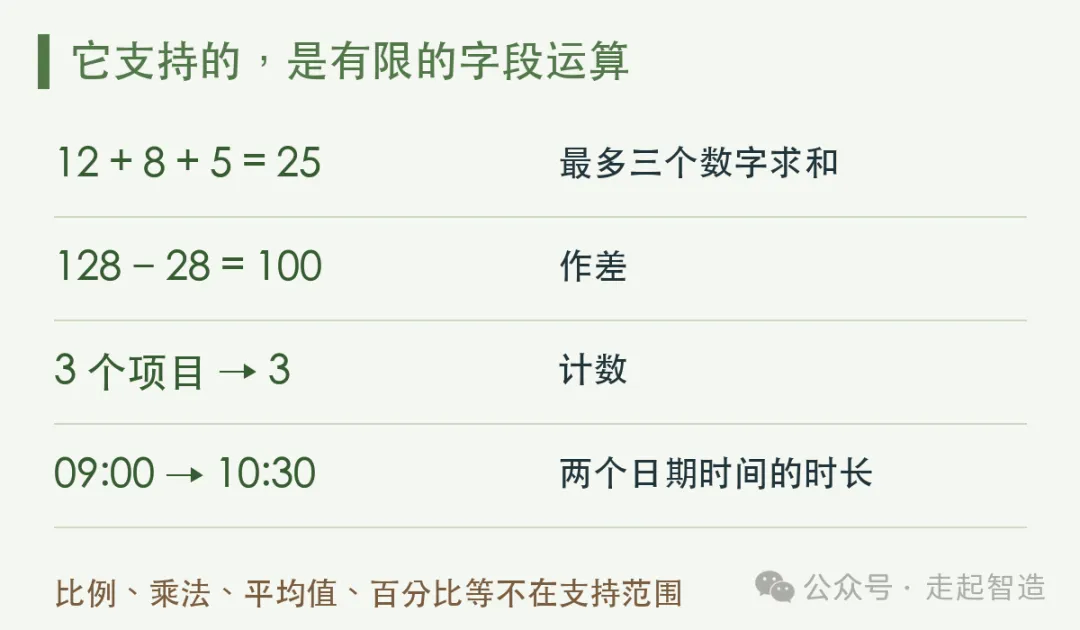
算式用于说明作者列出的操作范围,未用模型运行这些例子。
看成绩,必须连同重叠数据一起看
作者报告了SystemOne Extract Index 0.1上75.30的成绩,以及指定Blackwell工作站显卡、BF16环境下的请求时间。这些是发布方在指定环境的测试,不代表任意设备都能达到的速度。
模型卡还明确披露:1,997个评测请求里,有110个对应的文档或句子也出现在训练数据中。作者称剔除它们后总分仍为75.30,并计划在后续版本清理这类文档重叠。即便如此,该结果也不宜理解成已经证明了对陌生业务文档的普遍泛化能力。
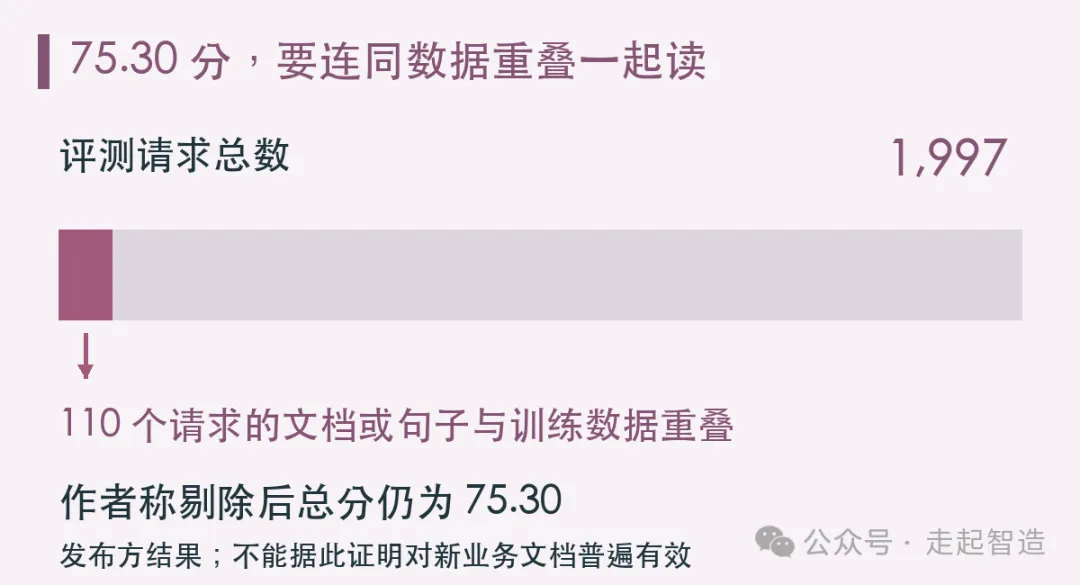
有重叠的是110个请求所对应的文档或句子;分数及剔除后的分数均由作者报告。
适配器标注Apache 2.0,仓库包含LICENSE与NOTICE;基础模型和训练数据也要分别按自身条件使用。当前更合适的定位,是一个值得研究的文档抽取方案:把“给我写出答案”,改成“指出值在哪里、怎样组成”。真正接业务,仍需用自己的文档检查漏取、误取和空值判断。
资料来源
Turion AI|模型卡、训练重叠披露与限制
Turion|适配器、抽取头、代码与许可文件
Google官方|Gemma4-12B基础模型