ARTICLE · 1247824
CLIP 源码精读:四亿张图喂出来的零样本视觉,五年后依然是地基
CLIP 源码精读:四亿张图喂出来的零样本视觉,五年后依然是地基2021 年 ICCV 把最佳论文授给了 OpenAI 的 CLIP。四年过去,它的引用量滚成天文数字,视觉语言模型换了几代,但真正把源码读透的人不多——多数人只用到 clip.load() 一行。这篇精读回到仓库本身:一个 4 亿图文对训出来的双塔模型,为什么到今天还是视觉语言任务的地基,它的接口和空间约定如何长成了行业的事实标准。 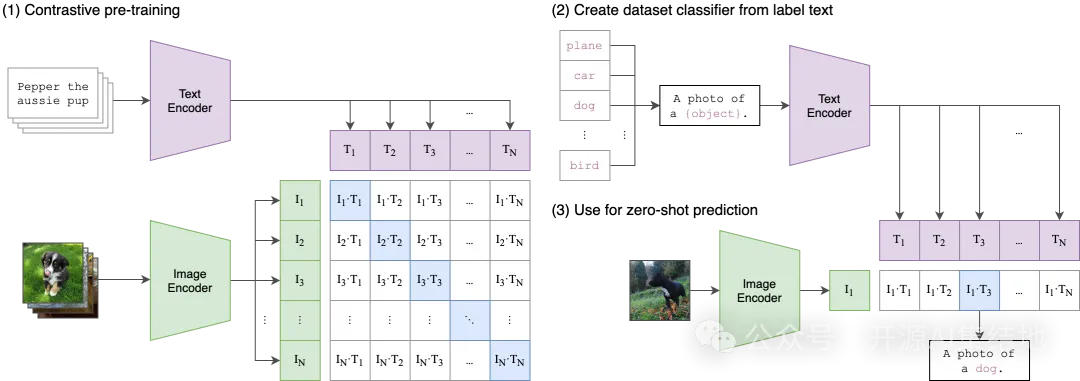
CLIP 的架构一句话讲完:图像编码器和文本编码器各一个,各自把输入映射到同一个嵌入空间,训练目标只有对比损失——4 亿图文对里,配对的图和文在空间里拉近,不配对的推远。就这么简单。但两个设计决定了它的历史地位,值得展开说透。 第一是零样本迁移。传统视觉是「一个数据集一个分类头」:ImageNet 训一个头,CIFAR 再训一个头,标注就是天花板。CLIP 换了个思路:把类别名写成句子——"a photo of a dog"——让文本编码器输出各类别的向量,图像向量与谁最像就分给谁。ImageNet 1.28 万张标注图一张不用,ResNet50 级别的精度被零样本直接追平。这个实验是它拿下最佳论文的核心:视觉分类第一次表现出和 GPT 系列一样的「任务无关」能力——模型没见过你的任务,却会做你的任务。 第二是自然语言监督的规模效应。4 亿图文对来自网络爬取,没有人工标注,靠的是语言本身对视觉概念的覆盖。论文在 27 个数据集上做迁移评测,除个别细粒度任务(物种识别、卫星图分类)外,零样本全面超越线性探针基线。今天的多模态大模型视觉端几乎清一色从 CLIP 预训练起步,这个工程选择就源自那组实验的结论。 代码本身出乎意料地小,核心就 clip 目录下几个文件,但有几处细节值得慢看。 clip.load() 的实现里藏着 JIT 的处理:权重发布时同时带 JIT 版和 eager 版,load 函数按 jit 参数选择,JIT 推理更快但不好改结构。追 encode_image 的调用链,ViT 版视觉端用 patch embedding 把 224×224 的图切成 49 个 patch 序列;文本端 tokenize 的 context_length 固定 77——超长文本直接截断,这个限制从 2021 年沿用至今,是很多下游应用偶尔翻车的根源:提示词一长,后半句等于没写。 还有个 API 设计的细节体现工程考量:model(image, text) 返回的两组 logits 是「相似度乘以 100」——logit_scale 是可学习参数,训练时温度自动调,推理时缩放让 softmax 的分布更锐。初学者常在这里犯迷糊:为什么相似度不是 0 到 1?因为这个输出本来就不是概率,softmax 之后才是。README 示例里那句 probs = logits_per_image.softmax(dim=-1) 就是在做这个转换。 tokenize 用字节对编码(BPE)处理词表,大小写折叠有专门的 lower_vocabulary 路径。README 的 CIFAR-100 示例把用法演示得最完整:"a photo of a {类别}" 的提示词模板对零样本精度影响不小,论文附录专门做了模板选择的消融——同一个数据集,好模板和差模板能差出好几个点。这也直接催生了后来「提示工程」这个细分手艺:怎么把类别名包进一句话,成了可以发论文的学问。 linear probe 接口是仓库里另一个值得跑一遍的示例:冻结 CLIP 编码器,只在其上训一个逻辑回归,CIFAR-100 上就能拿到不错的准确率。这个范式叫线性探针,价值在于隔离评估——特征好不好,看线性可分性就知道,不用碰下游网络。今天的视觉评测里线性探针仍是标准动作,出处就是这个仓库的这段示例代码。 权重家族从 ViT-B/32 到 ViT-L/14,最大版本在 ImageNet 上零样本 76.2%。社区基于这份代码训出更大的 OpenCLIP(到 ViT-G/14),HuggingFace 的实现直接对齐这套 API。一个开源仓库长成事实标准接口,在深度学习圈不多见——后来者即使不用它的权重,也得兼容它的调用方式。 训练侧的信息论文讲得更多一些,值得在这里补两句,因为它解释了为什么这个范式当时只有 OpenAI 做得出来。4 亿图文对的爬取和清洗本身就是工程壁垒——去重、过滤低质配对、平衡概念覆盖,每一步都是数据工程的硬活。训练用了 592 张 GPU 按周计,2021 年这个算力规模只有少数几家出得起。对比损失在超大批量下的实现也有讲究——批内负样本越多,对比信号越强,这对分布式训练的通信模式提出了具体要求。这些细节不在仓库里(仓库只放推理代码),但读懂它们才能理解:CLIP 的简单是结果不是起点,把简单的思路做到 4 亿对数据的规模,本身就不简单。 CLIP 的局限今天看很清楚:对比目标只学到图文对齐,不理解空间关系和组合推理——"A 在 B 左边""三个红色立方体"这类问题它答不好;检索式零样本在细粒度任务上仍逊于有监督训练。后续工作从 BLIP 的生成式预训练到今年的多模态大模型原生视觉编码器,都在补这些短板。 但地基的位置没变。想知道一个视觉概念模型见没见过,最快的办法还是拿 CLIP 编码算相似度;要给新任务冷启动视觉编码器,CLIP 预训练仍是默认选项;数据集构建时用 CLIP 过滤噪声图文对,是常识级操作。读它的源码不为追新——四年前的代码没有新东西可追——为的是理解这套接口、上下文长度、嵌入空间约定从哪来。整个领域的下游都在它之上生长,知道地基的纹理,盖楼时才知道哪里能承重。 给一个直观的动手验证:装好仓库后,拿一张自家照片跑 README 的零样本示例,把类别列表换成任意概念的中文描述(比如「一只猫」「一辆车」「一份早餐」),看概率分布——三行代码就能体会「任务无关分类」是什么手感。做过这一步,再看今天多模态大模型里视觉编码器的位置,很多设计选择就有了参照系:原来那些模型不是凭空长出来的,是站在这个 2021 年的仓库上,一层层加出来的。经典的价值就在这里——它不追着你跑,但你要往深处走,总会在半路遇见它。