ARTICLE · 1271419
V4L2 源码深度解析(十三):一块图像内存,怎样在多个设备之间共享?
前面已经分别读过 MMAP 和 USERPTR。前者让 VB2 建立存储,再把它映射给应用;后者把应用准备好的存储关联到 VB2 的缓冲区槽位。现在再加一个条件:采集端写完图像以后,编码器、图像处理器或者显示设备还要继续使用它。
最直接的办法,是为下一个设备再准备一块内存,把整帧复制过去。但下一设备真正需要的是这帧数据,并不一定需要它的一份副本。只要它能够访问原来的存储,格式布局也能对应,两个设备就有机会沿用同一块内存。
DMA-BUF 解决的正是这段连接。应用传递一个 fd,导入侧从中取得共享对象,再为自己的访问方式建立关联。这里没有“fd 里面装着图像”这回事,也不是把采集端的 DMA 地址原样送给编码器。
本篇从一块已经建立的缓冲区出发,先看它怎样导出,再看另一个队列怎样导入,最后补齐设备交接、CPU 访问和引用释放。正文中的 VB2、VIMC 和内存后端,以所分析的函数体为准;采用固定 bufs[]、prepared、synced 这套实现。DMA-BUF 公共对象与接口契约补充对照 Linux v6.1,不以此推定整个驱动实现的版本。主线不使用 Media Request,不展开厂商扩展的偏移约定。
1. 先把“共享一帧”说具体
1.1 下一设备需要的不是一次新的内存分配
仍用 640 × 480、RGB24、行尾没有填充的例子。一帧需要:
640 × 480 × 3 = 921600 字节
假设设备 A 负责采集,设备 B 能够接收同样布局的数据。这里的 B 是满足这一前提的处理设备,不是在假定任意编码器都支持 RGB24。
不共享时,A 把图像写入存储 S,程序或另一个搬运单元再把 S 复制到 T,B 从 T 读取。共享时,可以让 A 写 S,完成后让 B 直接读 S。省掉的是为了连接 A 和 B 而建立的那份整帧副本;A 写入和 B 读取仍然发生,内存带宽也不会变成零。
按每秒 30 帧计算,只算这一次额外复制的有效数据,读取和写入合计为 921600 × 30 × 2 = 55296000 字节每秒。这个数没有计算缓存、总线、对齐或其他处理,不能当成平台的实际带宽测量。
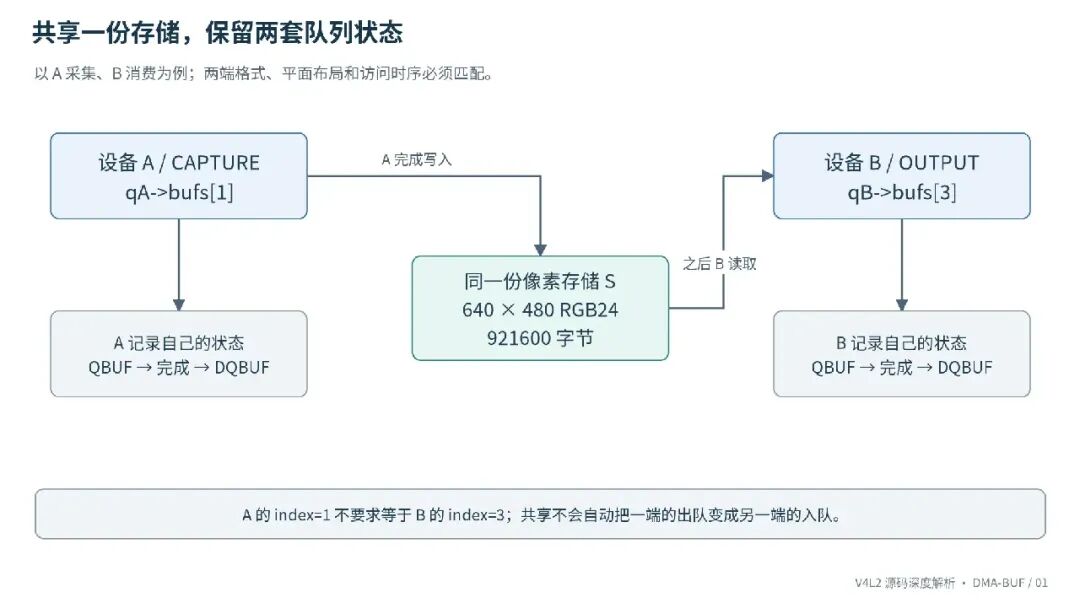
图 1:A 的索引 1 和 B 的索引 3 可以关联同一份存储。索引属于各自队列,图中没有第二份整帧像素。
1.2 两个队列共享存储,不共享内部状态
A 的 q->bufs[1] 和 B 的 q->bufs[3] 是两个不同的管理对象。它们有各自的状态、排队关系和完成结果,只是底层关联到了同一份像素存储。
因此,A 完成一次 DQBUF,不会自动给 B 执行 QBUF;B 完成一次 DQBUF,也不会自动把 A 的缓冲区重新排队。应用需要记录“B 的哪个槽位对应 A 的哪一块”,并安排两端交接。
即使 fd、地址和长度都正确,B 仍然可能把 RGB24 当成 NV12,或者按错误的行跨度读取。共享内存只解决字节存在哪里,不会替两端协商图像格式。 宽高、像素格式、行跨度、平面数量、有效区间和硬件约束,都必须另行一致。
1.3 导出者不一定是生产者
“生产者”表示本轮谁写数据,“消费者”表示谁使用结果。“导出者”则表示谁提供 DMA-BUF 对象和存储管理操作。
本篇首先让 A 用 MMAP 建立存储并导出,因此 A 同时是存储提供方和图像生产方。但也可以由独立分配器先导出一组 DMA-BUF,A、B 都作为导入方使用:A 写入,B 读取。改变的是存储来源,不是生产者与消费者的先后关系。
这些角色是针对一份共享对象而言的。同一个驱动可以既支持导出自己分配的存储,又支持导入其他来源的存储;不需要永久选定一个角色。
2. fd 怎样指向同一块内存
2.1 fd 是进程中的引用入口
DMA-BUF fd 与视频节点 fd 用途不同。前者关联共享存储对象;后者关联采集或处理设备,接受 V4L2 的命令。
以公共 DMA-BUF 实现为对照,导出后可以建立这样的查找关系:
进程中的 DMA-BUF fd
    → struct file
    → struct dma_buf
    → 导出者的 priv 和 ops
    → 由导出者管理的底层存储
dma_buf_get(fd) 会取得并检查文件引用,再返回对应对象。它不是按 fd 的数值算出一段物理内存。传入普通文件或无效 fd,不能因此变出一个可用的 DMA-BUF。
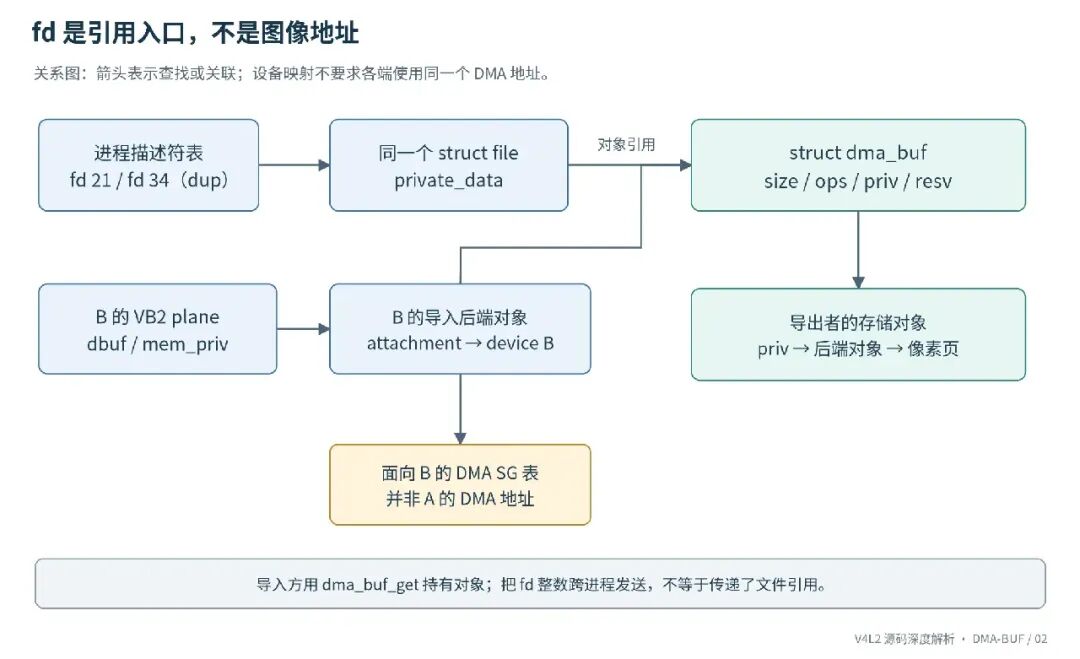
图 2:两个 fd 可以引用同一个文件对象;导入方另外持有对象引用。图中的关联箭头不是数据复制。
2.2 为什么把同一个数字发给另一进程还不够
fd 的整数只在相应进程的描述符表中有意义。进程甲的 21 与进程乙的 21,可能指向完全不同的文件。跨进程分享时需要真正传递文件引用,例如通过 Unix 域套接字的 SCM_RIGHTS,或者使用已经建立的描述符继承关系;只发送整数没有这种效果。
复制描述符也不会复制整帧。dup() 等产生的别名仍可指向同一个 DMA-BUF 对象。相反,一个已关闭的数字被重新使用以后,它可能指向另一份对象。后面会看到,VB2 正是比较对象指针,而不是只比较整数。
2.3 先认识三个内核对象,不急着背成员表
struct dma_buf 表示共享对象,提供大小、文件、导出操作和私有数据等关联。对于本文的 VB2 导出路径,priv 指向内存后端对象,不是直接指向一个 v4l2_buffer。
struct dma_buf_attachment 表示某个设备与这个共享对象的附着关系。导入侧指定自己的 struct device;导出者可以为这次附着保存独立的信息。附着还没有等同于得到最终硬件地址。
struct sg_table 可以用来表达映射结果。DMA 导入方拿到的是为自身设备建立的地址段;一个设备的结果不能无条件拿到另一个设备使用。CPU 的映射是另外一条路径,后面单独分析。
实现对照:公共 DMA-BUF 的 fd、get/put 与对象接口见文末 A、D;各后端如何把这些对象连接到 VB2,以下文实际代码为主。
3. 从 V4L2 导出:EXPBUF 操作的是哪个对象
3.1 先建立 MMAP 缓冲区,再导出其中一个平面
A 已经完成 REQBUFS,当前队列为 V4L2_MEMORY_MMAP。假定实际返回数量至少为 2,可以导出 buffer 1 的第 0 个平面:
structv4l2_exportbufferexp = {0};

exp.type = V4L2_BUF_TYPE_VIDEO_CAPTURE;
exp.index = 1;
exp.plane = 0;
exp.flags = O_RDWR | O_CLOEXEC;

if (ioctl(a_fd, VIDIOC_EXPBUF, &exp) < 0) {
/* 导出未成功,不能使用 exp.fd。 */
} else {
int dmafd = exp.fd;  /* 独立的 DMA-BUF fd,不是 a_fd。 */
/* 保存 dmafd,后续交给导入方;最终按持有关系关闭。 */
}
这段只展示接口字段,不是一份独立可运行程序。单平面接口的 plane 为 0;多平面接口要按实际平面数分别导出。index 是 A 队列中的索引,不是 DMA-BUF 对象编号。
这里不必为了导出而先对 A 执行 mmap。MMAP 是当前缓冲区的存储方式;应用是否真的需要 CPU 映射,是另一个选择。也不必先采到一帧才导出:可以在建立池后导出并长期保存 fd,每轮使用再通过队列交接确定数据有效时刻。
3.2 从操作表进入核心
VIMC 提供 .vidioc_expbuf = vb2_ioctl_expbuf,后续路径为:
VIDIOC_EXPBUF
    → 标准 ioctl 处理
    → vidioc_expbuf = vb2_ioctl_expbuf
    → vb2_expbuf
    → vb2_core_expbuf
        ├─ q->mem_ops->get_dmabuf:建立共享对象
        └─ dma_buf_fd:安装文件描述符
这是先调用后端、取得返回对象,再由核心安装 fd;不是后端的 get_dmabuf() 直接调用 dma_buf_fd()。
intvb2_ioctl_expbuf(struct file *file, void *priv, struct v4l2_exportbuffer *p)
{
structvideo_device *vdev = video_devdata(file);

if (vb2_queue_is_busy(vdev->queue, file))
return -EBUSY;
return vb2_expbuf(vdev->queue, p);
}
包装层先做队列归属检查。导出方使用的是 A 的 file->private_data,不是未来 B 的上下文;成功导入之后,B 仍有自己独立的队列 owner。
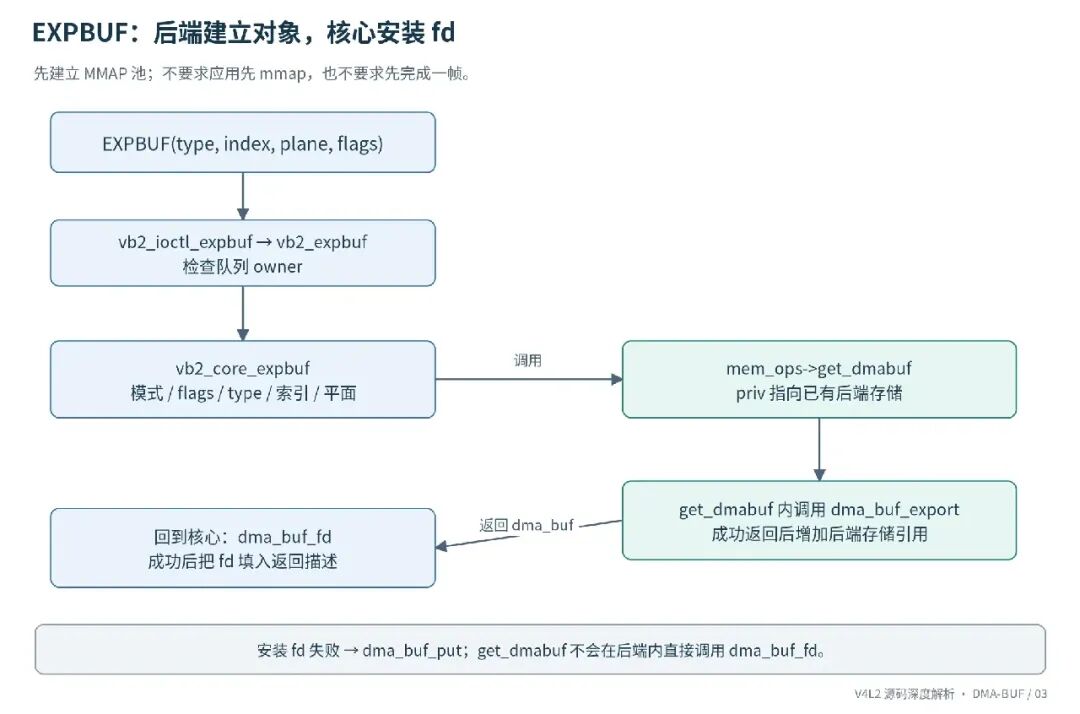
图 3:后端返回共享对象,核心再把它装进进程描述符表;额外建立的是对象与引用,不是图像副本。
3.3 核心检查与两个失败出口
vb2_core_expbuf() 依次检查 MMAP 模式、后端 get_dmabuf、flags、队列类型、索引、平面和 fileio 占用。模式不对、对象不存在或能力不支持时,不会继续导出。
flags 只接受访问模式及 O_CLOEXEC 相关位。访问模式交给共享文件,O_CLOEXEC 控制描述符在 exec 时的处理;它们都不表示设备 DMA 的方向。DMA 方向要由导入队列和实际设备用途确定。
核心选中平面后的关键部分是:
    dbuf = call_ptr_memop(get_dmabuf,
                  vb,
                  vb_plane->mem_priv,
                  flags & O_ACCMODE);
if (IS_ERR_OR_NULL(dbuf)) {
        dprintk(q, 1, "failed to export buffer %d, plane %d\n",
            index, plane);
return -EINVAL;
    }

    ret = dma_buf_fd(dbuf, flags & ~O_ACCMODE);
if (ret < 0) {
        dprintk(q, 3, "buffer %d, plane %d failed to export (%d)\n",
            index, plane, ret);
        dma_buf_put(dbuf);
return ret;
    }

    dprintk(q, 3, "buffer %d, plane %d exported as %d descriptor\n",
        index, plane, ret);
    *fd = ret;
后端返回空指针或错误指针时,这个核心入口统一返回 -EINVAL,不保证原始分配错误一路透传。对象已建立、但安装 fd 失败时,则调用 dma_buf_put() 归还刚取得的对象引用。
安装成功以后,文件引用由安装好的 fd 承接;不能再按“失败回滚”把同一份引用无条件 put 掉。实际返回到应用还要经过 ioctl 结果回写,所以描述结构在调用期间必须持续有效。
实现对照:vb2_ioctl_expbuf()、vb2_expbuf()、vb2_core_expbuf();EXPBUF 的接口范围见文末 B。
4. 导出者怎样把已有像素存储包装起来
4.1 沿 vmalloc 后端看一次真正的导出
前文使用的 vmalloc 分配器在平面对象里保存 vaddr、大小和 refcount。导出函数没有再申请一块 sizeimage 大小的像素内存:
static struct dma_buf *vb2_vmalloc_get_dmabuf(struct vb2_buffer *vb,
void *buf_priv,
unsignedlong flags)
{
structvb2_vmalloc_buf *buf = buf_priv;
structdma_buf *dbuf;
    DEFINE_DMA_BUF_EXPORT_INFO(exp_info);

    exp_info.ops = &vb2_vmalloc_dmabuf_ops;
    exp_info.size = buf->size;
    exp_info.flags = flags;
    exp_info.priv = buf;

if (WARN_ON(!buf->vaddr))
returnNULL;

    dbuf = dma_buf_export(&exp_info);
if (IS_ERR(dbuf))
returnNULL;

/* dmabuf keeps reference to vb2 buffer */
    refcount_inc(&buf->refcount);

return dbuf;
}
exp_info.priv = buf 是关键连接。共享对象通过这个私有指针回到原来的后端对象,后端再找到已有的像素页。
exp_info.size 使用后端记录的存储大小。在本实现的 MMAP 分配路径中,这通常是传给后端的页对齐大小,不能无条件当作一帧有效数据量。读取图像仍要遵守格式和完成结果的 bytesused/data_offset。
4.2 这里增加的是哪一份引用
导出成功后的 refcount_inc(&buf->refcount),增加的是 vmalloc 后端存储的引用。并不是给 A 的 vb2_queue 增加一次打开计数,也不是把 A 的整个 vb2_buffer 生命周期复制给 B。
共享对象最终释放时,导出者的 release 回调调用 vb2_vmalloc_put(dbuf->priv),归还这份存储引用。A 解除自己的池之后,若共享对象或其他映射仍持有存储,像素页仍可能继续存在。
这套关系解释了导出的意义:把存储的寿命从单个队列的管理对象中分离出来,让其他使用方能够有明确的持有凭据。 至于它们何时可以读写,还要依靠后面的交接和同步规则。
4.3 重复 EXPBUF 与 dup 并不一样
本文三个通用后端的 get_dmabuf() 都会调用 dma_buf_export() 建立一个新共享对象,没有在这个入口缓存“上次导出的那个 dma_buf”。因此,对同一平面重复 EXPBUF,可能得到不同的 DMA-BUF 对象,但它们的 priv 又关联同一份后端存储。
dup() 则复制既有文件引用,仍指向同一个共享对象。这一区别会影响导入侧的复用判断;也不能把多个独立共享对象的同步信息自然视为同一套信息。
通常的池式视频流程应在建立缓冲区后,每平面导出一次并保存 fd,而不是每帧重新导出。需要描述符别名时,用真正的文件引用复制方式,并清楚记录由谁关闭。
实现对照:vb2_vmalloc_get_dmabuf()、vb2_vmalloc_dmabuf_ops_release()、vb2_dc_get_dmabuf()、vb2_dma_sg_get_dmabuf()。
5. 导入侧先有槽位,再接入外部存储
5.1 REQBUFS(DMABUF) 仍然需要执行
B 准备使用已有的共享内存时,先选择 V4L2_MEMORY_DMABUF 并建立自己的缓冲区槽位:
structv4l2_requestbuffersreq = {0};

req.type = b_type;
req.memory = V4L2_MEMORY_DMABUF;
req.count = 4;

if (ioctl(b_fd, VIDIOC_REQBUFS, &req) < 0) {
/* 本队列可能不支持导入,或当前状态不允许建立槽位。 */
}
这一步仍需要当前格式和 queue_setup(),以确定平面数和最低容量;核心建立 q->bufs[] 中的管理对象。它不会像 MMAP 分支那样在此统一调用 mem_ops->alloc() 分配像素。
只看到 V4L2_CAP_STREAMING 还不能断言支持导入。适配层会核对 VB2_DMABUF 以及 attach/map/unmap/detach 等所需操作;格式、后端和设备限制还会继续影响后面的准备结果。
5.2 把共享对象交给 B 的某个槽位
假设 B 是一个能消费相同 RGB24 布局的普通单平面 OUTPUT 队列,槽位 3 有效,A 已经完成并返回 buffer 1:
structv4l2_bufferb = {0};

b.type = V4L2_BUF_TYPE_VIDEO_OUTPUT;
b.memory = V4L2_MEMORY_DMABUF;
b.index = 3;
b.m.fd = dmafd_of_a_buffer_1;
b.length = shared_capacity;
b.bytesused = completed_payload;
b.field = negotiated_field;
b.timestamp = source_timestamp;

if (ioctl(b_fd, VIDIOC_QBUF, &b) < 0) {
/* 先确认失败阶段,不把槽位记成已经被 B 正常接收。 */
}
这里的变量必须来自真实的格式、容量和 A 的完成结果;不是可以复制后直接运行的固定参数。对 CAPTURE 导入方,提交的是可供写入的存储,不应照搬 OUTPUT 的有效载荷填写方法。
b.index = 3 选择 B 的管理对象,b.m.fd 选择共享存储。两者没有自动的数值对应。需要另建映射关系,例如 b_slot_to_a_index[3] = 1,并在成功提交后记录本轮用途。
5.3 同一份内容,必须满足两端布局
DMA-BUF 本身不是一个完整视频格式描述。即使大小足够,以下情况也可能使共享不能直接成立:RGB 与 YUV 不同、行跨度不同、NV12 与 NV12M 的接口平面组织不同、硬件要求额外对齐或压缩布局、目标设备无法访问相应地址范围。
真正的兼容条件应在流启动前确定。不要用“EXPBUF 成功”和“attach 成功”替代格式协商;前者建立共享入口,后者建立设备关联,都不会自动转换图像。
实现对照:vb2_verify_memory_type()、vb2_core_reqbufs()、vb2_queue_or_prepare_buf()、vb2_fill_vb2_v4l2_buffer();接口说明见文末 C。
6. 进入 __prepare_dmabuf:先取得对象,再检查长度
6.1 普通 QBUF 与提前准备在这里汇合
沿普通直接提交路径:
vb2_ioctl_qbuf
    → vb2_qbuf
        ├─ vb2_queue_or_prepare_buf:检查并暂存接口描述
        └─ vb2_core_qbuf
            → 尚未 prepared 时:__buf_prepare
                → DMABUF 分支:__prepare_dmabuf
PREPARE_BUF 通过对应入口也能走到这个准备函数,但准备成功不会直接把对象交给驱动。这里先讨论尚未准备的对象;已经 prepared 时,前面的路径会复用准备结果,不会重新解释一套任意更换的 fd 和布局。
6.2 候选描述与已经持有的关联要分开
函数先准备局部 planes[],通过 fill_vb2_buffer 取得本次描述。vb->planes[] 则保存此前已经建立的关联。
局部数组使源码可以比较“这次要求的 fd、容量”和“上一次实际取得的对象、容量”,而不先覆盖旧关联。它并没有复制共享内存中的像素,也不依赖对视频节点执行 QUERYBUF+mmap 才能导入。
for (plane = 0; plane < vb->num_planes; ++plane) {
structdma_buf *dbuf = dma_buf_get(planes[plane].m.fd);

if (IS_ERR_OR_NULL(dbuf)) {
            dprintk(q, 1, "invalid dmabuf fd for plane %d\n",
                plane);
            ret = -EINVAL;
goto err;
        }
dma_buf_get() 成功意味着取得一份必须配对归还的引用。原始查找失败可能有不同原因,但这里统一把无效对象情况转换成 -EINVAL。
6.3 容量至少有两个边界
如果本次长度为零,当前实现取 dbuf->size;随后检查长度是否至少达到这个槽位的 min_length。dma-contig、dma-sg 和 vmalloc 的 attach 辅助函数还会检查 dbuf->size 是否足以容纳本次长度。
因此,合理关系是:
槽位最低容量 ≤ 本次声明长度 ≤ 共享对象实际大小
这只是存储容量条件,不包含全部图像布局和硬件约束。推荐应用明确保存容量并填写长度,而不是到处依赖零长度回退。V4L2 平面长度字段本身有固定宽度,超大共享对象还必须检查数值是否能由接口完整表示。
OUTPUT 的 bytesused/data_offset 要在容量内表达有效数据。不能把 DMA-BUF 的总大小当成每帧固定的有效载荷,更不能把对象 fd 当作数据地址相加。
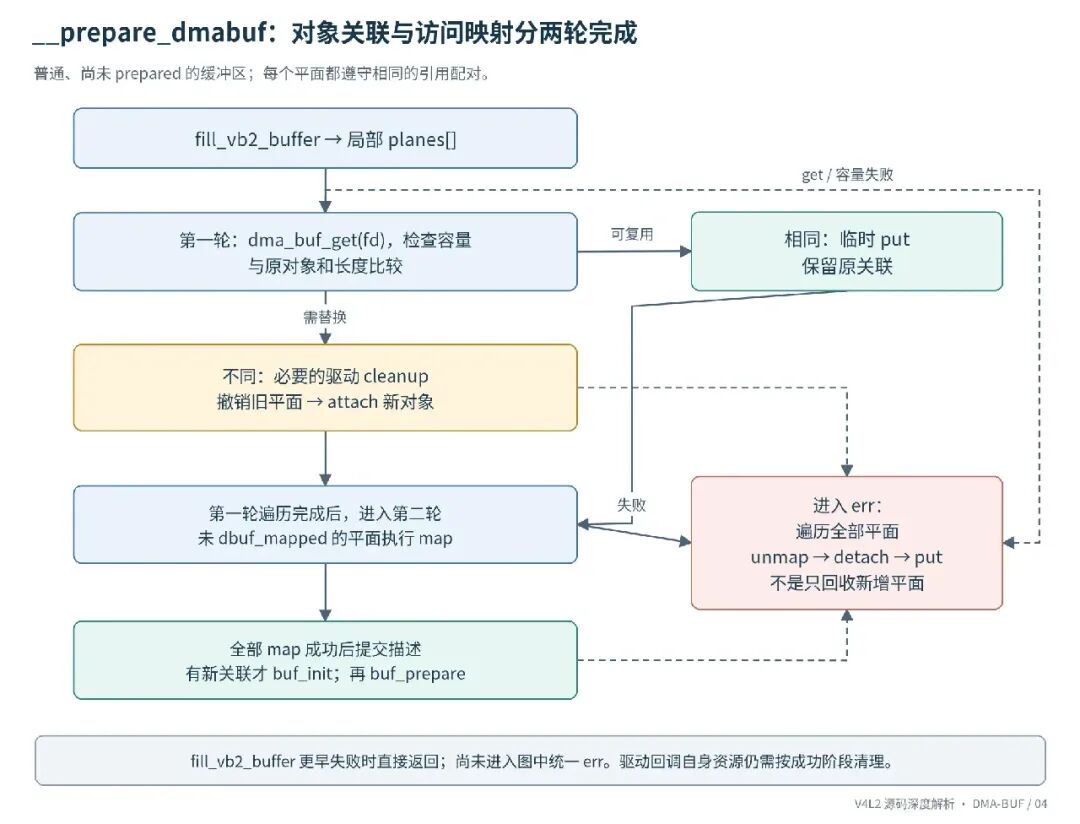
图 4:先完成所有平面的对象取得与附着,再完成各平面的 map。失败并非只清理当前平面。
7. 复用、替换和多平面回滚
7.1 相同的是对象和长度,不是 fd 数字
/* Skip the plane if already verified */
if (dbuf == vb->planes[plane].dbuf &&
            vb->planes[plane].length == planes[plane].length) {
            dma_buf_put(dbuf);
continue;
        }
如果两个不同 fd 实际指向同一个 dma_buf,且长度相同,就可以复用旧关联;本次临时 get 增加的引用立即 put,避免每次提交都多持有一次。
反过来,同一个整数已被关闭并重新使用,dma_buf_get() 可能得到不同对象,此时不会被仅凭数字相同蒙混过去。重复 EXPBUF 得到的独立共享对象,即使底层存储恰好相同,也不满足这里的对象相等条件。
复用只表示不重新 attach 已有平面;后续仍会检查映射标志,并继续本轮参数和驱动准备工作。普通完成出队后重新提交,与“同一个对象已经 prepared 又立即 QBUF”也不是完全相同的路径。
7.2 改变关联时,先结束旧的驱动附加状态
if (!reacquired) {
            reacquired = true;
            vb->copied_timestamp = 0;
            call_void_vb_qop(vb, buf_cleanup, vb);
        }

/* Release previously acquired memory if present */
        __vb2_plane_dmabuf_put(vb, &vb->planes[plane]);

/* Acquire each plane's memory */
        mem_priv = call_ptr_memop(attach_dmabuf,
                      vb,
                      q->alloc_devs[plane] ? : q->dev,
                      dbuf,
                      planes[plane].length);
if (IS_ERR(mem_priv)) {
            dprintk(q, 1, "failed to attach dmabuf\n");
            ret = PTR_ERR(mem_priv);
            dma_buf_put(dbuf);
goto err;
        }

        vb->planes[plane].dbuf = dbuf;
        vb->planes[plane].mem_priv = mem_priv;
reacquired 用来记录本次是否需要重新建立驱动附加初始化。若已有存储发生改变,第一次变化时先调用可选的 buf_cleanup,再撤销该平面的旧关联;它不是每改一个平面都无条件重复调用一次驱动 cleanup。
新的 attach 成功后,局部取得的 dbuf 引用记录到 vb->planes[plane].dbuf,后端返回的对象记录到 mem_priv。attach 失败时,这个尚未交给平面持有的临时引用先 put,再进入统一失败出口。
注意新关联不是在所有新资源成功后才一次性替换旧关联。旧平面可能已经被拆除,所以后续失败不会自动恢复上一次可用的整组存储。
7.3 第二轮才执行 map
for (plane = 0; plane < vb->num_planes; ++plane) {
if (vb->planes[plane].dbuf_mapped)
continue;

        ret = call_memop(vb, map_dmabuf, vb->planes[plane].mem_priv);
if (ret) {
            dprintk(q, 1, "failed to map dmabuf for plane %d\n",
                plane);
goto err;
        }
        vb->planes[plane].dbuf_mapped = 1;
    }
这里先跳过已经建立访问关系的平面;其余平面调用对应后端的 map_dmabuf,成功后设置 dbuf_mapped。
这个标志记录的是后端约定的“map 已完成”。对于两个 DMA 后端,它对应附着对象的 DMA 映射;对于 vmalloc 导入后端,它对应 CPU vmap。不能只看字段名称,就断言每一个 dbuf_mapped=1 都产生了硬件 IOVA。
所有平面成功后,函数再提交本次 length、fd 数值、bytesused 和 data_offset;发生新关联时调用可选 buf_init,每次真正执行到这里还会调用 buf_prepare。返回外层后,才继续 VB2 的内存 prepare 与 prepared 标志设置。
7.4 错误出口会拆掉全部已取得关联
函数尾部的关键关系是:
if (reacquired) {
/*
         * Call driver-specific initialization on the newly acquired buffer,
         * if provided.
         */
        ret = call_vb_qop(vb, buf_init, vb);
if (ret) {
            dprintk(q, 1, "buffer initialization failed\n");
goto err;
        }
    }

    ret = call_vb_qop(vb, buf_prepare, vb);
if (ret) {
        dprintk(q, 1, "buffer preparation failed\n");
        call_void_vb_qop(vb, buf_cleanup, vb);
goto err;
    }

return0;
err:
/* In case of errors, release planes that were already acquired */
    __vb2_buf_dmabuf_put(vb);

return ret;
}
这里的清理遍历该缓冲区的所有平面,不只是“这次新建的”平面。举例说,plane 0 本轮复用成功,plane 1 却传入无效 fd,进入 err 后,plane 0 的既有关联也会被放开。
但更早的 fill_vb2_buffer 失败是直接返回,尚未进入统一清理段。读错误路径时要看具体出口,不能把所有负返回概括成同一种回滚。
还要单独观察驱动回调:统一的 err 出口负责拆平面关联,并没有无条件调用 buf_cleanup。例如已有平面再次提交无效 fd,在查找对象时就失败,可能直接进入这个出口,而没有经过前面的“关联改变”清理分支。驱动附加资源的配对必须逐路径核对,不能把平面释放等同于驱动附加状态也已完整回收。
可选 buf_init 自身失败时,代码不会再为该对象自动调用 buf_cleanup;回调自身取得后又失败的附加资源,应在它自己的失败分支释放。buf_prepare 失败时,这份函数会先调用 buf_cleanup,再拆全部平面关联。
实现对照:__prepare_dmabuf()、__vb2_plane_dmabuf_put()、__vb2_buf_dmabuf_put()。这些条件同时也是本篇控制流检查的重点。
8. 跨驱动的关键一跳:导入方为什么会调用导出方
8.1 两张操作表站在不同一侧
B 的 q->mem_ops->attach_dmabuf、map_dmabuf,描述 B 怎样接入外部存储。A 导出的 dbuf->ops->attach、map_dma_buf,描述 A 怎样允许其他设备使用它管理的存储。
两张表之间由公共 DMA-BUF 层连接,不能把名字相似的回调当作同一个函数。
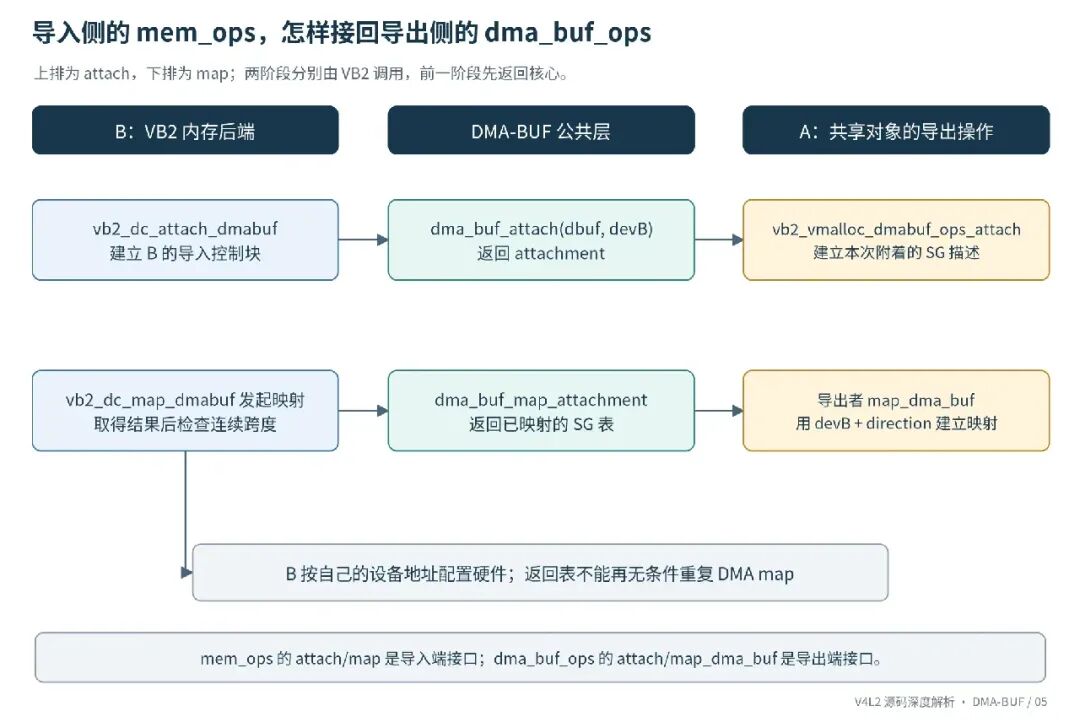
图 5:以 dma-contig 导入、vmalloc 导出为例。箭头表示调用,返回路径逐层带回附着对象或已映射 SG 表。
8.2 B 指定的是自己的设备
dma-contig 的 attach 辅助函数先检查大小和 dev,建立自己的 vb2_dc_buf,然后执行:
    buf->dev = dev;
    buf->vb = vb;

/* create attachment for the dmabuf with the user device */
    dba = dma_buf_attach(dbuf, buf->dev);
if (IS_ERR(dba)) {
        pr_err("failed to attach dmabuf\n");
        kfree(buf);
return dba;
    }

    buf->dma_dir = vb->vb2_queue->dma_dir;
    buf->size = size;
    buf->db_attach = dba;
dev 来自 q->alloc_devs[plane] 的可选覆盖或 q->dev,表示这次需要访问存储的设备。它不能随意沿用 A 的设备对象,否则 DMA API 建立的地址可能属于错误的访问域。
dma_buf_attach() 会把导出者的 attach 回调接进来。对 vmalloc 导出者,该回调沿 vaddr 找到各页,为这次附着建立 SG 表,再把私有信息保存到 dbuf_attach->priv。
8.3 三个 priv 不能混成一个
dbuf->priv | |
attachment->priv | |
B 的 vb->planes[p].mem_priv |
复制一张 SG 描述表,是复制“哪些页、各段多长”的元数据,不是复制页内图像。每个附着对象可以拥有自己的映射状态,避免 B 和 C 把同一张表中的 DMA 地址字段相互覆盖。
8.4 map 返回的是已经为 B 建立的地址
B 随后执行 dma_buf_map_attachment()。它会进入导出者的 map_dma_buf,在本例中就是 vb2_vmalloc_dmabuf_ops_map()。后者使用 attachment->dev 和本次方向调用 DMA API:
/* mapping to the client with new direction */
if (dma_map_sgtable(db_attach->dev, sgt, dma_dir, 0)) {
        pr_err("failed to map scatterlist\n");
        mutex_unlock(lock);
return ERR_PTR(-EIO);
    }

    attach->dma_dir = dma_dir;
成功返回的 SG 表已经包含面向 B 的 DMA 地址和长度。B 不应该再拿这张结果表无条件做一次 dma_map_sgtable();应当按映射契约使用结果,并以配对接口归还。
若第三个设备 C 也导入同一对象,它有自己的附着和地址表示。同一份像素可以在 B、C 的设备地址空间里使用不同数值,这不意味着多复制了一份图像。映射可能因 DMA mask、IOMMU 资源、段限制或导出者能力而失败,attach 成功不是后续 map 必然成功的保证。
实现对照:vb2_dc_attach_dmabuf()、vb2_vmalloc_dmabuf_ops_attach()、vb2_vmalloc_dmabuf_ops_map()。公共层调用契约见文末 A、D。
9. dma-contig 为什么还要检查连续跨度
9.1 SG 表有结果,不等于设备可以直接消费
dma-sg 导入后端保留映射后的 sg_table。驱动可以通过对应辅助接口取得表,并按硬件格式构造描述符;这不代表硬件自动理解 Linux 的 SG 结构。
dma-contig 面向的是需要连续 DMA 地址范围的使用方式。它取得表以后,还要检查从第一段开始的连续范围是否覆盖本次容量:
staticintvb2_dc_map_dmabuf(void *mem_priv)
{
structvb2_dc_buf *buf = mem_priv;
structsg_table *sgt;
unsignedlong contig_size;

if (WARN_ON(!buf->db_attach)) {
        pr_err("trying to pin a non attached buffer\n");
return -EINVAL;
    }

if (WARN_ON(buf->dma_sgt)) {
        pr_err("dmabuf buffer is already pinned\n");
return0;
    }

/* get the associated scatterlist for this buffer */
    sgt = dma_buf_map_attachment(buf->db_attach, buf->dma_dir);
if (IS_ERR(sgt)) {
        pr_err("Error getting dmabuf scatterlist\n");
return -EINVAL;
    }

/* checking if dmabuf is big enough to store contiguous chunk */
    contig_size = vb2_dc_get_contiguous_size(sgt);
if (contig_size < buf->size) {
        pr_err("contiguous chunk is too small %lu/%lu\n",
               contig_size, buf->size);
        dma_buf_unmap_attachment(buf->db_attach, sgt, buf->dma_dir);
return -EFAULT;
    }

    buf->dma_addr = sg_dma_address(sgt->sgl);
    buf->dma_sgt = sgt;
    buf->vaddr = NULL;

return0;
}
buf->size 是 B 这次导入所要求的长度。判断失败时先归还刚得到的映射,再报错,不能保留一个“只连续了前半帧”的基地址交给硬件。
9.2 这里连续的是设备地址,不是物理页
staticunsignedlongvb2_dc_get_contiguous_size(struct sg_table *sgt)
{
structscatterlist *s;
dma_addr_t expected = sg_dma_address(sgt->sgl);
unsignedint i;
unsignedlong size = 0;

    for_each_sgtable_dma_sg(sgt, s, i) {
if (sg_dma_address(s) != expected)
break;
        expected += sg_dma_len(s);
        size += sg_dma_len(s);
    }
return size;
}
它依次比较 sg_dma_address(),并累加 sg_dma_len()。不是按 sg_page() 的 PFN 是否相邻来判断,也不是简单要求 nents == 1。
例如 B 得到两段:第一段从 0x80000000 开始、长度 8192;第二段从 0x80002000 开始、长度 4096。虽然有两段描述,设备地址却衔接起来,共 12288 字节。请求 9000 字节时,连续容量足够。
如果第二段改从 0x90000000 开始,总容量仍为 12288,但第一段之后出现空洞,连续前缀只有 8192;同一个 9000 字节请求就不能通过。上述地址仅用于手算,不是平台实测值。
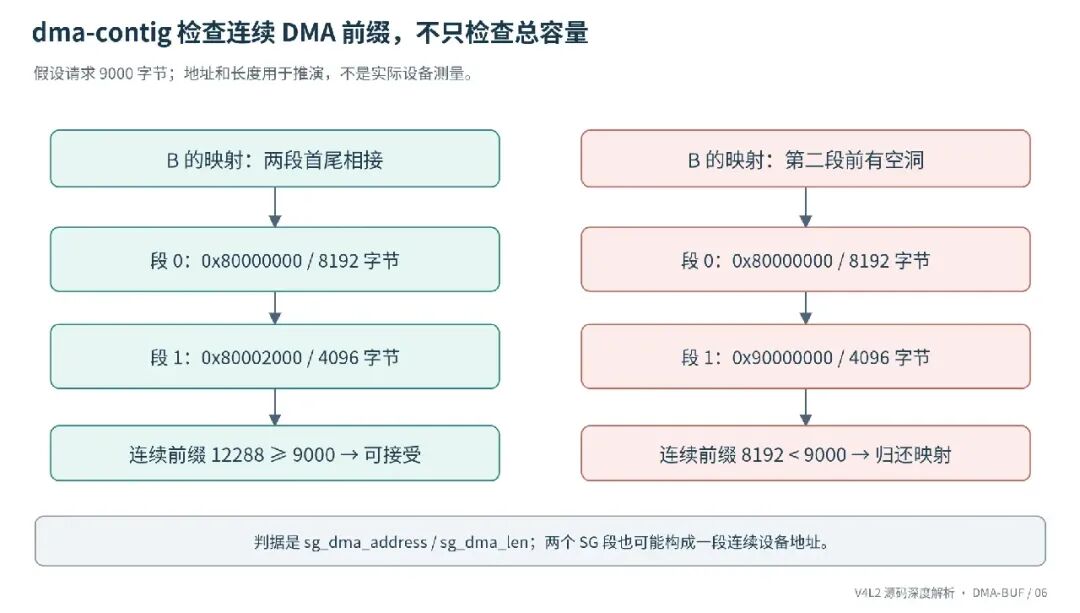
图 6:检查的是 B 的映射结果。物理分散的页可以在合适的 IOMMU 映射下形成连续设备地址,但映射并不保证每次都如此。
9.3 有了地址以后,还缺驱动自己的硬件动作
成功后,dma-contig 保存第一段的 DMA 地址与整张表。驱动取得地址后,仍须配置地址寄存器或描述符,并在完成时正确报告。DMA-BUF 和 VB2 不会仅凭一次 map 就启动设备。
缓存属性、方向和地址寿命也仍然有效。B 读取 A 产生的帧时通常按 DMA_TO_DEVICE 使用;B 自己作为采集写入方时通常是 DMA_FROM_DEVICE。队列若启用了双向约定,还需按实际配置解释,不能从“图像数据”四个字推断方向。
10. vmalloc 导入是另一条路:它需要 CPU 地址
10.1 attach_dmabuf 的名字不保证建立设备 attachment
vmalloc 导入辅助函数只建立自己的后端对象,记录共享对象、长度和方向:
staticvoid *vb2_vmalloc_attach_dmabuf(struct vb2_buffer *vb,
                       struct device *dev,
                       struct dma_buf *dbuf,
unsignedlong size)
{
structvb2_vmalloc_buf *buf;

if (dbuf->size < size)
return ERR_PTR(-EFAULT);

    buf = kzalloc(sizeof(*buf), GFP_KERNEL);
if (!buf)
return ERR_PTR(-ENOMEM);

    buf->dbuf = dbuf;
    buf->dma_dir = vb->vb2_queue->dma_dir;
    buf->size = size;

return buf;
}
这段函数没有调用 dma_buf_attach(),因此不会因为执行了这个 VB2 回调,就在公共 DMA-BUF 层建立一个设备附着对象。引用由 VB2 核心之前的 dma_buf_get() 持有,后端保存的 dbuf 指针使用这份生命周期。
它的 map 回调随后取得内核 CPU 映射:
staticintvb2_vmalloc_map_dmabuf(void *mem_priv)
{
structvb2_vmalloc_buf *buf = mem_priv;
structiosys_mapmap;
int ret;

    ret = dma_buf_vmap(buf->dbuf, &map);
if (ret)
return -EFAULT;
    buf->vaddr = map.vaddr;

return0;
}
dma_buf_vmap() 返回 CPU 可用的映射信息,不是设备 SG 映射。导出者没有 vmap 能力,或者建立映射失败时,这条导入路径也可能失败。
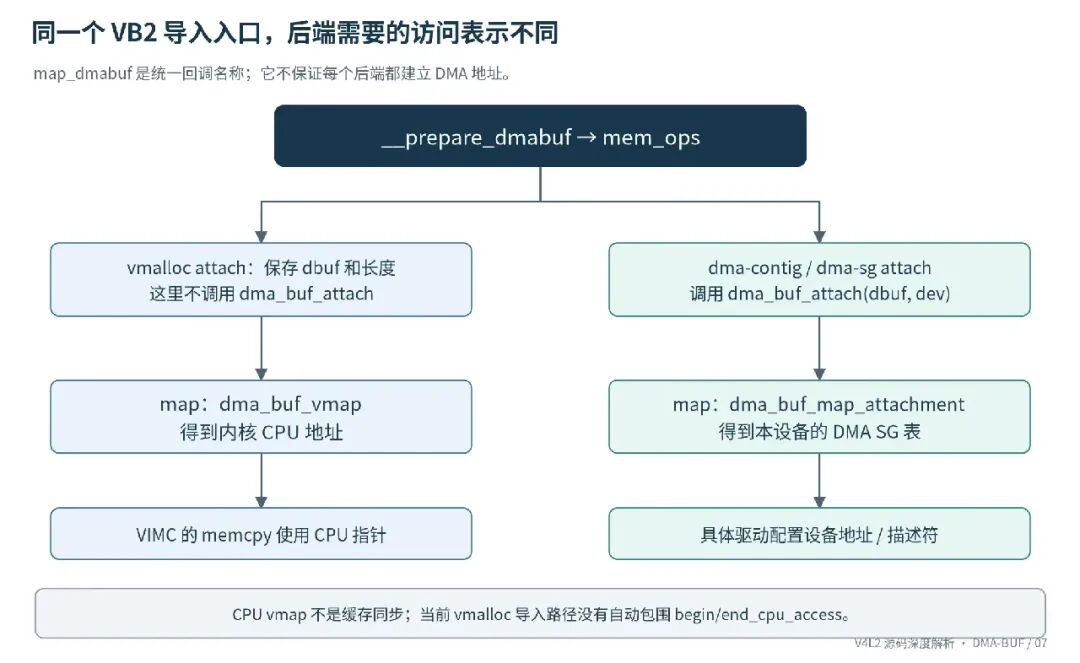
图 7:统一的是 VB2 准备入口,不是后端一定执行相同操作。vmap 不等于 map_attachment,也不自动完成 CPU 访问同步。
10.2 VIMC 为什么能使用这种导入
VIMC 最终通过 vb2_plane_vaddr() 取得 CPU 地址,再用 memcpy() 写入图像。使用 vmalloc 导入后端后,这个地址就可以来自共享对象的 vmap,而不必是 VIMC 自己分配的页。
这只说明 CPU 能访问共享存储,不意味着 VIMC 变成 DMA 驱动,更不意味着外部 DMA 设备与 VIMC 同时访问时已经自动同步。
当前 vmalloc 导入回调没有调用 dma_buf_begin_cpu_access() / dma_buf_end_cpu_access();取得 vmap 本身也不替代这两个访问边界。对真正跨 CPU/非一致性设备的链路,必须确认导出者、实际处理驱动与平台共同满足同步要求,不能把这个软件示例直接当作所有外部 DMA-BUF 的通用正确模板。
11. 导入成功以后,为什么 DQBUF 不拆映射
11.1 本轮结束与长期关联是两条时间线
DMA-BUF 导入准备相对昂贵。对象引用、附着、DMA 映射或 vmap,可以跨越多轮 QBUF/DQBUF 保留。本实现的普通 __vb2_dqbuf() 恢复状态和接口扩展,不调用 __vb2_plane_dmabuf_put()。
所以,成功 DQBUF 归还的是本轮使用安排,不一定已经 detach。STREAMOFF 取消准备与排队,也不能直接等同于销毁全部导入关联;池释放或真正改变平面关联时才走相应拆除路径。
下一轮提交相同对象和长度,可以复用这些长期关系。设备必须已经停止对本轮数据的访问,才能宣布完成;长期保留映射不构成“出队后继续偷偷读写”的许可。
11.2 DQBUF 返回的 fd 不是新取得的句柄
接口填回的 fd 数值通常与提交时一致,用于描述这次结果,并没有再次执行 EXPBUF 或为应用新建一份描述符引用。
若应用在成功提交后提前关闭原 fd,内核持有的导入引用可以继续维持对象存活;但随后 DQBUF 填回的整数不保证仍是一个有效句柄,它甚至可能已被复用。下一轮还需要 fd 查找时就会产生问题。
因此,普通循环最好在整个池使用期间保留导出的 fd,直到所有相关槽位解除关联,再关闭描述符。不要把 DQBUF 返回的数值当成一次全新的所有权赠送。
11.3 prepared 还会影响是否重新解释 fd
提前 PREPARE_BUF 成功后,prepared=1。紧接着 QBUF 时,框架可能直接复用既有准备,并不重新用任意更改后的参数切换对象。
需要换存储时,应先通过受支持的取消或完成路径回到可重新准备的状态,再提交新对象。把“同一槽位允许换 DMA-BUF”误读成“任何状态下改一个 fd 都会立即换绑”,会留下很难定位的对象与描述不一致。
实现对照:vb2_queue_or_prepare_buf()、__buf_prepare()、__prepare_dmabuf()、__vb2_dqbuf()、__vb2_queue_cancel();DQBUF 的 fd 约定见文末 C。
12. 两个设备怎样交接同一帧
12.1 A 出队以后,才把这轮结果提交给 B
假设 A 采集,B 消费图像,并且两端布局已经匹配。最容易核对的顺序是:
A 的 CAPTURE QBUF(index=1)
    → A 写入 S
    → A 的 CAPTURE DQBUF(index=1)
    → B 的 OUTPUT QBUF(index=3, fd=S)
    → B 读取 S
    → B 的 OUTPUT DQBUF(index=3)
    → A 的 CAPTURE 再次 QBUF(index=1)
这不是把同一个 v4l2_buffer 原样从 A 传到 B。B 的 type、index、容量与载荷字段应按 B 的接口填写;应用维护对应表,把 B 的完成结果关联回 A 的存储。
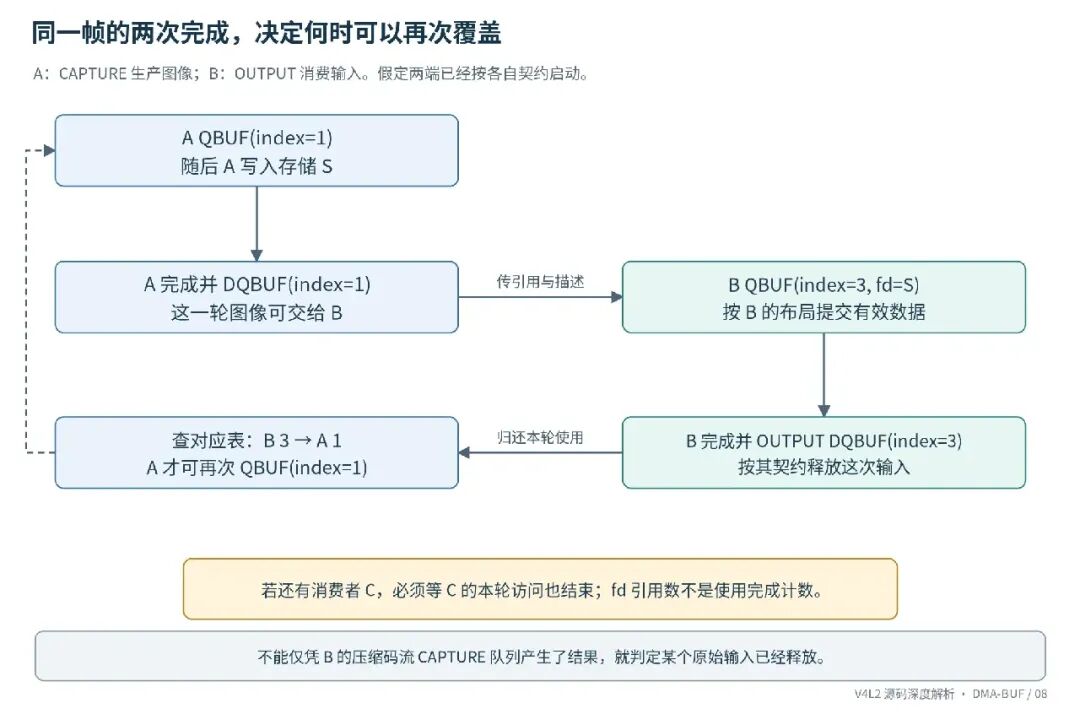
图 8:假定 B 的 OUTPUT DQBUF 按其驱动契约表示原始输入已经释放。B 的压缩输出队列属于另一组存储,不用它的结果代替输入释放证明。
编码器通常还有 CAPTURE 队列返回压缩码流。该队列的 buffer 索引、完成数量和原始输入并不必然一一对应。一个压缩结果到达,不等于某个指定原始帧可以立刻被采集端覆盖;要看输入队列的完成和对应驱动契约。
12.2 两个消费者时,要等最后一个实际使用者
若同一帧还交给显示设备 C,B 完成以后也不能马上重新 QBUF 给 A。应用需要记录 B、C 对本轮帧的使用,等两端都按协议结束后再允许覆盖。
这份“本轮使用计数”不是 DMA-BUF 文件引用计数。持有 fd 的程序可能根本没有开始访问;设备已经完成一帧,也可能继续保留 attachment 供下一轮复用。引用数保证对象存活,不能直接说明哪个硬件还在忙。
12.3 共享对象有 fence 容器,不等于本链路自动发布 fence
DMA-BUF 可以通过 reservation 对象和 fence 表达异步完成;显式同步也可以通过相应接口传递同步对象。但参与者需要真正建立、发布并等待这些完成关系。
本文沿到的普通 VB2 导出、导入和 vb2_buffer_done() 路径,没有替每一次视频处理自动建立一套覆盖所有设备的 fence 协议。A 的 done 唤醒本视频队列,不等于已经向所有 DMA-BUF 消费者发布了同样的完成信号。
因此,不能把视频节点上的 poll 与 DMA-BUF fd 上的 poll 混用:前者观察 V4L2/VB2 的就绪条件,后者观察共享对象里实际登记的 fence。若生产者根本没有发布相应 fence,DMA-BUF poll 的就绪不能证明这帧已拍完。完成机制的接口边界见文末 A。
13. 缓存同步:能够访问,不代表此刻看见的是新数据
13.1 先确认访问已结束,再处理 CPU 可见性
本篇有三件必须分别成立的事:对象仍存在;上一执行方已经结束;下一执行方能看见正确内容。
DMA-BUF 引用解决第一件。队列完成、明确的设备完成信号或正确接入的 fence 解决第二件。缓存维护和相应访问协议解决第三件。只完成其中一个,不能替代另外两个。
如果应用需要 CPU 读取导出的 DMA-BUF,可以在支持 mmap 的导出者上建立映射,再在每轮实际 CPU 访问外侧使用 DMA_BUF_IOCTL_SYNC:
通过视频队列或已正确接入的同步机制确认数据可以交给 CPU
    → DMA_BUF_IOCTL_SYNC(START | READ)
    → CPU 只读取有效区间
    → DMA_BUF_IOCTL_SYNC(END | READ)
    → 才按协议交给下一执行方
内核 CPU 访问对应 dma_buf_begin_cpu_access() / dma_buf_end_cpu_access()。公共层可能等待已经登记的隐式 fence,但它不知道驱动从未登记的异步工作。SYNC 也不是阻止其他线程或设备同时访问的通用互斥锁。
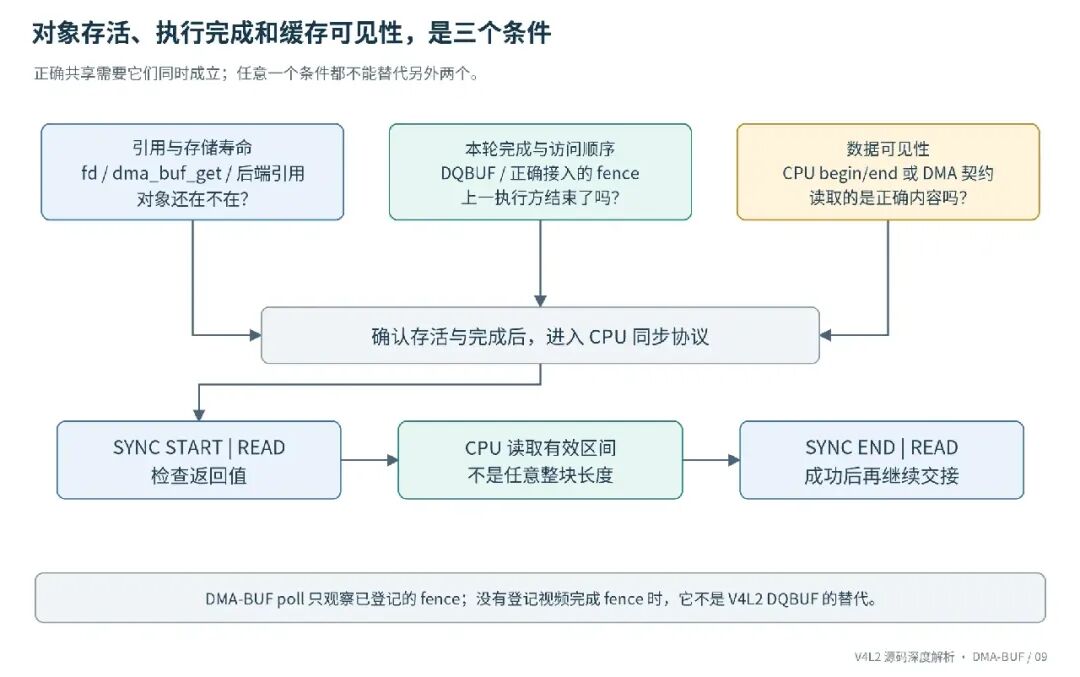
图 9:这里描述 CPU 访问共享映射的协议。DMA-BUF 的 CPU 访问标志,不是视频队列的 CAPTURE/OUTPUT 类型。
对于这些访问接口,应用必须检查返回错误;START 未成功就不能按已同步处理,END 失败也不能宣告访问已完整交回。可恢复的中断或重试条件要依接口约定处理,不能吞掉错误继续排队。
13.2 视频 mmap 偏移不能搬到 DMA-BUF mmap
视频节点 mmap 的 offset 用来在整个队列中选择平面;DMA-BUF fd 已经选中了一个共享对象。应用为整个导出平面建立 DMA-BUF 映射时,从对象起点的 offset 0 开始,并按导出者允许的大小和能力映射。
不要把视频 QUERYBUF 的 m.offset 再用作 DMA-BUF fd 的映射偏移。也不要认为 B 选择了 V4L2_MEMORY_DMABUF,就自动能够对 B 的视频节点执行原先的 MMAP 流程;CPU 访问应走共享对象支持的映射接口。
13.3 本实现为什么跳过部分 VB2 内存同步
核心初始化导入缓冲区时有一个明确分支:
if (q->memory == VB2_MEMORY_DMABUF) {
        vb->skip_cache_sync_on_finish = 1;
        vb->skip_cache_sync_on_prepare = 1;
return;
    }
两个 DMA 后端的 prepare/finish 会检查这两个标志,从而避免把导出者负责的工作无条件再做一遍。这是框架的责任划分,不是“所有共享存储都具有硬件缓存一致性”。
从当前代码继续往下看:vmalloc 导出操作表没有 CPU begin/end 回调;dma-contig 的这两个导出回调直接返回成功;dma-sg 则包含显式 DMA 同步。把 CPU 访问接口调用成功解释为“任意后端、任意配置、任意跨设备链路都已同步正确”,是不成立的。
尤其 dma-contig 同时还支持非一致性分配分支,不能用“它叫 contig”证明 CPU 同步可以为空。需要按实际分配属性和平台审计这些路径;示例不依赖 CPU 读写共享像素来掩盖这些边界。
13.4 SG 条目数需要按 API 契约核对
当前 dma-sg 导出者的 CPU 访问回调使用了下面这类调用:
dma_sync_sg_for_cpu(buf->dev, sgt->sgl, sgt->nents, buf->dma_dir);
这里的 sgt->nents 是映射后的条目数;DMA API 要求 dma_sync_sg_*() 的数量与建立映射时传入的原始条目数配对。若映射合并使 nents < orig_nents,这个实现写法存在参数配对问题,不能作为无条件正确的模板照搬。
适用的修订应使用匹配该 SG 表的原始数量,或者采用正确封装了这一语义的 dma_sync_sgtable_*(),并核对设备与方向。本文只指出源码与接口契约的差异,没有修改正在运行的内核,也没有据此声称已在某个平台重现图像错误。DMA API 的条目数约定见文末 E。
14. 释放时到底放开了什么
14.1 单个导入平面的配对顺序
staticvoid __vb2_plane_dmabuf_put(struct vb2_buffer *vb, struct vb2_plane *p)
{
if (!p->mem_priv)
return;

if (p->dbuf_mapped)
        call_void_memop(vb, unmap_dmabuf, p->mem_priv);

    call_void_memop(vb, detach_dmabuf, p->mem_priv);
    dma_buf_put(p->dbuf);
    p->mem_priv = NULL;
    p->dbuf = NULL;
    p->dbuf_mapped = 0;
    p->bytesused = 0;
    p->length = 0;
    p->m.fd = 0;
    p->data_offset = 0;
}
先撤销后端 map,再解除后端附着,最后 put 共享对象引用。这个次序保证前面的清理仍然可以使用有效的共享对象。
对于 dma-contig/dma-sg,它对应 DMA unmap_attachment、detach 和对象 put;对于 vmalloc,它对应 vunmap、释放导入控制块和对象 put。不能机械地把每种后端都画成一次物理页解除映射。
14.2 unmap 回调为空,不等于没有清理约定
当前三个导出者都在每次 attachment 的私有状态里保存了映射结果和方向。相同方向的下一次 map 可以返回已有表;其 unmap_dma_buf 回调本身为空,真正的 DMA 解除发生在方向改变或 detach 清理缓存时。
所以,导入方仍然必须调用配对的 dma_buf_unmap_attachment(),不能因为看到某个导出者的当前回调为空,就在自己代码里删掉 unmap。它完成的是协议层归还;导出者是否保留底层映射,是另一层实现决定。
这段缓存行为以本文源码为限,不能直接推广成所有版本 DMA-BUF 导出者的推荐写法;移植到不同版本时还要检查公共层的缓存和锁契约。
14.3 两层引用用一个例子算清楚
只看 vmalloc 后端的一块平面,假设没有 CPU 映射、没有额外 dup,也没有第三个导入者:
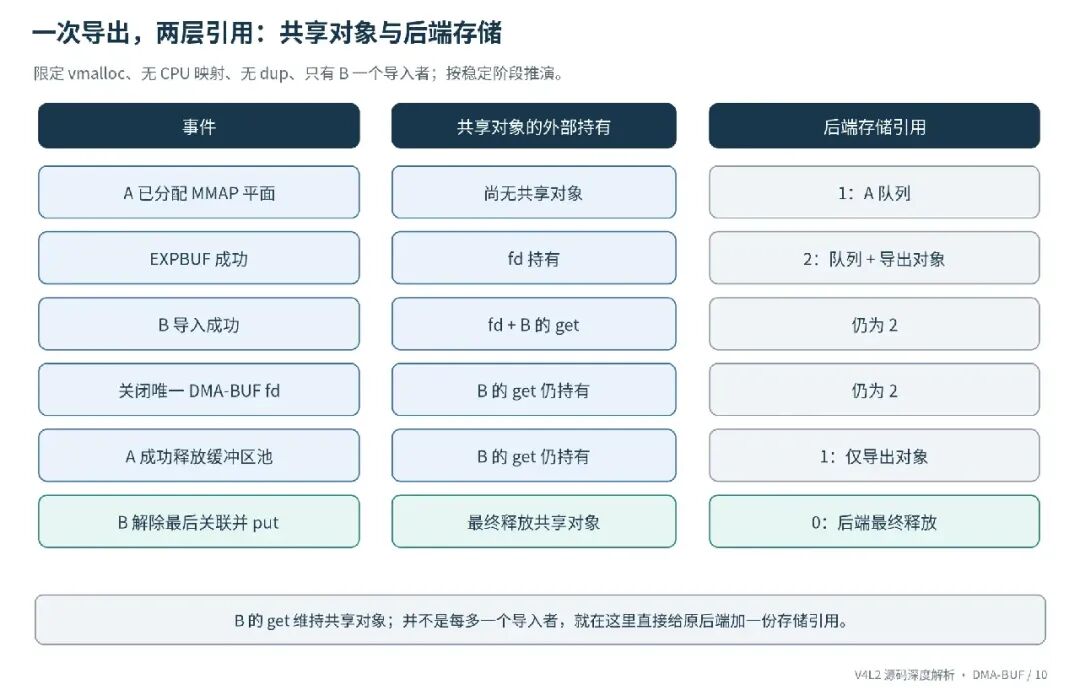
图 10:这是排除映射、别名和其他参与者后的推演,不是所有设备上恒定不变的计数表。
A 释放池后,原来的索引管理对象可以消失,存储却继续存在。之后 A 新建另一个 buffer 1,不会让 B 自动切换到那块新存储。
14.4 正常退出优先遵循依赖顺序
停止接受新任务,结束所有实际访问,撤销导入队列关联,再关闭共享 fd 和释放源池,是容易核对的一种顺序。存在 CPU 映射时,先完成当前 CPU 访问配对,再解除映射。
即使某些引用机制允许调整部分释放顺序,也不能把它们当成停止硬件的替代。关闭 fd 不会替 B 等待 DMA 完成,A 的 STREAMOFF 也不会替其他独立设备停止访问。
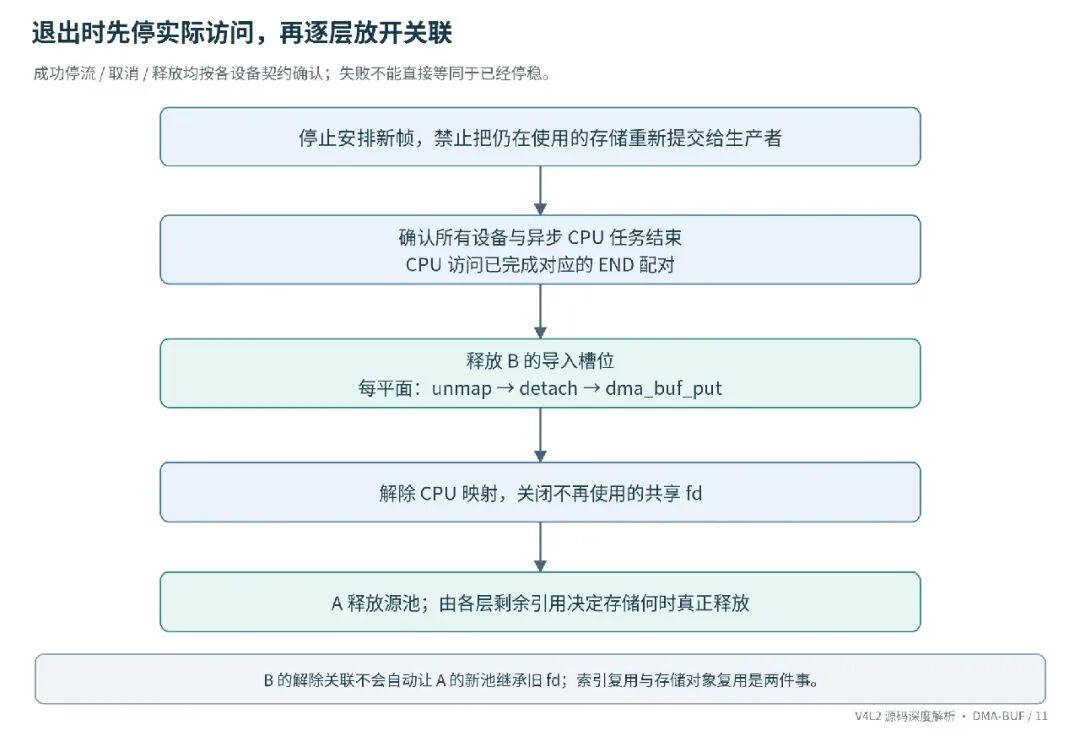
图 11:停止或取消失败时不能沿成功路径宣告内存已可覆盖。引用回收之前,先满足实际访问结束的条件。
15. 多平面共享,不只是多填几个 fd
EXPBUF 一次选择一个平面;多平面时分别导出,导入时为每个 v4l2_plane 填写对应的 fd、容量和有效数据描述。外层 b.length 是平面描述数组的元素数,不是整帧字节数。
两个平面使用不同的 fd,是一种常见组织方式,但 fd 数量与物理分配次数不能机械画等号:fd 可以是别名,不同共享对象也可能包装同一存储。应当核对实际对象和布局,而不只是数整数。
尤其不能把同一个 fd 同时填给所有平面,就默认后端会为第二平面自动加上第一平面的长度。通用 attach/map 的参数没有“这个平面在共享对象里从哪里开始”的统一偏移输入;两个 DMA 后端首先取得的是对象起点对应的映射。data_offset 描述有效数据起点,不能脱离驱动契约当成所有硬件的通用平面重定位开关。
同样,NV12 的两个分量区域可以位于一个接口内存平面中,NV12M 则采用分别描述的平面。只有格式、平面数、偏移语义与驱动实现都匹配,才能复用相同对象。未经检查的平面重叠或不同槽位共享同一可写区域,可能让数据互相覆盖;VB2 并没有替应用证明整个池的地址区间互不重叠。
实现对照:v4l2_exportbuffer 接口、vb2_fill_vb2_v4l2_buffer()、__prepare_dmabuf() 与各后端 attach/map 参数。
16. 一个不启动采集的导出/导入实验
16.1 实验刻意只验证关联,不宣称完整零复制链路
配套的 examples/dmabuf_link_probe.c 使用两个不同的单平面 CAPTURE 节点:A 建立 MMAP 池并导出 buffer 0;B 建立 DMABUF 槽位,并对槽位 0 执行 PREPARE_BUF。
两端都使用现有格式,程序不设置格式,不 QBUF、不 STREAMON,也不读取或写入像素。让两个 CAPTURE 节点参与,是为了在没有编码器假设的情况下验证对象连接;这不是同时让两个采集设备往一块内存里写。
程序先检查节点和基本能力,再比较宽高、像素格式、场、行跨度与色彩描述,核对容量。它只覆盖普通单平面布局;厂商压缩布局、额外私有约束仍需要实际驱动确认。两个节点即使结构字段相同,也不保证一定能够互相导入,准备结果才会暴露后端和设备约束。
16.2 准备成功后,再观察一次同对象复用
实验使用 F_DUPFD_CLOEXEC 创建同一 DMA-BUF 的 fd 别名。第一次 PREPARE_BUF 成功以后,在这份支持未启流取消的实现上执行 STREAMOFF,清除准备状态;随后使用别名再次 PREPARE_BUF。
第二次 fd 数字不同,对象却相同、长度相同,按本文的比较条件应复用长期关联。单凭应用返回值不能证明“没有再次 attach”,需要配合 __prepare_dmabuf()、后端 attach/map 的短时日志或跟踪确认。
清理时先释放 B 的槽位,使其归还导入引用;再关闭两个共享 fd;最后释放 A 的池并关闭节点。失败路径也执行已经取得资源的配对清理。
cc -std=c11 -Wall -Wextra -Werror -O2 \
   dmabuf_link_probe.c -o dmabuf_link_probe

./dmabuf_link_probe /dev/videoA /dev/videoB
设备路径应替换为空闲测试节点。申请缓冲区会改变队列状态,驱动 open 也可能有额外行为;不启动采集不等于可以随意对生产链路运行这个实验。
16.3 观察哪些位置才有意义
第一次准备关注 dma_buf_get、attach、map 和驱动 buf_prepare。第二次准备关注对象相等分支是否临时 put,以及 map 是否因已建立而跳过。退出关注 unmap、detach、put 的顺序与导出者最终 release。
/proc/<pid>/fdinfo/<fd> 或适用配置下的 DMA-BUF 统计可以辅助观察对象,但不能代替同步正确性验证。fd 数字、虚拟地址或成功返回值,都不能单独证明同一组页已经在真实硬件之间安全周转。
17. 把常见故障放回对应层次
排障应把“对象能取得”“映射能建立”“设备能正确访问”“本轮访问已完成”分开验证。一次成功导入最多证明已经走通了相应准备路径,不能替后续运行作全部保证。
18. 从 fd 回看整条共享链
到这里,最初的问题可以沿实际对象回答:
A 的 MMAP 平面已经有存储;EXPBUF 让后端把它包装成 DMA-BUF,并通过 fd 提供引用入口。B 的 REQBUFS 先建立自己的管理槽位,随后 QBUF 或 PREPARE_BUF 用 fd 取得同一个共享对象。DMA 后端让导出者为 B 建立附着和设备映射,vmalloc 后端则取得 CPU 映射。映射成功后,真正的驱动仍要按自己的处理方式使用数据。
本轮结束用完成和出队交接,下轮相同关联可以复用。最后停止实际访问,再按 map、attach、对象引用与后端存储引用逐层收尾。
共享的是存储,独立的是队列状态和设备访问表示;引用决定存活,完成决定交接,同步决定可见性。 只有把这几件事同时接对,传递 fd 才真正减少了多设备链路中不必要的图像复制。