ARTICLE · 1286417
一个AI试衣插件,藏着实时视频的商业化拐点
最近,我发现了一个很好玩的东西,叫WearNow。
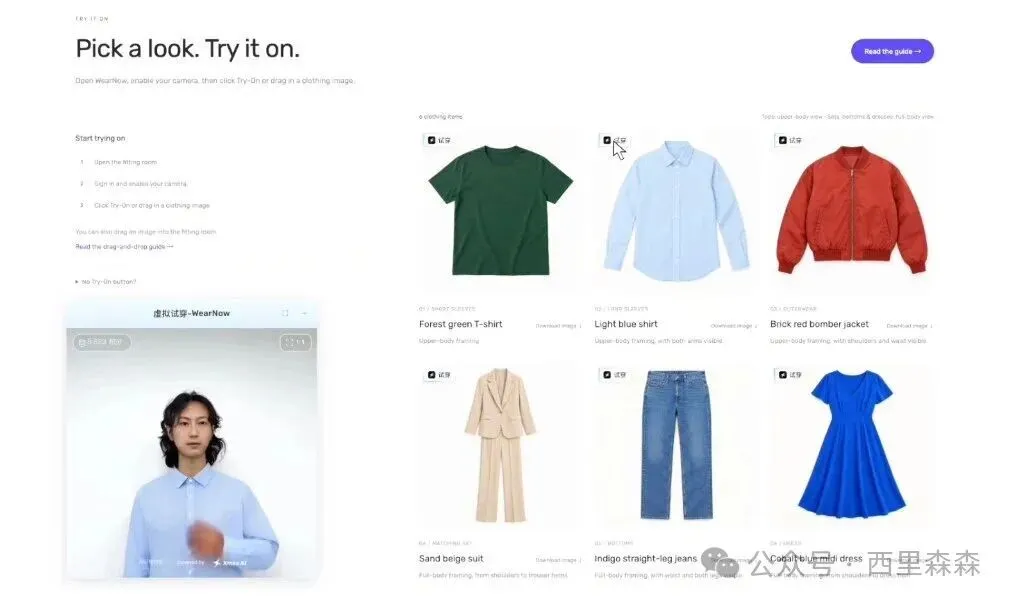
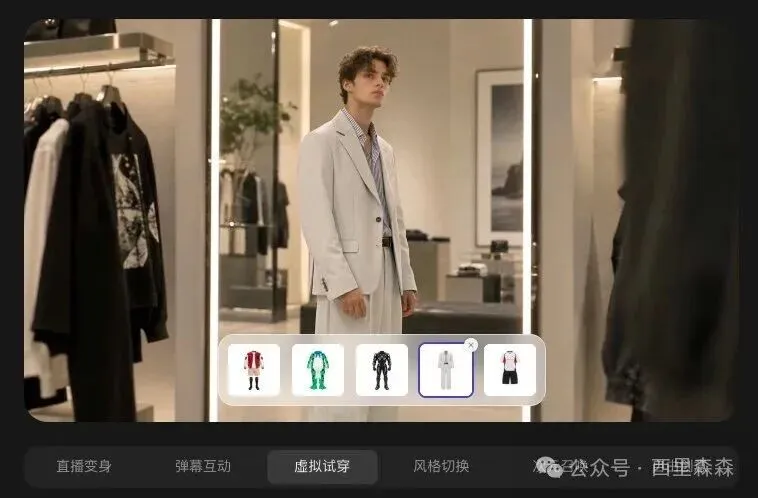
打开摄像头,再选中网页里的一件衣服,就能直接看到上身效果。
而且它不是只生成一张静态照片,你抬手、转身或者走近镜头,衣服都会跟着身体一起变化。
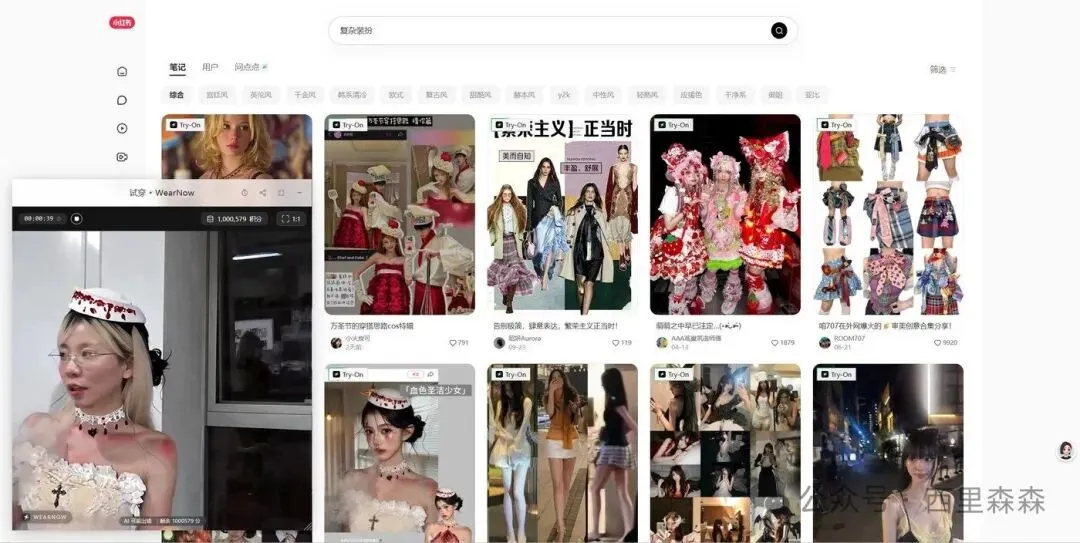
想试另一种风格,点一下就能继续换,整个过程很像在照镜子,很有意思。
SECTION 01
REAL-TIME VIDEO
我去了解了一下,WearNow背后是Xmax刚推出的实时交互视频模型X2.1。
除了换装,它还能替换人物、面部和背景,改变画面风格,并根据手势和文字指令修改视频。
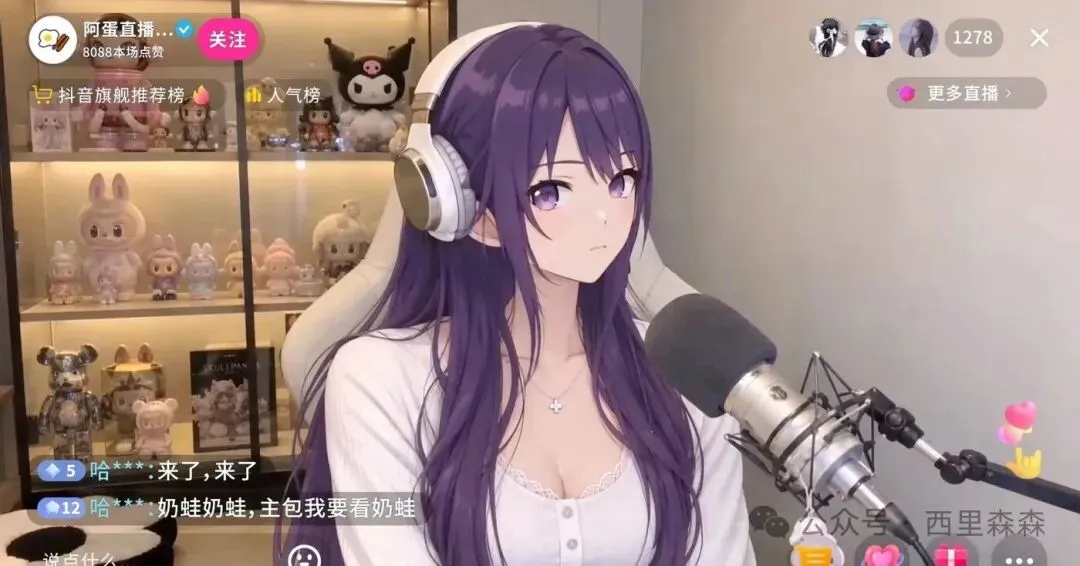
其实我还是挺惊讶的,现在的实时交互视频模型,居然已经开始进入直播、电商和视频通话这些需要持续运行的产品里了。
用户不仅可以输入提示词和参考图,还能通过拖拽、触控和手势直接改变正在生成的画面。
比如下面这个视频,拖动鼠标就能改变帽子的运动轨迹。
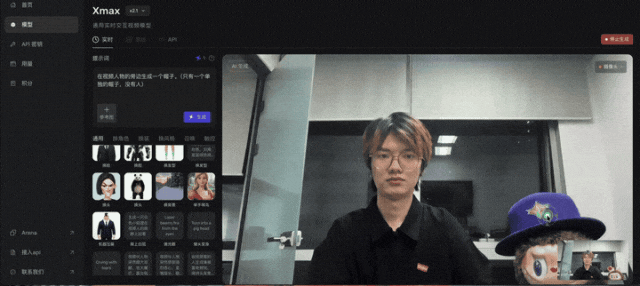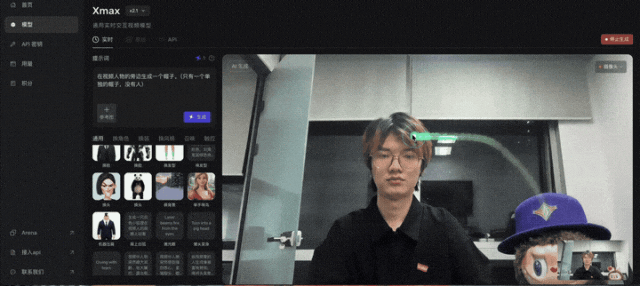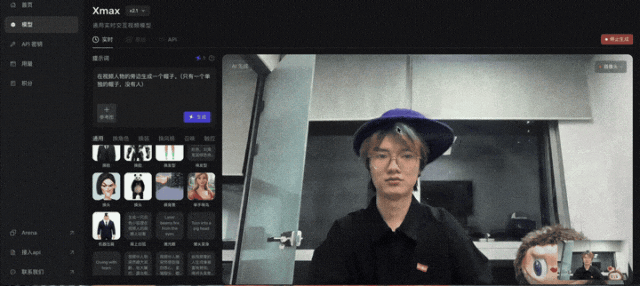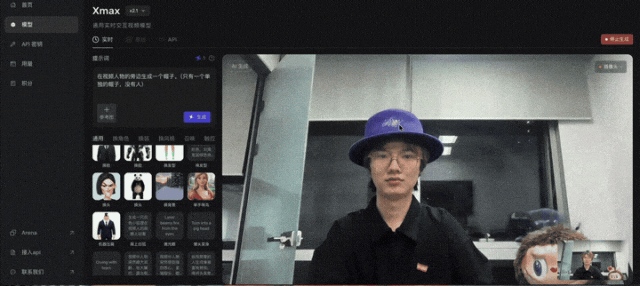
当然了,如果每增加一种玩法,都要重新接入一套模型,开发和维护成本很快就会失控。
X2.1选择了一条更通用的路线,一个模型覆盖多种需求,持续理解摄像头里的内容,再按照用户指令修改画面。
SECTION 02
REAL-TIME VIDEO
能力覆盖得广只是基础,真正难的是切换任务以后,画面依然能稳住。
为了更直观地比较实时模型的表现,Xmax做了一个叫 StreamArena 的测试场。
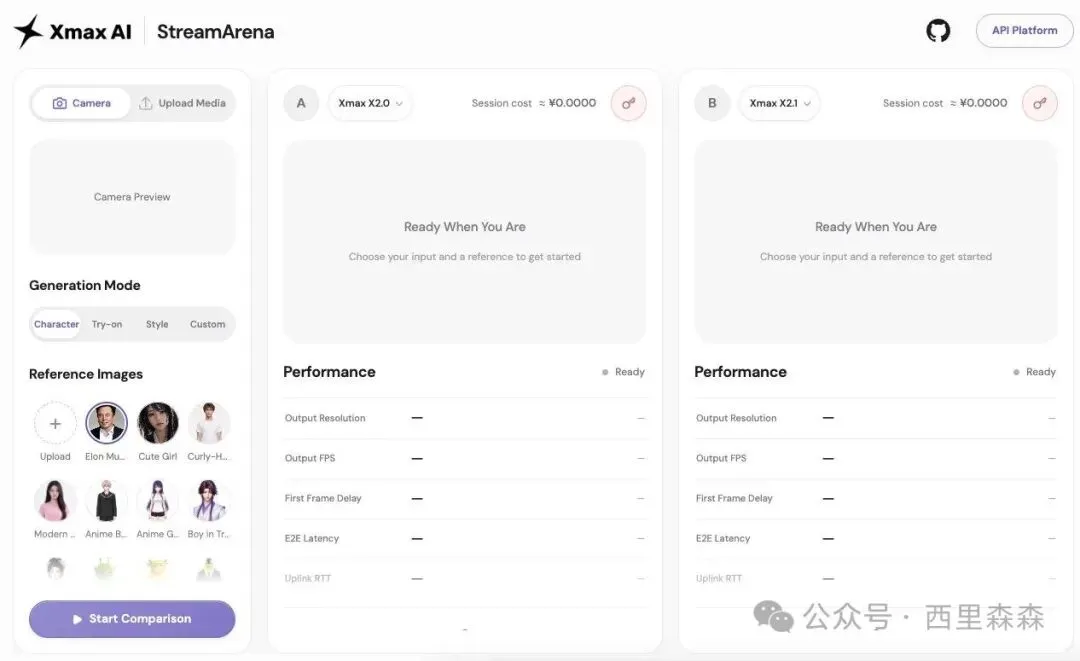
测试方法很简单,直接给不同模型相同的视频、参考图和任务,再把结果放在一起看。
重点包含是人物快速移动时,衣服的结构能不能保持稳定;只替换上衣时,包和裤子会不会被误改;做角色替换时,脸、手和身体能不能在连续运动里保持一致。
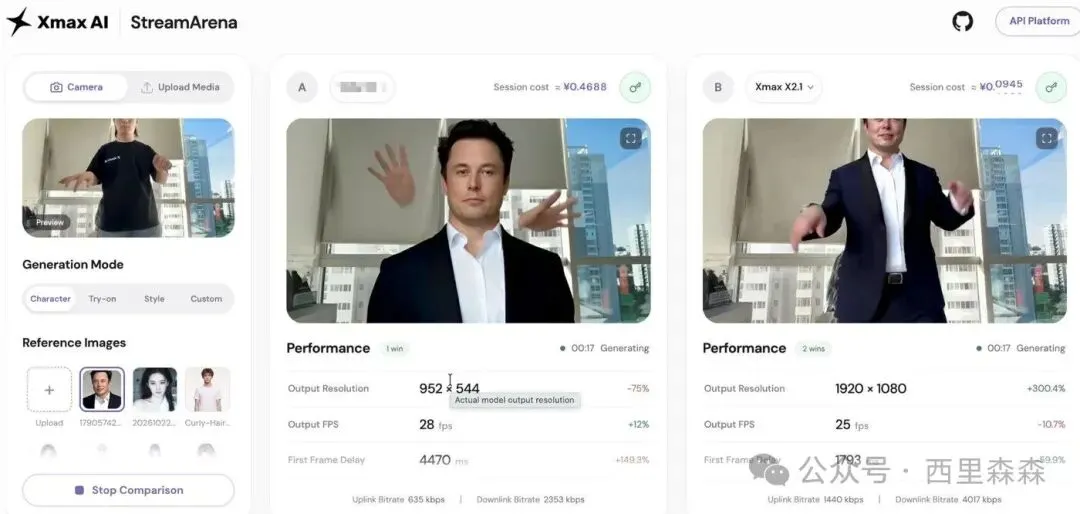
从现有结果来看,X2.1在复杂服装还原、非替换区域保持和快速动作稳定性上,都有明显优势。
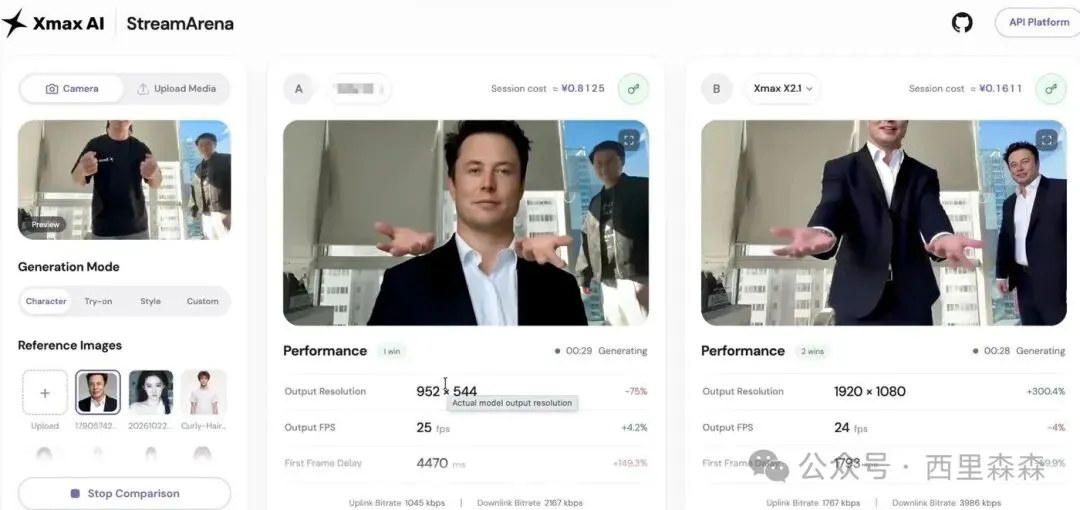
画质差距也很直观。
X2.1能够输出1080P画面,人物和背景细节更完整,运动中也较少出现模糊和破碎。
当然,这些对比来自Xmax自己搭建的测试场,还不能完全替代第三方评测和大规模真实使用。
但它提供了一种更贴近产品的评价方式,不再只是无意义的刷榜刷数据,而是让用户能直观进行对比。
实时视频不能只挑一张最好看的截图,还要看连续运行时能不能稳住。
SECTION 03
REAL-TIME VIDEO
X2.1采用逐帧自回归的视频生成方式。
简单来说,模型不会先算完整段视频,再把结果交给用户,而是根据前面的画面和当前输入,一帧一帧继续生成。
每当人物动作、参考图或交互指令发生变化,后面的画面都可以随之调整。
为了让这个过程足够快,Xmax又对模型蒸馏、采样步骤、算子和调度方式做了压缩。
根据官方数据,X2.1可以输出1080P画面,端到端延迟约200毫秒。
这个速度还谈不上完全无感,但已经接近视频通话中可以自然接受的反馈,用户不用停下来等待。
实时模型还有一个很现实的问题:只要保持在线,算力成本就会持续产生。
按照Xmax提供的国内调用价格,X2.1约为每秒0.0056元,一分钟约0.336元,一小时约20元。
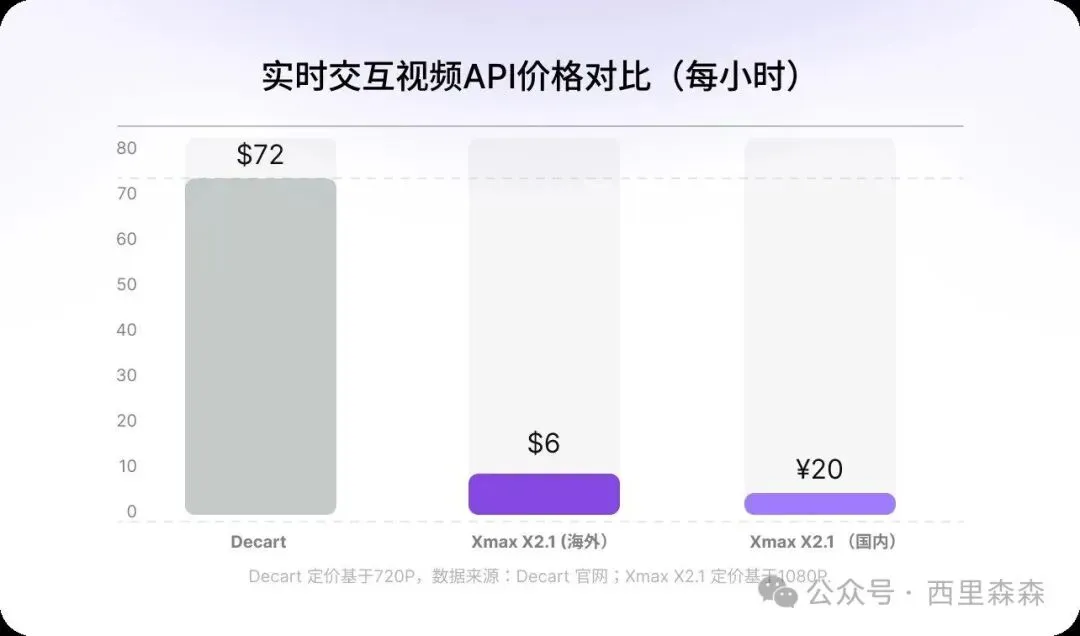
成本过高,实时试衣、视频社交和AI直播都很难落地。价格降到可以按分钟甚至按小时使用,实时视频才有机会进入商业链路。
SECTION 04
REAL-TIME VIDEO
那么,Xmax X2.1已经是全球最好的实时交互视频模型了吗?
单看某一项能力,现在很难给出绝对答案。
离线模型可以用更长的计算时间换取更高画质,复杂动作、遮挡和多人场景,也需要更多真实业务验证。
但把能力覆盖、连续稳定性、画质、延迟和成本放在一起看,X2.1确实已经进入目前最领先的一档。
WearNow只是其中一种产品形态。
围绕X2.1,Xmax还推出了视频通话工具FaceNow和直播工具XLive Studio。
FaceNow可以把实时人物替换带进视频通话。
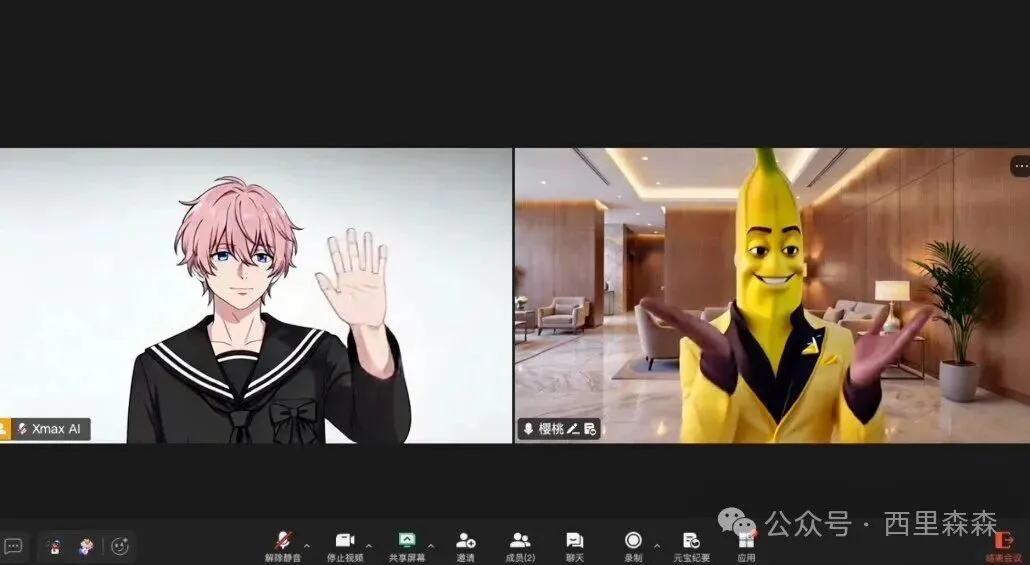
XLive Studio支持主播切换形象,观众也能通过弹幕触发画面变化。
再往外看,这套能力还可以进入游戏、社交、智能眼镜、线下展陈和虚拟陪伴。
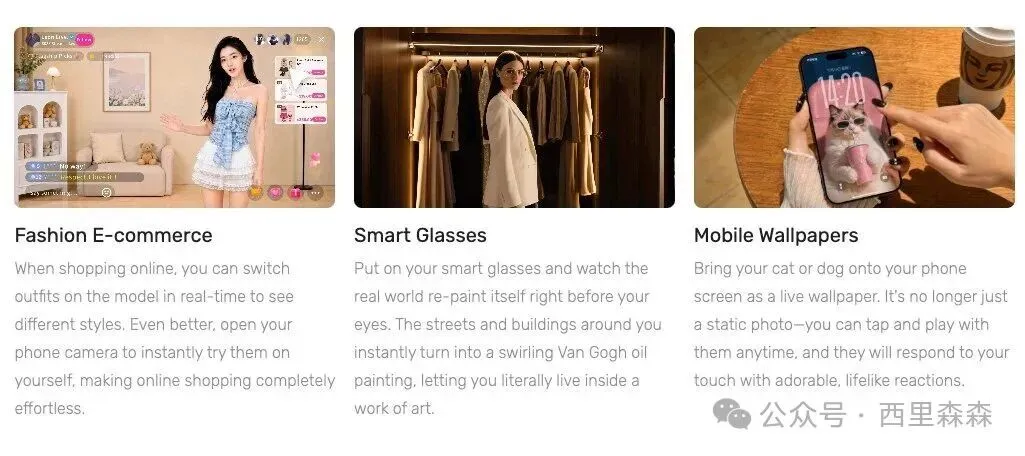
X2.1更重要的价值,是把实时视频变成一套可以被不同产品调用的通用能力。
WearNow看起来只是一个好玩的AI试衣插件,它释放出的信号是,实时视频正在变成普通人用得上、开发者接得进、企业也算得过账的产品能力。
当画面能够理解人的动作,接受新的指令,还能以普通产品承担得起的价格持续运行,视频与人的关系也会发生变化。
以后我们面对的,可能不再是一段已经生成好的内容。
而是一块会一直回应你的屏幕。