ARTICLE · 1380268
JVM 全景:从源码到机器码
应用层的问题追到底,一半的尽头是 JVM。这个系列计划:全景、内存布局、GC 基础、G1、ZGC、内存分配与逃逸分析、类加载与字节码、JIT、诊断工具链、生产实战。第一篇:JVM 到底是什么,一条 Java 指令从源码到机器码要经过什么,以及三个新手期最容易踩的坑——它们恰恰是生产环境里最贵的三种事故。
本篇三条主线:① JVM 是「规范—实现—运行时实例」三层,讨论问题时先分清在说哪层;② 一条指令的完整旅程:编译 → 类加载 → 解释 → JIT → GC 全链路;③ 三个事故都是「认知边界」事故——不是不会调参,是不知道 JVM 的账本不止一个。
事故一:升级 JDK 17 后线上 P99 抖动。一次大版本升级,发布后前 40 分钟接口 P99 从 12ms 抖到 200ms,随后恢复。回滚后复现,升级前从未出现。原因:新环境的 C2 编译队列冷启动,热点方法重新 Profiling 和编译,期间大量请求走在解释执行路径上。止血靠发布后预热压流量,根治靠把「JIT 预热」写进发布流程——JVM 的性能不是常量,启动后有一段爬坡期,流量必须配合这个爬坡期。
事故二:NoSuchMethodError 在深夜爆发。一个依赖升级后本地全绿、测试全绿,上线两小时后同一接口偶发 NoSuchMethodError。根因:两个依赖各自传递引入了同一 artifact 的不同版本,Maven 仲裁选了旧版,而新代码路径在特定分支才会调用到缺失的方法——类路径上「谁说了算」不搞清楚,任何测试都保证不了运行时的类长什么样。
事故三:Xmx 设了 2g,容器还是被杀。Pod 内存 limit 3g,JVM -Xmx2g,运维以为留了 1g 余量很稳。结果大促期间连续 OOMKilled。根因:堆外还有 Metaspace、直接内存、线程栈、GC 自身开销,峰值合计超过 1g——-Xmx 只管堆。进程内存的账本至少有四本,少看一本就会在容器里被内核杀掉。
一、技术分析:立起 JVM 的骨架
1.1 先分清三层:规范、实现、实例
说「JVM」的时候其实可能在说三样东西。JVM 规范是一份文档(The Java Virtual Machine Specification),定义了字节码格式、指令集、类文件结构、内存模型——它只规定「必须表现成什么样」,不规定怎么实现;JVM 实现是按规范写的软件,HotSpot 是事实标准,此外还有 OpenJ9、GraalVM 等;JVM 运行时实例是你 java 命令启动的那个进程。面试里说「JVM 方法区在哪」答 PermGen 或 Metaspace 都不算错——规范只说方法区是逻辑概念,放在哪是实现的事:HotSpot 8 之前用 PermGen,8 之后移到 Metaspace。分不清这三层,很多争论根本无法展开。
1.2 一条指令的旅程:从源码到机器码
把一条 Java 指令的一生展开(图 1):javac 把源码编译成 .class 字节码——注意 javac 是编译到字节码,不是编译到机器码,它只是 JVM 的前置工具,不是 JVM 的一部分;类加载子系统把字节码读进来、校验、变成方法区的运行时结构;main() 入口之后,执行引擎接管——解释器逐条解释字节码,热点代码被 JIT 编译成机器码;整个过程中对象在堆上分配,GC 持续工作。编译期一次完成,运行期持续发生——这是 Java「一次编写、到处运行」的机制根源,也是 Java 性能问题和 C++ 性能问题形态完全不同的原因:C++ 的性能在编译时就定死,Java 的性能是运行时演化的。
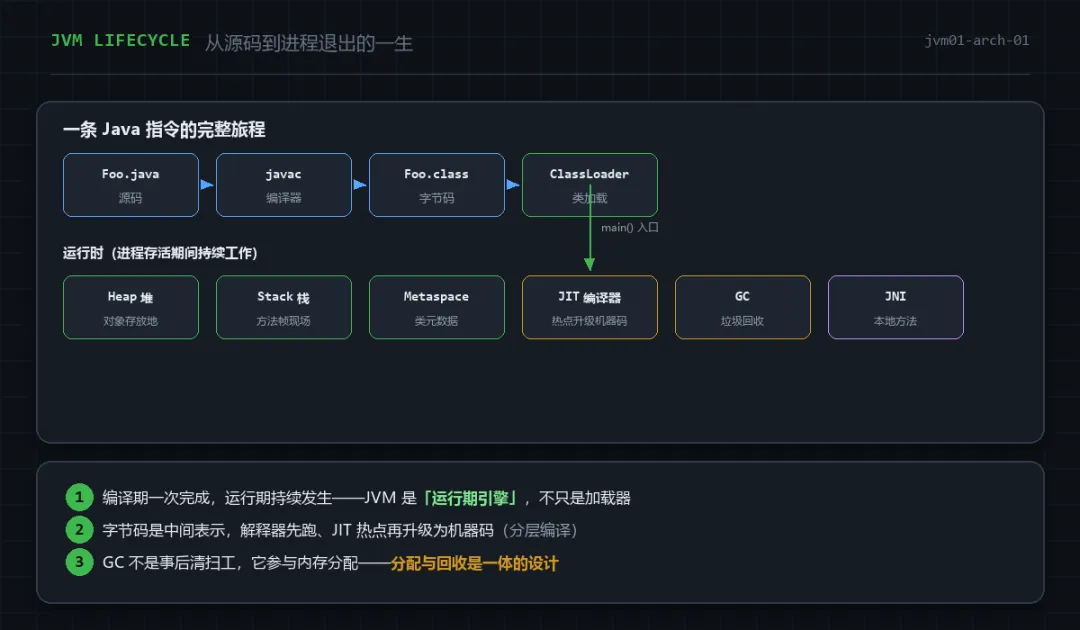
图 1 · 一条 Java 指令的完整旅程:编译期一次完成,运行期持续发生
1.3 体系结构:三大子系统与一根桥
JVM 的内部结构可以压缩成三块(图 2):类加载子系统负责把字节码变成可执行的运行时结构;运行时数据区是内存的账本,堆和 Metaspace 线程共享,虚拟机栈、程序计数器、本地方法栈线程私有,此外还有一块容易漏的直接内存——NIO 的 DirectByteBuffer 用它,它不受 Xmx 管;执行引擎包含解释器、JIT 编译器和 GC——注意 GC 是执行引擎的一部分而不是独立模块,它和内存分配深度耦合。三块之间靠 JNI 这根桥连接本地世界。后面九篇的内容全部挂在这三块上:内存布局(02 篇)展开第二块,GC 系列(03-06 篇)展开执行引擎,类加载(07 篇)展开第一块。
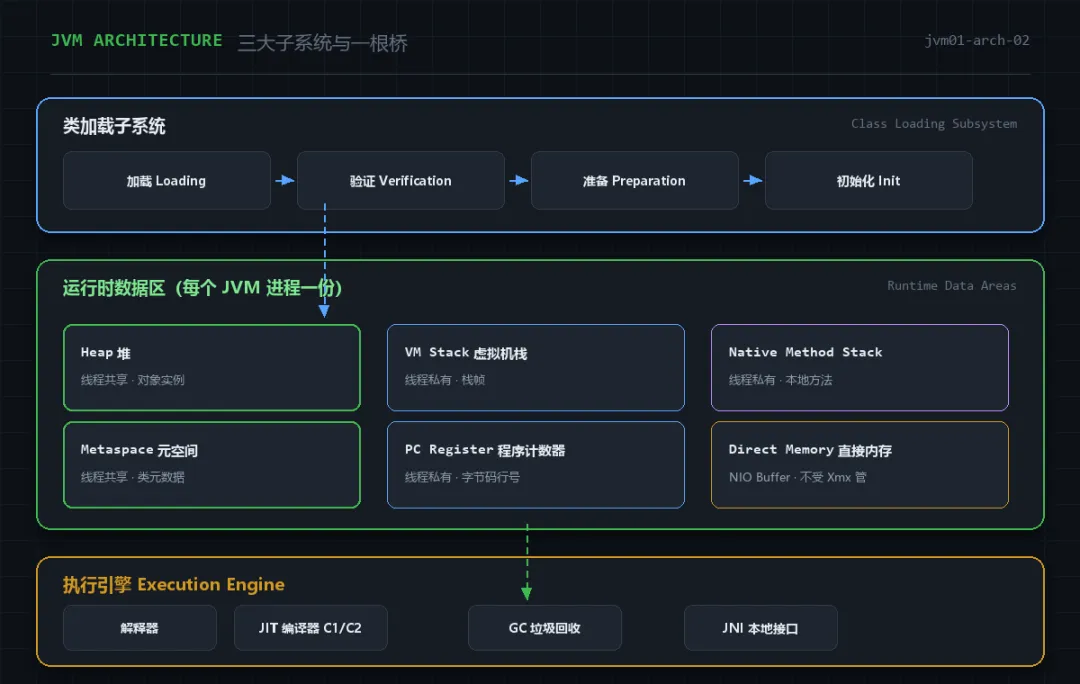
图 2 · JVM 体系结构:类加载子系统 → 运行时数据区 → 执行引擎,JNI 连接本地世界
1.4 类加载五阶段与「活过来」的那一刻
类加载的流水线(图 3)分五步:加载、验证、准备、解析、初始化。前三步纯 JVM 内部动作:加载读字节流生成 Class 对象,验证防恶意字节码,准备给静态变量分配并设零值——int a = 1 在准备阶段 a 是 0,真正变成 1 要等初始化阶段(final 常量除外,它在准备阶段就赋值);解析把常量池的符号引用换成直接引用,可以延迟;初始化是第一个执行 Java 代码的阶段,它执行静态变量赋值和静态块(合称 <clinit>)。什么时候初始化?六种主动引用:new、读写静态字段(非常量)、反射调用、调用 main 的主类、初始化子类时父类先初始化、以及 JDK 7 的动态语言支持。其余都是被动引用,不触发——「类什么时候加载」和「类什么时候初始化」是两个问题,生产事故里很多诡异的 NPE 和常量缓存问题就出在这。
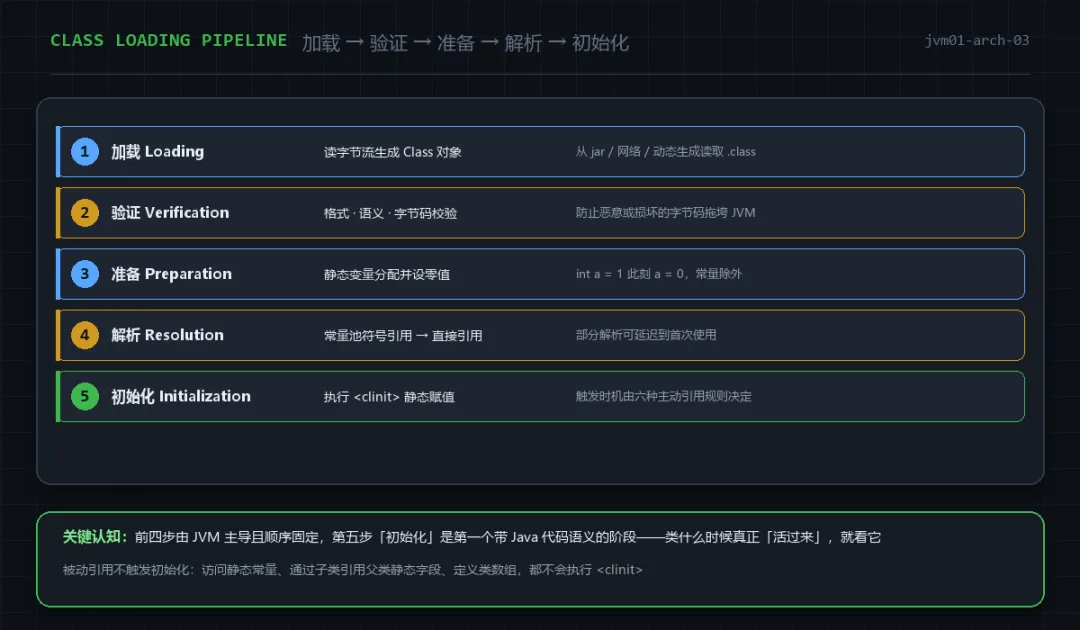
图 3 · 类加载五阶段:前四步 JVM 主导,初始化是第一个带 Java 语义的阶段
1.5 双亲委派:先问爸爸,再自己干
类加载器的层次(图 4)从上到下:Bootstrap(核心类库)、Platform(9+ 的平台类库,8 里叫 Extension)、Application(classpath)、自定义加载器。双亲委派的规则只有一句话:收到加载请求先委托父加载器,父加载器反馈无法完成时子加载器才自己加载。它解决两个问题:安全(你自己写个 java.lang.String 加载不进来,核心类永远由顶层说了算)和唯一(核心类全 JVM 只加载一次)。但它不是不能打破:SPI 用 ContextClassLoader 反向委托、Tomcat 每个应用独立加载器做隔离、热部署框架故意重复加载——打破的代价都要自己承担。还有一个必须刻进脑子的事实:类的同一性由「加载器 + 全限定名」共同决定,两个加载器加载同一个类,instanceof 会返回 false。事故二里深夜爆发的类型转换异常,根子都在这。
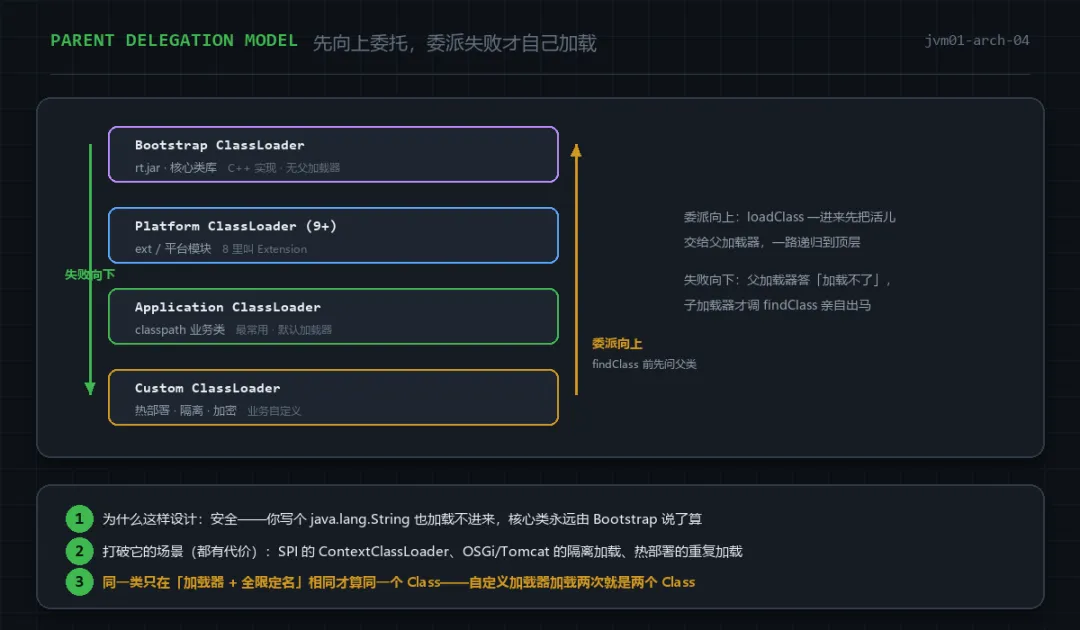
图 4 · 双亲委派模型:委派向上、失败向下,打破它有代价
1.6 执行引擎:解释器打底,分层编译升级
为什么不启动时就把所有代码编译成机器码?因为编译本身有成本,而且大部分代码根本跑不了几次。分层编译(图 5)的思路是按热度区别对待:Tier 0 解释执行保冷启动;Tier 1-3 是 C1(客户端编译器)快速编译并采集 Profiling 数据;Tier 4 交给 C2(服务端编译器)做激进优化——内联、逃逸分析、循环优化都在这层。热点探测靠方法调用计数和回边计数,默认阈值约一万次。关键机制是去优化:C2 的激进优化建立在Profiling 猜想上(比如「这个字段只会是 A 类」),猜想一旦被证伪,机器码作废退回解释器重新走流程——JIT 不是一次到位,是持续修正。事故一的 P99 爬坡正是这条流水线的冷启动成本:全部热点要重新走Tier 0 → 3 → 4,大服务的爬坡期可以长达几十分钟。
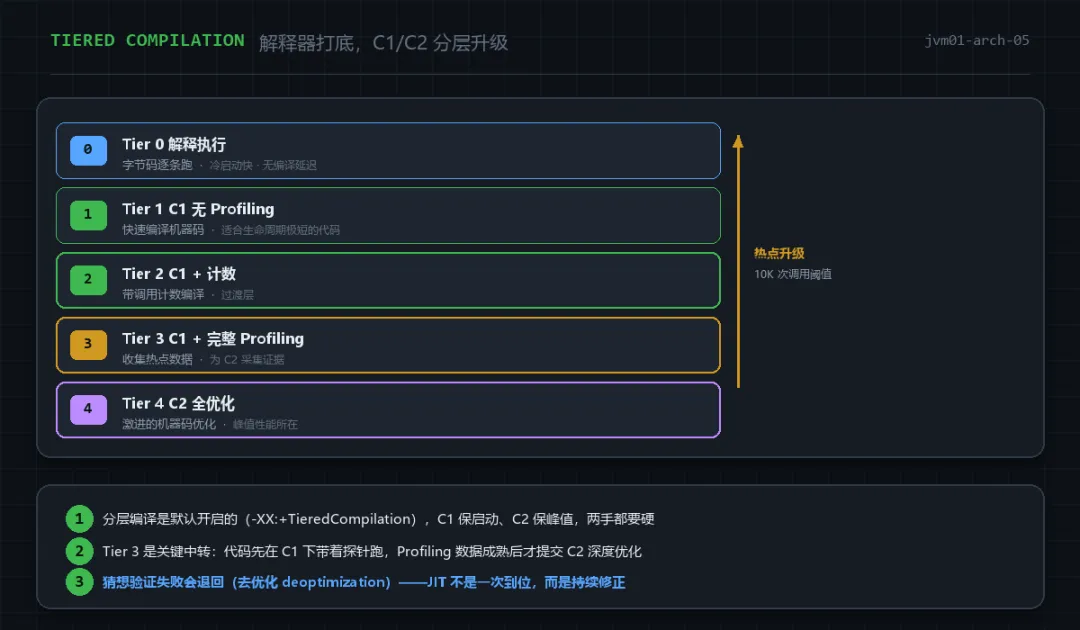
图 5 · 分层编译五层:C1 保启动、C2 保峰值,去优化持续修正猜想
1.7 内存账本不止一本:Xmx 之外还有三本
事故三的根因值得单独展开。一个 JVM 进程的内存至少四本账:堆(-Xmx 管,最大头);Metaspace(类元数据,-XX:MaxMetaspaceSize 管,动态生成类的场景会失控);线程栈(每个线程一份,-Xss 默认 1M,线程数 × 1M 不是小数);直接内存(NIO 和 Netty 用,-XX:MaxDirectMemorySize 管,默认约等于 Xmx)。容器时代这三本账全都致命:堆设得刚好等于容器 limit,堆外一涨就被内核 OOMKilled,而且 kill 发生在内核层,JVM 的 HeapDumpOnOutOfMemoryError 完全抓不到现场——因为它压根不知道自己要死了。这是本系列反复出现的主题:先知道账本有哪些,再谈怎么管。02 篇会把四本账逐一展开。
二、生产实战:一份参数与一套流程
2.1 配置一:生产 JVM 启动参数全量
这份参数是后面各篇的收敛预览:GC 参数(03-06 篇)、JIT 参数(08 篇)、诊断参数(09 篇)各自的细节后面展开,这里先给骨架。每个参数后面标注它保护什么——看不懂保护什么的参数不要抄:
# ==== 生产 JVM 启动参数骨架(JDK 17)====
# --- 堆:起始=最大,避免运行期扩缩容抖动 ---
-Xms4g -Xmx4g
# 等值原则:动态扩容会产生 Full GC 风暴
# --- 元空间:给动态生成类留上限 ---
-XX:MetaspaceSize=256m
-XX:MaxMetaspaceSize=512m
# --- 线程栈:默认 1M,千线程服务注意乘积 ---
-Xss1m
# --- GC:G1 起步(04 篇细讲)---
-XX:+UseG1GC
-XX:MaxGCPauseMillis=50
# --- JIT:默认分层编译,不用动 ---
-XX:+TieredCompilation
# --- 诊断:OOM 留现场 ---
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/data/dump/
# OOM 时先 dump 再退出,配合告警抓盘
-Xlog:gc*:file=/data/logs/gc.log:time,uptime:
level,tags:filecount=5,filesize=50m
# 统一日志:可观测性是排障的底线
2.2 配置二:容器环境的正确姿势
容器里不要手写 -Xmx,让 JVM 感知容器 limit 并自己算堆大小;同时用 NativeMemoryTracking 把堆外账本亮出来:
# ==== 容器参数(limit: 4Gi 的 Pod)====
# 按 limit 百分比分堆,留 30% 给堆外
-XX:MaxRAMPercentage=70.0
# 4Gi x 70% = 堆约 2.8G
# 余量给元空间/栈/直接内存
# 打开内存追踪(生产可用,开销约 5%)
-XX:NativeMemoryTracking=summary
# 容器里禁用手动 bias/显式 GC 等历史包袱
-XX:-UsePerfData 保留;去掉 UseCompressedOops
# 现代默认开启,不要再写
# 体检命令:进程内存的四本账
jcmd 1 VM.native_memory summary
# 输出示意(单位 KB):
# Java Heap: 2936012 <- Xmx 那本
# Class: 98304 <- Metaspace
# Thread: 61440 <- 60 线程 x 1M
# Internal: 20480 <- GC 自身等
# Total: committed ≈ 3.1G < limit 4G 安全
配额上还有一条纪律:Pod 的 requests 和 limit 都要按「native_memory summary 的 Total」来定,不是按 Xmx。总 committed 加上安全余量(建议 20%)就是 limit 的下限。上线前跑一轮压测看 summary 曲线,四本账各自的峰值记进容量表——这套动作和 Kafka 篇的容量规划是同一个思想:可计算,不拍脑袋。
2.3 复盘:JDK 17 升级的三周
回到事故一。复盘时把升级流程固化成五步:① 依赖先行——把依赖矩阵在 JDK 17 下全量编译,处理 remove 掉的 API(尤其 sun.misc 和 JEE 模块);② GC 换代验证——17 默认 G1,与 8 的 Parallel 对比压测,不能想当然更快;③ JIT 预热方案——发布后灰度实例先压 10 分钟流量再接真流量,或用预热框架提前触发热点方法;④ 灰度观测——至少 10% 流量观察 24 小时,盯 P99 和 GC 日志两个口径;⑤ 回滚预案——镜像双版本并存,一条命令切回。三周的升级成本里,真正的难点从来不是编译报错,而是行为差异:字符串去重、JIT 优化策略、默认 GC 都变了,压测口径必须覆盖。
2.4 类冲突排查 SOP:从报错到根因十分钟
事故二这类问题有一套标准动作。第一步定性:NoSuchMethodError 是「类在、方法不在」——版本旧了;NoClassDefFoundError 是「运行期找不到类」——编译期在、运行期不在,scope 配置问题;ClassNotFoundException 是「主动加载找不到」——反射或 SPI 配置问题。三种错三个方向,先分清再动手。第二步定位:报错栈里的类是谁加载的:
# 第一步:报错时先看类从哪个 jar 加载
# (arthas,09 篇细讲)
sc -d com.google.common.collect.Lists
# 输出 class-info 里的 jar 位置即真相
# 第二步:本地复现依赖仲裁
mvn dependency:tree -Dverbose
# 找到目标 artifact 的两条路径
# +- A:1.0 -> guava:20.0 (omitted for
# conflict with 31.0)
# omitted 标记的就是被仲裁掉的版本
# 第三步:显式锁定版本
<dependencyManagement>
<dependency>
<groupId>com.google.guava</groupId>
<artifactId>guava</artifactId>
<version>31.0-jre</version>
</dependency>
</dependencyManagement>
SOP 的最后一步是固化:CI 里加 maven-enforcer-plugin 的dependencyConvergence 规则,让仲裁冲突在提交时就报错——把「深夜爆发的 NoSuchMethodError」变成「提交时的红线」,和 Kafka 篇把事故变成上线卡点是同一个方法:事故会重复,卡点不会。
三、核心源码:四段看懂骨架
3.1 ClassLoader.loadClass:双亲委派的骨架
protected Class<?> loadClass(String name,
boolean resolve)
throws ClassNotFoundException {
synchronized (getClassLoadingLock(name)) {
// 1. 先查:这个加载器是否已加载过
Class<?> c = findLoadedClass(name);
if (c == null) {
try {
// 2. 有父加载器就委托父加载器
if (parent != null) {
c = parent.loadClass(name, false);
} else {
// 3. 无父(Bootstrap)查核心类库
c = findBootstrapClassOrNull(name);
}
} catch (ClassNotFoundException e) {
// 父加载器加载不了,抛回这里
}
if (c == null) {
// 4. 委派失败,本加载器亲自查找
c = findClass(name);
}
}
if (resolve) resolveClass(c);
return c;
}
}
四步结构就是双亲委派的全部:查缓存 → 委托父 → 委派失败则 findClass。自定义加载器应该重写 findClass 而不是 loadClass——重写 loadClass 就把委派链改掉了,除非你明确要打破它。
3.2 URLClassLoader.findClass:委派失败后的亲自查找
// 委派到不了这里,能进来就说明
// 父加载器都加载不了
protected Class<?> findClass(String name) {
// 1. 把全限定名变成资源路径
String path =
name.replace('.', '/') + ".class";
Resource res = ucp.getResource(path, false);
if (res != null) {
// 2. defineClass:字节流 -> Class 对象
// (期间触发验证与准备)
return defineClass(name, res);
}
throw new ClassNotFoundException(name);
}
findClass 的两步把「加载」阶段写实了:定位字节流,然后 defineClass 进入 JVM 内部——验证和准备都在 defineClass 的调用链里完成。自定义类加载器的扩展点就是这里:从网络读、从加密文件读、从内存生成,都在 findClass 里换字节流来源。
3.3 Class.forName 与加载器初探:主动初始化的入口
// 反射触发的就是六种主动引用之一
public static Class<?> forName(
String className)
throws ClassNotFoundException {
// caller sensitivity:取调用者的加载器
Class<?> caller =
Reflection.getCallerClass();
// initialize=true 是关键差异:
// 它会一路执行到 <clinit>
return forName0(className, true,
ClassLoader.getClassLoader(caller),
caller);
}
// 对比:加载但「不活过来」
Class<?> c = Loader.class.getClassLoader()
.loadClass("com.demo.Loader");
// 此时 c 非 null,但静态块没跑过
// 第一次 new / 读静态字段时才触发 <clinit>
forName 和 loadClass 的区别是面试高频题:前者「加载 + 连接 + 初始化」,后者只「加载」。JDBC 驱动注册、SPI 加载都用 forName——因为驱动注册逻辑写在静态块里,不初始化等于没装。
3.4 分层编译的热点判定(HotSpot 简化)
// HotSpot C++ 侧的判定逻辑(简化伪码)
bool should_compile(Method* m,
CompLevel cur) {
int invocations = m->invocation_count();
int backedges = m->backedge_count();
switch (cur) {
case CompLevel_none: // Tier 0
// 达到阈值 -> 先进 C1(Tier 3 采数据)
return invocations >= INV_THRESHOLD;
case CompLevel_c1_profile: // Tier 3
// Profiling 数据成熟 -> 提交 C2
return invocations >= C2_THRESHOLD
&& profile_mature(m);
}
return false;
}
// C2 猜想被打破 -> deoptimize 退回解释器
// 该方法计数清零,重新积累热度
这段伪码解释了两件事:为什么启动后有一段爬坡期(每个热点都要从解释器重新爬梯子),以及为什么预热压测是升级流程的必选项。08 篇会把去优化和逃逸分析展开到字节码层面。
四、七笔账
启动账:大服务冷启动的爬坡期 20~40 分钟,期间解释执行路径的性能只有编译后的一半以下。没有预热就接全量流量,等于上线即降级。
依赖账:一个中型服务的 classpath 上平均 200+ 个 artifact,冲突靠仲裁「碰巧能用」是常态。enforcer 红线的成本是配置一次,收益是消灭一类深夜事故。
内存账:Xmx 只是最大的一本账,不是全部。容器 limit 按 native_memory summary 的 Total 定,余量 20% 起——少留的那 20% 会变成凌晨的 OOMKilled 告警。
兼容账:JDK 大版本升级的成本分布:编码适配 30%、依赖适配 30%、行为差异验证 40%。行为差异最贵也最容易漏——GC 换代、JIT 策略、默认值变化都在这一类。
排障账:三种 NoClassDef 类报错平均排障 2 小时,方向错了拖到 2 天。先定性(三个错误三个方向)再用 arthas 定位,10 分钟内结束战斗。
性能账:分层编译让峰值性能比纯解释快 10~30 倍,但 Profiling 本身有5~10% 开销。绝大多数服务不该关分层编译,除非你是短命 CLI 工具。
心智账:「规范—实现—实例」三层分清后再看所有争论:PermGen vs Metaspace 是实现差异,方法区是规范概念。争论先对齐层面,否则鸡同鸭讲。
五、高频面试题(含答案)
Q1 · JVM 是规范、软件还是进程?HotSpot 又是什么?
三者都是,分三层回答:JVM 规范是文档(定义字节码、指令集、内存模型);HotSpot 是规范的主流实现(OpenJDK/JDK 默认虚拟机,因热点探测而得名);java 命令启动的进程是一个 JVM 实例。讨论「方法区在哪」时,规范只定义逻辑概念,存放位置是实现细节。
Q2 · javac 属于 JVM 吗?字节码和机器码的区别?
javac 不属于 JVM,它是把源码编译成字节码的前置编译器(本身是 Java 程序)。字节码是面向虚拟机的中间表示、平台无关;机器码面向具体 CPU 架构。字节码由 JVM 执行时再通过解释器/JIT 转成机器码,这就是「一次编写到处运行」的机制。
Q3 · 类加载五个阶段的顺序可以打乱吗?哪个阶段最特殊?
加载、验证、准备、解析的顺序相对固定(解析支持延迟),初始化必须在准备之后且第一个执行 Java 代码。最特殊的是初始化:它由六种主动引用触发,其余被动引用不触发——这是「类加载了但没活过来」的根源。
Q4 · 静态变量在准备阶段是什么值?final 常量呢?
准备阶段静态变量一律零值(int=0、引用=null),int a=1 的 1 要到初始化阶段才赋值;static final 的编译期常量(String、基本类型字面量)在准备阶段直接赋值,因为它们进了常量池,不需要 <clinit> 参与。
Q5 · 六种主动引用是什么?各举一例被动引用。
主动:new 实例化;读写非编译期常量的静态字段;反射 Class.forName;启动主类;初始化子类先触发父类;JDK 7 动态语言句柄。被动示例:通过子类引用父类静态字段只触发父类、定义数组Foo[] arr 不触发 Foo、访问 static final 常量不触发。
Q6 · 双亲委派的流程和设计动机?
收到加载请求先委托父加载器逐级向上,父级无法完成才自己 findClass。动机:安全——用户伪造 java.lang.String 加不进来;唯一——核心类全局只加载一份。实现就是 loadClass 四步:查缓存、委托、兜底、findClass。
Q7 · 怎么打破双亲委派?代价是什么?
重写 loadClass 改委派逻辑,或用线程上下文加载器反向委托(SPI/JDBC);Tomcat 为每个 webapp 建独立加载器先自己加载实现隔离;OSGi 用网状委派。代价:类的唯一性靠约定维护、隔离边界出问题排查困难、热部署泄漏风险。
Q8 · Tomcat 为什么要自定义类加载器?
两个诉求:隔离——两个应用用不同版本的同一个库,必须各自加载各自的;卸载——应用重新部署时丢弃其加载器,连带卸载所有类,否则 Metaspace 只涨不降。WebappClassLoader 故意先自己加载(违背委派)再委托父级。
Q9 · 两个不同的加载器加载同一个类,instanceof 结果?
false。类的同一性由「Class 对象 = 加载器 + 全限定名」决定,两个加载器加载的同一个类名是两个不同的 Class,相互赋值会抛 ClassCastException。这是自定义加载器隔离场景最常见的坑。
Q10 · 解释器和 JIT 为什么共存?只留 JIT 不行吗?
JIT 编译有成本(编译线程、代码缓存),且多数代码只执行一两次,编译它们纯亏;解释器启动零成本。共存 = 分层编译:解释保冷启动,热点才值得编译。只留 JIT(如 AOT 化)会让启动时间和内存暴涨。
Q11 · C1 和 C2 的定位差异?
C1 快编译、轻优化、必带 Profiling 采数据;C2 慢编译、激进优化(内联、逃逸分析、向量化),依赖 C1 采集的 Profiling 数据做猜想。分层编译让 C1 管启动和过渡(Tier 1-3),C2 管峰值(Tier 4)。
Q12 · 热点怎么探测?相关的两个 JVM 参数?
方法调用计数 + 回边计数(循环),之和超阈值触发编译。-XX:CompileThreshold 控制方法阈值(分层编译下是内部阈值,不可直接设)、OnStackReplacePercentage 控制回边。热度还带衰减(半衰期),长时间不调用的方法计数会退火。
Q13 · 什么是去优化?举一个必然发生的场景。
C2 基于 Profiling 猜想编译(如「此字段只会是 A 类」),运行时出现违例即猜想证伪,机器码作废、退回解释器重新采集。必然场景:首次向原本单态的集合传入另一个类型;或类层次被子类加载器扩展后。去优化不是 bug,是分层编译的自我修正。
Q14 · -Xmx2g 的进程在容器 limit 3g 里安全吗?
不安全。除堆外还有 Metaspace(动态类生成可达数百 MB)、线程栈(线程数 x -Xss)、直接内存(默认约等于 Xmx)、GC 自身开销、Code Cache。四本账峰值加起来超过 limit 就被内核 OOMKilled,且 JVM 无感知、抓不到 dump。正确姿势 MaxRAMPercentage + native_memory summary 实测。
Q15 · Metaspace 和 PermGen 的区别?为什么要移除?
PermGen 在堆内、大小固定易 OOM(类加载器卸载不彻底时);Metaspace 在本地内存、默认只受物理内存限制(可用 MaxMetaspaceSize 封顶)。移除动机:PermGen OOM 是历史高频故障,移到本地内存后与堆生命周期解耦,为 GC 演进扫清障碍。
Q16 · 直接内存是什么?和堆的区别?怎么限制?
堆外本地内存,NIO DirectByteBuffer 使用,Netty 大量依赖。区别:不受 GC 管理(靠 Cleaner 回收)、分配释放贵但 IO 零拷贝快。-XX:MaxDirectMemorySize 封顶,默认约等于 -Xmx。排查它用 native_memory summary 和 NMT 的 Other 章节。
Q17 · 线程栈大小谁定?1000 线程的服务栈内存多大?
-Xss 默认 1M(64 位 Linux)。1000 线程理论 1G——注意这是committed 虚拟内存按需提交,实际物理占用看栈深,但容量的规划要按 committed 算。深递归场景调大 -Xss,海量线程场景调小到 256k~512k。
Q18 · JNI 调用的开销在哪里?什么场景该避免?
开销在:Java→native 的边界切换(保存寄存器现场)、句柄管理、数据拷贝(数组传递)。频繁跨界的循环内调用要批量化。JDK 9 后有 Foreign 链路(Panama)大幅降低开销,新代码优先考虑。
Q19 · 容器里配 JVM 参数的正确姿势?
不要手写 -Xmx 固定值,用 -XX:MaxRAMPercentage=70 让 JVM 按容器 limit 计算(JDK 8u191+/10+ 默认容器感知);开 NativeMemoryTracking 验证总 committed 占 limit 的 80% 以内;CPU 用 -XX:ActiveProcessorCount 显式指定,避免感知错核数。
Q20 · OOM 时怎么自动留现场?这个参数的局限?
-XX:+HeapDumpOnOutOfMemoryError + HeapDumpPath。局限:只覆盖堆内 OOM——Metaspace OOM 早期版本部分覆盖、直接内存 OOM 和容器 OOMKilled 完全不触发(kill 的是内核)。完整方案 = 堆 dump + NMT 监控 + 容器内存告警三层。
六、一页速记
JVM 全景六句:① 规范、实现、实例分三层,争论先对齐层面;② 编译期一次完成,运行期持续演化——JVM 的性能是活物;③ 类加载五阶段,初始化是「活过来」的那一刻,六种主动引用触发;④ 双亲委派一句话:先问爸爸,爸爸不行自己干;打破要付代价;⑤ 分层编译:解释打底、C1 采证、C2 决战、去优化纠错;⑥ 内存四本账:堆、Metaspace、线程栈、直接内存,Xmx 只管一本。
七、小结与下篇预告
整个系列的骨架:三大子系统(类加载、运行时数据区、执行引擎)+ 四本内存账 + 一条「源码到机器码」的完整链路。三个开场事故分别对应三块骨架的盲区:不了解 JIT 演化(事故一)、不了解类加载与委派(事故二)、不了解内存账本(事故三)。后面的每一篇都在这块骨架上长肌肉:02 篇拆运行时数据区,把四本账的布局、对象在内存里长什么样、以及 OOM 的每种形态讲透——它是 GC 系列(03-06)的地基,也是排障工具链(09 篇)的地图。
建议:拿你手头的服务跑一遍 jcmd 1 VM.native_memory summary,把四本账的实际占比记下来——这个数字后面每一篇都会用到,JVM 的学习从看清自己的进程开始。