ARTICLE · 1401296
把 PDF 变成能核对的数据:用 Docling 跑通一次报价单整理
把 PDF 变成能核对的数据:用 Docling 跑通一次报价单整理
两份报价单放在面前:A 的合计是 16000 元,B 是 15000 元。看起来差了 1000 元,翻到第二页才发现,B 写的是未税,还要加 6%。口径统一以后,两家只差 100 元,交期却相差 5 个工作日。
金额并不难算,麻烦在于资料散在不同位置。第一页是表格,第二页是条款;复制出来的一串数字,还得知道它属于哪个项目、什么单位、哪种税务口径。换成扫描件,连文字提取都可能没有结果。
这次我用 Docling 做了一次完整练习:把两份 PDF 报价单转换成表格和结构化文档,再生成能回到原页核对的比较结果。 附带原始 PDF、脚本、导出文件和操作视频,读者可以从同一组输入重跑。
01这次具体解决什么问题
Docling 是开源文档解析工具,可以把 PDF 等格式转换为统一的文档表示,并导出 Markdown、JSON 等结果。它保留的内容包括文本、表格、文档层次,以及可用的版面和来源信息〔1〕〔2〕。
本文先完成一个小任务:找出两份报价的含税总价和交付周期,并保留出处。检查时关注四件事:表头与单元格有没有对应,单价与金额有没有混,税率和交期有没有漏,结果能不能找到原页。
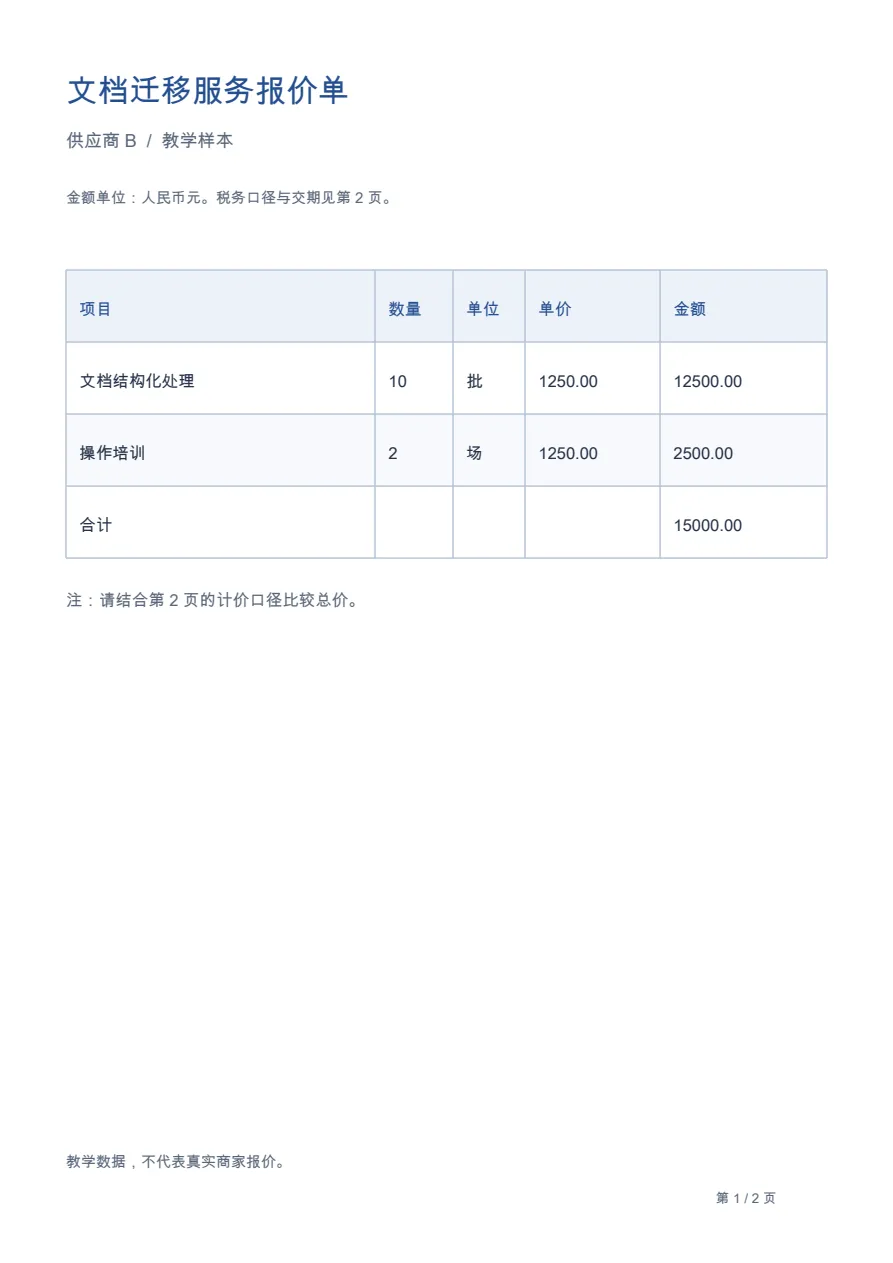
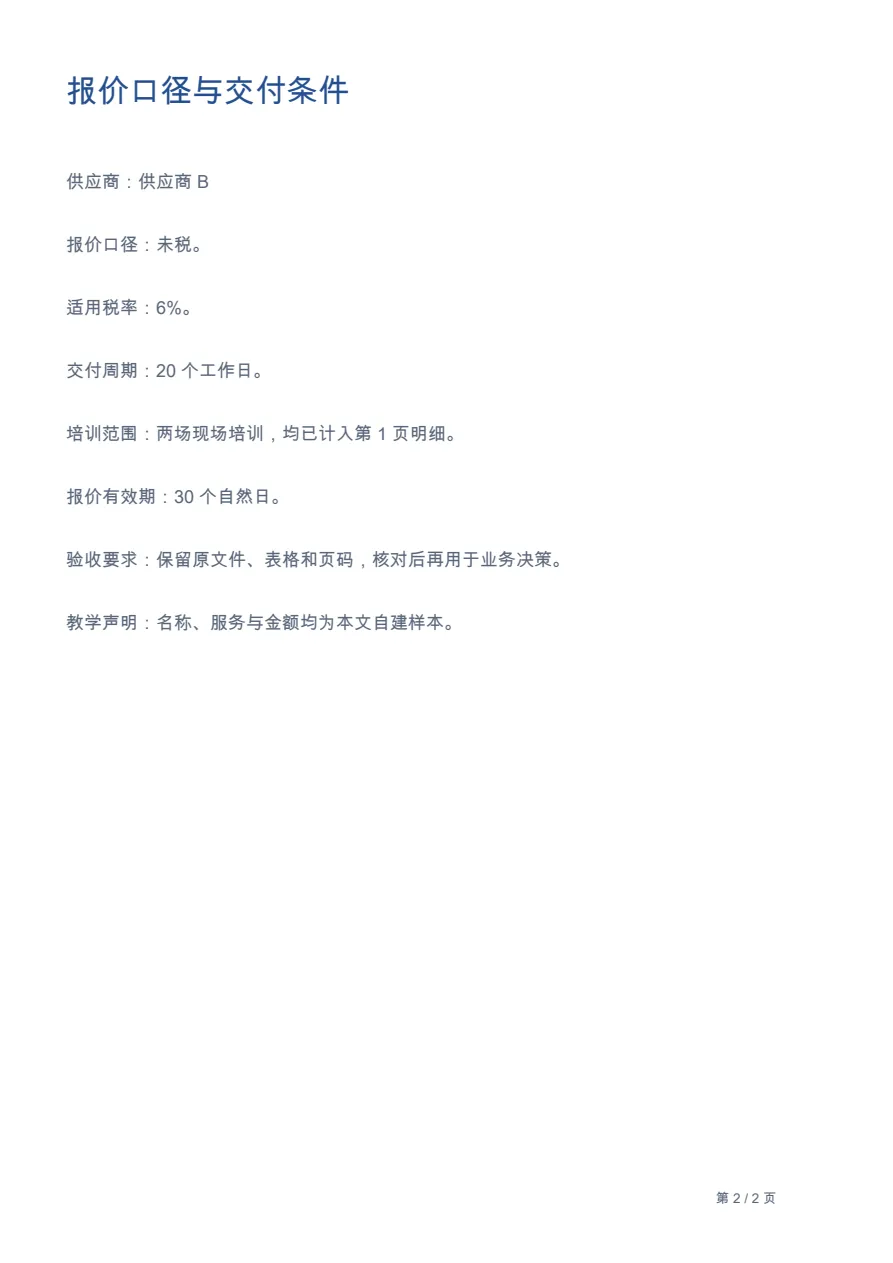
输入是两份各两页的自建教学报价单,另有一份 B 的纯图片扫描版。名称、服务和金额都是教学数据;第 1 页放服务明细,第 2 页放计价口径和交期。
先说明一个实际观察:这两份规整的文字 PDF,用普通文字提取也能读到大部分内容。Docling 在这里提供的是后续整理需要的表格对象、文档结构和来源信息;扫描版则需要另走 OCR。是否值得使用,取决于你后面要怎样处理这些资料。
02第一步:建立隔离环境,准备模型
先下载完整实践包,解压进入 docling-lab。里面已经有三份输入 PDF,不需要准备自己的业务文件。以下以 macOS/Linux、Python 3.11 和 uv 为例;未使用 uv 时,可按包内 README 的标准 venv 方式安装。
cd docling-labuv venv .venv --python 3.11uv pip install --python .venv/bin/python -r requirements.txt.venv/bin/python practice/prepare_models.py本次固定 Docling 2.151.1,实际运行环境是 macOS arm64、Python 3.11.13。安装脚本和依赖记录都在包里,后续命令统一使用这个虚拟环境里的 Python。
第一次使用要准备模型。本文的 prepare_models.py 只选择版面与表格相关资源,没有下载图片描述、公式识别或语音模型;本机模型目录约 674MB,包含预下载工具取得的相应后端资源。下载耗时与转换耗时应分开看。
官方支持先下载模型,再通过 artifacts_path 指向本地目录〔3〕。下面这条标准 PDF 管道使用本地模型,关闭远程模型服务;准备模型时仍需要访问下载站点。软件版本固定以后,也要留意模型资源是否变化,本文同时保留了本机文件摘要。
03第二步:先作文字对照,再导出结构
进入同一工作目录,执行普通提取对照,然后转换两份文字版 PDF:
.venv/bin/python practice/baseline.pyHF_HUB_OFFLINE=1 TRANSFORMERS_OFFLINE=1 \ .venv/bin/python practice/convert_quotes.py --models practice/models对照结果很明确:脚本按页去掉首尾空白后,两份文字版各得到 347 个字符,扫描版为 0;计数包含文本内部的空白。这个数字描述的是本文脚本的提取结果,不是 OCR 准确率。
转换脚本关闭 OCR,开启表格结构识别,以 CPU、4 线程运行。它把结果分别写到 practice/output/quote-a/ 和 quote-b/:
document.md # 阅读和检查转换内容document.json # 保存结构、单元格及可用来源信息table-1.csv # 表格原始导出table-1.html # 浏览器查看表格Markdown 便于快速阅读;CSV 便于后续计算;JSON 保留文档结构与来源。把它们一起保存,后面发现问题时才有检查依据。表格的 DataFrame/CSV 导出方式来自官方示例〔4〕。
本机这一轮首次顺序转换,A 约 4.24 秒,随后 B 约 1.58 秒,均为两页文件;第一份包含管道初始化。这只是这组小样本的记录,不含安装和模型下载,复杂文档还需单独测量。
04第三步:检查表头,别让漂亮的预览代替核验
这一步实际出了一个很有价值的问题。Markdown 表格看着正常,CSV 的列名却是数字:
0,1,2,3,4项目,数量,单位,单价,金额文档结构化处理,10,批,1250.00,12500.00操作培训,2,场,1250.00,2500.00合计,,,,15000.00真正的字段名称留在了第一行数据里。如果后续程序直接按“金额”列取值,就会失败。只检查 Markdown 排得好不好,会漏掉这个问题。
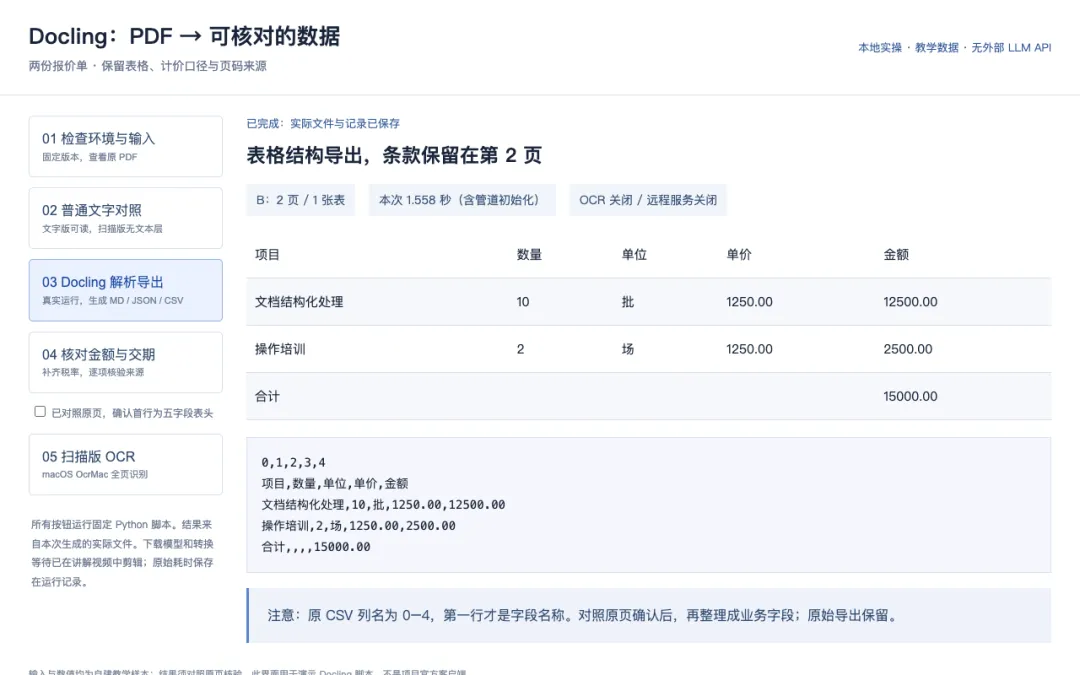
先运行核对命令,它会提示表头尚未确认:
.venv/bin/python practice/compare_quotes.py回到原 PDF 第 1 页,确认首行确实是“项目、数量、单位、单价、金额”,再明确执行:
.venv/bin/python practice/compare_quotes.py --accept-first-row-header.venv/bin/python practice/verify_results.py脚本只在首行严格符合这五个字段的约定时整理表头,并写出 checked-table.csv。原来的 table-1.csv 继续保留;遇到其他字段或行宽不一致,会停止处理。
转换完成以后,仍要检查你准备交给下一步的那一种格式。 表头、空单元格、合并单元格、小数点和漏行,都值得对照原页看一次。
05第四步:把税务口径和交期接回表格
表格整理完,还不能直接比较两张“合计”。A 的第 2 页写着含税,B 写着未税,适用税率都是教学设定的 6%;交期分别为 15 和 20 个工作日。
本文的核对脚本先检查“数量 × 单价 = 行金额”,再检查“明细之和 = 表内合计”。随后从解析出的条款里取得计价口径、税率和交期;缺失、重复或没有页码来源,都停止比较。
在已经人工确认人民币元、服务范围一致的这个样例里,结果是:
B 的 15000 × 1.06 = 15900,与 A 相差 100 元;A 的交付周期短 5 个工作日。选择哪一家,还要结合完整条款、服务质量和实际需求判断。
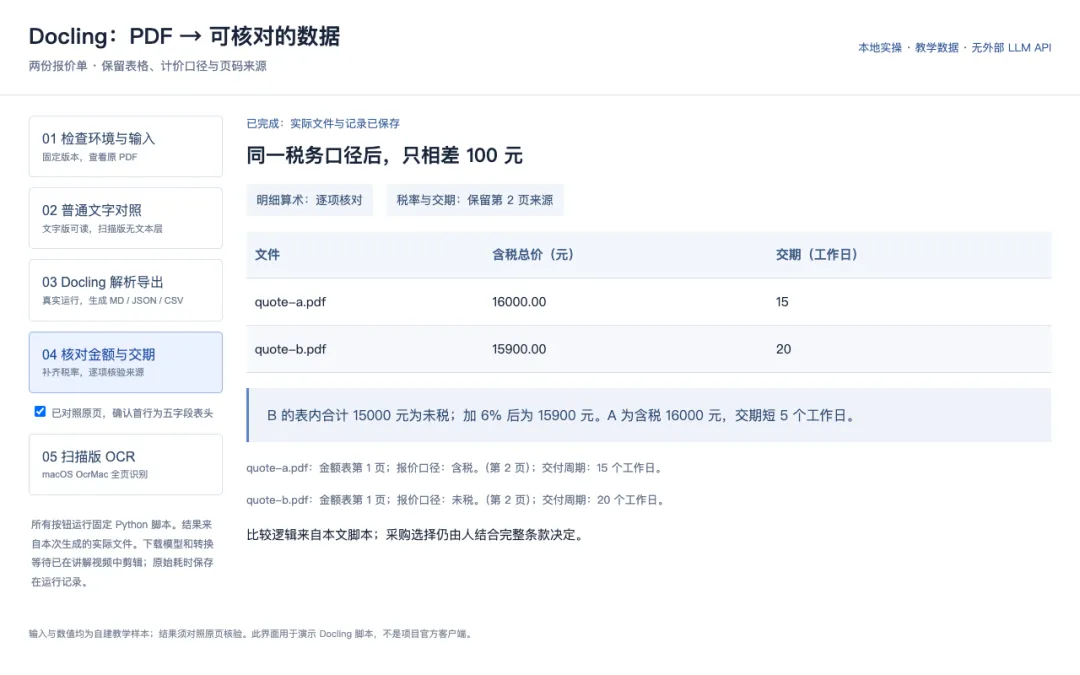
这里有清楚的分工:Docling 负责文档解析,本文脚本负责约定字段与算术核对,业务选择留给人。这份脚本只针对已确认币种、服务范围和五字段结构的教学样例;真实报价的折扣、运费、阶梯税率与额外条款,需要另行建规则。
为了验证检查确实会拦住问题,我还故意改坏一行金额,并删除计价口径。两种情况都被拒绝,记录保存在 practice/output/verification.json。
06第五步:扫描件单独开启 OCR
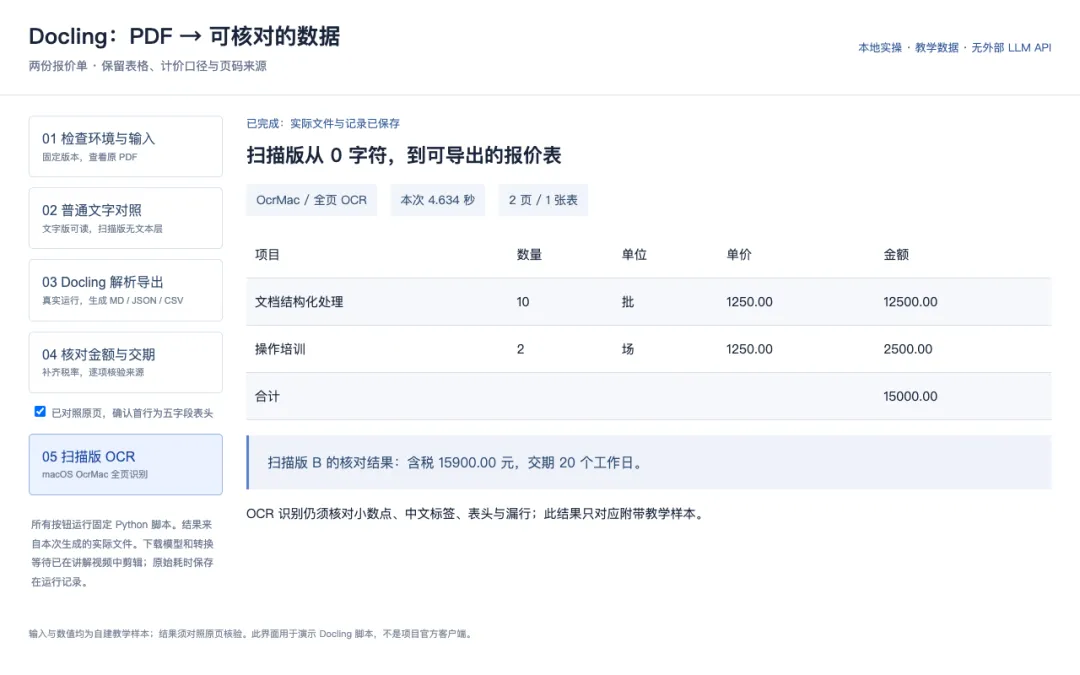
如果 PDF 没有文本层,就需要文字识别。本文把 B 的两页渲染成图片,再放回 PDF;普通提取为 0 字符,明确构成扫描版对照。
本机使用 macOS 的 OcrMac,全页识别语言为 zh-Hans 和 en-US。这一支路需要额外安装依赖,其他平台应按官方 OCR 文档选择适合的引擎〔5〕:
uv pip install --python .venv/bin/python "docling[ocrmac]==2.151.1"HF_HUB_OFFLINE=1 TRANSFORMERS_OFFLINE=1 \ .venv/bin/python practice/convert_quotes.py --models practice/models --scan.venv/bin/python practice/compare_quotes.py --scan --accept-first-row-header.venv/bin/python practice/verify_results.py这次扫描版第一次转换约 12.56 秒,金额、税务口径和交期与文字版关键字段一致;原页中的部分空格呈现有所变化。结果只说明这份清晰教学样本通过了核对,不能推算成所有扫描件的准确率。
07操作视频:从原页到比较结果
下面的视频包含五步实际操作:检查环境和原文件、查看文字提取对照、运行 Docling 导出、确认表头并核对金额、处理扫描版。安装与预下载命令可按上文和实践包 README 执行。
也可以直接打开操作视频。想自己操作界面,在实践包目录运行:
.venv/bin/python practice/serve_demo.py --models practice/models浏览器打开 http://127.0.0.1:8769/practice/demo.html,按顺序点击。第 4 步前先对照原页,勾选“确认首行为五字段表头”;转换和核对的文件都会保存在 practice/output/。关闭终端里的服务可用 Ctrl+C。
08结果准备交给知识库之前,还缺什么
完成这次练习以后,我更关心的是每个数字带着什么条件进入下一步。15000 旁边如果没有未税口径、币种、项目范围和来源页码,后续回答即使流畅,也可能沿着错误的前提继续计算。
因此,我会同时保存原 PDF、输入文件摘要、Docling JSON、原始表格、核对后的表格,以及整理规则。规则变更、输入替换或模型资源更新,都有线索可查。
如果接下来做 RAG,可以从这些结构化结果继续分块和建立索引。Docling 官方提供基于文档结构的分块能力〔6〕;本文做到解析与字段核对,没有把向量库、问答和引用质量宣称为已经验证。
对于只需要提取几段干净文字的资料,普通提取可能已经够用。需要处理表格、扫描件、章节关系,或希望后续能回到原页核对时,再评估 Docling 的安装、模型和处理成本。
这次练习带给我的变化,是给“文档处理完成”增加了几个具体条件:结构能检查,业务口径能说明,来源能找到,异常能停住。做到这些,资料才逐步成为下一项工作的可信输入。
09来源与实践附件
〔1〕Docling 官方仓库:项目能力、安装入口与许可说明。代码采用 MIT,模型使用许可需按各自资源核对。
〔2〕DoclingDocument:统一文档表示、层次、版面和来源信息。
〔3〕模型预下载与本地使用:本地模型目录和远程服务选项。
〔4〕官方表格导出示例:DataFrame、CSV 和 HTML 导出。
〔5〕全页 OCR 示例及安装说明:OCR 后端与可选依赖。
〔6〕结构化分块:后续知识库准备的方法入口。
附件:实践包、文字版核验记录、扫描版核验记录、视频字幕。