ARTICLE · 1054639
喂了9代自己的数据,AI彻底疯了!Nature重磅:千亿模型遭遇致命“近亲繁殖”
给一个 AI 输入一段关于“中世纪教区教堂建筑”的历史考证,让它续写。
然后,把它的输出当成教材,喂给第二代 AI;再把第二代的输出,喂给第三代……
如此循环迭代到第 9 代,令人毛骨悚然的事情发生了。
这台原本满腹经纶的 AI,突然把中世纪的古老石砖、飞扶壁和尖顶通通抛到了九霄云外,开始像梦呓一般疯狂复读:
“……黑尾长耳大野兔、白尾长耳大野兔、蓝尾长耳大野兔、红尾长耳大野兔、黄尾长耳大野兔……”
这出荒诞而真实的退化推演,出自牛津大学与剑桥大学顶尖学者联手完成的一项严肃实验。
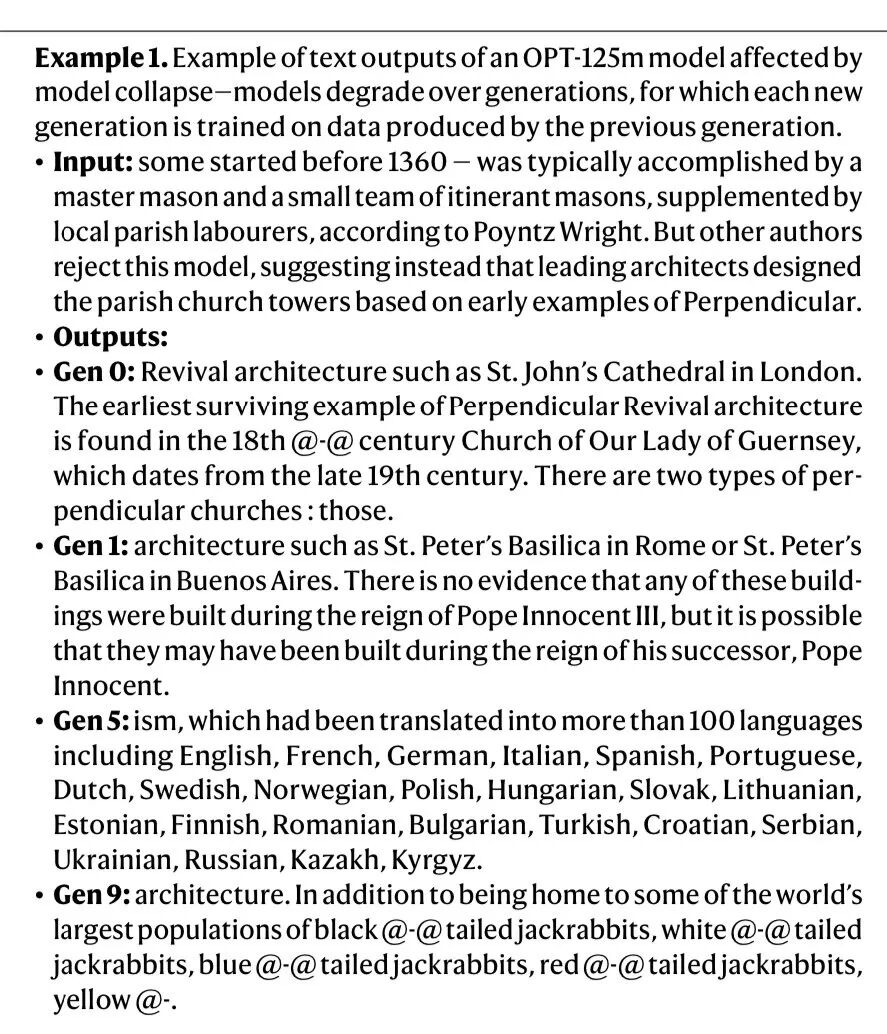
▲ 论文中最震撼的实验截图:从严谨的教堂建筑史,退化到荒诞的“彩色大野兔”
国际顶级科学期刊《自然》(Nature)正式刊登了这篇重磅封面级研究,标题只有冷冰冰的一句话:
《AI 模型在递归生成的数据上训练时会发生崩溃》。
▲ Nature 官方刊发论文页面
一个横亘在整个人工智能行业面前的恐怖真相,被血淋淋地撕开了:
当 AI 开始吞食 AI 自己制造的内容,文明的数字大脑,就会患上不可逆的“自噬性脑死亡”。
消失的山脚:AI 是如何一步步吃傻自己的?
牛津大学计算机系的 Yarin Gal 教授和共同一作 Ilia Shumailov,给这种现象起了一个极为冷峻的名字,模型崩溃(Model Collapse)。
▲ 研究团队早在预印本阶段就指出了“递归的诅咒”
为什么庞大如千亿参数的模型,一旦开始“自给自足”,就会迅速变蠢?
我们可以把人类数千年沉淀下来的全部语言与知识,想象成一座巍峨的高山:
- 山顶
,是那些最常见、最主流、概率最高的表达。比如“今天天气不错”、“苹果是水果”、“因为所以”。 - 山脚与山谷
,则是广袤无垠的长尾分布(Tails)。那里藏着极其小众的方言、冷门的物理公式、刁钻的哲学思辨、前卫的诗歌、哪怕是一段只有三五个人知晓的中世纪冷门野史。
大语言模型(LLM)的本质,是一个超级概率采样机器。它在生成文本时,天生就更喜欢在“山顶”附近打转。
当第 1 代 AI 产出内容时,山脚下的罕见知识点,就已经被它漏掉了一部分;
第 2 代 AI 拿着这批二手语料去学习,由于统计误差与模型表达局限,它会把上一代的“平均水平”误当成世界的全部,于是山顶被进一步拔高,山脚被大面积铲平;
一代又一代递归下去,误差像滚雪球一样无限放大。
这就是早期模型崩溃(Early Model Collapse):罕见但至关重要的信息,最先在数字世界中彻底灭绝。
而到了晚期模型崩溃(Late Model Collapse),整座高山甚至退化成了一个极端狭窄的“尖刺”,AI 彻底丧失了理解复杂世界的能力,输出方差极速收敛,最终只能吐出诸如“五彩斑斓的大野兔”这种毫无逻辑的胡话。
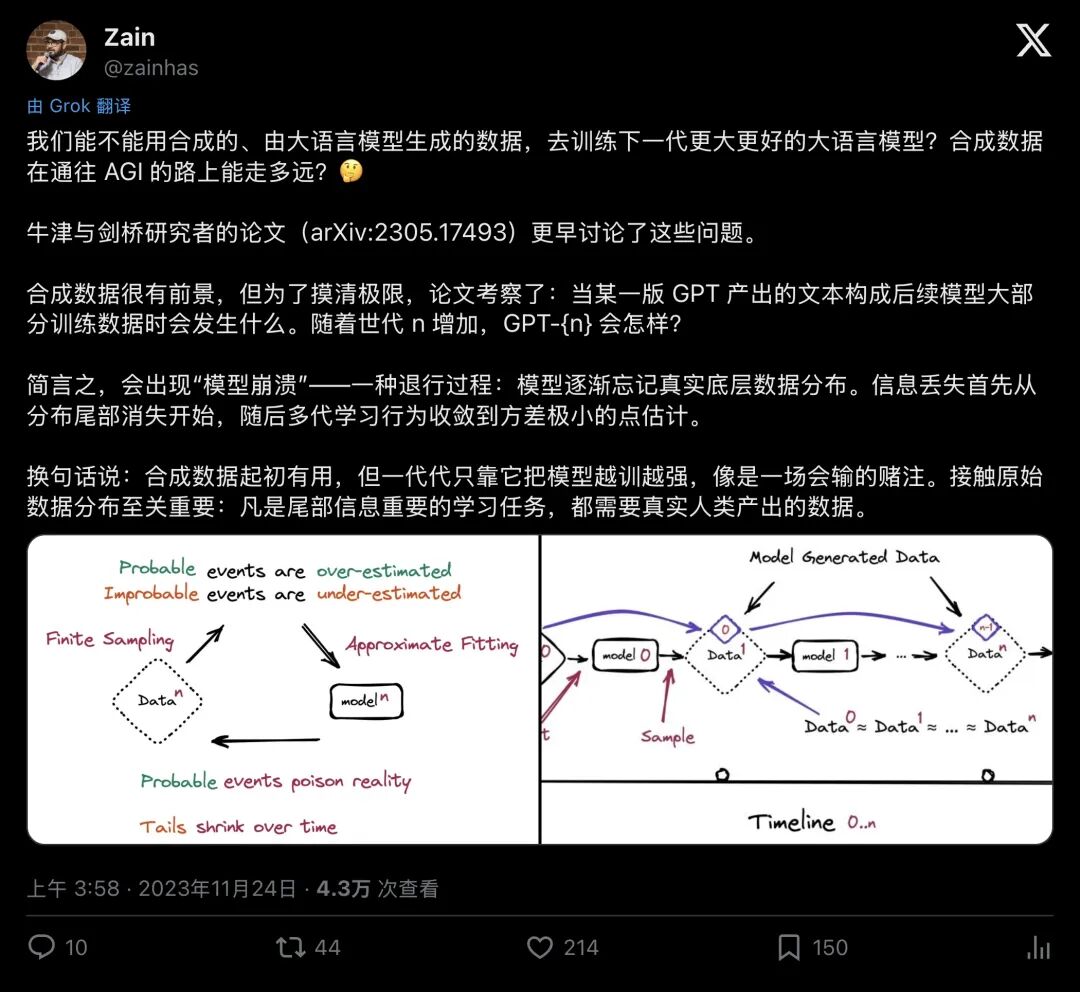
▲ 早期科普贴精准点出了长尾分布消失与点估计收敛的本质
另一篇来自莱斯大学的平行研究甚至直接将这种绝症命名为 MAD(Model Autophagy Disorder,模型自噬综合征)。
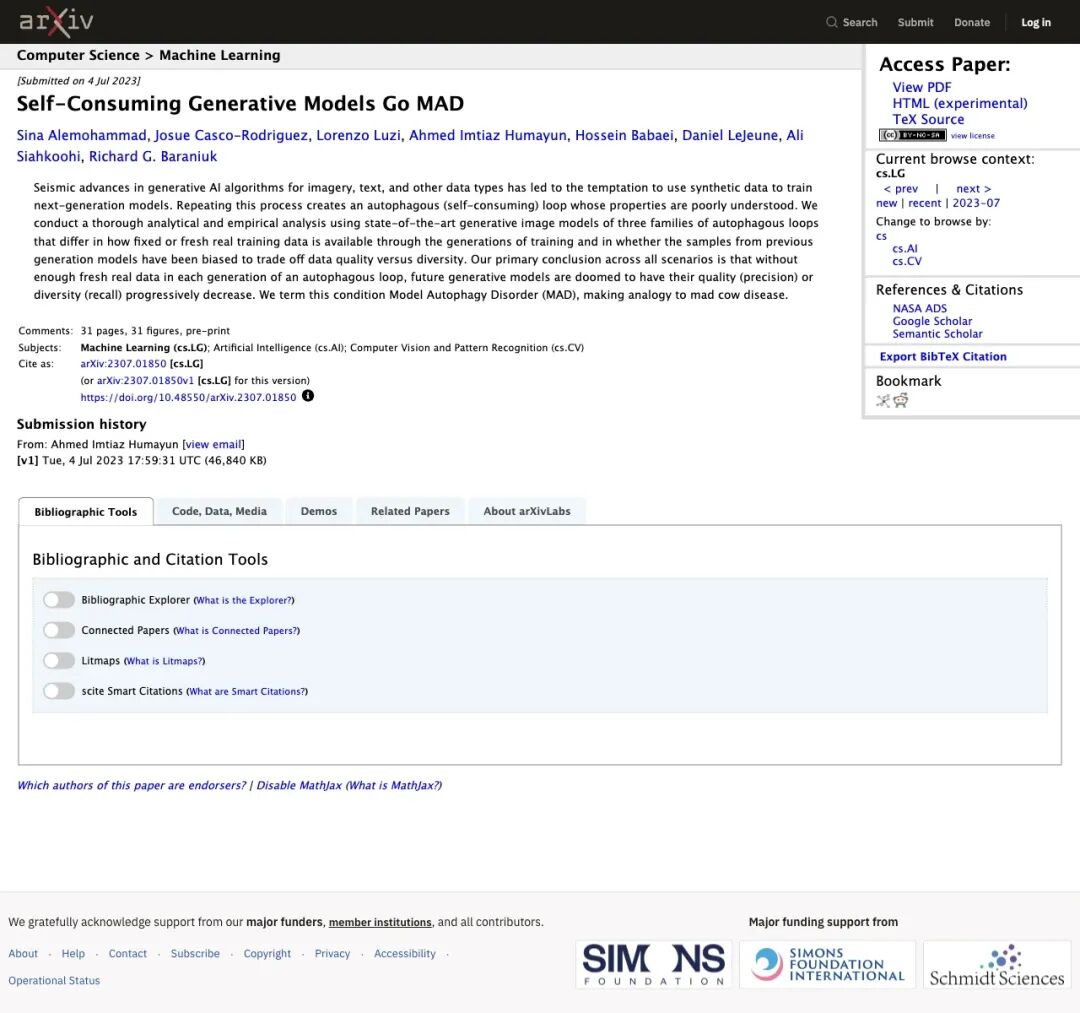
▲ 图像生成领域的自吞噬研究指出:没有新鲜真实数据,模型必将走向退化
这正如一条咬住自身尾巴的贪吃蛇,不断吞下从自己体内排出的残渣,最终将整个躯体拖入虚无。
74% 互联网已带毒!全网正在沦为“AI 排泄场”
有人或许会问:实验室里的递归实验很极端,现实中哪有那么巧,AI 偏偏会去吃自己上一代拉出来的文字?
现实,比实验室里的推演残酷十倍
全球著名 SEO 与数据分析机构 Ahrefs 发布了一份令人触目惊心的检测报告:
他们抓取并分析了全网约 90 万个全新英文网页,结果发现:高达 74.2% 的页面,都含有 AI 生成的内容!
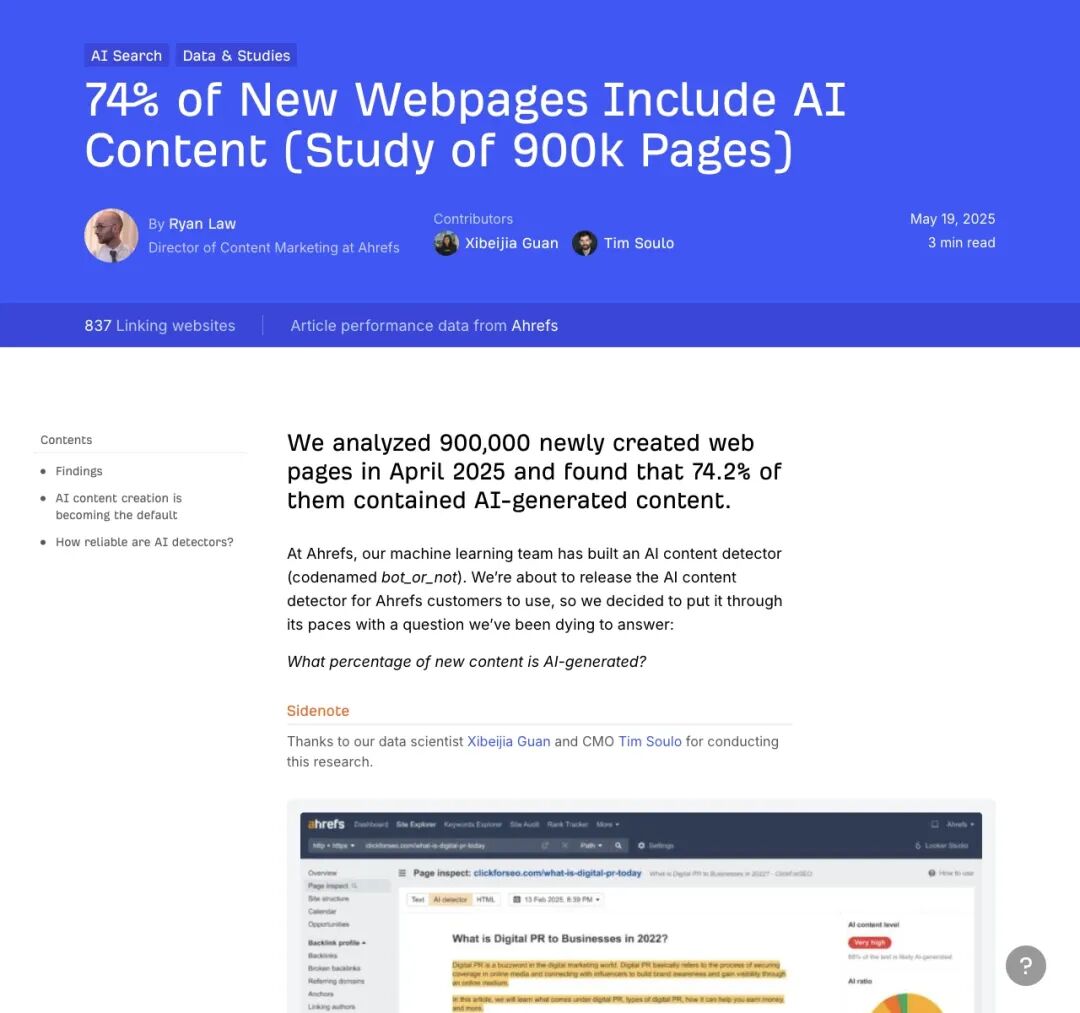
▲ Ahrefs 调查报告:超过七成的新建网页已被 AI 内容渗透
如今,一键生成文章的插件已经塞满了每一个自媒体后台、营销机构和问答社区。铺天盖地的营销号短文、自动生成的伪原创快讯、流水线生产的代码注释,正在以每天数以亿计的恐怖速度,污染着整个互联网公海。
曾经清澈的人类知识海洋,在短短两三年内,迅速被稀释成了一汪浮满合成垃圾的浑水。
下一代大模型已经无路可逃
当科技巨头的爬虫再次撒向全网抓取训练语料时,人类千百年来凝练的智慧结晶早已被稀释殆尽,取而代之的是上一代 AI 互相洗稿、反复反刍出来的海量“数字塑料”。
知识的熵增,正在以指数级失控
2.5 亿美元抢购旧报纸:巨头们在恐慌什么?
当普通人还在为 AI 的“文采斐然”惊叹时,大洋彼岸那些最敏锐的科技巨头,早已冷汗直流。
他们不仅早就意识到了“模型自噬”的致命威胁,更在私下打响了一场惊心动魄的“纯净数据抢夺战”。
2024 年 5 月,OpenAI 突然豪掷重金,与传媒巨头新闻集团(News Corp)签下一份为期五年、总金额超过 2.5 亿美元(约合 18 亿人民币)的惊天协议。
这笔巨资买下的核心资产,正是《华尔街日报》、《泰晤士报》等传统媒体在档案馆里沉淀了数十年的历史报纸底稿。
紧接着,Reddit、Stack Overflow、各大老牌出版机构……这些过去被视为“古典互联网遗迹”的平台,其历史数据瞬间被炒成了天价。
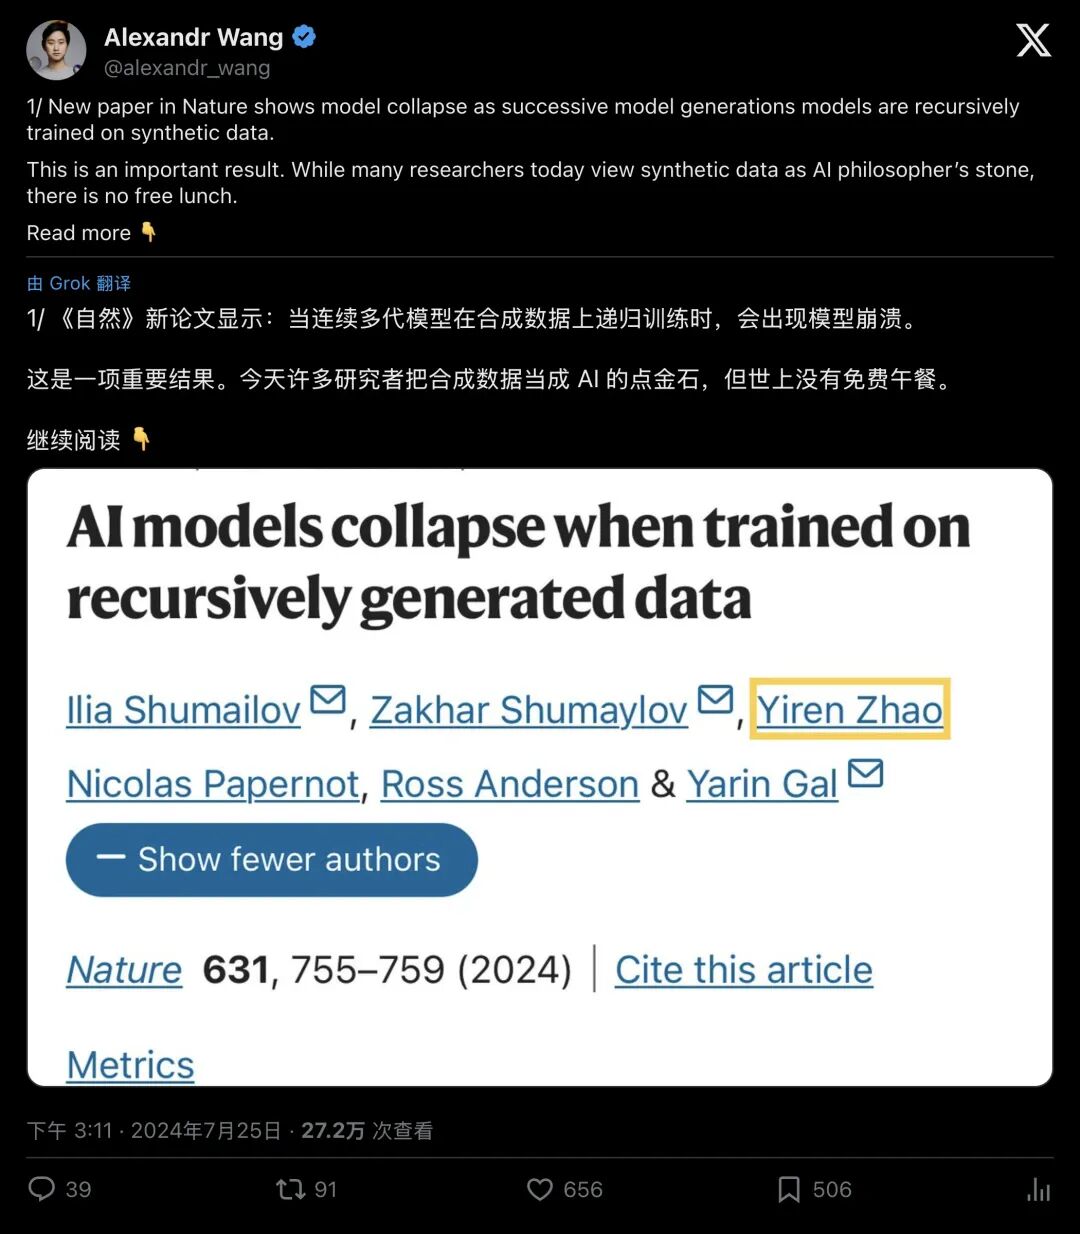
▲ 数据标注独角兽 Scale AI 创始人 Alexandr Wang 警告:纯合成数据绝非点金石
为什么那些几十年前的旧报纸突然价值连城?
因为在模型崩溃的阴影下,所有人终于看懂了这一底层逻辑:
2022 年以前、未经 AI 污染的人类原生写作,已经成为了这个星球上无法再生的“数字黄金”。
Nature 论文作者特别指出了一种残酷的“先发优势”(First-mover Advantage):
那些在互联网被 AI 大规模污染之前,就已经完成海量高质量人类数据清洗和预训练的巨头,手中握着后来者永远无法复制的护城河。
后入场的创业者哪怕算力再充沛、资金再雄厚,只要他们面对的是一个充斥着 74% 合成垃圾的受污染网络,就极有可能在一遍遍递归训练中坠入模型崩溃的深渊。
解药是什么?人类不可替代的终极注脚
这场席卷整个人工智能底层的“近亲繁殖危机”,真的无解吗?
牛津与剑桥的科学家在论文的消融实验中,给出了一个极具戏剧性的关键数字:10%。
如果在每一代 AI 训练时,哪怕仅仅强制保留 10% 来自真实人类的高质量数据作为锚点,模型的退化就会被大幅遏制,整体任务表现仅出现微弱下滑。
这 10% 的人类真实数据,就像是注入干涸机体的新鲜血液,是防止整个知识大厦坍塌的定海神针。
Scale AI 创始人 Alexandr Wang 随后也发文呼吁:
行业必须抛弃“用纯合成数据实现无限自我进化”的幼稚幻想。切实可行的破局路径,唯有 混合数据(Hybrid Data),必须将合成样本与真实世界的种子、人类专家的深度交互、以及严密的逻辑验证系统死死绑定在一起。
一旦脱离真实世界的物理反馈,缺失人类有血有肉的情感体验与偶发灵感,AI 内部无论如何做数学矩阵运算,都无法凭空产生关于这个世界的“新信息”。
未被污染的人类灵光,才是终极奢侈品
回到最初那个荒诞的故事
中世纪巍峨庄严的教区教堂,为什么会在 9 代之后退化成五颜六色的长耳大野兔?
AI 本身既缺乏信仰与敬畏,也无法体悟岁月沉淀下的历史沧桑。它所拥有的,不过是冷冰冰的概率矩阵与词向量转移。
当它脱离了人类鲜活的生活实践,开始闭门造车地复述自己编造的谎言时,虚无便成了它唯一的终点。
这项轰动学界的 Nature 研究,给狂热的 AGI 淘金热泼下了一盆最清醒的冷水:
AI 可以无限扩充算力,可以秒级生成亿万文字,但它永远无法取代人类写作中最幽微、最独特、最不可预测的灵光一现。
在合成垃圾即将淹没互联网的未来,你写下的每一句带有人性温度的真诚思考,每一次源于真实生活的欢笑与落泪,不仅不会被 AI 淘汰,反而正在成为这个数字时代最稀缺、最昂贵的资产。
因为,那是拉住 AI 不滑向疯狂深渊的,最后一根绳索。