ARTICLE · 1055610
从 PDF、网页到知识库问答|GitHub 本周 8 个开源 RAG 项目分享
很多人第一次接触知识库,会以为它只是“上传一个 PDF,然后让 AI 回答问题”。
但一个真正可用的知识库,通常要经过资料解析、内容清洗、切分、向量化、检索、排序,最后才交给模型生成答案。
RAG 的核心,不是让模型记住更多,而是在回答前帮它找到更准确的资料。
本期挑选 8 个开源项目,覆盖从 PDF、网页资料处理,到知识库构建、向量检索和智能问答的完整链路,仓库地址见文末。
01|Tencent/WeKnora:把文档变成可以持续更新的知识库
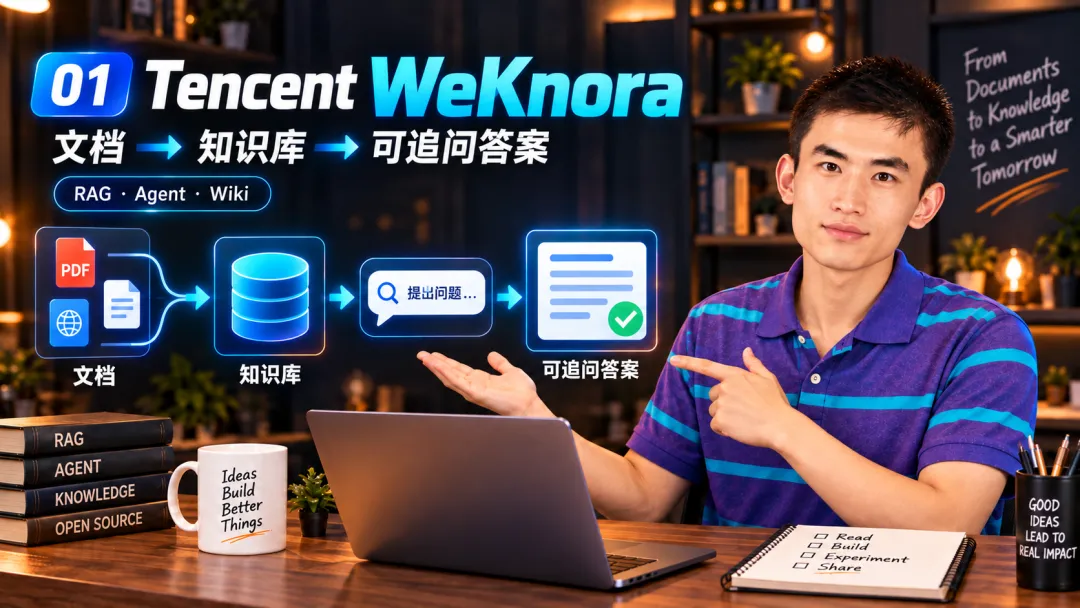
WeKnora:文档到知识库问答
它是啥
WeKnora 是腾讯开源的 LLM 知识平台,目标是把原始文档转化为可查询的知识库。
它不只是做简单的“文档问答”,还集成了 RAG 检索、Agent 推理、知识库管理和自动 Wiki 等能力。
有什么用
你可以把企业制度、产品手册、项目文档、会议资料等内容放进系统,然后通过自然语言进行查询。
它支持:
文档上传与知识库管理
混合检索和 RAG 问答
Agent 推理
知识库内容持续维护
Wiki 页面生成与管理
面向 AI Agent 的 MCP 接入
如果你想做一个比较完整的企业知识库,WeKnora 更接近“开箱即用的平台”,而不是单一组件。
适合什么场景
企业内部知识库、团队文档问答、产品资料检索,以及希望把知识库和 Agent 结合起来的开发者。
02|infiniflow/ragflow:更擅长处理复杂文档
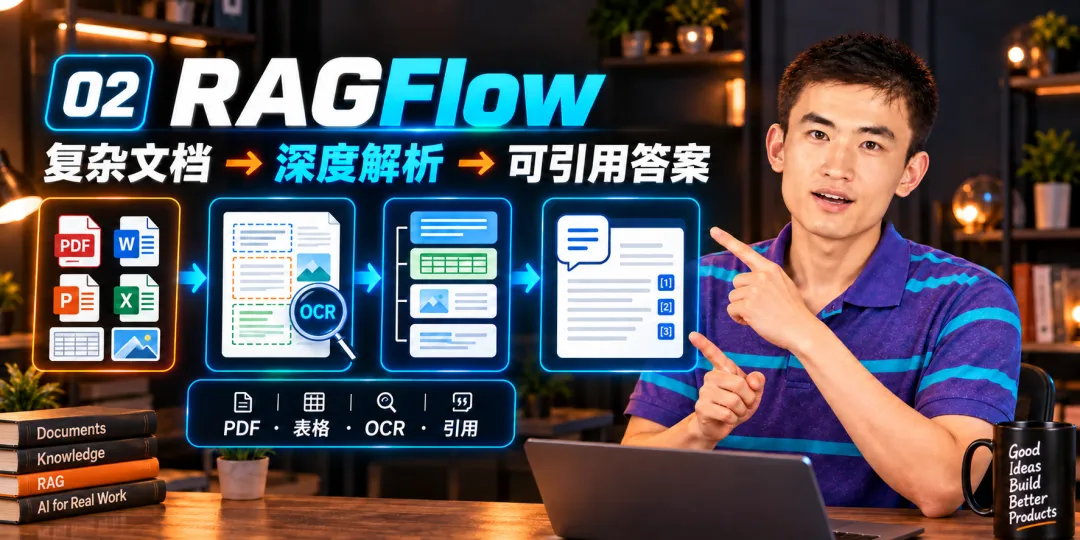
RAGFlow:复杂文档理解
它是啥
RAGFlow 是一个基于深度文档理解的开源 RAG 引擎。
它的重点不是简单地把文字切成一段一段,而是尽量理解文档中的标题、段落、表格、图片、页码和阅读顺序。
有什么用
对于普通的纯文本资料,简单的向量检索通常已经够用。
但遇到下面这些文件时,处理难度会明显增加:
带复杂排版的 PDF
合同和规章制度
包含大量表格的报告
带图片和扫描页的文档
PPT、Excel、Word 等办公文件
RAGFlow 通过文档解析、OCR、版面分析和表格识别,把复杂资料转换成更适合检索的内容。
它还支持知识库、引用溯源、问答助手和 Agent 工作流。
RAGFlow 解决的是“资料已经上传了,但 AI 读不懂”的问题。
适合什么场景
需要处理大量专业文档、合同、技术资料、研究报告和企业档案的团队。
03|microsoft/markitdown:先把各种文件变成 AI 能读懂的 Markdown
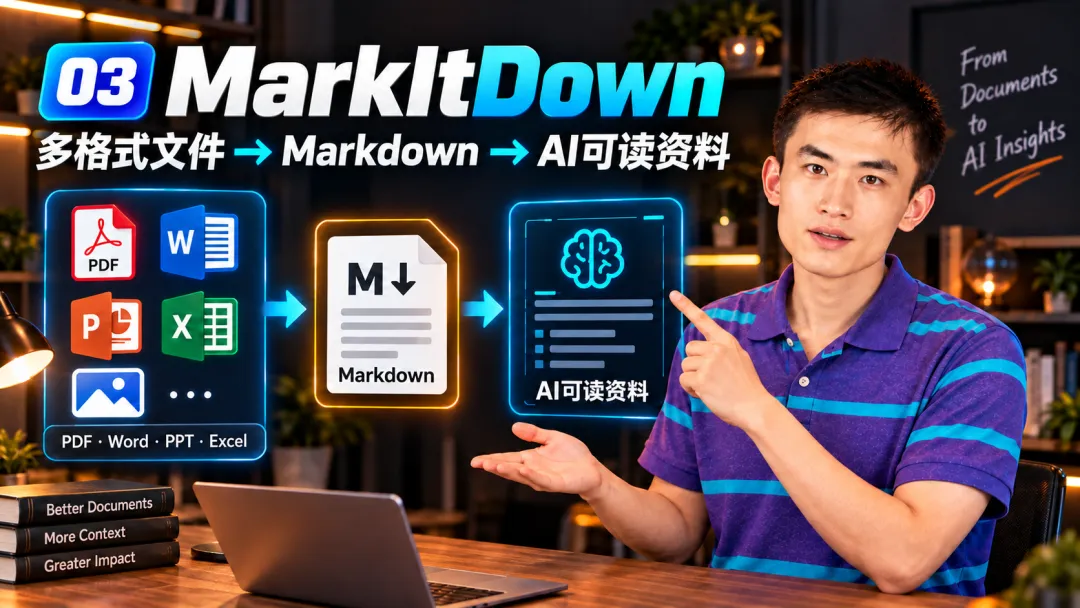
MarkItDown:多格式文件转 Markdown
它是啥
MarkItDown 是微软开源的文件转换工具,主要用于把各种文件转换成 Markdown。
它支持 PDF、Word、PowerPoint、Excel、图片、HTML、CSV、JSON、XML、音频、EPUB 和 YouTube 内容等格式。
有什么用
很多知识库项目的问题,并不一定出在模型,而是出在资料进入系统之前。
如果原始文件结构混乱,标题、表格和正文没有被正确提取,后面的检索效果就会变差。
MarkItDown 可以把不同格式的资料统一转换成更适合大模型处理的 Markdown 文本。
它不是一个完整的知识库,而是知识库前面的“资料预处理工具”。
适合什么场景
批量处理办公文件、搭建文档问答系统,或者把本地资料统一转换为文本格式。
04|firecrawl/firecrawl:把网页变成干净的知识来源
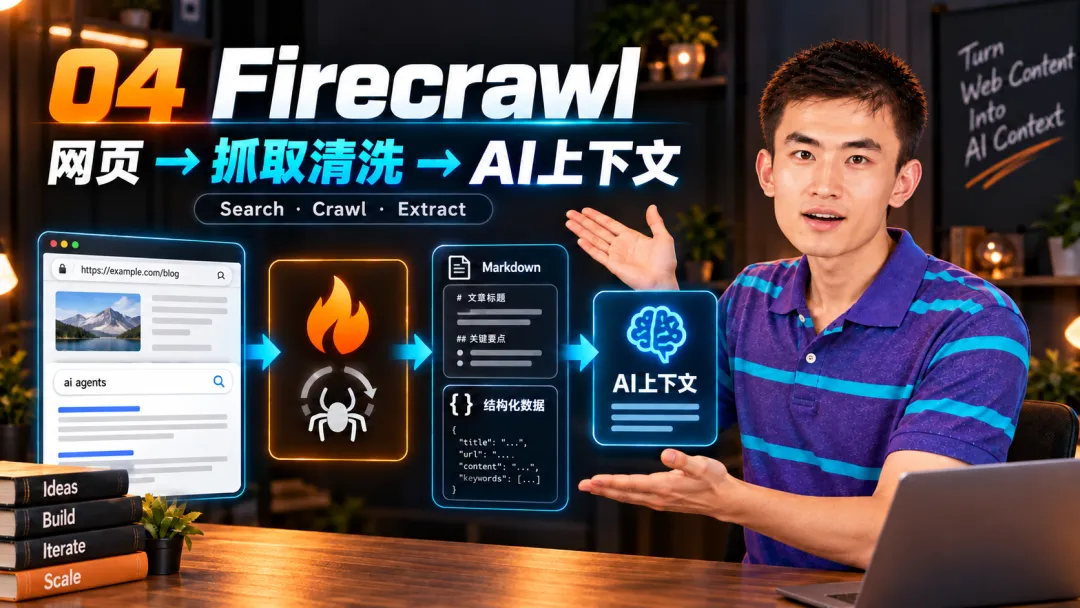
Firecrawl:网页抓取与清洗
它是啥
Firecrawl 是一个面向 AI 的网页数据工具,可以把网页抓取、清洗,并转换成 Markdown 或结构化数据。
它提供搜索、抓取、爬取、网页地图和内容提取等能力。
有什么用
如果你想让 AI 查询实时网页内容,首先要解决的不是“怎么问”,而是“怎么把网页内容拿回来”。
普通网页往往包含导航栏、广告、评论区、推荐内容和动态脚本等无关元素。
Firecrawl 会尽量把网页中的主要内容提取出来,整理成适合大模型使用的上下文。
它可以用于网站资料采集、企业竞品监测、行业信息整理、网页知识库构建、AI 搜索和深度研究。
Firecrawl 不是负责回答问题的模型,而是负责把互联网资料送到模型面前。
适合什么场景
AI 搜索、网页问答、研究助手、竞品分析和实时知识库。
05|run-llama/llama_index:自己搭建 RAG 应用的开发框架
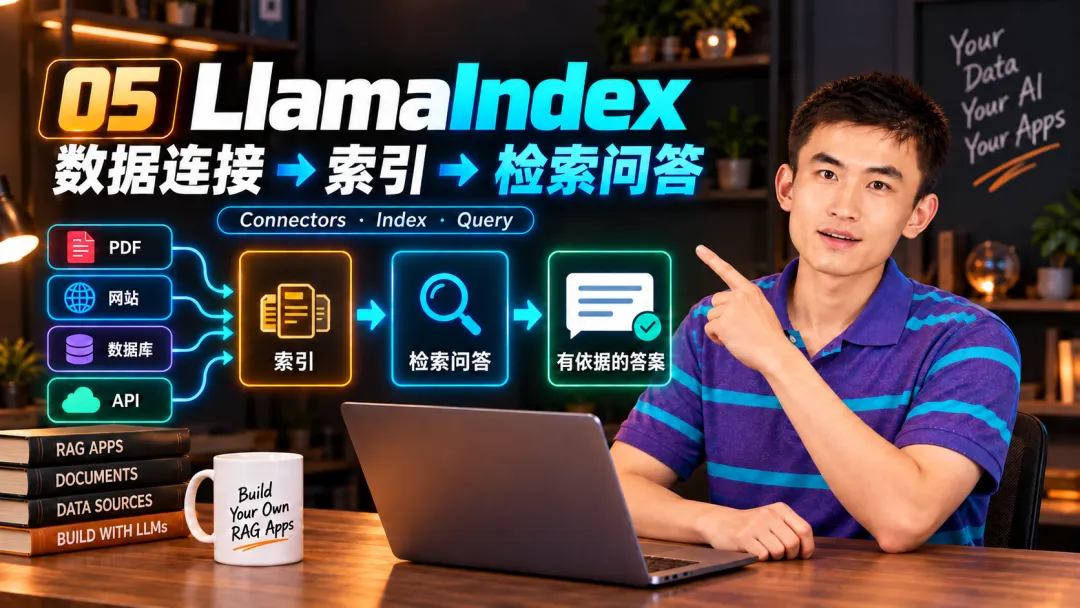
LlamaIndex:数据连接与检索问答
它是啥
LlamaIndex 是一个面向大模型应用的数据框架,重点解决“如何把自己的数据接入大模型”。
它提供数据连接器、索引、检索器、查询引擎和 Agent 等组件。
有什么用
你可以使用 LlamaIndex 接入 PDF 和 Word 文档、网页资料、数据库、API、本地文件和企业内部系统。
然后自己组合出文档问答、企业知识库、研究助手、数据分析助手、多文档对比等应用。
LlamaIndex 的特点是可组合性比较强。你可以使用高层接口快速做出原型,也可以深入调整数据读取、索引、检索和排序过程。
如果 WeKnora 更像完整产品,LlamaIndex 更像一套用于开发知识库应用的工具箱。
适合什么场景
想自己控制 RAG 流程、开发定制化 AI 应用,或者需要连接多种数据源的开发者。
06|deepset-ai/haystack:用模块化流程搭建生产级 RAG
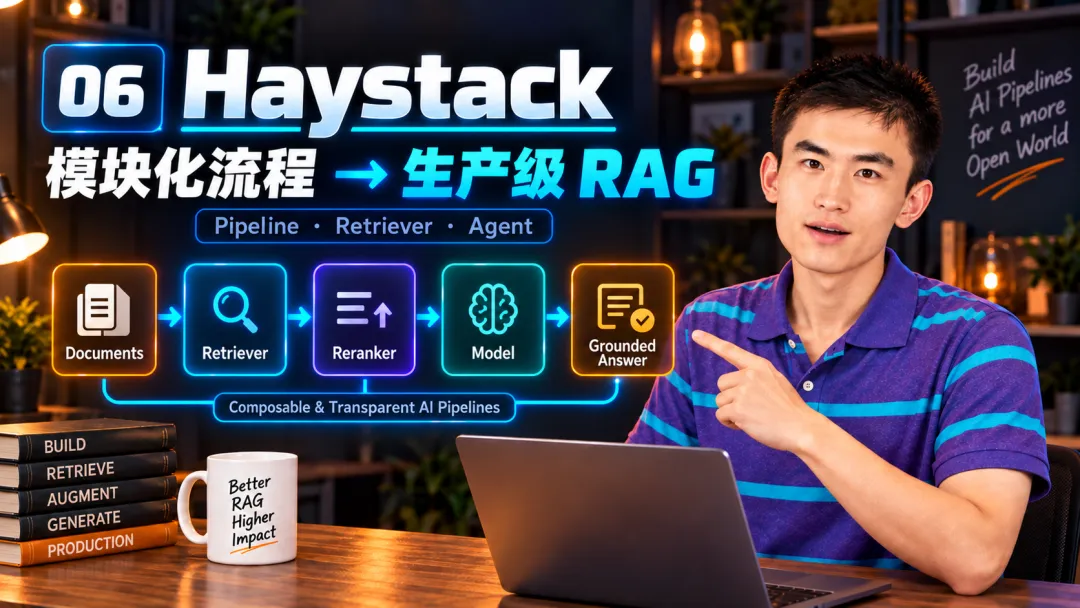
Haystack:模块化 RAG 流程
它是啥
Haystack 是一个开源 AI 应用框架,支持 RAG、文档搜索、问答、Agent 和多模态检索。
它的核心思想是把一个 AI 应用拆成多个清晰的组件,再通过流程把它们连接起来。
有什么用
在 Haystack 中,你可以组合文档读取组件、文本切分组件、嵌入模型、向量数据库、检索器、重排序器、大语言模型和 Agent 工具。
这样做的好处是,每一个环节都可以单独替换和调试。
比如你可以更换模型、调整检索方式,或者在生成答案前增加过滤、排序和审核步骤。
Haystack 更适合那些希望把 RAG 流程拆开看清楚,并且长期维护系统的人。
适合什么场景
企业级 AI 应用、生产环境知识库、需要精细控制流程的团队和开发者。
07|qdrant/qdrant:专门负责保存和检索向量
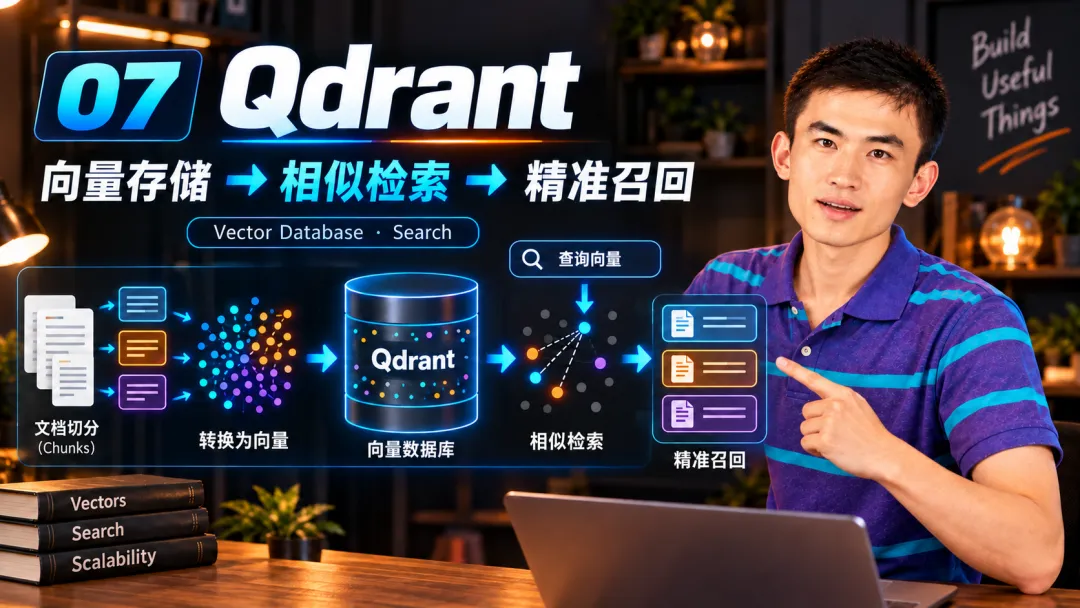
Qdrant:向量存储与相似检索
它是啥
Qdrant 是一个开源向量数据库,也是很多 RAG 系统中的基础组件。
在知识库中,文档通常会先被切分成多个片段,再通过嵌入模型转换成向量。
Qdrant 的作用,就是保存这些向量,并根据用户的问题找到语义上最相关的内容。
有什么用
Qdrant 可以用于语义搜索、文档相似度检索、图片和多模态检索、推荐系统、RAG 知识库,以及带条件过滤的向量搜索。
它还支持元数据过滤,可以在搜索时加入部门、时间、权限和文档类型等条件。
Qdrant 不负责解析文档,也不负责生成答案,它专注于把相关资料快速找出来。
适合什么场景
需要自己搭建 RAG 后端、语义搜索系统和大规模向量检索服务的开发者。
08|open-webui/open-webui:直接体验本地知识库问答
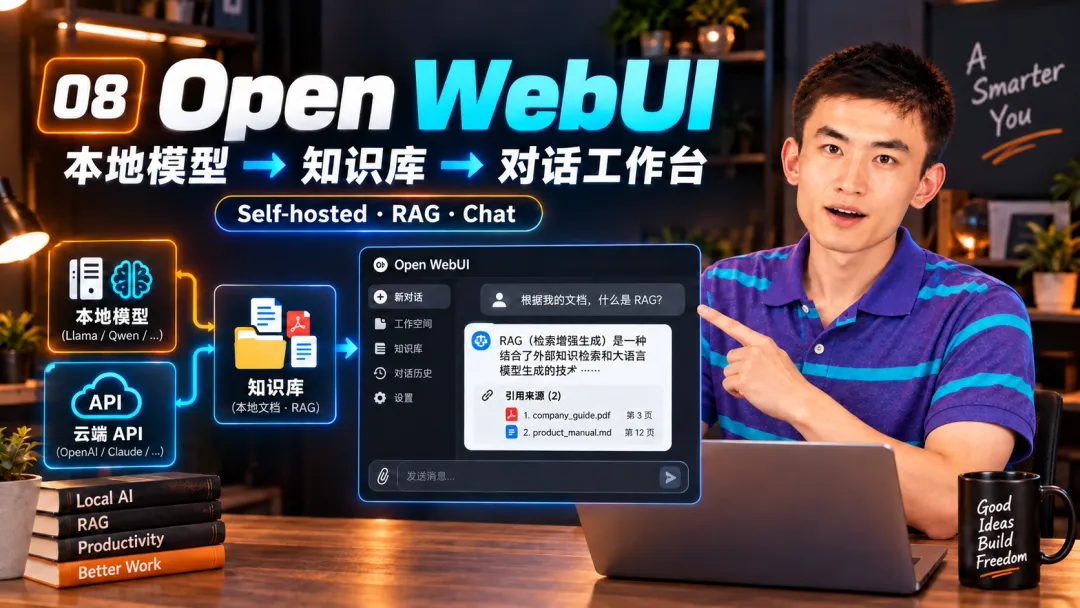
Open WebUI:本地模型与知识库工作台
它是啥
Open WebUI 是一个可以自托管的 AI 平台,支持连接本地模型和兼容 OpenAI 接口的云端模型。
除了聊天功能,它还提供知识库、文件问答、网页搜索和 RAG 能力。
有什么用
你可以在 Open WebUI 中上传 PDF、Word 等文档,创建可重复使用的知识库,让模型基于指定资料回答问题,也可以连接本地模型和多个向量数据库。
它的优势是界面比较完整,不需要从零开始开发聊天页面和知识库管理页面。
如果你想快速体验“把自己的资料交给 AI 查询”,Open WebUI 是这 8 个项目中上手感比较直观的一个。
适合什么场景
个人本地 AI、团队内部问答、企业知识库原型和 AI 工作台。
Agent 的分水岭,是能不能留下可检查的结果
这 8 个项目可以分成四层:MarkItDown 和 Firecrawl 负责准备资料,RAGFlow 和 WeKnora 负责构建知识库,LlamaIndex 和 Haystack 负责开发应用,Qdrant 负责向量检索,Open WebUI 则负责把问答体验呈现出来。
从这条链路看,RAG 并不是某一个单独的软件,而是一套从资料进入、内容处理、检索召回到答案生成的完整系统。
真正值得关注的,不是哪个项目的介绍最漂亮,而是它能不能把资料、检索和答案之间的关系讲清楚,并且留下可检查的依据。
觉得有用,可以点个在看
关注「虾哥AI」 · AI 工具实测 / 工作流 / 真实判断
资料来源与链接
[1] github.com:https://github.com/Tencent/WeKnora
[2] github.com:https://github.com/infiniflow/ragflow
[3] github.com:https://github.com/microsoft/markitdown
[4] github.com:https://github.com/firecrawl/firecrawl
[5] github.com:https://github.com/run-llama/llama_index
[6] github.com:https://github.com/deepset-ai/haystack
[7] github.com:https://github.com/qdrant/qdrant
[8] github.com:https://github.com/open-webui/open-webui