ARTICLE · 1079138
让 AI 帮操作手机?Mobile MCP 与 AutoGLM 深度对比与选型指南
最近,在手机端运行 AI Agent(智能体)的风头正劲。
一边是智谱开源的 Open-AutoGLM凭借端到端自动点外卖、发小红书的演示持续刷屏;另一边,GitHub 上一个名为 Mobile MCP(@mobilenext/mobile-mcp)的开源项目也迅速斩获数千 Star,支持在 Claude Code、Cursor 等编程工具中直接驱动真机和模拟器。
很多人看完了演示,心里直犯嘀咕:
“这俩不都是让 AI 帮我点手机吗?到底有啥区别?哪个更好用?我该折腾哪一个?”
别急着跟风配环境。今天我们通过实际拆解两者的技术原理、实测逻辑和官方文档,用完全不讲八股的人话,把它们的本质差异和选型建议彻底捋清楚。
一、 核心结论先行:它们压根不是同一种物种
如果用买车来打比方:
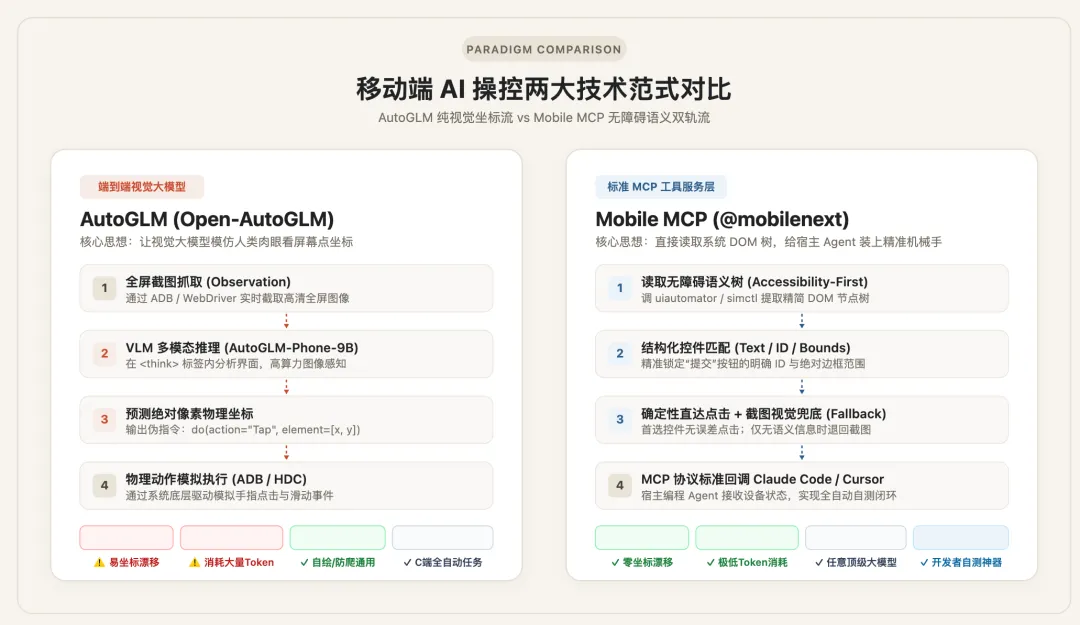
- AutoGLM 是一辆「装满传感器的自动驾驶整车」
:它自己打包了一套专门训练的手机端大模型(90 亿参数的 AutoGLM-Phone-9B),内置了从“看屏幕截图”到“脑内思考规划”再到“输出点击指令”的完整自闭环系统。 - Mobile MCP 是一根「插在你电脑最强大脑上的标准机械臂」
:它自己根本不是大模型,也不包办任务。它是一个遵循 Anthropic 标准协议(Model Context Protocol)的工具服务层(MCP Server)。它的作用是把你手头的 Android(ADB)或 iOS(WebDriverAgent / xcrun)变成一套标准的 API 工具,外挂给你平时用的 Claude 3.7、DeepSeek 或 Cursor。
二、 实际技术细节拆解:三大本质差异
很多人以为它们只是接入方式不同,其实翻开源码和实现机制,底层逻辑截然相反:
1. 感知屏幕的哲学:纯截图视觉 vs. 查系统 DOM 户口本
当 AI 要点屏幕上的一个按钮时,它怎么知道按钮在哪?
AutoGLM 走的是「纯视觉人眼模式」:
- 怎么工作
:每次操作前,先通过 ADB 截一张手机全屏图片,送进 AutoGLM-Phone-9B视觉大模型;模型在<think>标签里完成推理,最后输出一个伪代码动作:do(action="Tap", element=[x, y]),驱动 ADB 点击该坐标。 - 实际痛点
:全屏大图推理延迟高、费 Token(真金白银)。更致命的是,面对密集菜单、微小图标或折叠屏界面,纯靠视觉像素预测的坐标极易发生微小漂移,导致按错或点空。 - 杀手锏优势
:完全不在乎 App 底层怎么写的,自绘界面、防抓取界面、游戏画面,它都能像人眼一样直接看。 Mobile MCP 走的是「系统无障碍树优先,截图兜底」:
- 怎么工作
:它的核心工具不是盲目截屏,而是调用 mobile_list_elements_on_screen,利用安卓的uiautomator或 iOS 的WebDriverAgent,直接 dump 出当前界面的精简 UI 结构树(包含控件文本、元素 ID、精准 bounding box 边界)。 - 官方设计哲学
:官方文档明确强调——通过截图出坐标是不精准的(imprecise),语义元素树才是首选的可靠操作方式;截图( mobile_take_screenshot)仅作为缺乏语义标签时的“最后兜底”。 - 杀手锏优势
:零坐标漂移,响应快到飞起,极其省 Token!AI 看到的是结构化文本,能直接根据按钮文字“确认支付”精准下达指令。
2. “大脑”的自由度:专有微调小模型 vs. 通用顶级商用模型
- AutoGLM
:深度绑定针对移动端微调的 AutoGLM-Phone-9B(基于 GLM-4.1V-9B-Thinking)。模型在手机界面理解上有专项调优,但通用推理能力和长链条复杂规划上限,受限于 9B 的参数量级。 - Mobile MCP
:不绑定任何模型,大脑全凭你定。你电脑用的是 Claude 3.7 Sonnet、DeepSeek-V3 还是 GPT-4o?只要客户端支持 MCP(Claude Code、Cursor、Cline、Windsurf 等),就能直接调动 Mobile MCP 提供的 4 类工具(设备列表、应用控制、屏幕语义读取、坐标与手势执行)。
3. 应用生态定位:替你过日子的保姆 vs. 帮开发者验货的工兵
AutoGLM 的设计初衷是「C 端助理」:它瞄准的是长链条跨 App 任务:
“帮我去美团点一杯常喝的拿铁,送回家里”“去小红书搜一下上海周末骑行攻略,点赞前三篇”这些任务需要模型具备强烈的“意图猜测与多步操作容错”能力。
Mobile MCP 的核心主场是「开发者自动化自测(QA)与工作流」:目前用它最爽的是独立开发者与移动端工程师:
“帮我把这个 RN 页面的按钮文案改掉,然后用 mobile-mcp 打开模拟器启动 App,检查新按钮有没有被导航栏遮挡,截个图给我看。”改代码、跑编译、在真机/模拟器里验证 UI,全在同一个对话界面完成,直接省去人工切屏测试的繁琐劳动。
三、 一张表全面对比
@mobilenext/mobile-mcp) | ||
|---|---|---|
| 开源仓库 | zai-org/Open-AutoGLM | mobile-next/mobile-mcp |
| 项目形态 | ||
| 感知机制 | 纯全屏截图 + VLM 坐标计算 | 系统无障碍树 (UI hierarchy) 优先 |
| 执行可靠性 | 确定性极高 | |
| 驱动的底座 | ||
| 操作成本 | ||
| 支持环境 | xcrun simctl/ 真机) | |
| 主要定位 |
四、 到底怎么选?掏心窝的选型建议
看完上面的底层差异,选哪个其实一目了然:
👉 毫不犹豫选 Mobile MCP 的场景:
- 你是一名开发者(独立开发者 / 前端 / 移动端工程师)
:你平时的生产力工具已经是 Cursor 或 Claude Code。你只需要用一条命令:
就能立刻让你的 AI 编程助手具备操作模拟器和手机真机的能力。claude mcp add mobile-mcp -- npx -y @mobilenext/mobile-mcp@latest - 你需要高准确率的 UI 检查与流程自测
:依靠无障碍树的结构化读取,不用担心 AI 因为“没看清”而乱戳屏幕,省心又省钱。
👉 建议研究 AutoGLM 的场景:
- 你想探索端到端手机操作系统(VLA / Phone Agent)前沿科研
:想研究视觉小模型如何在端侧做自主规划与直接像素点击,甚至自己微调一套手机操作模型。 - 你的目标任务是纯粹的 C 端生活琐事代劳
:例如跨 App 检索商品、点外卖、社交软件打卡,且希望有完整的开箱即用 Python CLI / WebUI。 - 目标 App 界面对无障碍辅助功能极度不友好(或故意防爬拦截)
:某些采用纯自绘游戏引擎或刻意隐藏无障碍节点信息的应用,纯视觉看图反而是唯一可行的路径。
五、 写在最后
移动端 AI 操控绝不是一句简单的“大模型点屏幕”。
AutoGLM 探索的是「专精大脑的深度」——让模型像人一样用肉眼看懂一切复杂的手机交互;而 Mobile MCP 探索的是「工程架构的广度」——把移动设备标准化成协议插件,让现有的强大通用 AI 能够无缝握住这把利刃。
搞清楚两者的战场,才不会在搭建自己的 AI 工作流时南辕北辙。