ARTICLE · 1092612
高分不等于插件有用——真正该看的,是 WITH 与 W/OUT 之间那个 Δ
claude plugin eval 这条 shell 命令会把你的 plugin(插件)跑在一组测试用例上,并给结果打分。每个用例(case)由一个贴近真实的 prompt(提示词),加一个或多个 grader(评分器)组成。grader 是对 Claude 产出结果做通过/不通过的检查,比如用正则匹配回复内容、检查某个特定工具是否被调用,或者交给第二个模型按评分细则(rubric)来评判。
你不必手写这套测试集。claude plugin eval init 会询问你的插件情况,提出用例与 grader 方案,试跑一遍,再写好文件。你也可以在已经打开的会话里,让 Claude 帮你做同样的事。
用 evals 可以:
衡量插件在多大程度上稳定地让 Claude 产出正确结果
在改动插件或新模型发布时,抓住回归(regression)
看清与「不装插件」相比,插件到底贡献了什么
本页面向的是已有可用插件、想让它的行为经得起测试的插件与 skill 作者,以及要在 CI 里为插件变更设卡的团队。如果你只想在某个 Claude Code 会话内部迭代单个 skill,skill-creator 插件会用自己的一套 evals/evals.json 格式做类似对比,而两个工具彼此不读对方的用例文件。想创建插件,见创建插件;想检查插件文件的语法与 schema(数据结构定义)错误(而不是行为),请用 claude plugin validate。
每一次 eval 运行、每一次 judge grader 评判,都是在你账号上发起的一次真实模型调用,会占用你所在套餐的用量额度,或计入你的 API 账单,所以请先看前置要求。然后去创建你的第一个 eval 测试集;如果你已经有测试集了,直接看在 CI 里运行 evals。
本文看点
01
写用例、配 grader
02
无插件基线对照出 Δ
03
在 CI 里守住效果
原文:Test plugins with evals
来源:Claude Code Docs(Anthropic)
译者:本文由英文原文翻译,技术术语保留英文并在首次出现时加注,代码块内的注释、命令与标识符按原样保留。原文版权归 Anthropic 所有,译文仅供学习交流;如涉版权问题,请联系删除。
Note
每一次 eval 运行、每一次 judge grader 评判,都是在你账号上发起的一次真实模型调用,会占用你所在套餐的用量额度,或计入你的 API 账单,所以请先看前置要求。然后去创建你的第一个 eval 测试集;如果你已经有测试集了,直接看在 CI 里运行 evals。
01
REQUIREMENTS
前置要求
要运行插件 evals,你需要:
Claude Code v2.1.269 或更高版本。运行 claude --version 查看版本,用 claude update 升级。
Git 2.31 或更高版本(前提是你装了 git)。运行 git --version 查看。git 版本过低时,claude plugin eval 会在跑任何用例之前就停下。没装 git 则一切照常。
一个插件目录,其中含 plugin.json 或 .claude-plugin/plugin.json 清单文件,或者是通过 skills 目录分发的插件。
与你平常用 Claude Code 时相同的认证方式和模型提供方。Eval 运行、由 judge 打分的 grader,以及 claude plugin eval init,都会用你的凭据去调用模型,因此会占用你套餐的用量上限,或计入你的 API 账单。当命令报出费用时,这个数字是对这些调用的标价估算。
02
HOW IT WORKS
eval 运行是怎么跑的
一个 eval 测试集放在插件内部名为 evals/ 的目录里,结构如编写与打磨用例所示。每个用例是一个独立子目录,里面有一个 prompt 和一个或多个 grader。prompt 写的是用户使用你的插件时可能输入的内容,例如某个本该由它的某个 skill 来处理的请求。
一次运行里发生了什么
对用例的每一次运行,Claude Code 都会新起一个隔离的非交互式会话,只加载你的插件,把 prompt 发进去,然后让 Claude 一直工作到完成,或触及该用例的轮次(turn)上限、时间上限为止。随后每个 grader 检查最终回复、对话记录(transcript)或 Claude 创建的文件,判定通过或不通过。
用例如何计分
非确定性智能体的单次运行说明不了什么,所以默认每个用例跑三次。一次运行的得分,是它各个 grader 中通过的比例(如果你设了权重则按权重加权);用例的得分则是它各次运行得分的平均值。当用例得分达到 --threshold 时判为通过,该值默认为 1.0。
在模型调用量上,一个测试集大致会产生「用例数 × 运行次数」次带插件的 agent 运行,以及同样次数的无插件基线运行;此外每次运行里,每个 llm 或 baseline grader 还会带来三次简短的 judge 调用。
无插件基线
单看高分并不能说明插件起了作用,因为不装插件 Claude 可能表现一样好。要把两者分开,默认情况下每个用例的运行都会在不加载插件的情况下再重复一遍,于是你得到两个分数:WITH 和 W/OUT。两者的差值 Δ,就是插件贡献的部分。如果某个用例在装和不装插件时都得 1.0,那让它通过的就不是插件。
这两组运行分别叫 with-arm(带插件臂)与 without-arm(不带插件臂);对照无插件基线打分一节会讲 grader 在两臂之间如何计分,以及怎么关掉基线。
03
FIRST SUITE
创建你的第一个 eval 测试集
这套走查会为你的插件写一个用例、跑一遍、再读结果。开始之前,请确认你已具备:
Claude Code v2.1.269 或更高版本,以及其余前置要求
一个终端,工作目录在插件的根目录(即含 plugin.json 或 .claude-plugin/plugin.json 的那一层)
插件里有一个你想测试的 skill,以及一句用户会输入、理应触发它的请求
STEP 01Create the cases
在插件根目录下运行
claude plugin eval init
如果 Claude Code 尚未信任该目录,它会先问 Trust this plugin directory?,回答 y。
接着会打开一个交互式 Claude Code 会话。Claude 读取你的插件,询问你「什么样的结果算好」,提出应当触发和不应当触发该插件的 prompt,为每一条设计 grader,先试跑一次确认它们的行为符合预期,最后在 evals/ 下为每条 prompt 写一个用例目录,目录名取自该 prompt。
当 Claude 告诉你测试集已就绪,用 /exit 或 Ctrl+D 退出该会话,回到你的 shell。
如果你已经在插件根目录打开了 Claude Code 会话,也可以直接在会话里让 Claude 运行 claude plugin eval init。Claude 会执行该命令,并在同一个对话里问你同样的问题。
如果你更想亲手写一个用例、看清文件里到底有什么,请按手动编写用例做,然后回到这里运行它。
STEP 02Run the suite
回到插件根目录的 shell,运行 evals/ 下的所有用例
claude plugin eval .
你在第 1 步已经信任过这个目录,所以运行会立刻开始。如果你改用手写用例,运行前会先问 Trust this plugin directory? [y/N],回答 y。一次运行能访问什么解释了你在同意什么。
每个用例都会带插件跑三次、不带插件跑三次,所以一个用例共六次运行。每次运行结束后会打印一行进度,含该次运行的得分与每个 grader 的判定。
STEP 03Read the summary
测试集跑完后,你会看到一张汇总表,随后是报告的去向
CASE WITH W/OUT Δ RUNS COST NOTES
first-case 1.00 0.33 +0.67 6 $0.41
1 case(s) · mean Δ +0.67 · 74s · $0.41
Report: /Users/you/my-plugin/evals/results/2026-09-10T17-02-11-482Z/report.html
Published: https://claude.ai/... · keep local next time with --no-publish
WITH 是加载你的插件时该用例的得分,W/OUT 是不加载时的得分,Δ 为正表示插件提升了得分。COST 是对这些模型调用的标价估算,NOTES 显示带插件臂中权重最高的那个未通过 grader 的说明,或者是该次运行的错误信息。
STEP 04Open the report and iterate
打开 Published: 给出的 URL;如果没有 Published: 这一行,就打开 Report: 给出的路径。在那里可以看到每一次运行中每个 grader 的判定与说明,对 llm grader 还能看到 judge 的投票和它评判的原文摘录。只有当你的账号能够发布报告时,才会出现 Published: 这一行。
最常见的第一个发现,是 Δ 接近零,而用例的 tool_used: Skillgrader 未通过——这意味着 Claude 没有在自然表述下选中你的 skill。请调整该 skill 的 description,再运行一次 claude plugin eval . 做对比。
想低成本地迭代单个用例,可以只跑单臂一次。单次运行噪声较大,所以任何改动都请在默认的三次运行下确认后再采信。只跑单臂时,表格会用 SCORE 和 PASS% 两列取代 WITH、W/OUT 和 Δ:
claude plugin eval . --case <case-name> --runs 1 --ablation none
把 <case-name> 换成 evals/ 下的某个目录名。
04
WRITE CASES
编写与打磨用例
claude plugin eval init 写出来的用例都是普通文件,你可以打开、修改、追加。一个用例就是插件 eval 目录下的一个目录,其中包含 prompt.md、case.yaml 或两者兼有。要把用例分组,就把它们放在一个本身不是用例的目录下面;用例目录里的一切,比如 graders/ 与 fixture(预置数据)文件,都属于该用例。
下面是 claude plugin eval init 写出的目录结构,新建测试集时也照这个来。eval 测试集参考里有完整的目录树,包括 mock 与结果:
my-plugin/
├── .claude-plugin/plugin.json
├── skills/...
└── evals/
├── first-case/
│ ├── prompt.md # frontmatter: case fields; body: the prompt
│ ├── graders/
│ │ ├── criteria.md # frontmatter: type + options; body: rubric or pattern
│ │ └── skill-fired.md
│ └── case.yaml # optional: only for context.* fields
├── ignores-unrelated-request/
│ └── ...
└── results/ # written by each run; add to .gitignore
手动编写一个用例
推荐做法还是让 Claude 用 claude plugin eval init 来写用例。如果你要自己动手,就从空白模板起步。下面这条命令会写出一个名为 first-case 的用例,含一个占位的 prompt.md 和一个占位 grader,但不运行任何东西:
claude plugin eval init --bare first-case
evals/first-case/
├── prompt.md # the prompt sent to Claude, plus run limits
└── graders/
└── criteria.md # one grader: how to score the result
在 prompt.md 里,你写下每次运行中 Claude 会收到的消息,并在 frontmatter 里设定该次运行的各项上限、以及这个用例可以使用的工具。打开 evals/first-case/prompt.md,把占位正文换成一个本该由你某个 skill 处理的请求,措辞要像用户真会输入的样子,而不要直接点名 skill。下面这个例子针对的是一个起草提交信息的 skill;请换成你自己的请求:
---
max_turns: 10
allowed_tools: [Read, Glob, Grep, Skill]
---
Write me a commit message for this change: I renamed getUser to fetchUser and updated the three call sites.
每次运行都从空的工作目录开始,所以任务需要什么,就把什么写进 prompt 本身,或者先把工作区准备好。
frontmatter 字段的完整清单涵盖了 model、timeout、tags 和环境变量。
graders/ 下的每个文件,都是运行结束后施加的一道检查。打开 evals/first-case/graders/criteria.md,把占位内容换成给 judge 模型的评分细则,写成具体的 PASS 与 FAIL 条件:
---
type: llm
---
PASS if <what a correct response contains>.
FAIL if <what a wrong or missing response looks like>.
然后再加一个 grader,检查给出答案的是不是你的 skill。新建 evals/first-case/graders/skill-fired.md,把 your-skill-name 换成该 skill 在 skills/ 下的目录名——Claude 就是按这个名字调用它的:
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?your-skill-name"'
---
当 Claude 在该次运行中至少调用过一次这个 skill(包括用 plugin-name:skill-name 这种带命名空间的形式)时,该 grader 通过。
grader 类型列出了其它可用的检查,比如匹配正则、或确认某个文件已被创建。
两个文件都保存好之后,按快速上手里的方式运行该用例——在插件根目录执行 claude plugin eval .。
在 prompt.md 里设置运行上限与工具
用例的 max_turns、timeout_seconds、model、tags,以及它可以使用的 allowed_tools,都在 prompt.md 的 frontmatter 里设置;prompt.md frontmatter参考列出了每个字段及其默认值。
Claude 收到的正文与你写的完全一致。正文里的 @path 提及不会被展开成文件附件,所以如果 Claude 需要读某个文件,请把它对应的工具授予 allowed_tools。
挑选 grader 并设置权重
grader 的 frontmatter 设定它的 type,还可以选配weight(让它在本次运行得分中占更大比重)和 arm(控制它相对基线如何计分)。六种类型中,regex、tool_used、tool_order 和 file_exists 由对话记录与文件计算得出,不产生额外费用;而 llm 和 baseline 会调用 judge 模型,会增加本次运行的成本。
没有「自定义代码」这类 grader。
grader 类型列出了每种类型的选项与通过条件,grader 能看什么列出了 target 与 focus 可接受的值。
llm 与 baselinegrader 的 judge 默认是一个小而快的模型。传 --judge-model sonnet 或完整的模型 ID,可以换用更强的模型来处理需要细腻判断的评分细则。
挑选能给出稳定信号的 grader
llmgrader 是让模型给出裁决,所以它的答案在多次运行之间可能有出入,而要读的文本越长,出入越大。以下习惯能让测试集的分数稳定到可被信任:
对生成文件这类长输出,用 regex grader 针对文件内容打分,它每次都以同样的方式检查整个文件。llm grader 留给短输出,并把评分细则写成具体的 PASS 与 FAIL 条件。
每个用例配两个 grader:一个针对结果(比如最终消息或产出的文件),一个针对 Claude 为得到该结果所走的步骤(比如 tool_used 或 tool_order)。两者合起来,既告诉你答案对不对,也告诉你答案是不是你的插件产出的。
如果某个用例的 tool_used: Skill grader 通过了,但 Δ 为负,先怀疑 judge,再怀疑插件。小号的 judge 模型可能因为答案格式与评分细则描述的不一样,就把正确答案判错。用 --judge-model sonnet 重跑,并收紧评分细则,让格式不再左右裁决。
想检查运行内部的构建或测试是否通过,就让 prompt 要求 Claude 运行它并把结果写入文件,对该文件打分,再用一个 tool_usedgrader断言该命令确实执行过(在其 input_match 里写出该命令)。
对照无插件基线打分
当插件是被测对象时,默认每个用例都会在两臂中运行。with-arm 是加载插件的那些运行,without-arm 是完全不加载插件的同样次数的运行。汇总表与报告会同时给出两个分数和 Δ,即 with-arm 得分减去 without-arm 得分。
传 --ablation none(ablation 即「消融」,指拿掉一个臂做对照)可以只跑 with-arm。当你不需要这个对照时(比如正在打磨 grader 的阶段),这能把成本减半。
在两臂运行中,某些 grader 会被标记为 scored: false。像「该 skill 被调用了」这样的检查,在不装插件时永远不可能通过,把它算进去会把 without-arm 的分数压向零,从而虚高Δ。为了让两臂可比,Claude Code 会在两臂中都把这类 grader 从计分里排除,只在 with-arm 里把它们当作通过/不通过的指示器报告出来。被排除的包括:
所有 tool 为 Skill 的 tool_usedgrader
当用例中每个被 mock(模拟)的服务器都是你的插件所声明的服务器时,所有 target: mock_calls 的 regexgrader 与所有 focus: mock_calls 的 llm grader
任何被你标为 arm: with-only 的 grader
有三种设定会改变这一排除规则:
所有 grader 都被排除:如果一个用例里的每个 grader 都在排除集合里,它们就改为正常计分,因为否则就没剩下什么可打分的了。
arm: both:在某个 grader 上设 arm: both,它就无论如何都在两臂中计分。对于「不得调用该 skill」这类带 min: 0 和 max: 0 的检查,这正是你想要的。
--ablation none:在 --ablation none 下不排除任何 grader,所以同一套测试集在两种模式下可能给出不同的绝对分数。
换一个 eval 目录
如果 evals/ 已被别的工具占用,可以把测试集放在另一个目录里。你既可以把这个目录记进插件的 plugin.json(这样每次运行、每位协作者都会用它),也可以在命令行上为单次运行指定:
写进 plugin.json:加上 "experimental": { "evals": "quality/evals" }。
写在命令行上:给 claude plugin eval 和 claude plugin eval init 都传 --eval-dir quality/evals。
如果两处都设了,以命令行的目录为准。请使用由普通目录名组成的相对路径,例如 qa 或 quality/evals。绝对路径、以及含 .. 的路径都不被接受:作为命令行取值时它直接报错;作为清单里的值不可用时,会打印一行 Warning:,然后该次运行改用 evals/。用例、结果和 init 的输出都会移到那个目录下。
05
FIXTURES & MOCKS
配置 fixture 与 mock
一个用例需要的可能不止一段 prompt:工作区里的文件或 git 仓库、一段需要接着往下走的既有对话,或者你的插件所连 MCP 服务器返回的应答。这些都在用例旁边配置好,运行才能保持可重复。
为工作区或对话预置初始状态
每次运行都从空工作区开始。当用例需要的不止 prompt 时,在 prompt.md 旁边加一个带 context 块的 case.yaml:
Fixture 文件或 git 仓库:在用例目录里写一个 Bash 脚本,并在 context.scaffold_script 里写它的名字。该脚本以你的身份、在智能体沙箱之外运行,且只有你传 --scaffold 时才会执行,所以只对你自己或你所在组织编写的测试集加这个参数。
一段需要接着走的既有对话:把对话记录存成 .jsonl 文件,在 context.history_file 里指向它,该用例的 prompt 就成了下一轮用户消息。
Claude 在运行期间可以读取的 fixture 目录:在 context.add_dirs 里列出。
case.yaml 还需要 schema_version: "1.1" 和 name;case.yaml 字段参考里有完整清单。
下面这个 case.yaml 用脚本播种工作区,并让 Claude 能从 resources/ 目录读取 fixture:
schema_version: "1.1"
name: changelog-from-diff
tags: [smoke]
context:
scaffold_script: fixture.sh
add_dirs: [resources]
mock 掉 MCP 服务器
即使背后没有真实服务,你也可以评估那些会调用 MCP 工具的插件 skill。为每个工具放一个 Markdown 文件:整个测试集共用就放在 evals/mocks/<server>/<tool>.md,只给单个用例用就放在该用例自己的 mocks/ 目录下。其中 <server> 是服务器在你插件 MCP 配置里的名称。
除非你明确要求,否则运行不会启动插件真正的 MCP 服务器。Claude Code 会以各服务器自己的名字注册一个替身服务器。有对应 mock 文件的工具由该文件应答,且无需 --allow-tools 授权即可使用;没有 mock 文件的工具,Claude 就用不到。一个完全没有 mock 的服务器,会在该用例的 mocked: 进度行里显示为 plugin_<plugin>_<server>[not started: no mock]。
mock 文件的正文就是该工具返回给 Claude 的内容。下面的 mock 代替一个名为 tracker 的服务器上的 create_issue 工具,校验 Claude 发来的输入,并把标题回显出来。把它保存为 evals/mocks/tracker/create_issue.md:
---
expect:
title: string
priority: [low, medium, high]
---
Created issue #4821: {{input.title}}
mock 文件的正文与 frontmatter 接受以下选项:
替换(Substitutions):用 {{input.<field>}} 插入本次调用输入里的字段,用 {{file:fixtures/{input.<field>}.json}} 插入 mock 旁边某个 fixture 文件的内容。
expect::expect: 块用于把关输入。若某次调用违反它,本次运行会以 0 分中止并记录原因,于是用例可以断言你的插件到底让服务器做了什么。
error: true:设 error: true 则改为把正文当作工具错误返回。
type: agent:设 type: agent 则由一个小模型按正文里的指示扮演该服务器作答。
mock 文件参考列出了每一个键,以及 _server.md 和 _tools.json 两个文件。
要给调用本身打分,就把 grader 指向target: mock_calls。
若改为对接插件真实的 MCP 服务器,请传下面任一标志。两种情况下那些进程都以你的身份、在本次运行的沙箱之外运行,其工具需要 --allow-tools 授权:
--allow-real-servers:为每个你没有 mock 的服务器启动真实进程,同时继续用 mock 文件应答被 mock 的工具
--mocks off:完全忽略 mocks/,启动插件声明的每一个服务器
回放 agent mock 的应答
type: agent 的 mock 是靠调用 --judge-model 来作答的,所以它的输出在多次运行之间会变,换了 judge 也会变。当一次运行无错误、未中止地完成时,Claude Code 会把 agent mock 给出的每个答案保存到结果目录下的 mock-recordings/ 里。
打开其中的 ADOPT.txt,可以看到每份录制内容以及该把它复制到哪个 .replay/<server>/ 目录——就在产生它的那个 mock 旁边。复制过去之后,后续运行遇到完全相同的调用就用该录制作答,不再产生模型调用。请把 mocks/.replay/ 与 mocks/ 的其余部分一起提交,这样 CI 运行才是可重复的。
06
RUN EVALS
运行 evals
测试集建好之后,就用 claude plugin eval 来运行它。你通过 target 参数选择运行哪个插件、哪些用例,用 --allow-tools 授予用例所需、而只读工具集之外的任何工具,并用其余选项控制运行次数、模型、成本和输出。
选择要评估什么
大多数情况下,你会在插件根目录运行 claude plugin eval .,它会把你当前所在目录的那个插件加载起来,跑完测试集里的所有用例。要运行单个用例文件,或者要评估一个已安装的插件(而不是你正在开发的),就换一个 target:
| 插件 | |
| name@skills-dir | |
加 --case <glob> 可按用例名过滤,加 --tag <tag>可保留带有任一给定 tag 的用例。
请把 target 写在 --tag、--allow-tools 和 --json 之前。前两者接受一个列表,--json 接受一个可选路径,所以它们中任何一个后面的 target 都会被当成它自己的取值读走。
授予工具
运行时绝不会停下来请求授权。需要授权而你没给的内置工具,比如 Bash、Write、Edit、WebFetch 和 WebSearch,会从会话里被移除,Claude 根本调不到它们。
一次运行只允许用例在 allowed_tools 里列出的那些只读工具,范围是 Read、Glob、Grep、NotebookRead、Skill、AskUserQuestion、Agent、TodoWrite 以及任务工具 TaskCreate、TaskGet、TaskList、TaskUpdate、TaskStop,再加上你用 --allow-tools 授予的部分。该授权作用于本次运行中的所有用例。要让用例能用 Bash、Write、Edit、WebFetch 或 WebSearch,得由你亲自授予:
claude plugin eval . --allow-tools Write Edit "Bash(npm test *)"
当某个用例请求了你未授予的工具,进度输出会把它列为not granted。在被 mock 的MCP 服务器上的工具无需授权。真实插件 MCP 服务器上的工具,既要把服务器启动起来(用 --allow-real-servers 或 --mocks off),又要按名字授权,例如 --allow-tools "mcp__plugin_my-plugin_github__*";插件的 MCP 工具命名格式为 mcp__plugin_<plugin>_<server>__<tool>。
只要你以任何形式授予了 Bash,每条命令都会在 Claude Code 的 OS 级沙箱里运行。写入被限制在本次运行的工作区内,你的主目录与 Claude Code 配置不可读,网络访问也仅限于你用 --allow-tools "WebFetch(domain:example.com)" 授予的域名。如果你在没有沙箱后端的机器上授予 Bash 或 PowerShell,Claude Code 会拒绝这次运行而不是无约束地跑它,该用例会显示一个运行错误并通常得 0 分。原生 Windows 没有后端,所以授予 shell 的测试集要在 WSL2 下运行;在 Linux 上,请先安装 bubblewrap 和 socat。见沙箱前提条件。
命令选项
下表覆盖运行次数、模型、计分、成本、工具授权、mock 与输出相关的选项。完整清单请运行claude plugin eval --help,其中还包括 --case、--tag、--eval-dir、--no-scaffold、--report 和 --verbose。
| --runs <n> | ||
| -j | 1 | |
| --model <model> | ||
| --judge-model <model> | llm | |
| --ablation <mode> | ||
| --threshold <0..1> | 1.0 | |
| --max-cost-usd <usd> | ||
| --allow-tools <tools...> | ||
| --scaffold | ||
| --trust-plugin | ||
| --mocks <mode> | record | record |
| --allow-real-servers | ||
| --json [path] | ||
| --output-dir <dir> | <eval dir>/results/<timestamp>/ | aggregate-result.json |
| --no-publish | ||
| --publish-report | ||
| --keep-temp |
在 CI 里运行 evals
在你的 CI 任务里,用 --json 运行测试集以写入结果供归档,并依据退出码让构建失败。传 --trust-plugin 让任务永不卡在首次信任提示上,固定两个模型以保证跨时间的分数可比,把报告留在本地,并设一个成本上限作为上限约束:
claude plugin eval . \
--trust-plugin \
--json results.json \
--threshold 0.8 \
--model claude-sonnet-5 \
--judge-model claude-haiku-4-5 \
--no-publish \
--max-cost-usd 20
任务的退出码告诉你发生了什么:
with 减 without 的差值会被报告出来,但从不影响退出码;写报告或发布报告出问题同样不影响。
想弄清某个用例为什么得分低,就本地运行它并去掉 --json,这样每次运行的进度行与 grader 行会打印出来。
CI runner 还需要具备以下几点:
安装与凭据:CI runner 需要装好 Claude Code,并在环境里配好凭据,例如 ANTHROPIC_API_KEY。
信任:不传 --trust-plugin 时,若 Claude Code 尚未信任该任务检出代码的目录,就需要首次信任提示,而无法询问的运行会以退出码 1 被拒。
在 CI 里跑 init:claude plugin eval init 需要一个终端来向你提问;在 CI 里请运行 claude plugin eval init --bare <name> 来拿空白模板。
为了让成本可预期,给「每次改动都跑」的快速测试集只配不调用 judge 的 grader,在不需要 Δ 的地方用 --ablation none,并且别把带 partial: true 的文档和带 skippedPaidGraders 的运行混进你要画的趋势图里。
07
READ RESULTS
读懂结果
只要跑了至少一个用例,就会在 eval 目录下写出一个 results/<timestamp>/ 目录,内有 aggregate-result.json 与 report.html。target 是路径时,它在插件下面;target 是已安装插件的名字时,它在你当前目录下面,如target 对照表所示。汇总表、JSON 和报告渲染的是同一份结果数据。
HTML 报告
report.html 是一个自包含的单文件,不发起任何外部请求,所以你可以把它附在 CI 产物里,或直接从磁盘打开。下面这个例子,是用 --threshold 0.8 跑一个三用例测试集时报告的开头部分;其中的成本是标价估算,会随模型与用例数量变化:
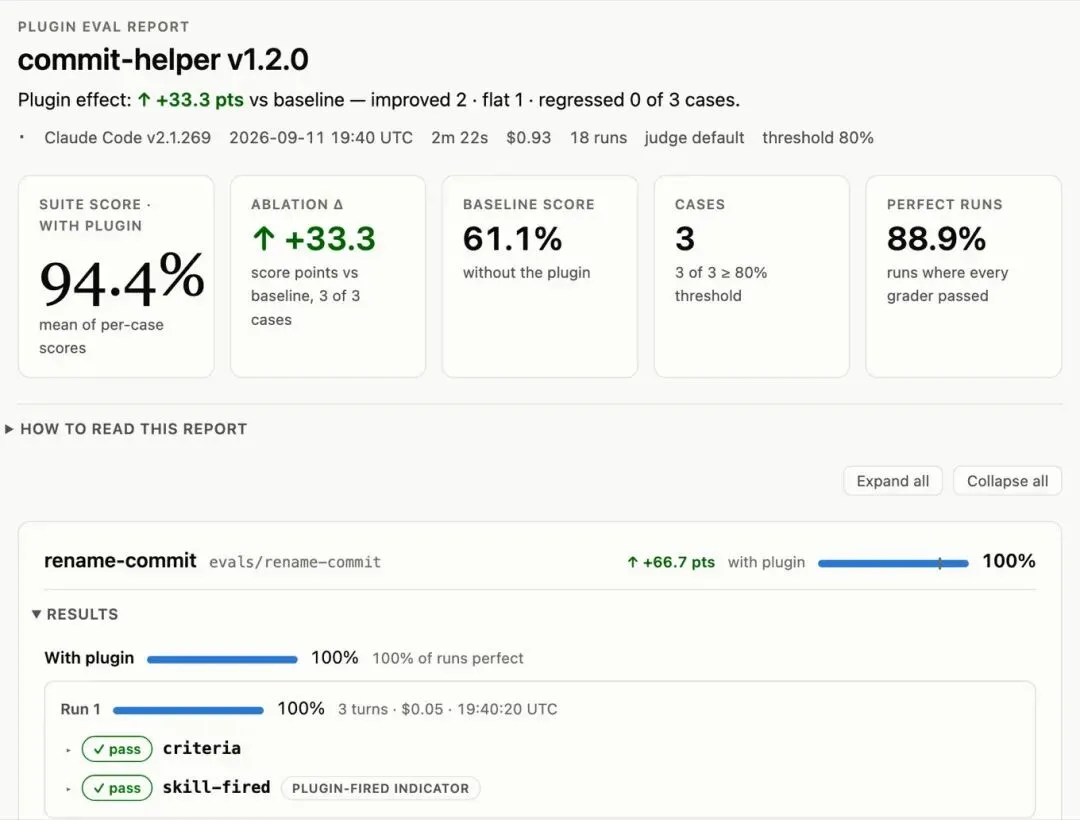
— 图:eval 报告的开头示例。结论行写着「Plugin effect: +33.3 pts vs baseline, improved 2, flat 1, regressed 0 of 3 cases」;其下五个汇总卡片分别对应套件得分、消融差值、基线得分、达到阈值的用例数、完美运行;再往下是第一个用例及其差值、得分条,以及一次两个 grader 都显示通过的运行。
从上往下读:
结论行与那些卡片回答的是:插件在整个测试集上到底有没有帮助。套件得分是各用例带插件得分的平均值,Ablation Δ 是它高出或低于基线得分的幅度,Cases 统计有多少用例达到了阈值。Perfect runs 指带插件的运行中全部 grader 都通过的比例。
每个用例卡片显示该用例自己的 Δ 与带插件得分,并在得分条上于阈值处打一个刻度。Δ 为负的用例左边会有一条红边,这样滚动浏览时回归能一眼看出。
用例内部,带插件的运行排在前,基线运行排在后。每次运行都列出它的 grader 与通过/不通过的标签。未通过的 grader 已经展开并附说明;llm grader 还会显示 judge 的投票和它看到的证据——正是从这里你能弄清一次运行为何得分低。不计入得分的 grader,比如 tool_used: Skill,带有一个 plugin-fired indicator 徽标。
运行记录下方的 Prompt and Graders 显示该用例的 prompt 和每个 grader 的评分细则或匹配模式,这样即便读者手上没有这套测试集,也能看清当时问了什么、什么算好。
如果你是用 claude.ai 订阅登录、且你的账号可用 artifacts,Claude Code 还会把报告作为私有 artifact 发布,并打印 Published: <url>。传 --no-publish 可让它留在本地。如果没有出现 Published: 这一行,比如使用 API key 认证时,那么本地文件就是报告。
由某个 Claude Code 会话发起的运行(比如你让 Claude 帮你跑测试集)同样留在本地,其 Report: 行会写着 kept local。想发布它,就在那条命令上加 --publish-report。
JSON 结果
aggregate-result.json 与 --json 的输出,是一份带版本号的文档,其 schemaVersion: 1,供 CI 脚本解析。字段名为 camelCase,新增字段不会重命名既有字段,所以你的脚本请写成忽略自己不认识字段的形式。
下面是做门禁的脚本通常会读取的字段。该文档还包含测试集配置、每个 grader 的定义,以及每次运行的 grader 结果(含说明与证据):
| partial | 测试集 |
| aggregates.overallScore | |
| aggregates.casesPassed | |
| aggregates.meanDelta | 两臂 |
| cases[].name | 用例 |
| cases[].aggregates.score | |
| cases[].aggregates.delta | with-arm |
| cases[].arms.with[].error | |
| cases[].arms.with[].aborted | |
| cases[].arms.with[].skippedPaidGraders | |
| costUsd |
08
ACCESS & ISOLATION
一次运行能访问什么
claude plugin eval 会加载目标插件的 skills、hooks 和 agents,并以你的身份在你的机器上运行它的 eval 测试集。把它指向某个插件,与 claude --plugin-dir 属于同一种信任决定,所以只评估你信任的插件。
本节所述的隔离,限制的是被测智能体能触达的范围;它并不是针对插件自身代码的边界,而且一套测试集通过,也说明不了这个插件是否安全。
信任插件目录
第一次对某个目录运行 claude plugin eval 时,Claude Code 会在从它那里加载任何东西之前询问Trust this plugin directory?——除非你在某个交互式 claude 会话里已经接受过该目录的信任提示。在 git 仓库内,回答「是」会信任整个仓库,交互式会话亦如此。当 stdin 或 stdout 不是终端、处于 --json 下,或 CI 环境变量被设为真值(例如 true)时,运行无法提问,会以退出码 1 被拒;此时传 --trust-plugin 由你自己断言信任,且仅限你会在本机运行的插件。以名字而非路径给出的 target(即已安装的插件或 skills 目录插件)会跳过该提示。
插件与测试集的某些部分,只有你在该次运行中传了对应标志才会执行:
用例的 scaffold_script,需 --scaffold
只读工具集之外的工具,需 --allow-tools
插件真实的 MCP 服务器,需 --allow-real-servers 或 --mocks off
用例的 allowed_tools 与 skill 自身的 allowed-tools frontmatter 都无法放宽以上任何一项。
当插件包含不是你写的 hooks,或你启动了它真实的 MCP 服务器时,请把这些得分当作参考值——除非你是在容器或 CI runner 这类隔离环境中运行的。因为 hooks 与服务器运行在智能体沙箱之外,可能改动 grader 要读的文件。
运行之间如何隔离
每次运行都会获得一个临时主目录、工作目录和 Claude Code 配置,被测智能体以 claude -p 子进程的形式在其中运行,且只加载你的插件。写用例时请记住以下后果:
不会加载任何个人级或项目级配置。 你的用户设置、hooks、CLAUDE.md 文件、MCP 服务器、其它已安装插件、记忆和 skills 都不在;沙箱之上的项目级 .claude/ 或 .mcp.json 也不会被读取。你的 shell 环境大部分也被屏蔽,只有一份允许清单与 EVAL_* 变量能进入这次运行。如果插件需要做初始化,就把它一并打包进插件、在 scaffold_script 里创建,或者传 EVAL_* 变量。
托管策略仍能限制运行。 管理员部署到本机的托管设置中的限制,在运行内部同样生效,所以同一套东西在受管机器上的结果可能因该策略而与不受管机器不同。
Artifact 工具是关闭的。 一个会发布 artifact 的 skill,只能就它在发布那一步之前产出的内容打分。
用例定义对智能体不可见。 运行无法读取 eval 目录,因此 Claude 看不到该用例的 prompt、它的 grader,也看不到旁边的其它用例。
shell 命令之外没有网络沙箱。 你授予的 shell 命令受沙箱网络规则约束。WebFetch(domain:…) 之类的授权可以直接访问该域名,而插件自身的 hooks、以及你启动的任何真实 MCP 服务器,可以访问任意主机。
09
REFERENCE
eval 测试集参考
一个 eval 测试集能包含的一切都在插件的 eval 目录下——除非你配置了别的目录,默认就是 evals/。下面这棵树列出了 claude plugin eval 在该目录下读取或写入的所有文件;对一个用例来说,只有 prompt.md 或 case.yaml 是必需的:
evals/
├── <case>/ # one directory per case; nest under a non-case directory to group
│ ├── prompt.md # frontmatter: case and run fields; body: the prompt
│ ├── case.yaml # optional: context.* fields, or the whole case in one file
│ ├── graders/
│ │ └── <name>.md # one grader per file; frontmatter: type and options; body: rubric
│ ├── mocks/ # optional: mocks for this case only, same layout as below
│ └── <fixtures, scripts, transcripts referenced by case.yaml>
├── mocks/ # optional: suite-wide MCP mocks
│ ├── <server>/
│ │ ├── <tool>.md # one mocked tool; body: the tool result
│ │ ├── _server.md # optional: one agent that answers several tools
│ │ ├── _tools.json # optional: saved tools/list response for real descriptions and schemas
│ │ └── fixtures/ # files inserted with {{file:fixtures/...}}
│ └── .replay/<server>/ # adopted agent-mock recordings, answered without a model call
└── results/<timestamp>/ # written by each run; add results/ to .gitignore
├── aggregate-result.json
├── report.html
└── mock-recordings/ # agent-mock answers from clean runs, with ADOPT.txt
prompt.md frontmatter 字段
prompt.md 的 frontmatter 接受以下字段。出现未知的键会报错:
| schema_version | "1.1" | 用例 |
| name | 用例 | |
| description | ||
| tags | [] | |
| plugins | ||
| runs | 3 | |
| expected_outcome | ||
| model | 子会话 | |
| max_turns | 10 | |
| timeout_seconds | 300 | |
| allowed_tools | [] | |
| append_system_prompt | ||
| env | {} |
case.yaml 字段
case.yaml 是 prompt.md 的替代品或搭档:它用 YAML 描述一个用例,并新增了指向其它文件的字段。它要求 schema_version: "1.1" 与 name。prompt.md 里那几个字段 description、tags、plugins、runs、expected_outcome 放在顶层;model、max_turns、timeout_seconds、allowed_tools、append_system_prompt、env 放在 execution: 下面。两个文件同时存在时,prompt.md 的 frontmatter 会覆盖 case.yaml 中对应的字段,prompt.md 的正文即 prompt,而 graders/*.md 会追加在 case.yaml 里列出的 grader 之后。
下面这些字段只存在于case.yaml 中:
| context.scaffold_script | 用例 |
| context.history_file | 用例 |
| context.add_dirs | 用例 |
| execution.prompt | |
| graders |
grader frontmatter 字段
graders/ 下的每个 grader 文件,frontmatter 里都接受以下这些键,外加其类型专属的选项。grader 的名字就是文件名去掉.md:
| type | ||
| weight | 1 | |
| arm | with-only |
grader 能看什么
regexgrader 取一个 target,llm grader 取一个 focus。两者接受相同的取值:
| last_message | |
| trace | |
| files | |
| { source: file, path: <path> } | |
| mock_calls |
grader 类型
下面每种 grader 类型都列出了它的选项以及何时通过:
| regex | pattern | |
| tool_used | tool | |
| tool_order | before | |
| file_exists | path | |
| llm | criteria | |
| baseline | baseline_file |
mock 文件
mocks/<server>/ 下的一个 <tool>.md 文件应答一个工具。它的正文即工具结果,可使用 {{input.<field>}} 与 {{file:fixtures/<name>}} 替换。它的 frontmatter 接受以下这些键:
| type | fixed | fixed |
| expect | ||
| error | false | |
| abort_when |
服务器目录里,工具文件旁边还有两个可选文件:
_server.md:一个 type: agent 的 mock,可应答多个工具,具体哪些工具写在它的 tools: frontmatter 键里。同一个工具有对应的 <tool>.md 时,以 <tool>.md 为准。expect: 守卫请加在各自的 <tool>.md 上,不要加在这里
_tools.json:从真实服务器保存下来的 tools/list 响应,这样被 mock 的工具会带着它们真实的描述与输入 schema,而不是一个宽松的占位定义
用例自带的 mocks/ 目录使用同样的布局,并会逐个文件覆盖测试集级的 mock。
10
TROUBLESHOOTING
疑难排查
以下是作者们最常遇到的问题,按你会看到的报错来索引。
报错:“plugin eval is currently in early access”
你手上的构建版本早于该命令正式可用。运行 claude update,然后在新会话里再运行该命令。
报错:“plugin eval is currently unavailable”
Anthropic 已在服务端关掉了该命令。你本机做什么都无法把它打开;运行 claude update,过一阵子在新会话里再试。
报错:“is not a trusted plugin directory, and this run cannot stop to ask you about it”
这是首次对某个 Claude Code 尚未信任的目录运行,而它没法问你,因为 stdin 或 stdout 不是终端、你传了 --json,或者 CI 环境变量被设为真值(例如 true)。请在终端里跑一次 claude plugin eval <dir> 并回答提示;如果你信任该插件的代码与测试集,也可以传 --trust-plugin。见一次运行能访问什么。
报错:“is too old for claude plugin eval”
你 PATH 上的 git 早于 2.31,因此 claude plugin eval 在跑任何用例之前就停下,并以退出码 1 结束,消息里会点出你的版本号:
git 2.30 is too old for claude plugin eval: it ignores the environment configuration (GIT_CONFIG_COUNT, added in git 2.31) that switches off the repository's git hooks and helper programs for the run. Install git 2.31 or newer.
每次运行中,Claude Code 都会关掉 git hooks、凭据助手,以及仓库 git 配置可能启动的其它程序。它靠的是 git 从 2.31 起才开始读取的某种环境配置。更老的 git 会忽略该配置,所以测试集会就此停下,而不是在那些程序可能被执行的情况下给运行打分。请安装 git 2.31 或更高版本,再运行一次。
在 v2.1.283 之前,claude plugin eval 不检查 git 版本,于是在较老的 git 上,测试集会在那些程序仍然开着的情况下运行。
报错:“No eval cases found”
生效的 eval 目录下不存在 <case>/prompt.md 或 <case>/case.yaml,或者你的 --case 与 --tag 过滤条件没有匹配到任何用例。请从插件根目录运行,或者运行 claude plugin eval init 来创建一个测试集。
基线臂显示没有插件,或者 delta 为零
如果汇总表里没有 W/OUT 列,或者该用例以「ablation requested but no plugin resolved」失败,说明这个用例没有找到插件。给该用例加上 plugins: ["../.."],其值为从用例目录到插件目录的路径。
如果插件确实加载了,而 Δ 仍接近零、你的 tool_used: Skillgrader 又没通过,那通常是一个真实发现:该 skill 的 description 在 prompt 的措辞下没被触发。请调整 description,重跑同一套测试集。
报错:“Agent type ’…’ not found”(插件里的某个 agent)
默认情况下每个用例既带你的插件跑,也不带它跑,而不带它的那些运行就是无插件基线。当 Claude 在基线运行中派发你插件里的某个 agent 时,Agent 工具调用会报错:Agent type '<plugin>:<agent-name>' not found. Available agents: ...。那份清单只列出不依赖该插件就存在的 agent,比如内置子代理。
这个错误是预期内的,因为 Δ 就是拿你插件的运行与基线作比较。在 JSON 结果里,基线运行位于 cases[].arms.without。
在加载了你插件的运行中,若某用例在 allowed_tools 里列了 Agent,它就能用带命名空间的名字派发你插件里的 agent,例如插件名为 my-plugin 时,它的 code-reviewer agent 就写作 my-plugin:code-reviewer。要跳过基线运行,传 --ablation none。
文件明明产出了,却全是零分
你的 grader 把目标对准了 files(已创建路径的清单),而你真正想要的是文件的内容。请改用 { source: file, path: <path> } 作为 target 或 focus。
另外,file_exists 只统计运行期间创建的文件,所以 scaffold 创建的文件、或 Claude 只是编辑过的文件,对它来说都是不可见的;请改为给文件内容打分,或对 Edit 使用 tool_used。
针对 trace 的正则匹配不上我看得见的文字
target 不对:默认target 是 last_message,不是 trace。
JSON 转义:当你确实把 target 设为 trace 时,它是每行一条 JSON,所以引号表现为 \"。
正则语法:正则用的是 JavaScript 语法,所以要把 i 写在 flags 里,而不是写 (?i)。
工具被拒、MCP 工具缺失,或 Bash 跑不起来
只读工具集之外的一切都需要你授权,例如 --allow-tools Bash Write。你的个人 MCP 服务器绝不会在一次运行中加载。插件自己的服务器也不会启动,除非你主动开启,而且它们的工具届时还需要 --allow-tools "mcp__plugin_<plugin>_<server>__*" 授权;被 mock 的工具则两样都不需要。
运行以退出码 1 结束,但结果看着没问题
--threshold 默认为 1.0,所以只要有用例得分不完美,命令就以 1 退出。请设一个符合你实际要求的阈值。退出码 1 也涵盖用例文件加载失败的情况,这会在表格上方的 stderr 里报出来。
报错:“--json output path must end in .json”
你把 target 写在了 --json 之后,于是它被读成了输出路径。请把 target 写在前面,如 claude plugin eval . --json,或者给 --json 一个显式的 .json 路径。
运行得了 1.0,某个 grader 却显示 passed: false
在两臂运行中,这个 grader 按设计就不参与计分,其 scored 字段为 false。见对照无插件基线打分。
运行中途因用量上限或速率限制报错失败
如果测试集运行期间你的账号触及了套餐用量上限或 API 速率限制,之后每一次运行都会以该错误结束,按它产出的内容打分,通常得 0 分。测试集仍会跑完,也不会被标记为 partial,所以结果看起来可能像一次回归。在采信这些分数之前,请先看 NOTES 列或 JSON 里的 cases[].arms.with[].error 有无那条限额消息;等限额重置后再重跑,若需要压在线下,可以用 --runs 1 或 --case 过滤。
运行超时,或触到轮次上限
默认是 10 轮、300 秒。对需要更多的任务,请调高用例里的 max_turns 和 timeout_seconds,并把 --max-cost-usd 当作成本上限,而不是把每次运行的上限卡得很紧。
11
SEE ALSO
延伸阅读
创建插件:构建你正在测试的插件,开发期用 --plugin-dir 加载它
插件命令参考:plugin eval 与 plugin eval init 两条命令的条目。清单里的 experimental.evals 键在清单参考里
Skills:skill 的 description 如何决定 Claude 何时调用它——这正是「检查 skill 是否触发」这类用例在衡量的东西
沙箱:当你给一次运行授予 Bash 时所适用的 OS 级沙箱
发布插件:测试集通过之后,把插件发布出去
衡量插件成本与用量:插件给每个会话的上下文增加了什么,以及人们是否还在用它
我是 链接AI实验室,专注于 AI 工程实践与技术文档的整理与分享。
如果这篇文章对你有帮助,欢迎在留言区聊聊你的看法。