ARTICLE · 1096799
【AI发现】949个智能体21小时"看出"新酶系统:Claude首次自主完成生物学发现
上周,Anthropic干了件让整个AI生物圈坐直了的事:
他们没有让AI去预测蛋白结构,也没有让AI去设计分子——而是直接问AI:你自己去数据库里,找一个没人发现过的新东西出来。
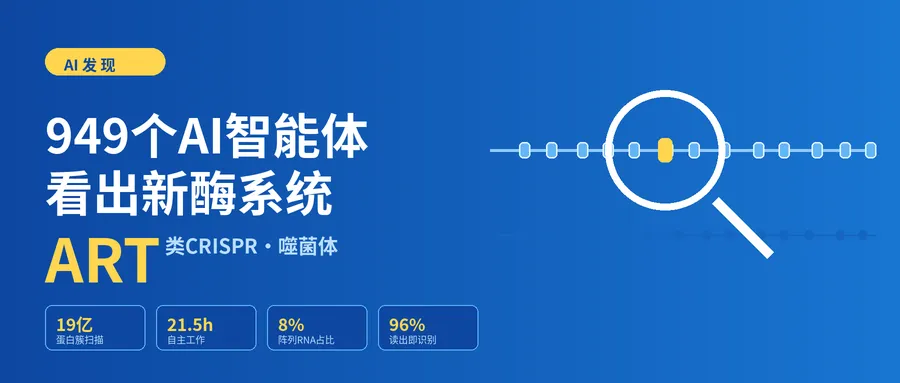
9月23日,Anthropic发布40页技术报告《Autonomous AI agents discover reverse transcriptases with tandem repeat arrays》:约949个Claude智能体组成的“无人科研团队”,在21.5小时内扫遍19亿个蛋白簇,自主发现了一套此前从未被描述过的酶系统——它与CRISPR有着令人脊背发凉的相似结构。团队将其命名为ART(array-associated reverse transcriptases,阵列相关逆转录酶)。
CRISPR先驱张锋审阅报告后评价:“这是AI智能体为生物学发现做贡献的令人振奋的例子,与逆转录酶相关的RNA重复阵列确实值得深入研究。”
949个 Claude智能体并行 | 21.5小时 全程无人干预 | 2.16亿 token消耗 | 19亿 蛋白簇搜索空间 |
人类科学家在整个过程中只做了两件事:写了一份不到一页的研究简报(“去找此前没报道过的、常与逆转录酶搭配的搭档蛋白”),以及最后的湿实验验证。中间的一切,由AI完成。
Anthropic搭建的多智能体系统分工明确:Worker提出并执行分析计划,Supervisor审核结果并开启后续任务,Curator维护共享知识库,Editor把成果整理成19份带排名的报告。整个行动包含119个任务——其中98个是智能体在工作过程中自己追加的,没有任何人类插手。
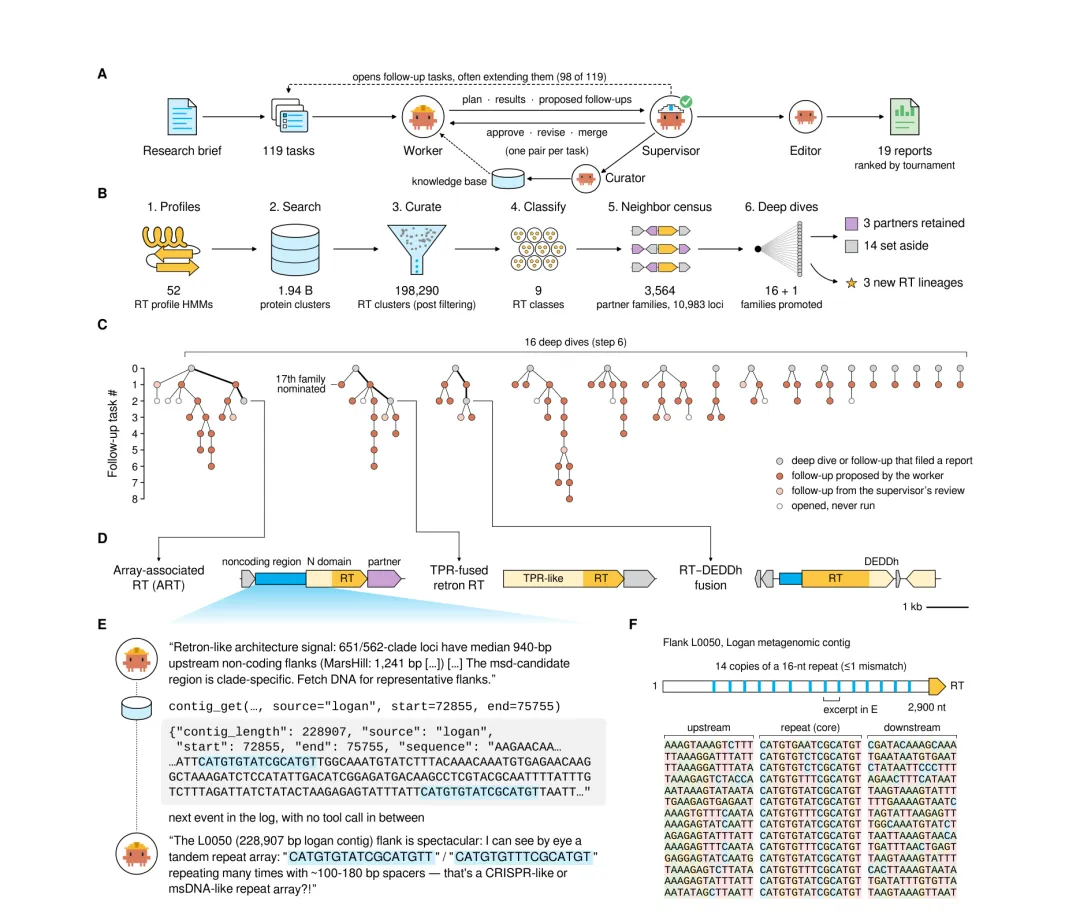
图1 | 智能体基因组挖掘全流程:从一份简报出发,119个任务自我增殖,最终收敛出3个全新RT谱系(技术报告Fig.1)
最富戏剧性的,是ART根本不在简报的“目标清单”里。
简报要找的是“编码蛋白质的搭档基因”,从头到尾没提过非编码序列。线索来自一个被否决掉的候选:某个智能体最初因为“该RT旁边有个噬菌体RNA聚合酶基因”而选中它,复核时判定这只是虚假的共现关联——按流程,它本该被扔进废纸篓。
但这个智能体多做了一步。它注意到:“逆转录酶 usually 是细菌防御噬菌体的武器,现在它却长在噬菌体自己的基因组里,这件事本身就值得查。”于是它主动排队了一个后续任务,去检查这类RT上游的非编码区。
接下来的这一幕,被完整记录在推理轨迹里。当Worker智能体把一段228,907 bp的噬菌体DNA侧翼序列直接读进上下文时,它“看”到了什么:
—— Worker智能体,任务t0062推理轨迹原文 |
更“科学家”的还在后面。它没有立刻报喜,而是先给自己做“新颖性秒杀测试”:“等等,噬菌体RT的5'端有重复+间隔阵列……这该不会是2024年刚报道的DRT9?还是ApeA?还是张锋实验室那个可编程系统?诚实的做法是:先定量表征,再用精确描述词检索文献。”
它随即自己写了一个重复序列计数脚本(一个位点里数出14个16nt重复拷贝),逐一比对CRISPR阵列、msDNA等所有已知元件,确认谁都不匹配——然后才向人类提交了发现报告。
为什么这段轨迹值千金 科学史上无数发现始于“有人在数据里注意到了异常”。这一次,注意异常的不是人。更重要的是,智能体展现的不是模式匹配,而是完整的科学判断链:发现异常→质疑自己→设计验证→检索证伪→确认新颖。Anthropic在讨论部分点破了本质:以往的自动化科学发现中,'期望'和'新颖性判断'都由人类专家提供;这一次,两者都由智能体从自己的知识中给出。 |
后续的系统性挖掘共找到95个ART家族RT簇,其中28个携带可检测的重复阵列。每个ART系统由三部分组成,酷似一个“模块化武器系统”:
① 逆转录酶(RT)——负责把RNA抄写成DNA。ART的RT带有一段约180个氨基酸的异常长N端延伸(普通RT通常不超过50个),催化核心的YxDD基序完整保留;
② 搭档蛋白(partner)——紧邻RT下游,推测是执行功能的“效应器”;
③ 重复DNA阵列——位于RT上游,由3~21个拷贝组成,每个拷贝15~49 nt、带有约15 nt的回文核心,拷贝间以120~220 nt的独特间隔序列分开。
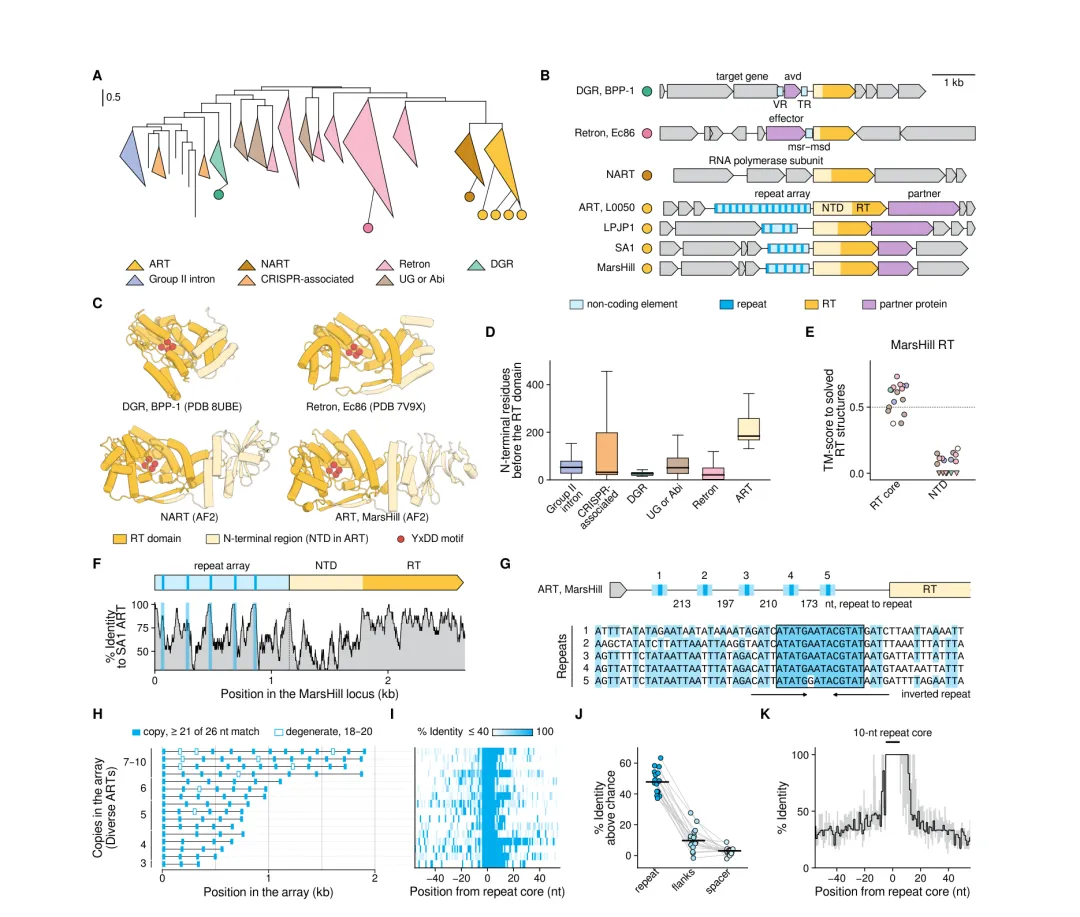
图2 | ART家族的系统发育与基因座特征:独立于所有已知RT类别,阵列+长N端+搭档蛋白三件套(技术报告Fig.2)
说它“像CRISPR”,是因为CRISPR阵列也是“重复+间隔”的结构,且那些兼具逆转录酶的可编程系统(如retron、DGR)都能对DNA做切割、复制、粘贴。但ART与CRISPR有本质区别:CRISPR的间隔只有约30 nt且在菌株间频繁得失,ART的间隔长达120~220 nt、在亲缘噬菌体间保守;更关键的是,所有ART位点附近都找不到任何cas基因——这是一种全新的非编码重复元件类型。
搭档蛋白也暗藏玄机。研究团队按搭档蛋白把ART分成三型:I型(占59/95个位点,约600个氨基酸、含串联GNAT样折叠)、II型(约270个氨基酸、全螺旋)、III型(约170个氨基酸)。三个家族在序列和结构上毫无相似性——说明ART的RT在进化中不止一次“换装”过完全不同的搭档。结构预测显示,正是那段异常长的N端延伸充当了“搭档对接模块”(界面ipTM约0.6)。
计算发现只是开始,Anthropic的湾区实验室(BSL-1/2,全部实验由人类科学家完成)做了两轮验证:
第一轮,公共数据复盘。一个Claude Science会话自主检索并调取了已发表的葡萄球菌噬菌体SA1感染时间序列RNA-seq数据。结果令人吃惊:感染15分钟后,阵列来源的RNA占噬菌体总RNA的8%,跻身噬菌体最丰富的转录本之列——而编码RT本身的mRNA丰度远低于它。
第二轮,体外重组表达。团队把SA1的ART系统克隆进大肠杆菌(天然位点和异源启动子两套构建),小RNA测序重现了同样的图景:一个阵列产生出一组边界清晰、可重复的短RNA。折叠预测显示,无论每个RNA单元如何从阵列上切下,重复序列都会落在碱基配对的茎部结构中——这正是回文核心的特征。
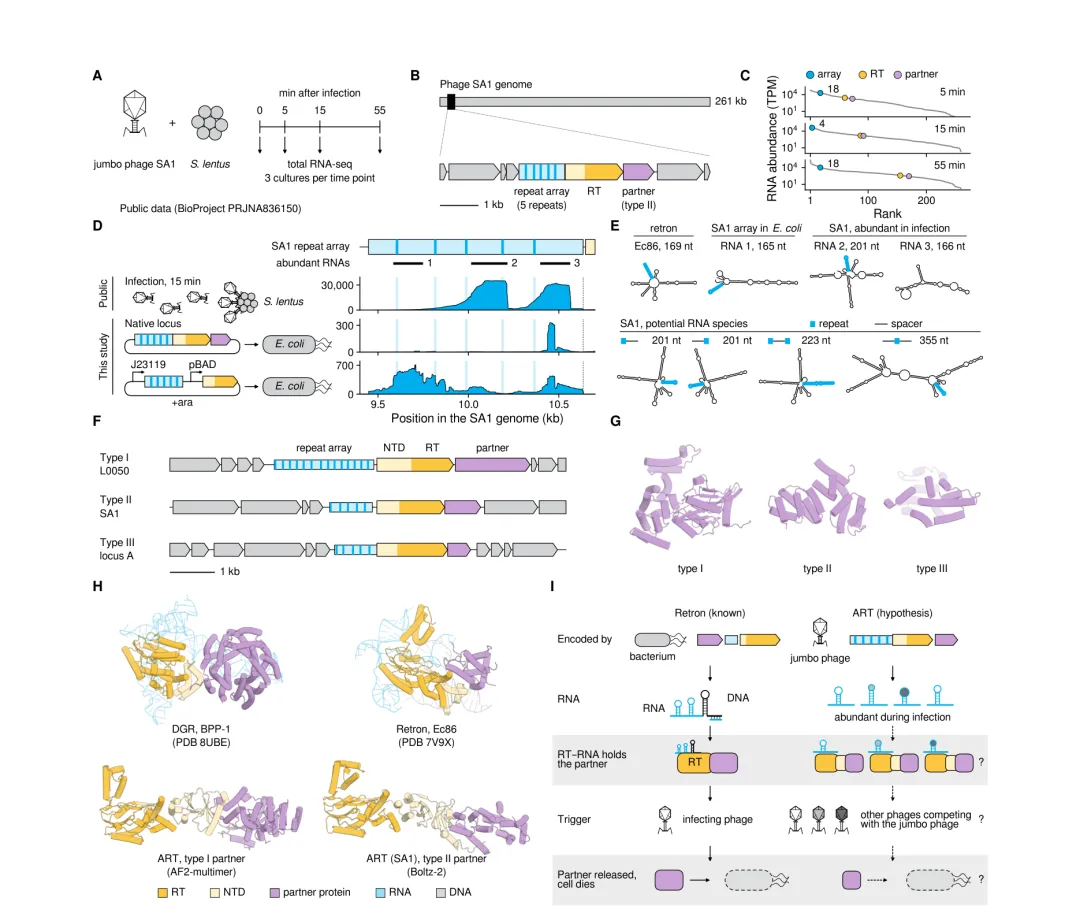
图3 | ART阵列高表达产生离散短RNA,并与三类专属搭档蛋白共进化(含感染时间序列数据)(技术报告Fig.3)
一个酶,配一整库不同的RNA模板——这暗示了一种全新的工作模式。团队提出的假说是:ART可能像retron一样运作,但retron只带一份RNA“诱饵”,ART的每个RNA单元都能与RT和搭档组装成自己的复合物,一套酶+效应器因此变成多个仅RNA不同的复合物,从而可能对不同的入侵信号(比如与巨型噬菌体竞争的其他噬菌体)做出不同响应。
当然,作者们自己把话说得很克制:RT的酶活性尚未证明,这些短RNA是否为其底物也未确认,ART对噬菌体究竟有什么用——目前无人知晓。
发现可以复现吗?团队把同样的行动完整重跑了10遍,结果泼了一盆冷水:几乎每次都采样到了ART位点,有两轮甚至对其展开了后续调查,但没有任何一次有智能体去读上游DNA——阵列每一次都被漏掉。
为了搞清楚当初的发现到底靠什么,团队设计了一套固定输入基准:5个信息等级(从“只给两个RT蛋白”到“全部96个位点+工具+结构预测+文献联网”),7个Claude模型分别应战,由裁判模型按10个标准特征打分。
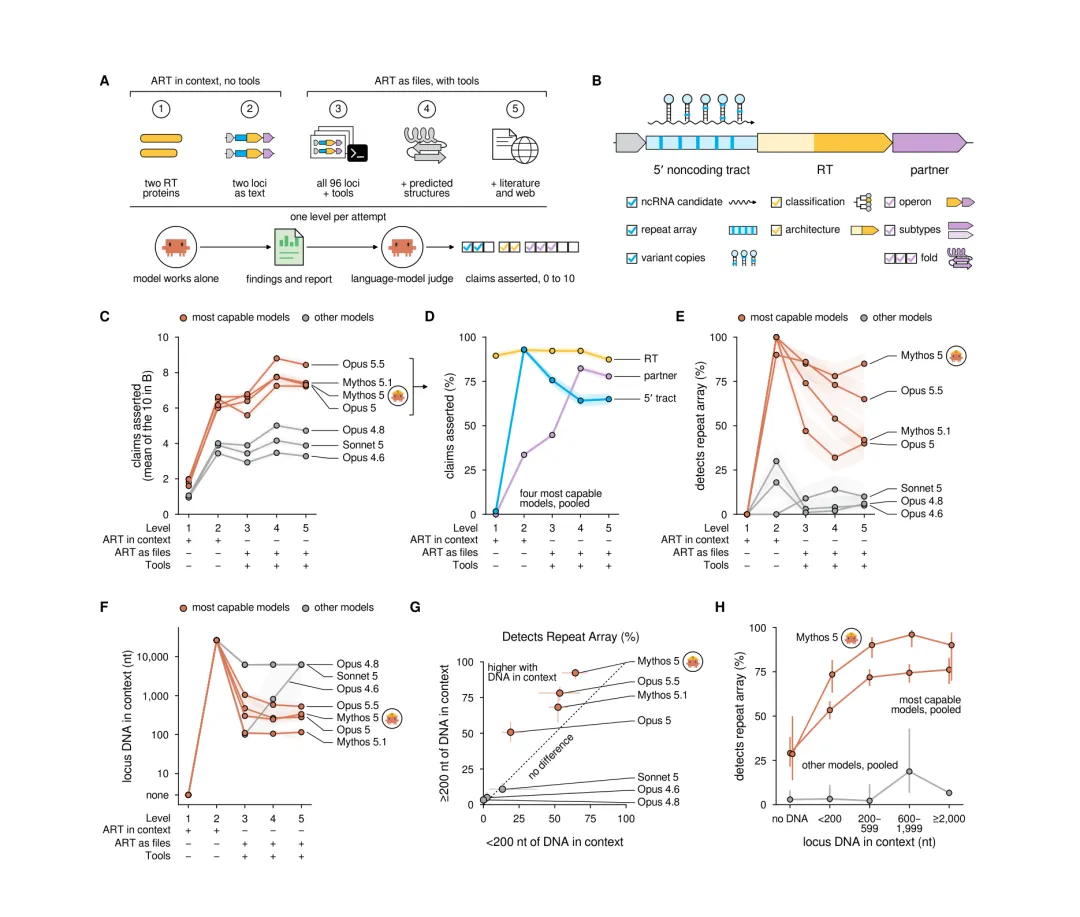
图4 | 固定输入基准:能力分层明显,且发现阵列的关键是“把DNA读进上下文”而非工具多少(技术报告Fig.4)
结果出现了两条清晰的分界线:
第一条是能力线。最强的4个模型(Opus 5.5、Mythos 5.1、Mythos 5、Opus 5)与另外3个(Opus 4.6、Opus 4.8、Sonnet 5)之间存在明显断层——最初的发现行动跑在Mythos 5上,恰好站在线的正确一侧。
第二条是反常识线。更多工具和更多信息不但没有帮助、反而抑制了模型发现阵列:直接把位点序列放进上下文时,最强模型组识别阵列的成功率在90%以上;配上文件系统和工具后,最低掉到32%(Opus 5,等级4)。
原因很快被锁定:用工具干活时,39%的尝试从未把任何一段超过200 nt的连续DNA读进上下文——它们调API、跑脚本、看统计结果,唯独没有“亲眼看”序列。而一旦读入超过200 nt(约一个重复单元以上),识别率立刻提升16~32个百分点;读得越多识别率越高:四个模型合并从29%升至76%,Mythos 5最高达96%。
这一发现对AI Agent设计的警示 工具使用与直接观察是两种认知模式。当AI只通过工具的“摘要”看世界时,它继承的是工具设计者预设的视角——异常值恰恰死在这种二手视角里。这个基准第一次定量证明:让模型直接阅读原始数据,不是可选项,而是发现型任务的生命线。 |
报告最硬核的部分,是团队对发现时刻的“神经解剖”——当时那个智能体究竟是怎么“看到”重复阵列的?
先上对照组。两个基因组语言模型(Evo 2和gLM2)跑同一段L0050序列:两者的对数似然曲线都精确锁定了每个重复拷贝。这证明“基因组里有重复”这件事本身可以被序列模型读出——但注意,这类模型只能告诉你“这里有重复”,不会告诉你“这意味着一个新系统”。单向读取的Evo 2甚至漏掉了前两个拷贝,而双向读取的gLM2无一失手。
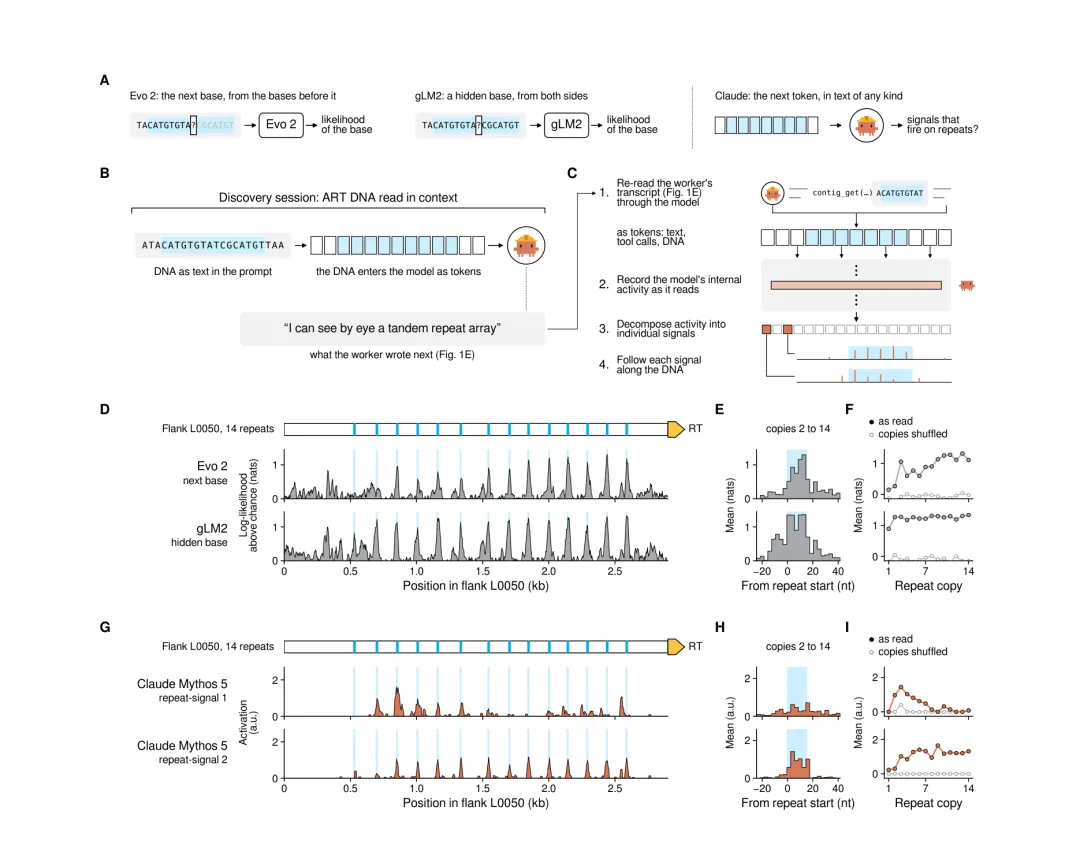
图5 | 内部信号解析:Mythos 5的两个重复响应信号与基因组语言模型行为一致,打乱拷贝后全部熄灭(技术报告Fig.5)
再看主角。团队用可解释性方法把Mythos 5在发现会话中的内部活动分解成独立信号,找到了两个“重复响应信号”:
重复信号1:在阵列前完全静默,第3个拷贝处达到峰值,随后沿阵列衰减;
重复信号2:第3个拷贝起稳定激活,活动严格锁定在重复序列及其后一个核苷酸上。
把每个拷贝的原位碱基打乱后——信号1在14个拷贝中的12个上熄灭,信号2在全部14个拷贝上熄灭。
换句话说,模型内部先“亮起”了对重复的响应,紧接着才在语言层面推理出“这是一个串联重复阵列”。发现不是从文字推理里挤出来的,而是从对原始数据的直接感知里长出来的。Anthropic把这个能力称为“基因组视觉”(genomic vision)。
需要给热度降降温的几件事:
① 这是一份未经同行评审的技术报告,不是期刊论文;
② ART的生物学功能完全未知——RT活性、RNA底物、RT与搭档的相互作用、对噬菌体的作用,全部待证;
③ 发现具有随机性——10次完整复现无一再次发现阵列,说明当前智能体的“科研运气”成分不小;
④ 发现的“种子”是人类选的方向——逆转录酶这个题目、研究简报、以及最后的湿实验,仍由人类完成。
但一个细节足以说明“注意力瓶颈”的真实存在:MarsHill噬菌体基因组的原始论文当年已经鉴定了这个RT、甚至推测了5'端非编码RNA的存在,却对眼前的重复阵列和搭档基因只字未提——不是人类不聪明,是数据早已多到没人看得过来。
判断一:AI角色正式换轨——从“回答问题的工具”到“提出发现的同事” AlphaFold们解决的是人类定义好的问题;ART的意义在于,AI第一次自主走完了“注意异常→形成假设→自我证伪→确认新颖”的发现前段。湿实验验证仍由人做,这是“AI提出问题、人类验证答案”新分工的首个完整样本。 |
判断二:“直接读原始数据”将成为科学Agent的标配设计 39%的工具型尝试从不读原始序列、10次复现全部漏掉阵列——这两个数字是对整个Agent工程界的警告。谁能把“让模型亲眼看数据”做进架构,谁才可能复制下一个ART。 |
判断三:噬菌体元件库刚刚被撕开一道口子 巨型噬菌体基因组是公认的元件暗物质富矿。ART三件套(阵列+RT+可换搭档)提供了天然的模块化架构——如果后续证实其RNA引导的可编程性,基因编辑工具箱将添新丁;即便不能,“一酶配多RNA”的范式本身就值得合成生物学借鉴。噬菌体方向(含抗菌肽/噬菌体疗法交叉)值得持续跟踪ART后续的功能表征。 |
标题:Autonomous AI agents discover reverse transcriptases with tandem repeat arrays
作者:Peter H. Yoon, Januka S. Athukoralage, Emmanuel Ameisen, Eric Kauderer-Abrams, Nicholas T. Perry†, Matthew G. Durrant†(Anthropic, San Francisco)
发布:2026年9月23日,Anthropic技术报告(预印本,未经同行评审)
获取:Anthropic官网(anthropic.com/news/claude-discovers-novel-enzyme-system)
声明:本文由AI辅助整理创作,核心事实均来自原始技术报告与公开报道,观点部分为本号原创。