ARTICLE · 1103106
别急着做全身换装:AI 人像从近景到全身,最容易崩在哪里?
IMG_1525_20260923.JPG,户外长椅原生态生活快照),在 Nano Banana Pro 中进行了 5 组构图对比实验,每组原生采样 20 次,累计完成 100 张样本的测试与双盲复核。实验结果非常直观:脸部辨识度下降,并不是单纯由“全身”这个词引发的,而是和人物在画面中的视觉占比、肢体动作复杂度、服装形态以及多目标冲突紧密交织。很多人在近景特写里能稳定出片,一换上冬日厚大衣拉到全身,人物立刻变成毫无辨识度的流水线网红脸甚至五官融化;此时若盲目追加8k, masterpiece, delicate face,不仅无法找回原型骨相,反而会让画面蒙上一层厚重的塑料磨皮感。本文不比较形容词堆叠,而只记录构图、动作和参考图条件改变后,结果如何变化。从我们一线排查的真实对照数据出发,回答三个具体的工程问题:1. 什么时候该停在牛仔景,什么时候值得继续做全身?2. 为什么动作越复杂、服装越厚重,脸部细节越容易滑向“大众平均脸”?3. 生成失败后,应该先改构图、改动作,还是改参考图?上周我们在为一个连续角色制作冬日羊羔毛长大衣换装资产时,遇到了一个极其典型的失败场景。
原型的基准图是一张户外自然光自拍,骨相非常平实:柔和微圆的下颌轮廓、平行双眼皮、天然卧蚕、笑起来露出一小截上齿尖,没有任何磨皮美颜滤镜。
我们在近景测试中,模型的表现相当稳定:无论是神态还是脸型,双盲匹配成功率能达到 18/20。然而,当我们为了展示一套及膝的米白色羊羔毛大衣,将提示词直接拉到全身站桩时,事故立刻爆发了:
❌ 初次尝试的典型失败提示词(直接要求全身站姿,且充斥抽象美化词): a full body shot of the 1girl standing on the street, wearing a long winter lamb wool coat, looking directly at camera, standing straight, highly detailed, perfect face, beautiful eyes, realistic skin, 8k在这组生成的 20 张样本中,集中暴露出三个严重问题:
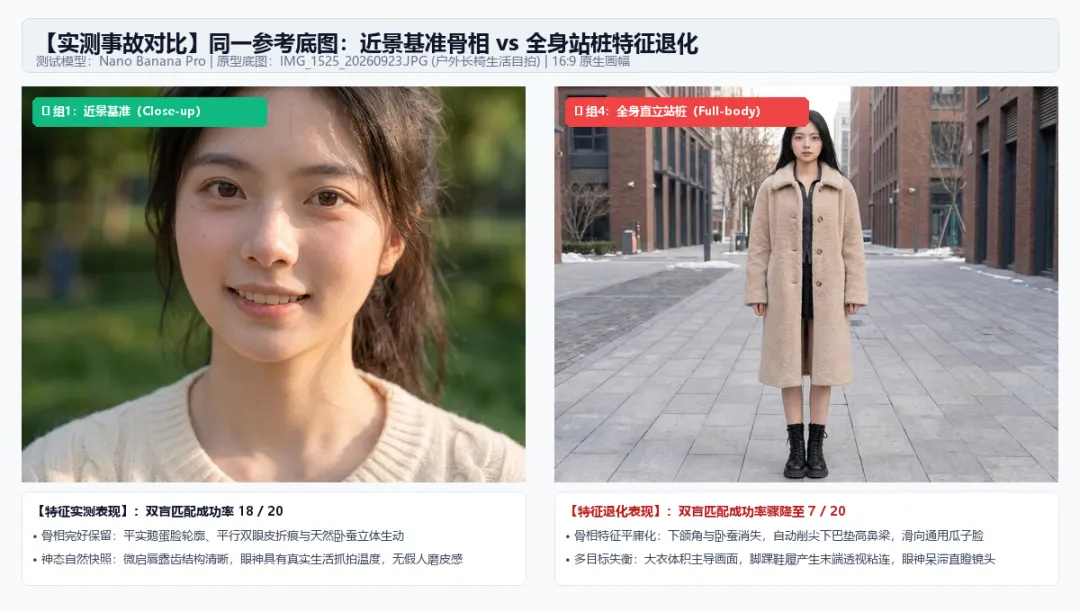
技术群里有人第一反应是:“是不是要再垫一张全身图?”“把人脸权重调高?”
先别急着加参数。 我们先回到图像生成的空间几何与条件约束中,理清楚底层的失败路径。
为什么同一个模型在特写时能记住脸,到了全身就容易“失忆”?从可观测的生成结果来看,核心在于两个客观存在的工程制约:构图分辨率限制与多目标条件冲突。
不同图像生成系统的内部架构(Diffusion、Flow-matching 等)各不相同,但从本次输出结果和多数类似生产经验来看,可以观察到一个较稳定的趋势:当人物在整幅画布中的视觉占比缩小后,可用于表达面部微观特征的有效区域也随之缩小。
IMG_1525_20260923.JPG,户外自然光无修图)、固定人物身份提示词(鹅蛋脸型、平行双眼皮、天然卧蚕与微扬笑意)、固定米白色羊羔毛冬日大衣的材质与版型描述、固定冬日午后街道背景与冷暖光照条件、固定模型推理模式(Nano Banana Pro 默认设置)。组 1~4 为 16:9 画幅,仅替换取景景别词(近景、中近景、牛仔景、普通全身);组 5 原生采用 9:16 竖幅,专门用于对比纵横比改变对人物在画面横向上视觉占比的挤压效应。除全身组因视觉需要包含鞋履与落地点外,其余提示词模块保持严格对齐。本实验对比的是不同构图策略在生产应用中的综合表现。因此,本实验不能单独证明脸部退化只由景别或画幅造成;它反映的是完整生产方案在不同构图任务下的综合差异。| 组1:近景 (Close-up) | 18 / 20 | 19 / 20 | |||
| 组2:中近景 (MCU) | 17 / 20 | 15 / 20 | |||
| 组3:牛仔景 (Cowboy) | 约 160~220 px | 16 / 20 | 14 / 20 | 【换装黄金平衡点】 | |
| 组4:普通全身 (Full-body) | 约 45~70 px | 7 / 20 | 8 / 20 | 脸部严重退化,鞋履手脚承压 | |
| 组5:9:16 原生竖幅全身 | 约 35~55 px | 5 / 20 | 6 / 20 | 竖幅为留上下边距,横向占比极小 |
*注:以上脸部像素宽度仅为本次测试中基于 Nano Banana Pro 1376×768 及对应分辨率的实测观察值,不代表跨模型固定物理阈值。*
从这组实测数据中,可以得出两点明确的观察:
在本次换装任务中,全身照同时要求模型处理多个强约束目标:
在多目标生成中,由于羊羔毛大衣的厚重纹理与复杂的街道背景占据了画面的绝大面积,整体服装轮廓和场景语义成为了全局主导。在本次输出中,更常见的结果是:服装轮廓和环境语义得以保留,而小面积脸部身份细节出现退化。这种现象属于多目标约束下的经验性失衡,也是为什么在全身照中增加抽象形容词往往适得其反的原因。
经过百余次生产样本的沉淀,我们将人像换装构图明确划分为5 个核心工作档位:
| 1. 近景 (Close-up) | ||||
| 2. 中近景 (MCU) | ||||
| 3. 牛仔景 (Cowboy) | 头部至大腿中下部(膝上) | 外套换装、角色海报、社交自拍 | 【推荐】首选单手插兜或轻抚门襟 | |
| 4. 全身 (Full-body) | ||||
| 5. 环境人像 (Env Portrait) |
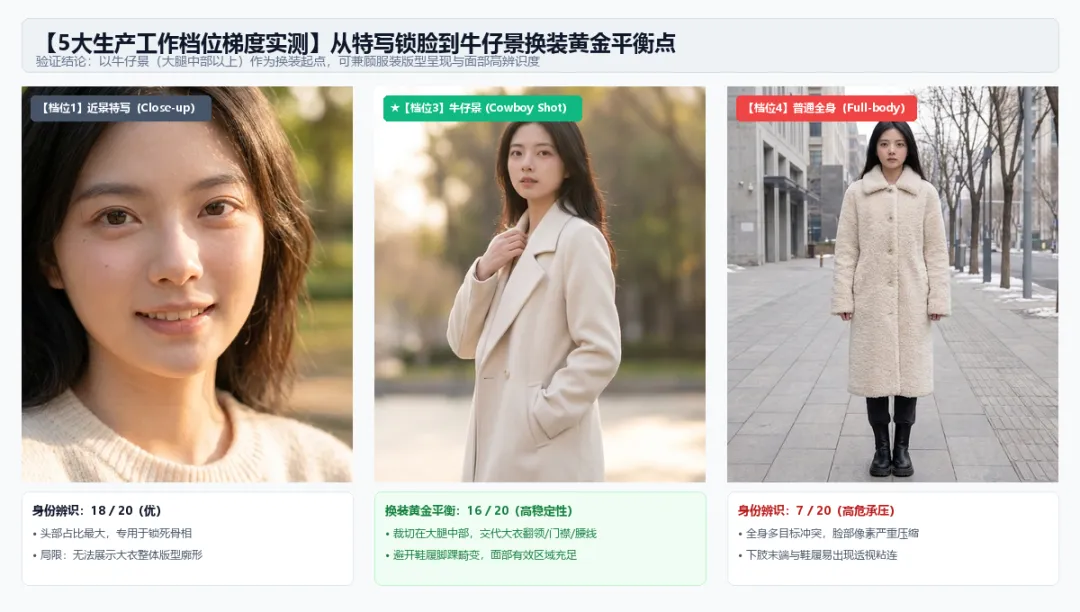
如果任务重点是人物身份与外套/上装的版型展示,而不是鞋履或及踝长裙的完整下摆,牛仔景通常是更稳妥的起始档位:
*注意:如果你的交付明确要求展示整双高跟鞋或及地晚礼服,牛仔景则不适用,此时必须采用全身档位,但应相应精简背景与动作。*
在传统摄影中有“避开关节裁切”的美学经验;在 AI 生成领域,这一经验同样具有极强的工程减负价值:
在模型生成边缘,手肘、膝盖骨或脚踝等骨骼连接点如果正好贴着画面底边,模型在边界处容易产生理解歧义,偶尔会为了闭合结构而生成多余的关节分叉或畸变截面;
在需要中途裁切构图时,优先让画框边缘落在肌肉丰满的骨骼段中部:
这并非绝对的解剖学定律,在时尚摄影中常有意截断关节以制造张力;但在追求快速稳定出片的工业场景下,选择肌肉中段裁切通常能减少边缘畸变的出现概率。
很多教程会告诉你:“不要站桩,给人物加上丰富的肢体动作!”
但在生产现场,动作复杂度越高,手部和肢体的翻车概率也越高。双手同时抬起、双手绕到颈后,极容易产生手指粘连、断指或手指穿模进大衣布料的现象。
动作设计应当遵循“从低风险逐步试探”的原则:
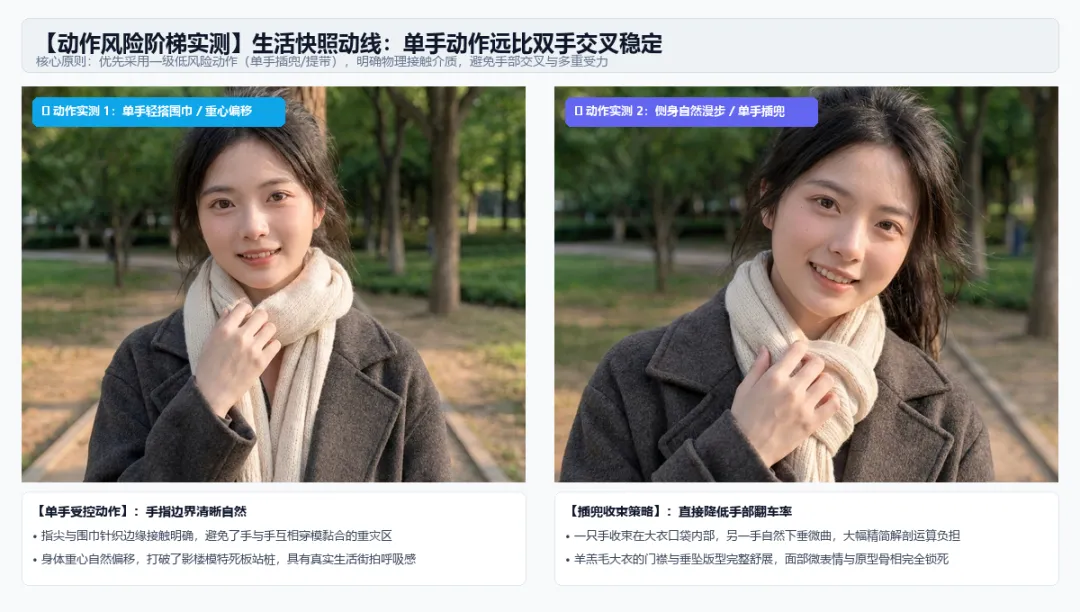
如果生成出的画面衣服好看但手崩了,请按照以下顺序调整,不要盲目重抽:
为了让角色看起来更像真实世界里的活人,可以通过具体的拍摄媒介与生活环境细节,替换同质化的抽象摄影词汇。
当你输入8k, masterpiece, photorealistic, 85mm portrait 时,模型往往会倾向于调用训练集里被过度调色、过度磨皮的影楼精修人像。
相反,如果输入具体的生活抓拍条件:
推荐参考写法: candid snapshot taken with a smartphone, natural afternoon winter light, authentic indoor ambient reflections, genuine fabric wrinkles (手机随手抓拍快照,冬日下午自然漫射光,真实室内环境反射,真实织物自然褶皱)模型会更倾向于呈现日常生活中的光影质感:自然的侧逆光、真实的衣服缝线折痕与细微发丝纹理。
在尝试特定媒介词汇时,必须注意以下反例:
iPhone screenshot 等系统 UI 词汇,模型偶尔会在人物脸颊或大衣上生成半透明的系统图标、电量图标或状态栏;在实际团队协作中,建议采用分层模块化的提示词模板与标准化的执行工作流:
【Nano Banana Pro 角色换装生产提示词模板(牛仔景推荐)】 [身份锁定层 - 固定项,严禁随意变动] A candid portrait of the same young Asian woman from the reference image, maintaining identical soft oval face shape, natural aegyo sal under eyes, and subtle smile, authentic skin texture without artificial smoothing [构图与景别层 - 单次生成仅选一项] cowboy shot framing, capturing from mid-thigh up to head, natural vertical composition with comfortable margins [姿态与低风险动作层 - 一级动词] body weight naturally shifted to one leg, one hand casually tucked into coat pocket, the other hand gently touching the coat lapel, natural relaxed posture [服装版型层 - 明确核心结构] wearing a structured cream-white wool winter coat, crisp collar structure, clear lapel fold, neatly finished cuffs and hemline, subtle texture of genuine wool fabric [环境与光影层 - 简化背景以保主体] soft winter afternoon daylight, minimalist modern city street background, gentle bokeh, authentic daylight color temperature在将上述方法迁移到其他场景前,必须客观说明本次测试的样本边界:
本文给出的核心价值,是一套先保身份、再展版型、动作分级、梯度降级的工程排查思维,帮助你在遇到翻车时知道先改哪个变量,而不是陷入随机重抽的消耗战中。
在 AI 角色连续性工程中,最容易让人陷入挫败感的,往往不是“生成不出一张好看的图”,而是“每一张都好看,但每一张都不是同一个人”。
很多人在做换装时,习惯一开始就直奔全身大景、拉满华丽服饰、设计高难度舞姿,最后在四肢畸变与面部漂移中反复重试。
我们实际交付时采用的是另一套顺序:
先用特写与近景夯实角色的骨相与神韵;再退到中近景确认服装上半身的剪裁与质感;当人物身份已经稳定成型时,再用牛仔景完整呈现整套穿搭版型。
全身图不是不能做,而是它同时把脸、手、脚、服装和背景推到同一张画布上。失败的时候,先去减少一个变量、简化动作或调准景别。多数时候,删掉复杂动作或简化背景,比在提示词末尾再补一串“超高清”更有效。