ARTICLE · 1108791
Univer:Office Agent 的运行时
👆 点击上方「迷斯特的小宇宙」,加「星标」不错过精彩内容
办公文档进入 Agent 工作流后,交付物应是可检查的结构化变更。Univer 把浏览器编辑与 Node.js 无界面处理放在同一套 Office 能力体系中,但开源 SDK、协作产品和 Pro 功能的边界必须分开看。
dream-num/univer 仓库始于 2022 年,目前将 Univer 定位为可嵌入现有产品的 Office SDK。它支持表格、文档等编辑界面,也提供 Node.js 无界面处理路径。仓库另行链接 Univer Workspace、CLI 与 Agent 相关项目;SDK 提供文档模型和操作接口,完整的 Agent 工作台、协作环境与产品交付由不同组件承担。团队选型要先确认是要嵌入编辑器、运行批处理,还是构建多人审核的办公工作流。
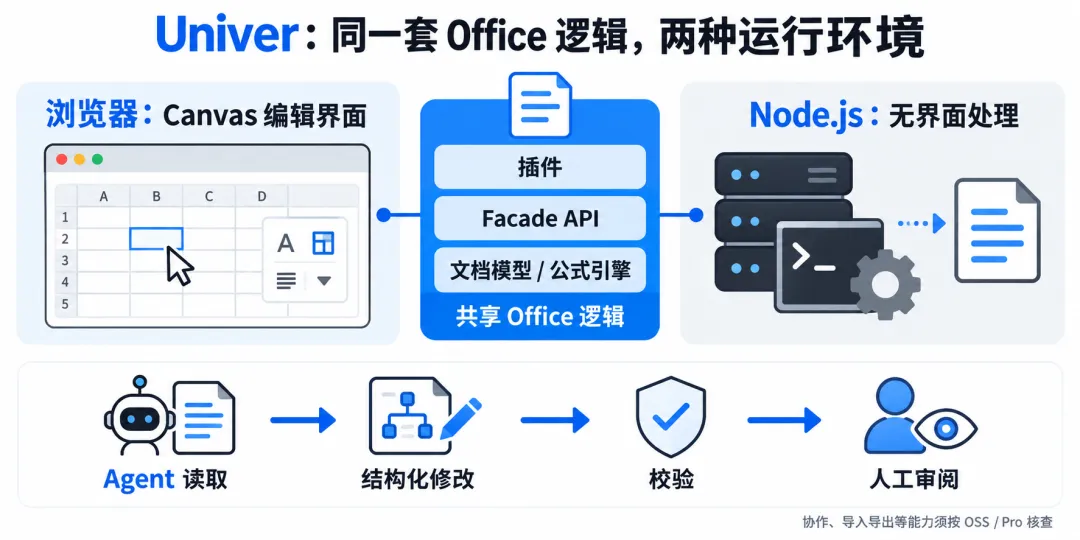
图一:Univer 浏览器界面、Node.js 处理与 Agent 审阅的概念分层
文档首先是结构
表格 Agent 的输入不应只是一张截图。“把本月销售表里华东区域的增长率算出来”涉及工作簿、工作表、表头、单元格范围、公式、格式和可能的跨表引用。用鼠标坐标定位 D17 容易受滚动、冻结窗格、缩放和列宽影响;结构化 API 可以先确认工作表身份和目标范围,再读取原值、写入公式并检查结果。界面仍很重要,但主要用于编辑、展示和人工审阅。
Univer 的核心围绕插件、文档模型、公式引擎、Canvas 渲染及 Facade API 构建。浏览器端负责交互与渲染,Node.js 可在无浏览器界面的环境运行相应文档处理逻辑。共享架构降低了两套实现各写一遍业务规则的成本,却不能推导出所有浏览器插件都能直接在 Node.js 使用。任何依赖 DOM、Canvas 容器、浏览器事件的插件都需要核查兼容性。服务端也无法仅凭 headless 运行时替代人眼检查版式。
一个稳妥的任务接口可以明确写成:输入文档版本、允许修改的工作表与范围、目标字段规则、预期输出;返回已修改的结构化数据、变更清单、计算检查与审阅预览。Agent 先读相关区域,再提出操作,执行器验证范围后写入。这样“模型认为应该改哪里”和“系统允许它改哪里”是两件独立的事。对于财务或合同类文档,范围检查还要加上角色权限和敏感列约束。
浏览器与无界面运行
官方 README 的浏览器 Preset 示例通过 createUniver 装配 UniverSheetsCorePreset,再由 univerAPI.createWorkbook({}) 建立工作簿。页面还需要一个 app 容器承载编辑界面。这种路径适合先把表格嵌进现有 Web 产品,快速验证常见编辑体验;当需要精确控制包大小、命令或扩展插件时,再评估逐个注册的 Plugin Mode。Preset 减少初始配置,Plugin Mode 提供更细的组合能力,二者的取舍取决于产品所需功能与维护成本。
import { UniverSheetsCorePreset } from '@univerjs/preset-sheets-core' import UniverPresetSheetsCoreEnUS from '@univerjs/preset-sheets-core/locales/en-US' import { createUniver, LocaleType, mergeLocales } from '@univerjs/presets' import '@univerjs/preset-sheets-core/lib/index.css' const { univerAPI } = createUniver({ locale: LocaleType.EN_US, locales: { [LocaleType.EN_US]: mergeLocales(UniverPresetSheetsCoreEnUS) }, presets: [UniverSheetsCorePreset({ container: 'app' })], }) univerAPI.createWorkbook({})上面是依据 README 缩减的浏览器示例,还需要页面容器 <div id="app" style="height:100vh"></div>;它没有在本文本地执行,也不能把 container: 'app' 原样复制到 Node.js 服务端。服务端应按官方 Node.js 指南安装与注册对应能力,确认运行版本和插件支持。仓库 README 给出的 Headless Univer 运行门槛是 Node.js 18.17.0,而整个 monorepo 的开发要求更高,不能混为同一条件;各 SDK 包也应使用协调发布的版本。
Node.js 路径适合后台模板填充、规则检查、批量生成中间工作簿状态等任务。真正的文件导入、导出和企业协作功能要回到授权和产品能力表核实,不能看到“headless”就推断可以免费在服务器上批量读写任意 Office 文件。无界面处理可以共享核心逻辑,但最终用户可能仍需要在浏览器中检查公式显示、列宽、合并区域和打印布局。
Agent 的修改如何验收
Agent 能通过结构化 API 修改内容,只解决了写入动作。对工作簿来说,写成功可能仍留下错误:目标区域漏行,公式引用相对位置偏移,日期被当作文本,合并单元格导致局部覆盖,或者筛选条件让一部分修改在当前视图里不可见。验收应至少分为结构校验、计算校验和视觉校验。结构层检查工作表数量、范围、数据类型与未授权区域是否变化;计算层检查公式与结果;视觉层在浏览器中确认可读性、布局和批注位置。
以月报模板为例,Agent 读取源数据后要填充“本月”“上月”“同比”列。执行前保存模板版本、目标工作表、允许范围与预期行数;执行后输出变更清单,列出每个被改动单元格的旧值、新值、公式或格式变化。然后重新计算,核对总计与分项是否一致,抽样检查日期和货币格式。最后将结果交给审核人在编辑器中比对,并明确“接受、退回、手工修正”的状态。这种操作日志是建议的产品实现,不代表 Univer 自动提供业务级审批。
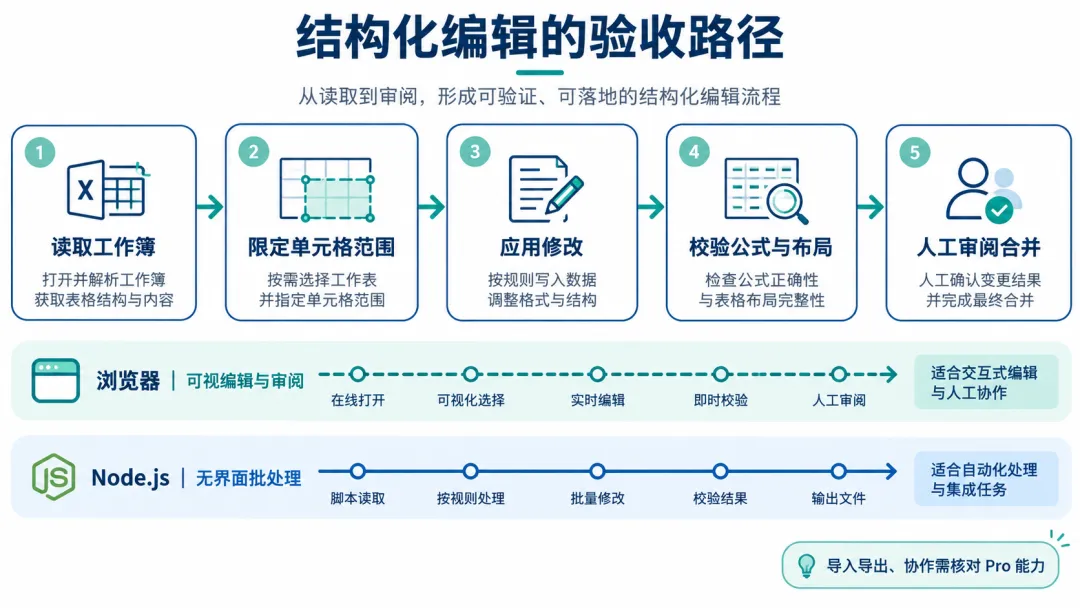
图二:从读取、限定范围、修改到公式布局校验与人工审阅
更复杂的任务还要检查“没有改动的地方”。例如只允许更新华东区域的销售数据,就对其他区域建立差异断言;新增一列时,验证跨表公式、条件格式和图表引用是否仍指向正确范围。单元格层面的 diff 可以告诉我们值变了,截图或渲染检查告诉我们用户看到什么,业务规则则决定这个变化是否符合要求。这三种证据彼此补充,任何一项单独通过都不足以自动合并到正式工作簿。
表格中的数值类型尤其容易造成隐蔽错误。同一列看起来都是日期,底层可能同时存在日期序列值、字符串和空白单元格;金额可能混用百分比格式与小数格式。Agent 写公式前应先读取真实单元格值及其格式,明确空值和错误值的处理方式。写完之后,除了读取公式字符串,还要检查计算结果是否更新。若公式依赖跨表区域或外部数据,延迟计算、循环引用和缺失数据源都可能让“保存成功”的工作簿给出错误数字。严格的场景下,业务系统还应保存预期的样本结果作为回归断言。
审阅体验需要把差异压缩到人能处理的范围。对数百行改动逐格弹窗确认会制造形式化审批;更实用的做法是按工作表和任务类型汇总,突出公式、合并区域、被保护区域与高金额单元格。审核人可以跳转到异常项,查看旧值、新值、公式依赖和可视预览,然后决定接受或退回。若允许人工修改 Agent 草稿,后续重跑应识别并保留人工变更,不能用重新执行的结果覆盖审阅决定。
并发修改还会影响结果。两名用户和一个 Agent 同时编辑同一工作簿时,必须明确以哪个版本为基线、冲突由谁解决、撤销操作是否跨用户生效。没有协作能力的轻量嵌入场景,可以先采用锁定或单写者队列;需要实时多人编辑的产品则要核查 Pro 能力和服务端部署。无论选择哪种方式,写入 API 成功并不自动意味着另一个客户端已经看到相同状态。
协作边界要单独核对
仓库的 OSS/Pro 能力表将实时协作、编辑历史、导入导出、图表、数据透视表和服务端协作等能力放在 Pro 一侧。开源核心采用 Apache-2.0,涵盖表格编辑、公式、插件体系与相应的 Node.js 基础。README 里的 Agent 工作流还谈到隔离草稿、审阅合并与共享修订;这些体验依赖具体 Web SDK 和协作能力,不能直接从一个开源 npm 包推断全套可用。
这会改变预算与架构。一个团队只想在内部页面里展示可编辑的结构化表格,可以先评估 OSS SDK 是否覆盖所需功能;另一个团队需要把客户上传的 XLSX 导入、由 Agent 批量修改、多人同时审阅后导出原格式,则必须逐项核查导入导出、协作、历史和商业授权。功能表是选型起点,最终还要对照当前版本的许可、包依赖、服务端部署方式与报价。不要把产品官网展示的完整工作空间等同于基础 SDK 的免费能力。
把系统拆成三层更容易做决策:文档编辑运行时承担结构化读写;Agent 编排负责意图理解、任务计划与权限;协作与交付层负责版本、审阅、文件互操作和用户身份。Univer 可以覆盖其中一部分,也可以与团队已有存储和审批系统组合。仓库链接的 Univer Workspace、CLI、DeepSeek Harness 是独立项目,部署和许可各自核对,不能因为它们被 README 放在同一页,就假定是同一个可直接安装的完整套件。
先做一个有界 PoC
最小验证任务可选“读取一张固定模板中的某列,根据已有数字写入一列计算公式,并展示差异”。准备一份带空白行、合并单元格和异常数据类型的样本;把允许改动的范围写成明确配置。浏览器端先确认嵌入体验和公式表现,Node.js 端验证同一类核心操作能否按文档运行。执行结束后保存修改前后的结构化状态、公式结果、截图和人工审阅意见,形成可复查证据。
评估数据要覆盖成功率之外的维护代价:大工作簿的加载与计算时间、内存峰值、插件组合大小、并发任务隔离、服务端失败后的状态恢复,以及不同浏览器的渲染差异。本文没有做这些性能测试,也不把 README 的“高性能”描述转写成吞吐结论。对于已经有成熟 Excel 文件互操作需求的团队,应优先验证样本文件能否无损往返,再决定是否迁移编辑器;反过来,若需求以在线结构化编辑为主,工作簿模型和 Facade API 的可控性可能更关键。
PoC 的测试文件应从真实业务结构中脱敏抽样,而非只创建一张空白表。至少准备一份有多个工作表、跨表公式、冻结窗格、合并单元格、隐藏行和不同日期格式的样本;另外准备一份异常样本,包含公式错误、缺失引用和超出预期的长文本。对每个样本写清楚期望修改范围与禁止修改范围。执行后生成机器可读的差异报告,再由人查看前后渲染。若某一特性要靠 Pro 才能正常往返,应在评估记录中明确标记,不能把付费依赖隐藏在“兼容 Office”的宽泛描述里。
服务端任务还需考虑失败后的原子性。修改到一半崩溃时,是回滚到原文档,还是保存隔离草稿供审查?两个重试请求是否会重复追加同一列?团队可以给每个任务分配稳定标识、锁定输入版本,并在提交前检查版本仍未改变。处理完成后先保留草稿与差异证据,人工确认后再写入正式文档。这样既方便回溯,也降低异步批处理覆盖用户编辑的概率。这些是围绕 SDK 的应用设计,不应误称为开源包已经内置的事务或审批保证。
部署前还要核对数据所在地和访问路径。工作簿可能包含员工名单、收入和客户信息;上传给外部模型做任务规划,与在本地 Node.js 处理文档,是不同的数据流。最小化传给模型的区域,只给它完成任务需要的列、摘要或脱敏值;将原始文档权限留在业务服务端。日志和审阅截图也要按敏感数据处理,确定谁可读取、保留多久、删除请求如何传递到副本。权限控制应该约束执行器实际可改的范围,不能只靠提示词要求 Agent 自觉避开敏感区域。
Agent 的权限最好从小范围开始:先只读,再允许编辑隔离副本中的指定区域,最后才增加多人合并与外部导出。每一步都要能撤销并留审计记录。尤其是公式与跨表引用,产品不能把“调用成功”渲染成“业务审核通过”;预览与人工确认是正式交付前不可省的界面状态。
选型结论
Univer 适合希望在 Web 产品中嵌入 Office 编辑能力,并围绕结构化 API 建立 Agent 操作的团队。它的优势来自编辑模型、插件和可视界面能够进入同一个产品架构;Node.js headless 提供后台执行路径。实际落地仍取决于具体插件在双端的可用性、文件格式互操作、协作需求和 Pro 授权。先用有界样本验证编辑、计算和差异审阅,再谈无人值守批量处理,风险会更可控。
我的判断是,Office Agent 的最小可用交付物应包含文档版本、精确的变更范围、可验证的结果和人的审阅结论。对话里的一句“已更新报表”无法替代这些证据;一次成功的演示也无法覆盖公式、格式与协作中的长期维护成本。
来源:Univer 官方仓库与能力表 · AI SDK 文档 · Node.js headless 指南 · Univer Workspace
文档 Agent 交付的是可复查的修改记录和结果,审阅界面应保留最后一道决定权。
迷斯特的小宇宙,客户端技术背景,大前端技术、AI前沿技术分享,偶尔写写生活日记。
如果这篇文章对你有启发,点个「在看」或转发给朋友,是对我最大的支持 🙏