ARTICLE · 1111311
围棋 AI:极小化极大、Alpha-Beta 剪枝与经验学习的源码实现解析
一、引言
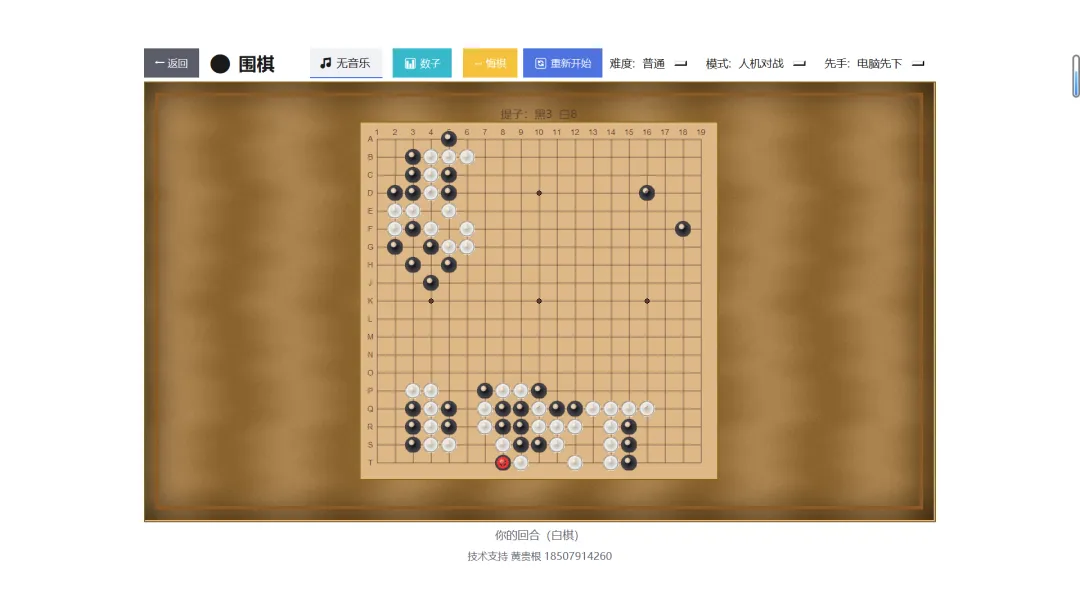
在一个 Python + tkinter 写的小游戏合集中,我实现了一个支持人机对战和电脑对战的围棋模块。它使用 19×19 标准棋盘,完整实现了气、提子、禁入点、打劫、数子等中国规则,并提供简单(深度 2)、普通(深度 4)、困难(深度 6)三档难度。
围棋的状态空间极其庞大——19×19 棋盘上每个交叉点有黑、白、空三种状态,理论局面数约为 10 的 170 次方,远超可观测宇宙的原子总数。因此,围棋 AI 不可能穷举所有变化,必须通过搜索剪枝、启发式评估和经验学习来逼近最优解。
本文将从源码层面,完整拆解这个围棋 AI 的三大核心模块:(1)极小化极大搜索与 Alpha-Beta 剪枝;(2)局面评估函数;(3)基于 SQLite 的 AI 经验学习系统——让电脑在每一局对弈后积累经验,越下越聪明。
二、核心搜索算法
2.1 极小化极大(Minimax):博弈树的基本思想
围棋是零和博弈——一方的收益等于另一方的损失。极小化极大算法的核心思路是:假设双方都采取最优策略,AI 方选择使自己收益最大化的走法,对手方选择使 AI 收益最小化的走法。
在代码中,_minimax 方法通过 maximizing 参数区分当前是哪一方:maximizing 为 True 时遍历所有候选点,取最大评估值;为 False 时取最小评估值。递归深度每减 1,就模拟一手棋,直到 depth 为 0 时调用评估函数返回局面分数。
def _minimax(self, board, depth, alpha, beta, maximizing, ko_point, cand_limit, best_prev=None): if depth == 0: score = self._evaluate(board)# 叶子节点:评估局面 return score, None color = self.ai_color if maximizing else self.human_color cands = self._candidates(board, color, cand_limit) if maximizing: for r, c in cands:# AI 方:最大化 ... if ev > max_eval: max_eval = ev alpha = max(alpha, ev) if beta <= alpha: break# Alpha-Beta 剪枝 return max_eval, best else: for r, c in cands:# 对手方:最小化 ... if ev < min_eval: min_eval = ev beta = min(beta, ev) if beta <= alpha: break# Alpha-Beta 剪枝 return min_eval, best
2.2 Alpha-Beta 剪枝:砍掉一半的搜索量
纯极小化极大搜索的节点数随深度指数增长——深度 6 时,即使每步只有 10 个候选点,也需要搜索 100 万个节点。Alpha-Beta 剪枝通过维护两个边界值来避免无效搜索:
alpha:当前最大化方已经能保证的最低收益;
beta:当前最小化方已经能保证的最高收益。
当某个分支的搜索结果表明 alpha >= beta 时,说明这个分支不可能影响最终决策,可以直接 break 跳过。在走法排序良好的情况下,Alpha-Beta 剪枝能将搜索节点数减少到原来的平方根级别——原本需要 100 万节点的搜索,可能只需要 1000 节点就能得到相同结果。
2.3 迭代加深:时间有限时的最优策略
固定深度搜索有一个问题:如果时间不够,搜索到一半被强制中断,可能连一个合法走法都返回不了。迭代加深的做法是从深度 1 开始,逐层加深搜索,每完成一层就更新当前最优解。一旦时间预算耗尽,立即返回上一层完整搜索得到的最优解。
def _ai_search(self, max_depth, cand_limit): best_move = None self._deadline = time.time() + self._time_limit for depth in range(1, max_depth + 1): self._search_timeout = False score, move = self._minimax(board, depth, ...) if self._search_timeout: break# 本层超时,结果不可靠,沿用上一层 if move: best_move = move return best_move
这种设计保证了 AI 永远能在规定时间内返回一个“至少经过深度 1 搜索”的走法,而时间充裕时则会搜索到更深的层数。
2.4 候选点限制:19×19 棋盘不能全搜
19×19 棋盘有 361 个交叉点,如果每一步都考虑所有空点,搜索量将完全不可控。围棋的一个重要启发式是:有效落子几乎都出现在已有棋子的附近。因此,_candidates 方法只收集已有棋子周围 2 格范围内的空点,然后按启发式评分排序,只取前 N 个(简单 20 个、普通 12 个、困难 8 个)。
def _candidates(self, board, color, limit): cands = set() for r in range(BOARD_N): for c in range(BOARD_N): if board[r][c] != EMPTY: for dr in range(-2, 3):# 周围2格 for dc in range(-2, 3): ... cands.add((nr, nc)) # 静态启发式排序 + 经验库加权,取前 limit 个 scored.sort(reverse=True) return [(r, c) for _, r, c in scored[:limit]]
2.5 走法排序:好的排序让剪枝效率翻倍
Alpha-Beta 剪枝的效率高度依赖走法顺序——如果最优走法排在前面,后续分支更容易被剪掉。代码中使用了两层排序策略:
(1)上一层搜索的最佳走法优先(best_prev 参数),因为迭代加深时浅层最优往往也是深层最优;
(2)启发式评分排序:_move_heuristic 模拟落子后评估提子数、气数、威胁对方程度和位置偏好。
此外,候选点排序时还加入了经验库加权(get_move_bonus),历史胜率高的走法会被优先搜索,这部分将在第三节详细展开。
2.6 in-place 落子与撤销:避免每秒复制几万次棋盘
这是一个关键的性能优化。最初的实现每次模拟落子都深拷贝整个 19×19 棋盘(new_board = [row[:] for row in board]),后盘候选点 200-300 个时,深度 4 约 2 万节点,累计几十亿次列表复制操作,导致 AI 在大劣局面下单步思考长达几十秒。
优化方案是使用 in-place 落子:_apply_move 直接修改棋盘数组,返回被提的棋子列表;递归返回后用 _undo_move 恢复棋盘。这样整个搜索过程只需要一份棋盘副本,节点开销从 O(361) 降到 O(1)。
def _apply_move(self, board, r, c, color, ko_point): """in-place落子,返回 (被提棋子列表, None) 或 None(非法)""" board[r][c] = color # 检查并提取对方无气棋子 # 禁入点检查 return captured, None def _undo_move(self, board, r, c, color, captured_stones): """恢复落子""" board[r][c] = EMPTY for gr, gc in captured_stones: board[gr][gc] = opponent
配合候选点生成时使用轻量静态打分(_static_heuristic,只看邻子和位置,O(候选×4)),后盘均衡局面单步思考从几十秒降到 0.77 秒,大劣局面从卡死降到 1.54 秒。
2.7 时间硬预算:防止 AI 卡死
即使有了上述优化,某些极端局面(如大劣局面下候选点多、提子频繁)仍可能导致搜索超时。为此,_minimax 每处理 256 个节点就检查一次时钟,如果超过时间预算就设置 _search_timeout 标志并立即返回。同时还有节点预算(node_limit)作为第二道防线。
if self._node_count & 255 == 0 and time.time() > self._deadline: self._search_timeout = True return self._evaluate(board), None# 提前截断
三档难度的时间预算分别为:简单 1 秒、普通 2.5 秒、困难 5 秒。电脑对战模式使用更短的时间预算(0.8/1.5/3.0 秒)以保证对弈流畅。
三、评估函数:AI 如何判断局面好坏
搜索的叶子节点需要一个评估函数来量化局面优劣。围棋的评估远比象棋复杂——象棋可以直接算子力价值,而围棋需要考虑地盘、外势、棋子死活等多种因素。本实现采用了一个简化但有效的评估模型。
3.1 单个棋子的价值
_stone_value 方法计算每个棋子的综合价值:
基础分 10 分(每颗棋子都有价值);
气:最多算 4 气,每气 2 分(气多的棋子更安全、更有活力);
位置:角部加 5 分、边部加 3 分(金角银边草肚皮);
危险棋子扣分:仅 1 气扣 8 分、2 气扣 3 分(濒临被提的棋子价值打折)。
3.2 地盘估算
除了棋子本身,还需要估算双方控制的地盘。简化做法是:遍历所有空点,如果一个空点的四邻只有一种颜色的棋子,就将该点判给那一方,每点 2 分。这是一个粗略的领地估算,不做复杂的区域填充,但在浅层搜索中足以引导 AI 走向围空。
3.3 综合评分
最终评估值 = AI 方总分 - 对手方总分。正数表示 AI 优势,负数表示对手优势。这个评估函数虽然简单,但配合 4-6 层搜索,已经能下出有模有样的围棋——会主动围空、会切断对方、会在被围攻时逃跑或弃子。
四、AI 经验学习:让电脑越下越聪明
4.1 为什么需要经验学习
纯搜索型 AI 有一个天花板:它每一局都从零开始思考,不会从过去的对局中学习。同一个局面,它可能反复犯同样的错误。而人类棋手会通过复盘积累经验——某个局面下某步棋胜率高,下次遇到就优先考虑。
我们为 AI 设计了一套基于 SQLite 的经验学习系统,包含两个核心机制:(1)对局经验库——记录“局面→落点→胜负”统计,选点时按历史胜率加权;(2)搜索缓存持久化——将搜索过的局面评分保存到磁盘,跨局复用,加速思考。
4.2 棋盘指纹:如何把 19×19 棋盘压缩成一个数字
要存储“某个局面下某步棋的胜率”,首先需要用一个紧凑的标识来代表棋盘局面。19×19 = 361 个交叉点,每点 3 种状态,如果直接存储需要 361 个字节。我们使用指纹函数 fingerprint_grid 将棋盘序列化为字节流后,取 SHA256 哈希的前 8 个字节,得到一个 64 位整数作为局面指纹。
def fingerprint_grid(board, n): buf = bytearray(n * n) i = 0 for r in range(n): for c in range(n): buf[i] = board[r][c] i += 1 return int.from_bytes(hashlib.sha256(bytes(buf)).digest()[:8], "big")
SHA256 的 64 位截断碰撞概率约为 2 的 64 次方分之一,在实际使用中可以忽略。使用哈希而非直接编码的另一个好处是:指纹值均匀分布在 64 位整数空间,作为 SQLite 的 INTEGER 主键和索引时查询效率极高。
这里有一个工程细节:SQLite 的 INTEGER 是有符号 64 位(最大值 2^63-1),而 64 位无符号哈希有 50% 的概率超过这个上限。因此存储前需要通过 _s64 函数将无符号 64 位转换为有符号 64 位(最高位为 1 时减去 2^64)。
4.3 对局经验库:experience 表
每局棋结束后,AI 会将本局中每一步的(局面指纹、落点、执棋方)记录下来,然后根据本局胜负更新统计表。experience 表的结构如下:
字段 | 类型 | 说明 |
game | TEXT | 游戏标识(go/gomoku/xiangqi),三游戏物理隔离 |
board_hash | INTEGER | 局面指纹(64 位有符号整数) |
move_key | TEXT | 落点坐标,如 10,3 |
win | INTEGER | 该局面下走这步棋最终获胜的次数 |
lose | INTEGER | 该局面下走这步棋最终失败的次数 |
total | INTEGER | 总出现次数 |
updated_at | TEXT | 最后更新时间 |
记录逻辑很简单:一局结束后,胜方的每一步 win+1,负方的每一步 lose+1,total 都 +1。使用 INSERT ... ON CONFLICT DO UPDATE 实现 upsert,避免重复插入。
需要注意的是,黑方和白方的经验是分开记录的——因为同一局面下,黑方的好棋和白方的好棋完全不同。_record_experience 方法按颜色分组后分别调用 record_game。
4.4 经验加权:历史胜率如何影响选点
有了经验数据后,AI 在生成候选点时会查询每个落点的历史胜率,并将胜率转化为启发式加分,叠加到候选点排序中。
def get_move_bonus(self, board_hash, move_key): """单落点经验加权分:胜率高加分,样本不足返回 0""" row = c.execute("SELECT win, total FROM experience ...").fetchone() if not row or row[1] < MIN_SAMPLES:# 至少3局样本才生效 return 0.0 return (row[0] / row[1]) * EXPERIENCE_BONUS# 胜率 x 300
这里有两个关键参数:
MIN_SAMPLES = 3:某个落点至少出现 3 次以上才启用经验加权。这是为了避免小样本误导——如果某步棋只下过 1 次且恰好赢了,100% 胜率并不代表它真的好。
EXPERIENCE_BONUS = 300:胜率 100% 时加 300 分。这个值与启发式评分(通常几十到几百)在同一量级,既能让经验影响选点,又不会完全压倒搜索评估。
经验加权发生在两个位置:一是 _candidates 候选点筛选时(决定哪些点进入搜索),二是 _minimax 内的走法排序时(决定搜索顺序,影响剪枝效率)。随着对局数增加,AI 会越来越倾向于选择历史上胜率高的走法。
4.5 搜索缓存持久化:TT 表跨局复用
除了对局经验,搜索过程中产生的大量局面评估结果也值得保存。在博弈算法中,这被称为置换表(Transposition Table,TT)——不同的走法顺序可能到达同一个局面,TT 表可以避免重复搜索。
传统的 TT 表只存在于内存中,程序退出就丢失了。我们将 TT 表持久化到 SQLite,实现跨局复用:上一局搜索过的局面,下一局遇到时可以直接命中缓存。
tt 表的结构如下:
字段 | 类型 | 说明 |
game | TEXT | 游戏标识 |
board_hash | INTEGER | 局面指纹 |
depth | INTEGER | 搜索深度(更深的缓存可用于浅请求) |
score | REAL | 局面评估分 |
tt_type | INTEGER | 缓存类型:精确/下界/上界 |
best_move | TEXT | 该局面下的最佳走法 |
version | INTEGER | schema 版本,评估函数大改后旧缓存自动失效 |
TT 表采用两级缓存架构:搜索过程中先写内存(_tt_mem dict,O(1) 查找),搜索完成后批量 flush 到 SQLite。查询时先查内存,未命中再查 SQLite 并回填内存。这样既保证了搜索时的性能,又实现了持久化。
缓存命中有一个重要条件:缓存深度 >= 请求深度。因为深度 6 的搜索结果比深度 2 更可靠,可以用深缓存回答浅请求;反之则不行。此外还有 version 字段——当评估函数或搜索逻辑发生重大变更时,递增 SCHEMA_VERSION,旧缓存自动失效。
为防止数据库无限膨胀,tt_flush 时会检查记录数,超过 20 万条时删除最旧的 20%。
4.6 SQLite 存储设计
三个游戏(围棋、五子棋、象棋)各使用一个独立的 .db 文件,物理完全隔离:
~/Documents/GameCenterData/ai_experience/ ├── go.db(围棋) ├── gomoku.db(五子棋) └── xiangqi.db(象棋)
每个文件内包含 experience 和 tt 两张表,表内还有 game 字段做逻辑隔离(即使以后合并文件也不会串)。数据库使用 WAL 模式(Write-Ahead Logging)提升并发读写性能,synchronous=NORMAL 在性能和安全之间取平衡。
选择 SQLite 而非 JSON 的原因:
(1)SQLite 支持索引,按局面指纹查询是 O(log n),JSON 需要全量遍历;
(2)SQLite 支持原子事务,不会因为程序崩溃导致数据损坏;
(3)SQLite 是 Python 标准库自带的,打包 EXE 零额外依赖;
(4)支持 upsert、批量写入等高级操作,经验更新更高效。
五、围棋规则的工程实现
5.1 气与提子
气是围棋的核心概念。_get_group 方法使用 BFS(广度优先搜索)找到一个棋子所在的整个连通块,同时收集所有相邻空点作为气。如果一块棋的气数为 0,就被对方提掉。
5.2 禁入点
如果落子后己方这块棋没有气,且没有提到对方的子,那么这个点是禁入点,不允许落子。_apply_move 在落子后检查己方气数,如果为 0 且未提子则回退并返回 None。
5.3 打劫
打劫规则禁止立即回提刚被提走的单子。_calc_ko 方法在提子后检查:如果恰好提了一个子,且己方落子后只有一气,那么被提子的位置就是劫点,下一手对方不能立即在这个点落子回提。
5.4 虚着与自动数子
当 AI 没有合适的落子点时,会视为虚着(跳过一手)。双方连续虚着(pass_count >= 2)时,棋局自动结束并调用 _count_score 数子。数子采用中国规则:
黑棋得分 = 黑子数 + 黑方控制的空点数;
白棋得分 = 白子数 + 白方控制的空点数;
黑贴 3.75 子(即 7.5 目),最终比较双方得分。
地盘归属通过区域填充判断:遍历所有空点区域,如果一个空白区域只与一种颜色的棋子相邻,则该区域全部归该方所有。
5.5 两套难度配置
代码中维护了两套难度配置:DIFFICULTY 用于人机对战(保持原棋力,候选点较宽),AI_VS_AI_DIFFICULTY 用于电脑对战(缩小候选点、加节点预算、缩短时间,保证对弈流畅)。_ai_turn 根据 self.mode 自动选择对应配置。
难度 | 搜索深度 | 候选点上限 | 时间预算(人机) | 时间预算(电脑对战) |
简单 | 2 | 20 / 12 | 1.0 秒 | 0.8 秒 |
普通 | 4 | 12 / 8 | 2.5 秒 | 1.5 秒 |
困难 | 6 | 8 / 6 | 5.0 秒 | 3.0 秒 |
六、总结与展望
这个围棋 AI 的核心是一套“搜索 + 评估 + 学习”的组合拳:
搜索层:极小化极大 + Alpha-Beta 剪枝 + 迭代加深 + 候选点限制 + 走法排序,在有限时间内尽可能深地搜索;
评估层:棋子价值(气、位置、安全性)+ 地盘估算,量化局面优劣;
学习层:对局经验库(胜率加权选点)+ 搜索缓存持久化(跨局复用),让 AI 从历史中学习。
实测效果:普通难度下,后盘均衡局面单步思考约 0.77 秒,大劣局面约 1.54 秒(优化前为几十秒甚至卡死)。随着经验库的积累,AI 在常见局面下会越来越倾向于选择人类棋手公认的好点。
当然,这个 AI 与职业水平还有巨大差距。未来可以改进的方向包括:
(1)引入蒙特卡洛树搜索(MCTS):AlphaGo 的核心算法,通过随机模拟评估局面,更适合围棋这种评估函数难设计的游戏;
(2)接入神经网络:用策略网络和价值网络替代手写评估函数,大幅提升棋力;
(3)更精细的评估函数:加入外势、模样、死活判断等高级特征;
(4)经验库共享:支持导入专业棋谱,让 AI 从人类大师的对局中学习。
但作为一个纯 Python、零外部 AI 依赖的小游戏 AI,它已经证明了:经典博弈算法 + 巧妙的工程优化 + 简单的经验学习,足以让电脑下出一盘有模有样的围棋。
—— 全文完 ——