ARTICLE · 1119234
AI原生的数据治理:换地基的时候到了
栏目名 · 第 12 期 · 2025.08
“AI 原生的数据治理,不是给传统治理加一个人工智能模块,而是把治理能力重构进数据产生、流转、消费的每一个环节。”
引子:大模型“换地基”,先换数据地基
上周,36 氪一篇题为《AI原生的数据治理:换地基的时候到了》的文章在数据圈刷屏。文章的核心判断是:当生成式 AI 从“玩具”变成“生产工具”,企业数据治理的目标、对象和方法都在被重新定义。过去,数据治理是“把数据管起来”;现在,它必须回答一个更底层的问题——数据能不能被 AI 安全、准确、实时地消费。
我们注意到,这不是一个孤立的技术话题。它背后是企业数据形态、计算架构和网络连接方式的整体迁移。换句话说,AI 原生数据治理的“地基”,既包括元数据、血缘、质量这些上层建筑,也包括数据如何在多云、多分支、多终端之间流动的底层网络。
一、数据洪流正在冲破传统治理的堤坝
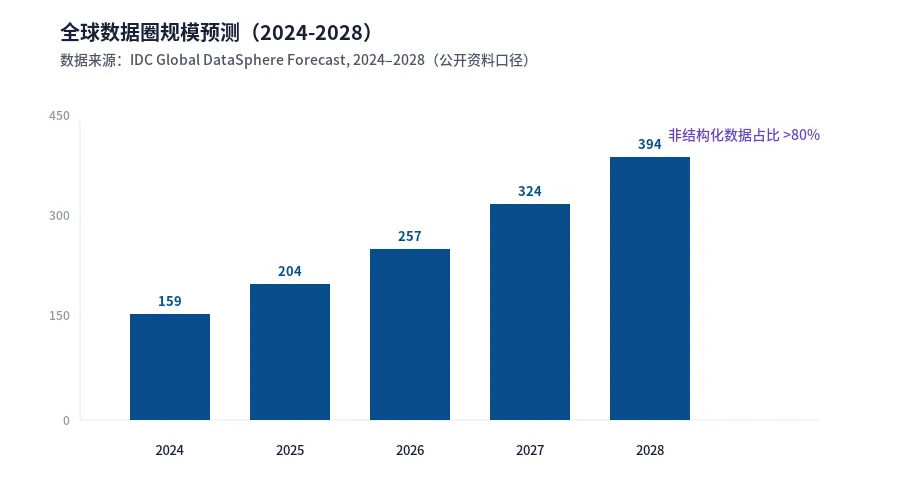
IDC 在《Global DataSphere Forecast, 2024–2028》中预测,全球数据圈将从 2024 年的约 159 ZB 增长到 2028 年的 394 ZB,年复合增长率约 25%。(公开资料口径)更关键的是,其中非结构化数据占比已超过 80%。这意味着,企业需要治理的对象,正从结构化的“表和字段”,快速转向文档、图片、日志、音视频、传感器流和向量 embedding。
传统数据治理工具是为结构化数据设计的:数据仓库、ETL 血缘、主数据管理、数据目录。它们擅长回答“这张表从哪里来、给谁用”。但在 AI 场景下,问题变成了“这段文本的语义是什么、哪些片段可以喂给模型、哪些必须被屏蔽、模型生成的结果又该被谁审计”。
Gartner 在 2024 年数据与分析峰会上指出,生成式 AI 正在把数据治理从“人工驱动”推向“自动化、嵌入式”,企业需要在数据管道中内嵌治理能力,而不是事后补治理。(Gartner 公开会议口径)
二、反常识:真正的瓶颈不是模型,而是“数据可用性”
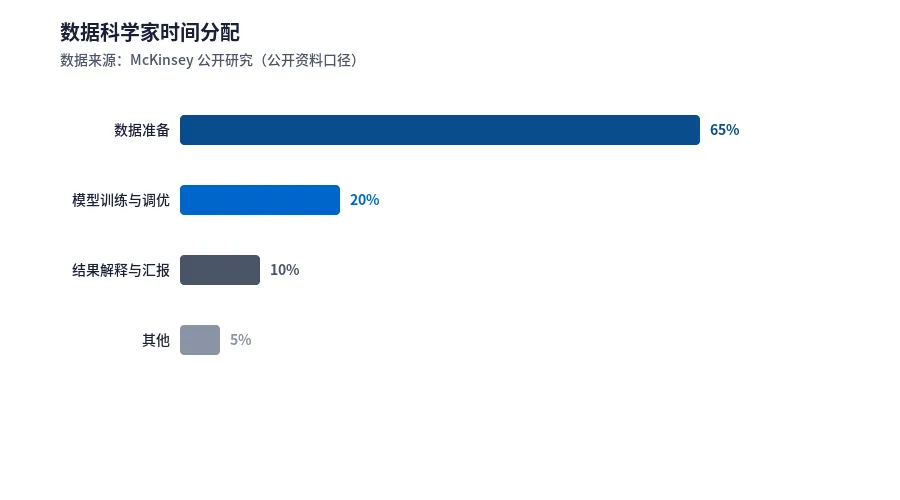
行业里有一个越来越明显的共识:大模型的性能差距正在收敛,但企业之间的 AI 落地效果却天差地别。差距在哪里?很大程度上在数据。McKinsey 在一份公开研究中指出,数据科学家平均把 60%–80% 的时间花在数据准备、清洗和标注上,而不是模型训练。(公开资料口径)
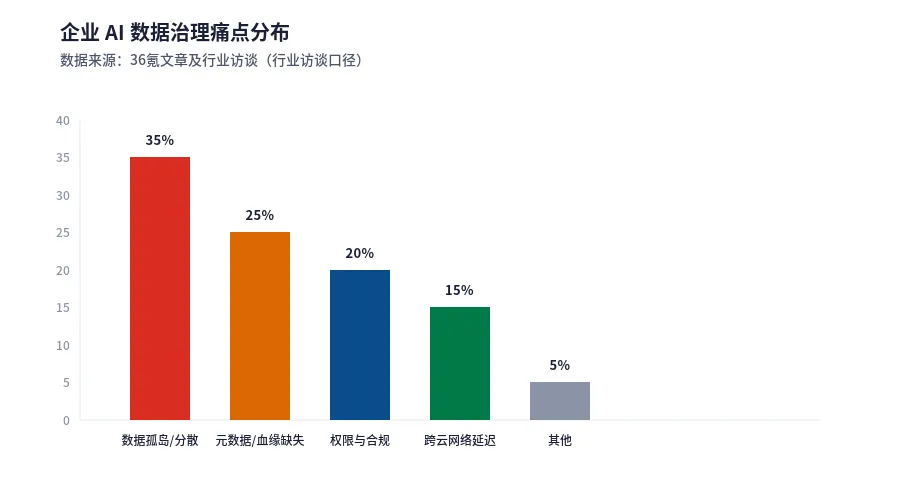
我们在与金融、制造、零售企业的数据团队交流中也听到了类似的反馈:当企业试图把 LLM 接入客服、研发、风控、营销场景时,最常见的卡点不是算力不够,而是:
- 数据分散在本地 IDC、多个公有云和 SaaS 里,找不到统一的“语义地图”;
- 元数据和血缘缺失,无法判断一段数据是否适合喂给模型;
- 权限、合规、脱敏规则不一致,导致“不敢用”;
- 跨云、跨地域访问延迟高、链路不稳定,拖慢数据消费。
这些问题的共同特征是:它们不是单个工具能解决的,而是需要数据治理从“事后管理”前移到“数据产生和流动的全链路”。
三、AI 原生数据治理:从“管数据”到“数据即服务”
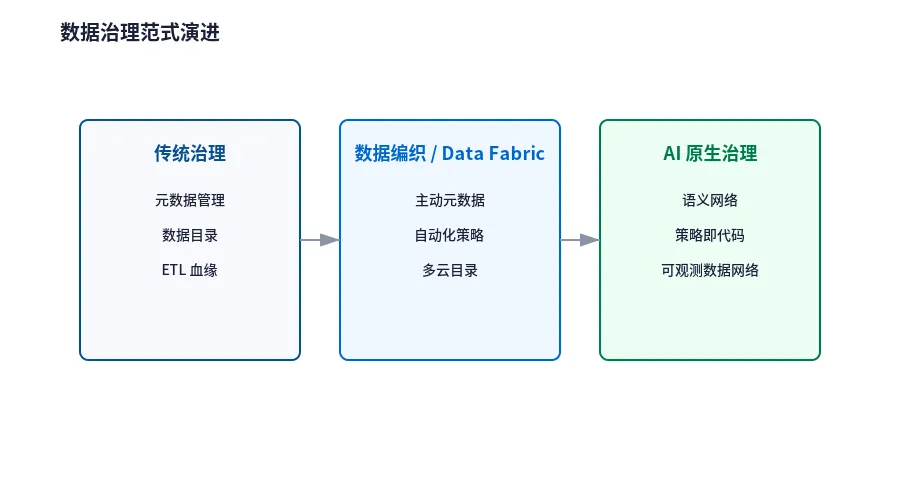
所谓 AI 原生,不是把 GPT 接进数据目录,而是让治理能力内生于数据管道。我们认为它至少包含三个层面的变化:
- 语义层:从元数据管理升级为“数据语义网络”。通过 schema、向量、知识图谱和标签体系,让机器理解“这段数据意味着什么”。
- 策略层:权限、脱敏、合规、审计从人工审批变成“策略即代码”(Policy as Code),并随数据流动自动执行。
- 连接层:数据在哪里产生、在哪里消费,网络链路就必须在哪里被看见、被调度、被保护。
这三个层面中,连接层最容易被忽视,却最可能成为新的瓶颈。因为 AI 训练、推理、RAG 检索、Agent 调用,都要求数据在不同云、数据中心、边缘节点和终端之间低延迟、高安全地流动。没有一张可靠的“数据网络”,再好的语义层和策略层也会被拖慢。
四、天弛视角:网络,是 AI 数据治理的“隐性地基”
▎天弛视角:AI 数据治理需要一张“可编排的数据网络”
在 AI 原生数据治理的链条里,网络不再是“通不通”的问题,而是“能不能被编排、被观测、被安全策略驱动”。天弛网络长期服务企业多云互联、分支组网和数据中心互联,我们看到三个关键变化:
- 多云到多模:企业的数据湖、向量库、模型服务分布在阿里云、腾讯云、华为云、AWS、Azure 以及本地 IDC。天弛通过云专线和 SD-WAN,把这些异构环境编织成一张逻辑统一的网络,降低跨云数据调度的延迟与复杂度。
- 数据血缘延伸到网络层:数据从产生到进入模型,需要经过多个节点。天弛的 SD-WAN 和 DCI 方案支持链路级可视化、QoS 策略和访问控制,让“数据在哪里、怎么走、谁在用”更可被审计。
- 安全策略随数据流动:AI 场景下,敏感数据可能从总部数据中心流向边缘推理节点、再回流到云端训练。天弛的 SASE/零信任架构(公司官网口径)可以在分支到云端之间持续执行身份、权限和加密策略。
我们认为,AI 数据治理的“换地基”,不仅要换数据平台,也要换连接方式——从“能连就行”升级为“可观测、可编排、可审计”的云网融合底座。
五、结语:先把“地基”夯实,再谈上层建筑
AI 原生数据治理不是一场工具替换,而是一次架构升级。它的目标不是让数据“更多”,而是让数据“更可被 AI 安全、准确地消费”。
当行业把目光投向大模型和 Agent 时,我们反而应该回到最底层:数据在哪里、如何被连接、如何被保护。无论是数据编织、AI 治理平台,还是云网融合服务商,大家都在解决同一个真问题——让数据从“成本中心”变成“AI 燃料”。
天弛网络作为国内 SD-WAN 与云网融合领域的服务商之一,也在持续参与这一“换地基”的过程。毕竟,再好的 AI,也跑不了一条慢、断、乱的网络。
声明:本文数据为行业访谈 + 公开资料口径(IDC、Gartner、McKinsey 等),仅作量级参考。天弛网络作为该领域的实际服务提供者,本期在行业观察之外也涉及自身解决方案介绍。