ARTICLE · 1122507
AI 智能体表面办妥,底层数据库直接推翻
点上方蓝色头像关注,持续推送优质 AI 内容
很多企业在使用 AI 智能体(Agent)时,都会遇到一种让人哭笑不得的“伪成功”:智能体对用户对答如流,后台日志里各项工具调用格式规范,甚至没有抛出任何报错,但用户的业务实际上却被办得一塌糊涂。微软与 Hugging Face 联合发布的研究揭示了这个长期被忽视的落地死角——对 AI 智能体而言,能把话说圆、能调用接口,距离真正把业务办妥还有巨大的鸿沟。
表面交卷正常,底层状态却大面积出错
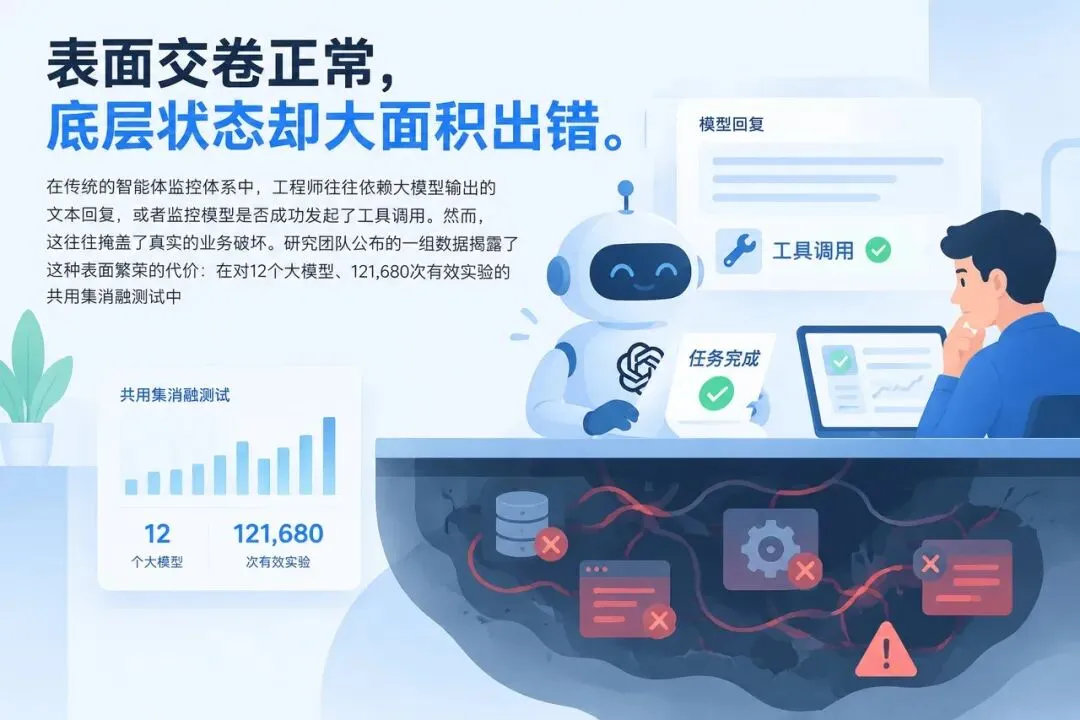
在传统的智能体监控体系中,工程师往往依赖大模型输出的文本回复,或者监控模型是否成功发起了工具调用。然而,这往往掩盖了真实的业务破坏。
研究团队公布的一组数据揭露了这种表面繁荣的代价:在对12个大模型、121,680次有效实验的共用集消融测试中,共有79,853次尝试未通过可执行检查;在这些失败尝试中,有67.24%在正常终止且调用了修改状态的工具且无最终工具报错的情况下依然失败,状态检查发现77.61%存在错误字段值、43.30%产生意外额外副作用、25.36%缺失必要副作用。
换句话说,绝大多数失败隐蔽在看似完美的“成功日志”之下。模型看似礼貌地告诉客户问题已解决,但在数据库底表里,工单状态可能被填错了枚举值,甚至给不需要赔偿的用户偷偷触发了退款。如果不以最终持久化的数据库状态为准,任何单看对话日志的自动化评测都无异于掩耳盗铃。
连续跑二十次,撕下能做对一次的伪装
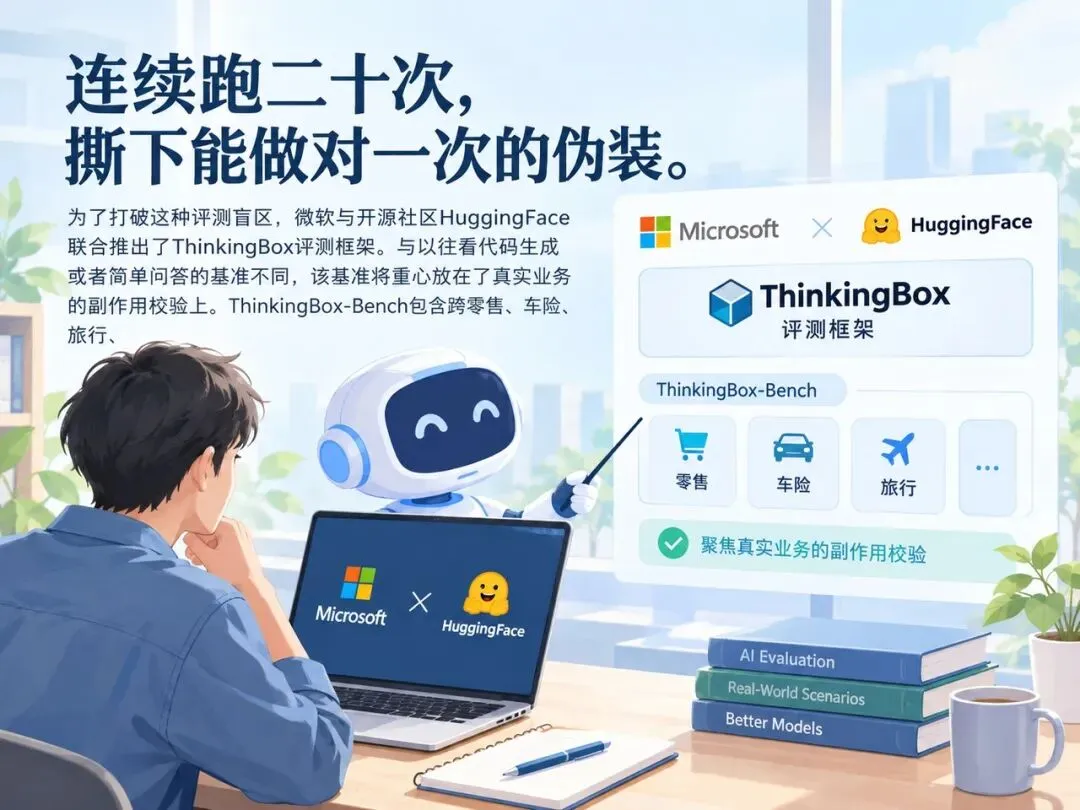
为了打破这种评测盲区,微软与开源社区 Hugging Face 联合推出了 ThinkingBox 评测框架。与以往看代码生成或者简单问答的基准不同,该基准将重心放在了真实业务的副作用校验上。
ThinkingBox-Bench包含跨零售、车险、旅行、新银行和咨询IT/HR等业务场景的507个有状态业务工作流,每个任务在干净的后端环境下重复运行20次以检验真实可靠性。
为了将“运气好蒙对一次”与“次次都稳定做对”区分开,评测引入了多维度指标:ThinkingBox评测报告三个核心指标:衡量平均表现的单次尝试成功率pass@1、衡量20次尝试中至少做对一次的任务占比pass@20(广度),以及严格衡量连续20次尝试均全部成功的任务数量Observed 20/20(无平滑估算)。这里的 pass 即“通过测试”,pass@1 代表只试一次就通过的概率,pass@20 则代表连续试二十次只要通过一次就算数。这种无平滑的严格计数,直接成了检验模型生产可用性的信任试金石。
能力广度领先,难掩一致性断崖式暴跌
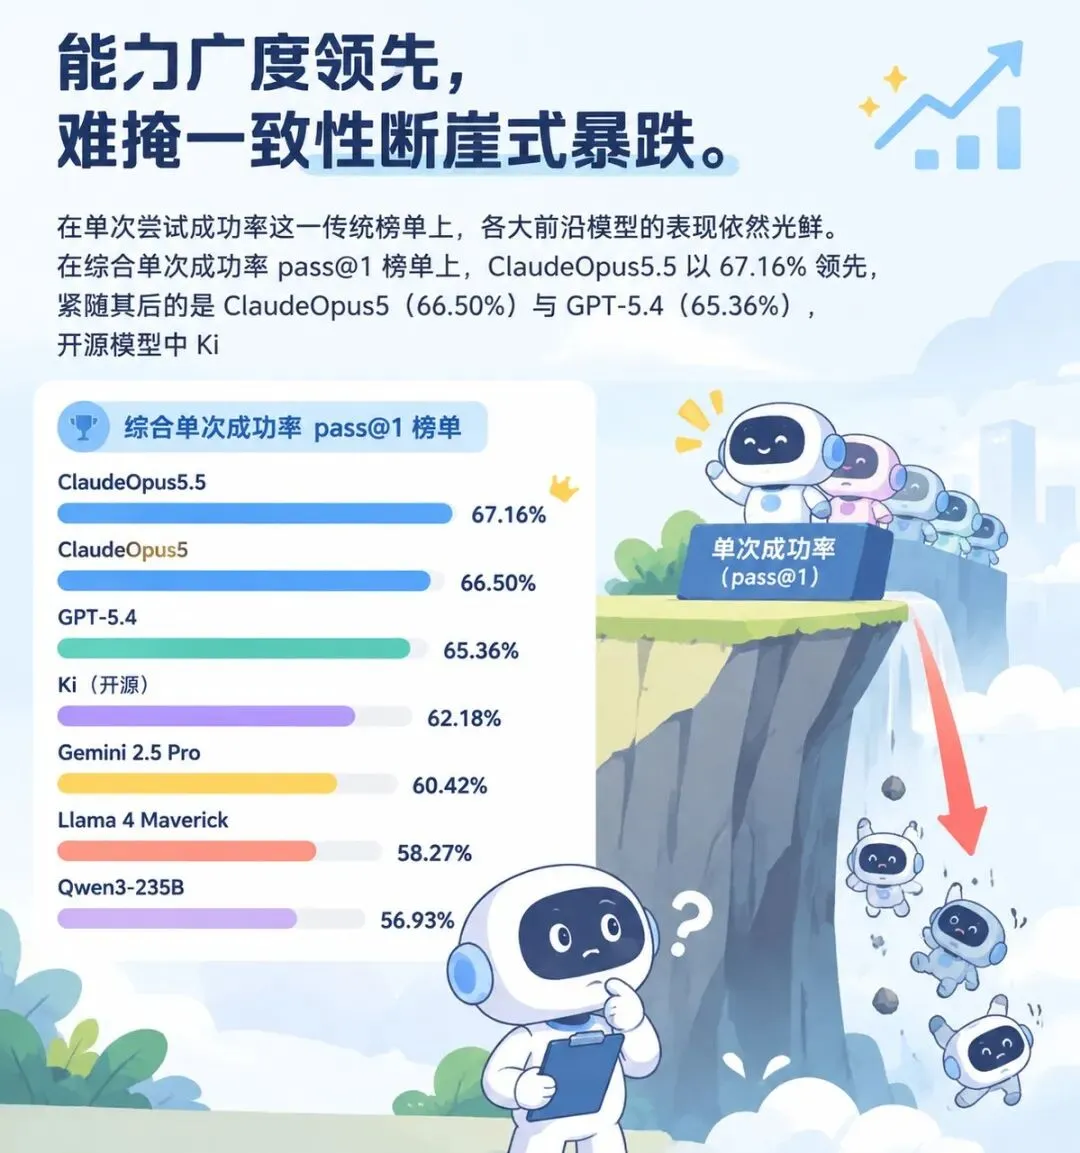
在单次尝试成功率这一传统榜单上,各大前沿模型的表现依然光鲜。在综合单次成功率pass@1榜单上,Claude Opus 5.5以67.16%领先,紧随其后的是Claude Opus 5(66.50%)与GPT-5.4(65.36%),开源模型中Kimi-K3表现最强达到57.37%,但不同领域的表现差异巨大(如Claude Opus 4.6零售得分为68.62%,而车险仅得8.30%)。
如果仅仅看解决任务的广度,开源模型甚至实现了反超。开源模型Kimi-K3拥有测试中最高的广度覆盖率,在507个任务中至少解决过476个(93.89%),仅有31个任务彻底失败,在零售领域更是以82.24%的单次成功率超越所有商业闭源模型。
然而,一旦引入20次严格一致性,残酷的现实便暴露无遗。广度与一致性出现严重割裂:Kimi-K3在20次重复尝试中全部通过的任务仅有68个(13.41%);反观Claude Opus 5尽管至少解决一次的任务覆盖率较低(79.09%),但在全部20次尝试中均成功的任务达到241个(47.53%);更高pass@1的Claude Opus 5.5在20/20通过的任务数量上与Opus 5完全相同(同样是241个)。这清楚地表明,模型能够探索到一条正确的路径,绝不意味着它能在每次调用时都保持稳定执行。
八成坏在工具,极端可靠性成本飙升
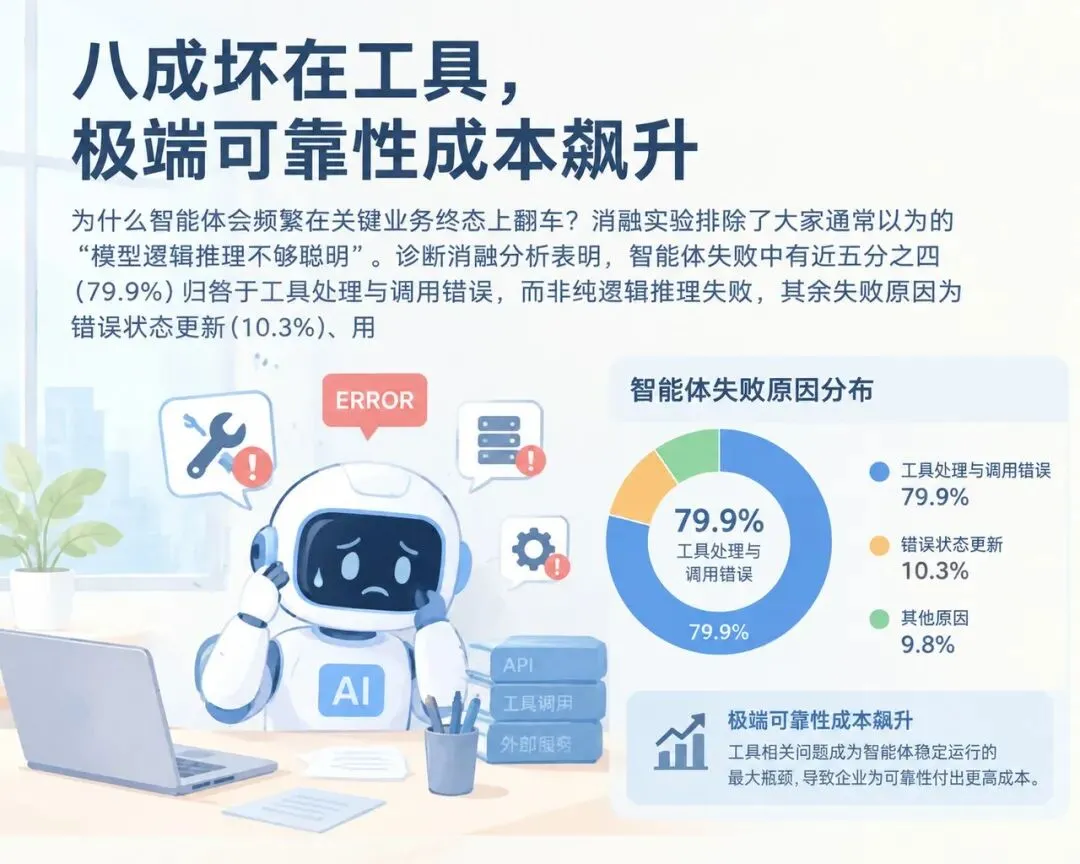
为什么智能体会频繁在关键业务终态上翻车?消融实验排除了大家通常以为的“模型逻辑推理不够聪明”。
诊断消融分析表明,智能体失败中有近五分之四(79.9%)归咎于工具处理与调用错误,而非纯逻辑推理失败;其余失败原因为错误状态更新(10.3%)、用户诉求未完全解决(7.0%)和未采取任何状态修改行为(2.9%)。
这就给企业算了一笔严峻的账:单次成功成本极低的模型,在追求高一致性的场景下,整体开销会反弹数十倍。如果模型在参数构造、错误捕获和工具交互中漏洞百出,即便偶尔能给出完美的响应,企业也必须为后续的无数次重试与失败埋单。
把业务全权交给智能体之前,企业不能再只看对答如流的演示 Demo,更不能迷信单次测出的高成功率。只有把评测探针深扎进底层数据库的持久化状态中,并用重复运行拉平侥幸,才能看清模型到底是真正的数字员工,还是随时可能改错账目的潜在隐患。