ARTICLE · 1136861
AI协同从 0 到 1:2W+篇文献构建个人知识文献库
我电脑里躺着 21,699 篇文献,约 45 GB,来源混杂,命名一半是乱码。逐篇精读当然不可能,按一天十篇算得读六年。所以这两年我做的事其实只有一件:搭一套分层体系,让机器干重活,把人的时间留给真正要写的那几篇。这篇把它从头到尾讲一遍,包括踩过的坑。
全文速览
1 · 起点:45 GB 的散乱文献
先说清楚我面对的是什么。这 21,699 篇里,有老 EndNote 库导出来的,有 CrossRef 批量下载的,还有各个文件夹里翻出来的。文件名大量是 UUID、被截断的标题或者干脆乱码,看不出作者和年份。
由此产生三个绕不开的问题:找不到,命名没规律,检索基本靠记性;读不完,一年精读几百篇已经是极限;用不上,没有可检索的结构化信息,真到写东西的时候调不出证据。
第三点最容易被忽略。很多人以为文献管理的目标是「读完」,其实不是,是写的时候能拿出来。
2 · 三层分档:为什么这么分
回答分层之前,先回答为什么要分层。原因很朴素:时间不够。所以核心是四个字,分档投入:大部分文献用机器低成本处理,少数才值得人花时间。
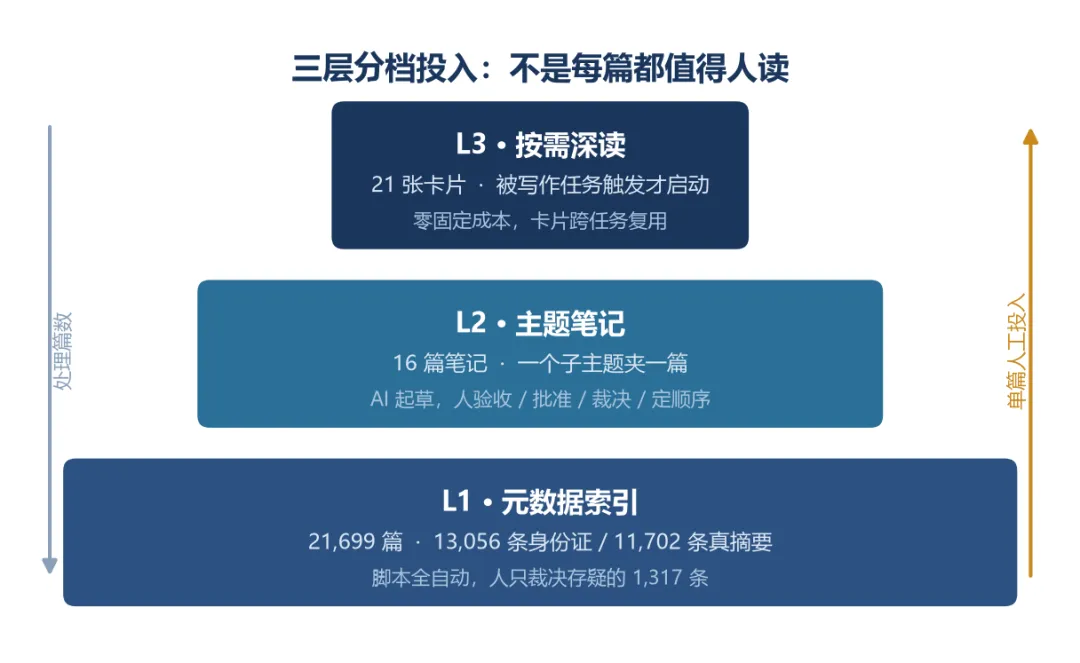
三层分档投入:越往上单篇人工投入越高,处理的篇数越少。底层 L1 覆盖全部 21,699 篇但全靠脚本,顶层 L3 只有 21 张卡片,用时才启动。(本文作者绘制)
L1 是元数据层,一篇一条身份证,脚本全自动,人只在机器判不了的时候出场。L2 是主题笔记层,一个子主题夹配一篇笔记,AI 起草、人来把关。L3 是按需深读层,只有真要写东西时才触发,产出卡片沉淀下来反复用。
三层之间不是并列关系,是筛选关系,每一层都在为上一层缩小范围。
3 · 打地基:先试点,后全量
迁移是整件事里第一场硬仗,动的是上万篇文件。我的做法是先在「大气河」这个 38 篇的小夹上试跑脚本:33 篇进了目标夹,5 个重复副本被隔离,31 个硬链接建进研究线视图,manifest 日志 82 条零失败。试点通过,才敢跑全量。
全量这一步,EndNote 库的 9,700 篇是复制,源库永不动;其余 11,000 篇经授权移动。分到 D01 到 D18 这 18 个学科主库,一篇只有一个归属,367 篇实在难判的先扔进待分池。重复判定用标题归一化,每组只迁一个代表,副本集中隔离。
这里有个设计我很满意:所有文献只在主库存一份正本,研究线视图用的是硬链接,同盘零额外占用,双向都能打开。现在 14 条研究线、2,433 个硬链接,一个字节都没多占。敢动上万篇文件,靠的不是勇气,是每一步都可撤销。manifest 记着源、目标、动作、原因,中断了重跑同一条命令会自动跳过已完成的,真出问题按日志反向移回就行。
4 · 给每篇文献办一张身份证
迁完就是登记。每篇文献在 catalog 里登记 27 个字段:作者、年份、期刊、标题、路径、研究线标签,还有置信度。目前的数字是 13,056 条主索引,外加 11,702 条单独成库的真摘要。
这里最值得说的是分工方式。机器判不了的那些,比如年份存疑、元数据对不上,一共 1,317 条,全部进人工待办清单,由我逐条裁决,严格可信的年份是 9,061 条。置信度分级的好处在于,它把「机器的不确定」变成了看得见、裁得了的东西,而不是悄悄混在结果里。后面你会看到,这类把不确定性显式化的设计贯穿了整个库。
5 · 主题笔记:模板是打磨出来的
L2 的规则只有一句:一个子主题夹,配一篇主题笔记。超过 100 篇的夹拆成主册加分册,比如 ENSO 530 篇拆了 7 个分册,季风 317 篇拆了 8 个。主册管总纲,分册管明细。
模板不是一次设计好的,这一点我想强调。v1 每篇只有一句话定位,全篇就一个板块。拿「观测数据与模式」这 55 篇当第一夹实测之后,立刻发现三个撑不住的缺口:挑不出核心必读、说不清方法差异、改完名连旧凭据都没留。
于是翻修成 v2 的 8 个板块:主题概述、数据方法对照表、叙事化的知识脉络配 mini 评述、阅读路线图、逐篇清单、研究线连接点、问题与处置、全篇文件清单。2026 年 9 月 23 号定稿冻结,再把旧 6 个夹、987 篇全部回填了一遍。
经验就一句:模板先拿一夹文献跑,实测打磨,再定稿冻结。它的价值不在好看,在于把质量下限锁住,但锁住之前得先把它磨对。
6 · L3:把「读书」换成「按任务取证据」
L3 的哲学是触发式,平时零成本,写作任务来了才启动。流程 5 步:触发之后先定位,只查索引和笔记、不读全文,成本几乎为零;然后按「三缺」筛选,也就是写作任务直接对口的、方法上有依据的、观点上能当对立面的,从几百篇砍到 8–15 篇;再逐篇精读产出卡片;最后组装成证据表。
卡片分两档。轻卡 10 节,15–20 分钟一篇,所有入选文献先过一遍;全卡 16 节,约 1 小时一篇,只给最终要进正文引用的 3–5 篇。
卡片是唯一真源,落在固定的 cards 目录里,跨任务复用。同一篇文献在第二个任务里直接引用,只做增量更新,不重读。这一层带来的转变是,文献库从收藏夹变成了生产线。
7 · 七种触发:工作流是长出来的
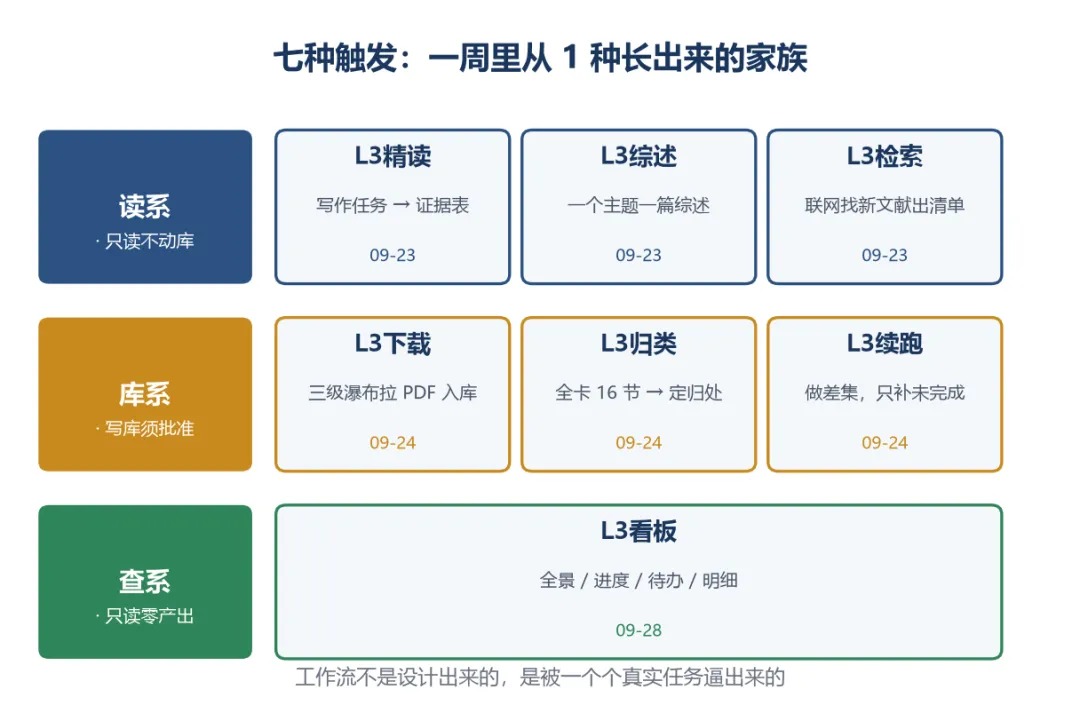
七种触发分三族:读系只读不动库,库系会写库所以必须批准,查系只读零产出。日期是它们各自长出来的时间。(本文作者绘制)
九月底只有一种触发,就是深读。然后发现要写综述,加了综述;发现要补新文献,加了检索;检索出来的文献要入库,下载就独立成一个触发;我自己下载的文献要归位,又加了归类;发现任务经常断在中途,加了续跑。
最后发现「做到哪一步了」这个问题没人回答,加了看板。7 种分三族:读系 3 种(精读、综述、检索),只产出内容不动库;库系 3 种(下载、归类、续跑),会写库,全部走批准制;查系 1 种(看板),只读,随时能问全景、进度、待办、明细。
日常用起来就是一句话:触发词,加意图,加源夹,约束可给可不给。比如「L3精读:写南海海平面变率,源夹 D02,上限 12 篇」。这套句式我培训同事,10 分钟能教会。回头看这段演化史,我的结论是别一上来就想设计完美工作流,让真实任务把缺口逼出来,再补协议。
8 · 两项刚跑通的新能力
第一项是给「归类」加了网页入口。我们刷公众号、看别人的文献解读,经常觉得这篇有用,一关网页就再也找不着。现在的做法是丢一个链接进来,它先把原文整个抓下来存成六件套:原始网页留痕、图片本地化的 html、打印版 PDF、正文 Markdown、图片文件夹、meta 信息。
接着从正文里抽出提到的文献 DOI,去 Crossref 核验题录,再交给下载流程把原文 PDF 拉回来,之后走完全一样的路:全卡 16 节、定归处、出 ops 清单、批准入库。
只有确实拿不到原文的时候,才用推文内容兜底出卡,但封面必须写明来源是网页,等原文到手再升级成正式卡。上周试了第一篇:一篇讲地表变暖加速的推文,顺着抽到 Nature Communications 的一篇文章,一次下载成功,出了全卡,归到气候变化那一夹。
这里的原则我写得很硬:别人的精读是线索,不是结论。落到卡上的每一句,都要能对得上原文页码。
第二项是下载重做成了三级瀑布。第一级走正规 OA 批量通道,第二级换多源解析器补漏,第三级拿全量 OA 位置逐个试再加出版社直连模板。最近一份 25 篇的清单实测,单级最好只能拿到 6% 左右,三级走完拿到 52%。
差别不在工具好坏,在于失败要归因:AGU、Wiley、Elsevier 这些是 403 授权问题,换通道也没用;但 Frontiers 这类站点其实是通的,以前判断「拿不到」,是没走对路。还有个小改动很实用:三级产出的 PDF 全进同一个文件夹,按 DOI 命名,同名就是同一篇,重下就覆盖,天然幂等,不会再留一堆「第二轮下载」的目录债。
9 · 避雷:这两个坑我都踩过
第一个坑是元数据。Liu-2009,文件名标的是 JAMES,打开一看其实是 J. Climate 22 卷 6104–6119 页;Yamagata-1997 更离谱,内容根本不是那篇经典文献,而是 Masson 等人 2004 年的文章,Yamagata 只是第五作者,1997 只是事件年;还有 22 条假年份,大多是把研究时段的起始年当成了发表年。按文件名建卡,直接张冠李戴。
由此定下铁律:元数据以 PDF 内部的版权行和页脚为准,多渠道交叉验证;发现错误不就地改,走存疑登记、ops 清单、批准之后再动。库里最容易腐烂的不是 PDF,是元数据,元数据一错,检索和综述全跟着错。
第二个坑是工具本身。我自建的图表清点脚本,27 篇实测命中 0 例,正则写得根本匹配不上真实图注格式。更险的是,审计脚本对空清单照样报通过,绿灯不等于没漏。后来重写了判据,实测 16 篇命中 16 篇。
检索排序也是个毒药。按被引次数排序,会灌进来一堆癌症统计、R 语言包这种外领域高引,450 篇里只有 4 篇过主题门禁,后来改成只看标题的严格短语。
查重同理,只看作者加年份会误判,上一份 25 篇的清单里标「疑似已在库」的 8 篇,全是撞了同作者同年的其他文章,后来加了一道标题实词覆盖率的闸门才止血。这几件事归成一句话:对现成工具保持怀疑,用实测数字说话。
10 · 库为什么不烂,以及现在的样子
AI 的执行力很强,但有个毛病:会顺手改。看到数据不对就想修,看到文件碍眼就想挪。人不在环里,库就悄悄烂掉。所以我定了三条规矩。
第一,ops 批准制。任何写库操作,先 dry-run 出清单给我看,我批准了才落盘,执行时备份、断言、双向校验、写 manifest,一步不少,累计执行了近千条 ops。
第二,唯一真源。卡片、术语表、库操作索引,每类数据只有一个写入点,不放副本,防止两份真相漂移。
第三,并发写保护。动手前先看文件最近改动时间,10 分钟内被别的会话写过就停手报告,绝不并发覆盖。
说白了,这三条规矩管住的不是库,是 AI 自己的手。「绝不静默修改」是这座库不烂的根。
现在的成果是这六个数字:13,056 条身份证,11,702 条真摘要,16 篇主题笔记,7 种触发,21 张深读卡,14 条研究线、2,433 个硬链接。
下一步两个方向:网页精读现在已经能一路走到卡片,这条路打通了;剩下的是 AGU 这类 403 授权,只有等机构订阅通道解锁才能再往上提。如果要给这套体系留一句总结,就是九个字:分档投入、人机分工、可回滚。前两条决定它能不能建起来,第三条决定你敢不敢让它继续长。
如果你也在搭自己的文献库,或者正被几千篇 PDF 拖着不知道从哪下手,欢迎在评论区说说你现在的做法,我可以按你的库型给一套分档方案。
关于本文:内容整理自组会分享《从 0 到 1:与 AI 协同构建三层文献知识库》(21 页,2026-09-29 更新版),文中所有数字均来自该库的实际运行结果。
文中两张结构示意图由本文作者绘制,封面图为 AI 生成。方法本身不依赖特定工具,脚本、协议和触发词都是自己攒的,换一套工具同样能跑。
科研工作流 · 2026-09-29