ARTICLE · 1136974
Kev 能在纯 CPU 上跑吗?下载、部署、实测全记录
01 测试结果
我先看的不是代码,是 README。支持列表里只有三个后端:CUDA、ROCm、Apple Silicon。一个 CPU 都没写。这台机器没有独显,所以我第一件事是判断它到底能不能跑起来。
结论是能。0.8B 的模型,全精度 fp32,加载花 6.8 秒,占 3.47 GB 内存。官方 README 里那段一百来个 token 的工单文本,1.33 秒出结果,再问一次 1.35 秒,两次答案一样。
但它有一条硬门槛,而且这条门槛在文档里看不出来。服务端点自己报的上限是 65536 token,我在纯 CPU 上实测,4097 能过,8193 直接爆内存。也就是说这个六万五的额度,这台机器连一半都拿不到。
下面是完整的判断依据、下载、部署和验证过程。
02 机器配置(同上一篇)
所有数字都对着这台机器说,所以先把它摆出来。
· 系统 Windows 11,AMD64
· CPU AMD Ryzen,16 个逻辑核
· 内存 30.8 GB,没有独立显卡
· Python 3.13.14,torch 2.8.0+cpu,torch.cuda.is_available() 是 False,torch.backends.mps.is_available() 也是 False
这台机器上唯一的硬约束是内存。模型的权重只占 3.5 GB,真正吃掉内存的是长文本那一遍前向,原因在第九章讲。
03 CPU 能不能跑
翻文档和源码,找到四处不一致的地方。
第一处是 README 里那句支持说明,原文只有一句:
This starts Kev-4B on your machine: CUDA or ROCm if you have a GPU, MLX on Apple Silicon.
一个 CPU 都没有。
第二处是 kev/device.py。这个文件的第一行就是它的自我说明:
The accelerator this process uses: cuda, then mps, then cpu.
而它里面的 default_device() 是三级降级,查到最后一层就是 cpu。也就是说,没显卡没 Apple 芯片的机器,它会自己落到 CPU 上,不会报错退出。
第三处是 kev/serve.py 第 327 行,专门给 CPU 开了一个口子:
if dev != "cpu" and opts.dtype is None:
opts = replace(
opts, dtype=torch.bfloat16)
意思是:除了 CPU 以外,服务端默认都换成 bf16 跑;CPU 不换,留在 fp32。这说明作者想过 CPU 这条路径。
第四处是模型卡自己。它讲 MLX 后端和官方评测路径的差距时,写的比对基准是:
Against fp32 PyTorch on the CPU on the same requests, the MLX answers differ by at most 0.0076 at 8k and 0.0052 at 16k tokens
拿 CPU 上的 fp32 PyTorch 当基准,而且是在 8k 和 16k 两个长度上比的。所以 CPU 上跑 8k、16k 的 state,在他们的流程里是存在的,只是没写进支持列表。
四处证据加在一起,代码层面 CPU 是支持路径,只是没宣传。没宣传的原因第九章会说:慢。
四处证据放在一起看:
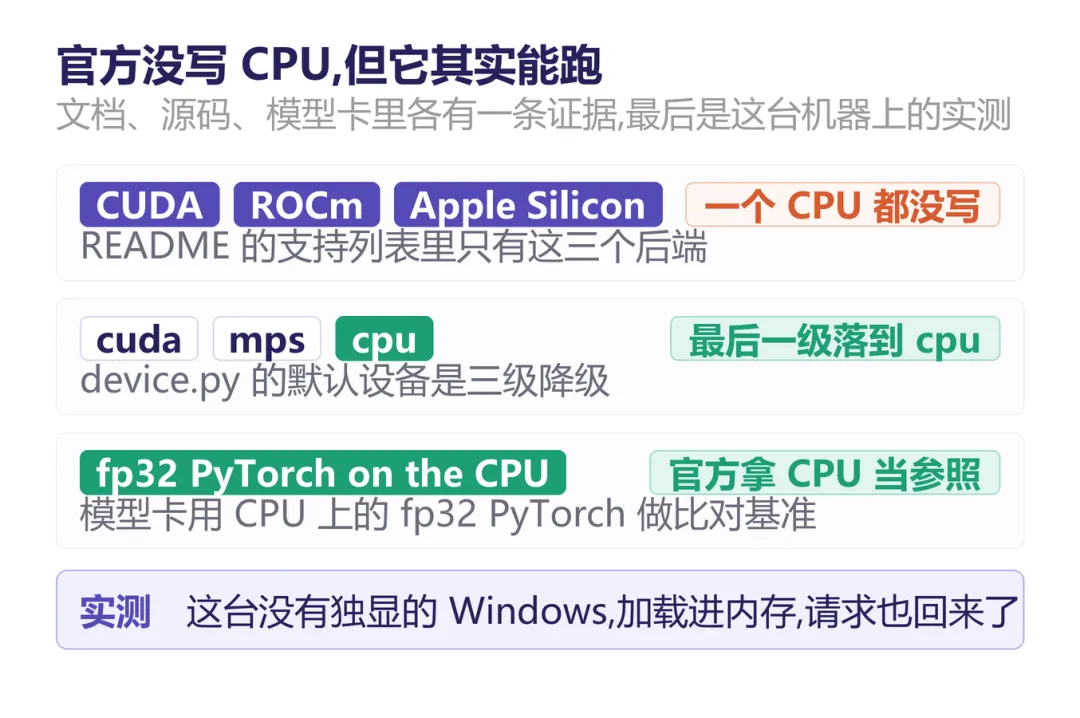
图 1 官方支持列表只有三个后端,但源码的三级降级,最后一层就是 cpu
04 下载: 代码和权重
代码是 33 个源文件,六百多 KB。直接用 git 拉会被代理挡掉,换成抓 codeload.github.com 的 tarball,结果包是截断的,只有 2.78 MB。最后改成按文件清单一个个抓 raw.githubusercontent.com,清单用 api.github.com 的 trees 接口拿。
权重分两块。适配器 43 MB,里面是 adapter_config.json、adapter_model.safetensors、head.pt、tokenizer.json、training_config.json、provenance.json、result.json 和一份两万四千字的模型卡。
底座是 Qwen/Qwen3.5-0.8B-Base,单个 safetensors 文件 1,746,942,600 字节。这个文件我分了 16 段并行下载,每段约 109.2 MB,下完按顺序合并,再核对字节数。
核对的依据是索引文件。total_size 写的是 1,746,882,752,一共 488 个张量,safetensors 文件头 59,840 字节,张量字节数加起来和索引完全对得上,dtype 只有 BF16 和 F32 两种。
这里踩过一个坑,值得单独说。适配器目录里那份 tokenizer.json 是截断的,只有 9,093,120 字节,正好 8880 KB 整,json.load 在第 408505 行就报错了。我一开始以为是下载出了问题,后来翻 checkpoint.py 才看到源码注释:
The tokenizer always comes from the base (both layouts carry a copy)
加载时 tokenizer 一律从底座取,适配器里那份根本不用。所以这个截断没有影响任何一次实测,但既然发现了就补成了完整的一份,12,807,196 字节,vocab 24,8044。
要检查文件完整性,别只看文件在不在。json 能不能解析、字节数和索引对不对得上,这些才是判据。我这次是靠 json 解析报错才发现的。
05 配置环境
不往系统 Python 里装东西,单独开一个 venv。CPU 版的 torch 轮子有 619 MB,分几条命令装:
python -m venv envs/kev
python -m pip install torch==2.8.0+cpu
python -m pip install transformers==5.19.0
python -m pip install peft
python -m pip install accelerate numpy
python -m pip install fastapi uvicorn
python -m pip install pydantic
装上以后确认一件事:
python -c "import transformers;print(
hasattr(transformers, 'Qwen3_5ForConditionalGeneration'))"
返回 True,说明这个版本的 transformers 认识 Qwen3.5 的模型类。
版本这块有个坑。国内几个镜像源(tuna、aliyun、ustc、bfsu)的 transformers 都停在 5.9.0,PyPI 上已经是 5.19.0。要用新版本只能走 PyPI。
下载速度也折腾了一轮。pip 单连接被限到 20 到 30 KB/s,619 MB 的 torch 按这个速度要三个小时。测下来 PyPI 直连 33 KB/s,走代理反而只有 13 KB/s,直连快 2.4 倍。最后改成 12 线程并行抓轮子,47 个依赖一共 1066 秒下完,其中两个因为网络抖动失败,重跑一次补齐。
装的过程中失败了三次。前两次是版本冲突:tokenizers 0.23.2 要求 huggingface-hub<2.0,我一开始只下了 2.1.1;fastapi 0.129.0 要求 starlette<1.0.0,我抓的是 1.0.1。都补上对应的轮子之后第三次成功。
装完启动会有两条警告,这两条很重要:
causal_conv1d_fn is falling back to its reference PyTorch implementation
chunk_gated_delta_rule is falling back to its reference PyTorch implementation
causal_conv1d 和 flash-linear-attention 这两个加速库没装,底座里的线性注意力层(DeltaNet)回落到参考实现。警告自己说了这个实现 correct but much slower。这就是 CPU 慢的直接原因,也是官方不宣传 CPU 的原因。
06 让它完全离线
这一步不是必须的,但做了以后运行就不再碰网络。
适配器的 head.pt 里存着底座的路径,字段名是 base,原本指向 Hub 上的仓库 id。Checkpoint.load() 会读这个字段去加载底座,所以它是这条链上唯一的来源。把它改成本地目录,整条加载链就离线了。
BASE = r"C:/kev/models/Qwen3.5-0.8B-Base"
d = torch.load("head.pt", map_location="cpu")
d["base"] = BASE
d["base_revision"] = None
torch.save(d, "head.pt")
脚本里做了两件事:先把原始文件备份成 head.pt.orig,之后每次都从备份读、从备份改,保证重复执行结果一样。
改完的输出:
base 'Qwen/Qwen3.5-0.8B-Base'
-> 'C:/kev/models/Qwen3.5-0.8B-Base'
base_revision 'dc7cdfe2...' -> None
head.pt 大小 2103999 -> 2104063
base_revision 也要一起清掉,否则加载时还是会拿这个 revision 去 Hub 上核。
07 第一次调用
官方 README 给的例子是一段客服工单,问三个问题:该转给哪个部门(选择)、要不要人工介入(是否)、客户有多生气(分级)。
加载阶段:
加载耗时 6.8 s
hybrid=True dtype=float32 device=cpu
内存 加载后 3472 MB / 峰值 3484 MB
参数 backbone=752.4M head=0.5248M
第一次调用 1.33 秒,state 22 个 token。第二次同样的请求 1.35 秒,两次答案完全一致。
输出长这样:
department choice shipping
returns 0.2612
shipping 0.4579
billing 0.2809
escalate noul 0.5543
frustration score 1.2284
(1 = Frustrated)
模型只做三类判断:是否、从若干选项里挑一个、在若干等级里打一个分。它不生成文字。返回里的 output_tokens: 182 是序列化后的答案占用的 token 数,别把它当成生成量。
底座的参数量也顺便核了一下,一共 873.4 M,488 个张量:
· language_model 752.4 M,占 86.1%
· visual 视觉塔 100.6 M,占 11.5%,153 个张量
· mtp 20.5 M,占 2.3%
标定温度写在 head.pt 里,是 2.3510958125672174。这个值是训练时拟合出来的,控制输出的概率分布有多极端。
它还带一整套环境变量,不用改代码就能换配置:
KEV_DTYPE fp32 / bf16 / fp16
KEV_ATTN eager / sdpa
KEV_MERGE 0 表示不合 LoRA
KEV_TEMPERATURE 覆盖标定温度
KEV_BACKEND torch / mlx / auto
第九章会用上其中两个。
08 启动服务 & 发送测试请求
命令行起服务:
python -m kev.serve \
--run models/kev-0.8b --port 8009
启动日志里有一行值得抄下来:
serving models/kev-0.8b on cpu via
torch (float32) 127.0.0.1:8009;
states over 65,536 tokens refused (422)
然后打了六组请求。
第一组,GET /v1/models,看服务自己怎么说:
device cpu
backend torch
dtype float32
temperature 2.3510958125672174
max_state_tokens 65536
prefix_cache {... 'hits': 0 ...}
第二组,POST /v1/systemone,官方工单示例。200,往返 0.97 秒,响应头里 server-timing: app;dur=946.3,服务端自己报 941.1 毫秒。答案是 shipping、0.5543、1.2284,和离线跑出来的完全一样。
第三组验前缀缓存。同一个请求再发一次,往返从 0.97 秒降到 0.63 秒,服务端耗时从 941.1 掉到 615.3 毫秒,prefix_cache 的 hits 从 0 变成 1。两次 answers 完全相同。
第四组是 /v1/systemone/permute,官方的演示接口:同一个选择题,换几种选项顺序各跑一遍,看结论稳不稳。这个接口有个细节要提前知道,它用的是随机打乱并允许重复,不是把 K! 种排列全跑一遍。所以我要了 6 次,实际只出现了 3 种不同顺序。
六次结果里,positive 的概率从 0.7556 到 0.8361,最大值始终是 positive,argmax_stable 返回 True,最大波动 spread 是 0.0805。结论稳,但概率会晃到 8 个百分点。模型卡里那条「选项顺序会改变答案」的局限,在这个例子上没被触发。
第五组是输入校验。下面是状态码:
questions 为空 422
choice 无 criteria 422
非法 type 422
state 缺失 422
重复 question id 200
多余字段 200
422 的几条报错都指名了字段。其中 choice 没有 criteria 和 type 写了非法值这两种,报的都是同一句 Input should be 'noul',信息量一般。重复的 question id 不会被拒,只保留最后一个;多余的顶层字段直接忽略。
第六组是超长 state。我构造了一个 66000 token 的 state,返回:
422
state is 66,001 tokens, over the
65,536-token limit (the <state>
token included): shorten the
document or split it across
requests; or set KEV_TRUNCATE_STATES=1
报错把实际长度也说出来了,而且提示了截断开关。0.2 秒返回,没有真的去跑前向。
这条线后来我离线对齐了一遍,边界落得很干净:
65535 token -> 通过 state_tokens=65536
65536 token -> 拒绝 state_tokens=65537
判断条件是 len(state_tokens) + 1 > 65536,那个 +1 是 <state> 这个特殊 token 自己占的位置。所以实际能用的文本长度是 65535 个 token,不是 65536。
09 长上下文验证
前面所有数字都很顺,问题出在这里。
我做了一个阶梯测试:同一个 state 内容,只改它的长度,从 1024 一路到 16384;再换三种改法各跑一遍。每一档量三件事——前向耗时、进程峰值内存、有没有跑完。每一档单独开一个进程,崩了不会带走别的档。
结果是这样的:
三列都是同一台机器、同一份 state,唯一变的是改法。默认那一列在 8192 就断了,sdpa 把它撑过去但要 62 秒、18.2 GB,bf16 用 39 秒、17.4 GB 也过了。16384 三列全军覆没。
在内存已经空出来的情况下我又单独重跑了一次 8192 那一档,还是失败:
RuntimeError: [enforce fail at
alloc_cpu.cpp:121] DefaultCPUAllocator:
not enough memory: you tried to
allocate 2148007968 bytes
崩溃时 常驻 1272 MB / 峰值 17588 MB
2148007968 字节这个数不是随机的。底座的全注意力层有 8 个注意力头,head_dim 是 256,fp32 每个数 4 字节,8193 的长度算下来正好是 8193 x 8193 x 8 x 4,就是 2.148 GB。所以它不是模型太大,是全注意力层按长度的平方一次性申请一块矩阵。
这里要补一层结构上的原因,不然会以为「加内存就行」。底座的 24 层里只有 6 层是全注意力,另外 18 层是线性注意力(Gated DeltaNet)。线性注意力的开销随长度线性增长,这部分确实省下来了;但剩下那 6 层的开销是长度的平方,长度翻一倍它就涨四倍。前面省下的,在长文本上全部被这 6 层吃掉。所以决定上限的不是模型大小,是这 6 层。
这个解释在另一次事故里得到了更夸张的印证。我用一个 40002 token 的 state 打服务,进程试图申请:
51205120128 bytes
51,205,120,128 字节,等于 40002 x 40002 x 8 x 4。一块 47.7 GB 的注意力矩阵。这台机器总共 30.8 GB 内存,当场就没了。
翻源码能看到根源。kev/model.py 里这一行:
attn = attn or ("sdpa" if
str(device).startswith("cuda")
else "eager")
CUDA 上用 sdpa,其它设备一律 eager。eager 就是老老实实把整块分数矩阵算出来,它的内存是长度的平方。而且在崩掉的调用栈里,最后一行不是矩阵乘法,是这一句:
attn_weights = attn_weights
+ attention_mask
也就是说,先算出一块 2.15 GB 的分数矩阵,再加一个同样大的 mask,于是又需要一块。同一时刻要三块。
换成 KEV_ATTN=sdpa 之后,8192 这一档撑过去了。但你看它的数字:耗时从 18.3 秒跳到 62.1 秒,峰值内存 18.2 GB,比 eager 崩掉时还高。它不是省内存的核,只是换了一条申请路径,避开了同时要三块这件事,代价是页面文件被拉爆,速度掉到 132 token/s。再往上到 16384,进程直接被系统干掉,连异常都没抛出来。
第三列能过 8192,这里有一处很直接的证据。16384 这一档按 16385 x 16385 x 8 x 4 算,fp32 的单块分配要 8.59 GB;bf16 实际报出来的申请量是 4.30 GB,正好一半。也就是说那块按长度的平方长的矩阵,在 bf16 下自己也减半了,不是只省权重。权重那边也在省,加载后的常驻内存从 3472 MB 掉到 2076 MB。两样一起省,才把 8192 从失败推到通过。
但它只是把上限顶上去一档。16384 依旧是 DefaultCPUAllocator 报错,理由是单块 4.30 GB 申请不到;而且 bf16 在 8192 上峰值 17784 MB,已经比 fp32 崩掉时的 17588 MB 还高,基本是贴着内存上限过去的。
所以对这台机器,能给的判断是:
· 日常用途,几百到几千 token 的文本,完全够用,4096 以内都在几秒到二十秒的量级
· 想跑长文档,这台默认配置的实际上限在 4096 到 8192 之间,不是官方报的 65536
· 服务端自报的 max_state_tokens: 65536 是准入上限,不是跑得动的上限,这两个数差得很远,文档没区分
想往上顶,三条路:内存加到能容纳 长度平方 x 32 字节的单块分配;装上 flash-linear-attention 这类加速库,让线性注意力层不走参考实现;或者开 KEV_DTYPE=bf16,让权重和注意力矩阵一起减半。前两条治本,第三条只是把一档额度从 4096 挪到 8192。
同一份 state 只改长度,三种改法并排:
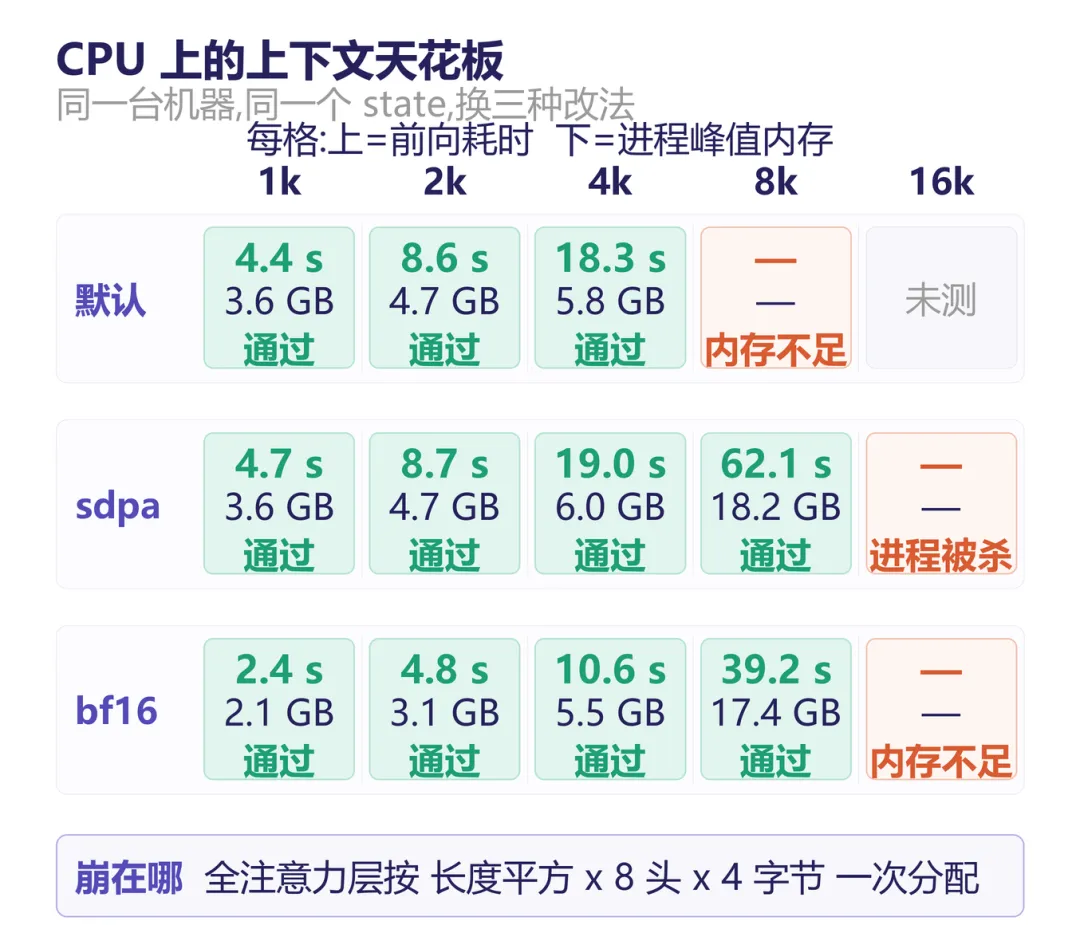
图 2 默认在 8192 上断了,sdpa 撑过去但慢了三倍,bf16 又快又省
10 有效性对比: 同一批餐饮评价,和上一篇正面对比
能不能跑是一件事,跑出来的判断准不准是另一件事。
我用的是上一篇《KaLM-Jev 本地部署实测》里那套数据:8 条餐饮评价,每条问 6 个判断(情感倾向、主要方面、星级、需不需要人工、有没有食品安全风险、是不是刷单),一共 48 个判断。同一批数据、同一把尺子,才谈得上对比。
跑了三种配置:
三个配置都高一点,但幅度不大,+1 到 +3 个判断。以 48 个样本来说,这个差距说明不了太多。
分题型看,有一项的变化是明显的:
上一篇里最难看的一项就是星级:KaLM-Jev 的 8 条评价全挤在 2 星和 3 星两档,从来不给 1 星也不给 5 星。这次 Kev 把它撑开了,1 星、2 星、4 星、5 星四档都出现过,8 条里对 5 条。
要说明的是,这不算模型变好了,是输出分布不一样。同一批评价、同一个标注,一个只给出两档,一个给出四档。5 条和 2 条的差距,主要来自这里。
置信度也值得看一眼。Kev 给每个 choice 和 score 都带一个置信度,分档统计下来:
zhtext >=0.5 18 个 对 15 个 83%
zh >=0.5 12 个 对 11 个 92%
<0.1 1 个 对 0 个
置信度高的时候确实更准。这一项比 KaLM-Jev 好:上一篇里置信度低于 0.2 的判断,正确率只有 25%。
把上一批和这一批的星级点阵摆在一起:
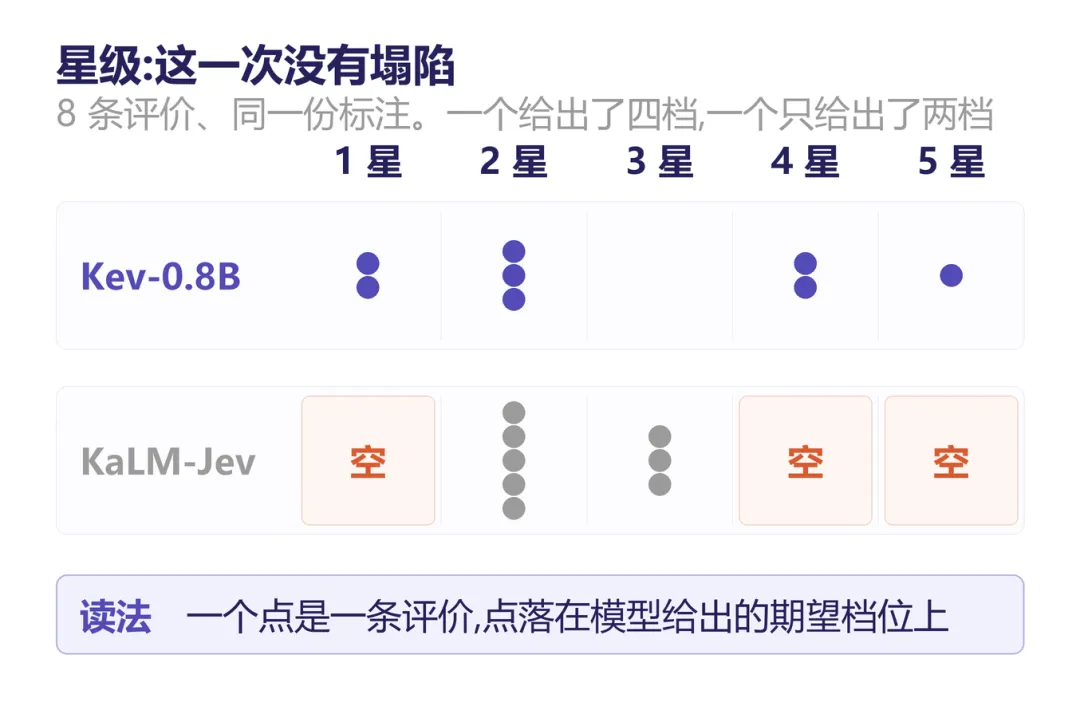
图 3 星级判断的点阵,上面是上一篇,下面是这一次:一个只给出两档,一个给出四档
11 两处短板
第一处是刷单识别,而且换语言就崩。
同一个「这条评价是不是刷单」的问题,三个配置分别是 4/8、4/8、0/8。用中文判据问的时候全错。对比上一篇 KaLM-Jev 是 7/8。
看几条具体的错法。R1 是一条正常好评,被判成刷单,概率 0.5482,阈值是 0.5,刚越过去一点。R3 是一条中评,0.6789,也判成刷单。而 R6 是一条全是感叹号、明显不像正常写的好评,0.2399,反倒放过了。
问题出在它对中文指令的跟随很弱。模型卡里的语言声明只有 English 一项。用英文判据能到 4/8,换成中文判据就是 0/8,掉了整整 8 个判断。
第二处是我拿同一批评价做了中英对照。中文原文和英文译文各判一遍,48 个判断里有 10 个不一致,而且这 10 处每一处至少有一边是判错的。举两个:
· R5 的「主要方面」,中文判 service,英文判 delivery,标注是 delivery
· R8 的星级,中文给 4 档,英文给 5 档,标注是 1 档,两边都错
语言一换结论就变,而且变的这些地方没有一边是对的。数据在中文、判据在英文,是目前最稳的一种配法(33/48),但离可以不管还差得很远。
12 要不要微调
上一章那两处短板,刷单识别换中文就崩、中英结论对不上,很自然会问一句:能不能拿自己的数据把它调过来。
官方留了这条路,先说结论:正常用不需要。
每个 checkpoint 交付的时候,本身就是调好的。适配器目录里装的是三样东西:一个 rank 16 的 LoRA(α 是 32,挂在注意力和 MLP 的投影上),一个 pointer head,还有一个训练时拟合好的温度。温度存在 head.pt 里,0.8B 那个值是 2.35,加载时自动应用。README 首页那句 You can use the pretrained weights or train your own.,把「用」放在了「训」前面。
所以判断的起点是:你的问题在不在它的训练分布里。官方在 Fine-Tune 那一节给了三个信号:
If your questions look different, like your own routing categories, your own escalation rules or another language, a short fine-tune usually helps more than any prompt change.
说的是三件事:你的分类标准和它训练时用的不一样;你的问题是另一种语言;你需要一个能拿去卡阈值的置信度。第三条要单独说一句,微调会顺手把温度在你的数据上重新拟合,你拿来定阈值的那个数,才是自己标签上量出来的。
第二条正好对上这台机器的实测。0.8B 的模型卡里,语言那一栏只有英文一个词。我这边换中文判据,刷单识别从 4/8 掉到 0/8。
收益是有的,但要够量:
· 官方示例的支持工单场景,三个问题、1050 条生成记录,H100 上跑 15 分钟,Kev-4B 从 67.7% 到 73.6%;按 5% 的错误预算算,能自动处理的决策从 34% 涨到 48%
· 另一个真实数据的例子,5219 条消费金融投诉跑一个 epoch,Kev-4B 从 0.804 到 0.904,评的是它没见过的投诉
· 400 条数据那次,增益落在噪声里。官方原话是 inside the noise
Kev-4B 在 H100 上跑一轮大约一块钱,成本可以忽略,卡住人的是数据量,先量够自己的标注再谈。
有两个坑要提前知道。
第一个是起点。必须从已发布的 checkpoint 起步,不能从底座开始。官方的实测是这样:从底座微调,在 Kev 自己的评测集上只有 0.33;用 --init_from 把已发布的 LoRA 和 head 热加载进来,这一项保持 0.83,新领域还能到 0.88。从底座起步,等于把它已经学会的全部扔掉。学习率也要更低,官方建议 2e-5 起。
第二个是代价。PLAN.md 里记了一条很具体的事:用 Kev 的格式做 LoRA,会侵蚀底座本来就有的日期算术能力。Qwen3.5-9B 在日期政策题上零样本 0.82,训练完掉到 0.72。这个丢失发生在表征层。用 LM head 读适配后的骨干,分数和 pointer 一样,head 补不回来。要救得靠 KEV_DATE_FACTS=1,让它把天数直接写进文本。
还有几件事微调修不了,别白花力气:
· 生成文本、对话、摘要。这类模型只给你给出的选项打分,从接口上就不生成
· 工具调用路由。0.8B 在 When2Call 上测试分 0.133,低于四选一的随机线 0.25,官方在模型卡里直接写了别用它做工具路由
· 知识题。这一项由底座决定,和微调无关
真要动手之前,有三件更轻的事可以先试。只做温度重标定,python -m kev.calibrate,模型卡里明确要求设阈值之前先在自己数据上做,它不算训练,成本很低。开 KEV_DATE_FACTS=1,日期类问题白捡。再就是换大一号的模型,0.8B 在域外比 4B 差 21 个百分点,如果只是要更准,换 4B 比微调省事。
回到这台机器。训练入口是有的,kev/train.py,680 行,参数很全。我确认过 --device 的选项里有 cpu。但有两个限制:bf16 那个选项的帮助文本写明是 CUDA only,CPU 上只能 fp32;全参数微调要 torchrun 配 FSDP2 上多卡。所以在这台没独显的机器上,LoRA 那条默认路径可以试着跑,全参微调别想。真要做,租一张卡更现实。
13 能用在什么场合
适合的场合:判断类的任务,一次问几十个到上百个短文本,每条几百个 token 以内,要的是概率和置信度而不是一段说法。放在本地跑完全可行,不需要账号,不需要显卡,加载 3.5 GB 内存,一秒钟出结果。
不适合的场合:需要长上下文的任务。这台机器上 4096 以内安全,8192 就悬了,官方报的 65536 拿不到。要吃长文档,要么加内存,要么先把 flash-linear-attention 这类加速库装上再试。
已知的弱项:中文判据。中文原文配英文判据能到 68.8%,中文判据只有 58.3%,刷单识别那一项直接掉到 0。
两个可以直接抄走的操作细节:
· 超长 state 不要硬打。服务端会返回 422 并告诉你实际长度,也可以设 KEV_TRUNCATE_STATES=1 让它只读前 65536 个 token
· 内存紧张时试 KEV_DTYPE=bf16,实测加载后的常驻内存从 3472 MB 降到 2076 MB,注意力矩阵也跟着减半,8192 那一档从失败变成通过;但 16384 还是过不去,它只把上限顶上去一档