ARTICLE · 1138305
AI安全测评: 从单点突破到体系化衡量
< AI SECURITY BENCHMARK >
AI安全测评:从单点突破到体系化衡量
大家好!
今天,我想和大家聊一个既前沿又紧迫的话题——我们究竟该如何衡量AI的安全能力?
过去几年,AI在代码生成、漏洞挖掘、自动化攻防等领域突飞猛进。但一个根本问题始终悬而未决:当AI越来越像一名“安全研究员”甚至“攻击者”时,我们用什么标尺去判断它到底行不行?靠演示?靠感觉?还是靠一两个漂亮案例?
显然不够。我们需要标准,需要实战化的测评体系。
首先,不得不提CyberGym。它由加州大学伯克利分校提出,被业界视为AI安全攻防能力的“黄金标准”。它的题库包含来自188个主流开源项目的1507个真实已修复漏洞,主要聚焦C/C++内存安全问题。赛制要求AI智能体仅凭漏洞描述和未修补的代码库,自主完成漏洞理解、定位、复现及PoC生成全流程,并通过自动化评审严格验证PoC是否可稳定触发目标漏洞。Anthropic、微软、Wiz等巨头都将其视为关键标尺。可以说,CyberGym在实战漏洞挖掘这个单点上,树立了一座高峰。
但AI安全,远不止漏洞挖掘。一个完整的测评体系,必须是多层次的。除了CyberGym,我们已经看到一个多层次、多方向的基准体系正在形成。它们从不同维度衡量AI的安全性,主要可以分为四类。
多层次测评:四大基准维度全景
第一类,是智能体安全与行为基准。 这类基准专注于评估AI智能体在复杂交互中的行为安全,比如目标保持、工具使用和长期规划。AgentShield Bench v3专门评估智能体在目标劫持、工具操纵、长期劫持等攻击下的“目标完整性”;IETF Agent Security Benchmark,覆盖感知、记忆、决策到执行的全生命周期风险;AI Safety Benchmark由中国信通院发起,针对端侧智能体,评估其在社交媒体、金融支付等场景下的内容安全与行为安全;ASSEBench用于检验评估器自身能否有效识别智能体安全风险与威胁;Agent-SafetyBench则是一个综合性基准,涵盖越狱、数据泄露、不安全工具使用等威胁。
第二类,是网络安全实战基准。 这类基准聚焦AI在真实网络安全攻防场景中的能力,与CyberGym类似。Cybench包含40个专业级CTF任务,评估AI的漏洞利用能力,其顶级模型仅解决了人类团队耗时11分钟的任务;CVE-Bench基于真实CVE漏洞,评估AI对Web漏洞的利用能力;SEC-bench专注于C/C++语言的内存安全漏洞利用评估;AutoPenBench用于生成式Agent的渗透测试通用评测;ThreatSage用于评估蓝队防御操作的模块化基准,聚合了MITRE ATT&CK等23个情报源;XBOW Validation Benchmarks由AI安全公司XBOW出品,包含104道Web漏洞挑战。
第三类,是大模型安全与红队测试基准。 这类基准主要评估大语言模型自身的安全性,以及抵抗对抗性攻击的能力。MLCommons Jailbreak Benchmark引入了“韧性差距”指标,量化模型在正常与越狱攻击下的安全性能差异;RedBench是一个通用红队数据集,汇集了37个基准的29,362个样本,覆盖22个风险类别;HarmBench是标准化评估框架,用于系统性衡量LLM的有害输出;JailbreakBench提供标准化的越狱评估测试集和排行榜;TOSSS基于CVE的软件安全基准,衡量LLM在安全与脆弱代码片段间的选择能力;Cyb-LLM则是一个统一基准,用于评估LLM在网络攻击与防御两方面的综合能力。
第四类,是综合与框架类基准。 这类基准或框架提供更宏观的评估视角或方法论。MITRE ATLAS是一个知识库,记录了针对AI系统的对抗性威胁战术和技术,常被用作红队测试参考;OWASP Top 10 for LLM是社区维护的LLM应用十大关键风险清单,是安全评估的重要威胁分类参考;NIST AI RMF是美国国家标准与技术研究院的AI风险管理框架,为AI系统的负责任设计、开发和部署提供指导。
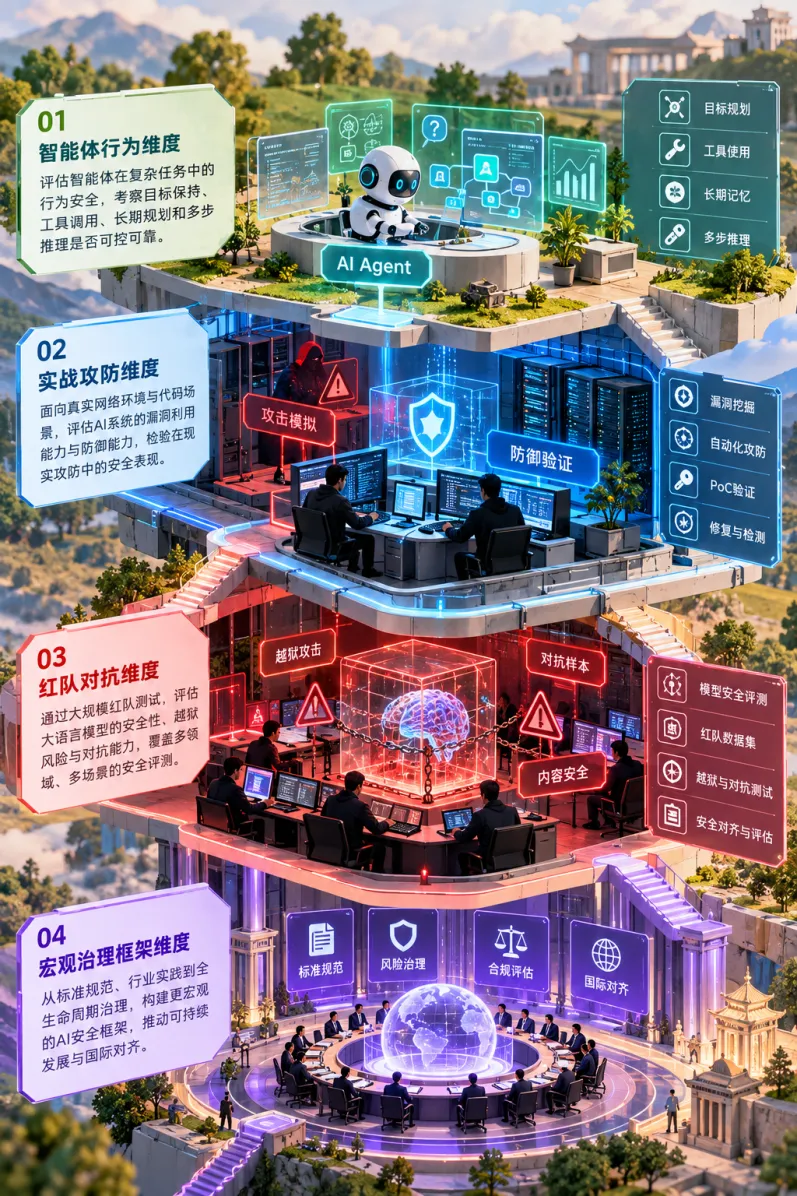
从智能体行为、实战攻防、红队对抗到宏观治理框架的四维图景
告别单点突破:铸就安全体系韧性
当我们把这些标准放在一起,一幅清晰的图景就出现了:AI安全测评,已经从早期单一的大模型内容安全,演变为一个覆盖模型、智能体、实战攻防的多层次体系。 CyberGym在实战漏洞挖掘方面树立了标杆,而其他基准则分别在智能体行为安全、大模型鲁棒性以及宏观治理框架等方向上,提供了不可或缺的互补视角。
这意味着什么?意味着我们不能再满足于“单点突破”。一个AI系统,可能在CTF中表现优异,却可能在长期交互中被目标劫持;可能能生成完美的PoC,却可能在面对越狱攻击时轻易失守。安全,从来不是某一个维度的满分,而是整个体系的韧性。
所以,我呼吁:无论是AI研究者、安全工程师,还是企业决策者,我们都应该以更系统、更实战、更开放的视角,去拥抱这些测评标准。用CyberGym检验实战能力,用AgentShield检验行为安全,用红队基准检验模型底线,用框架类标准指导治理。只有这样,我们才能真正锻造出既强大又可靠的AI安全能力。
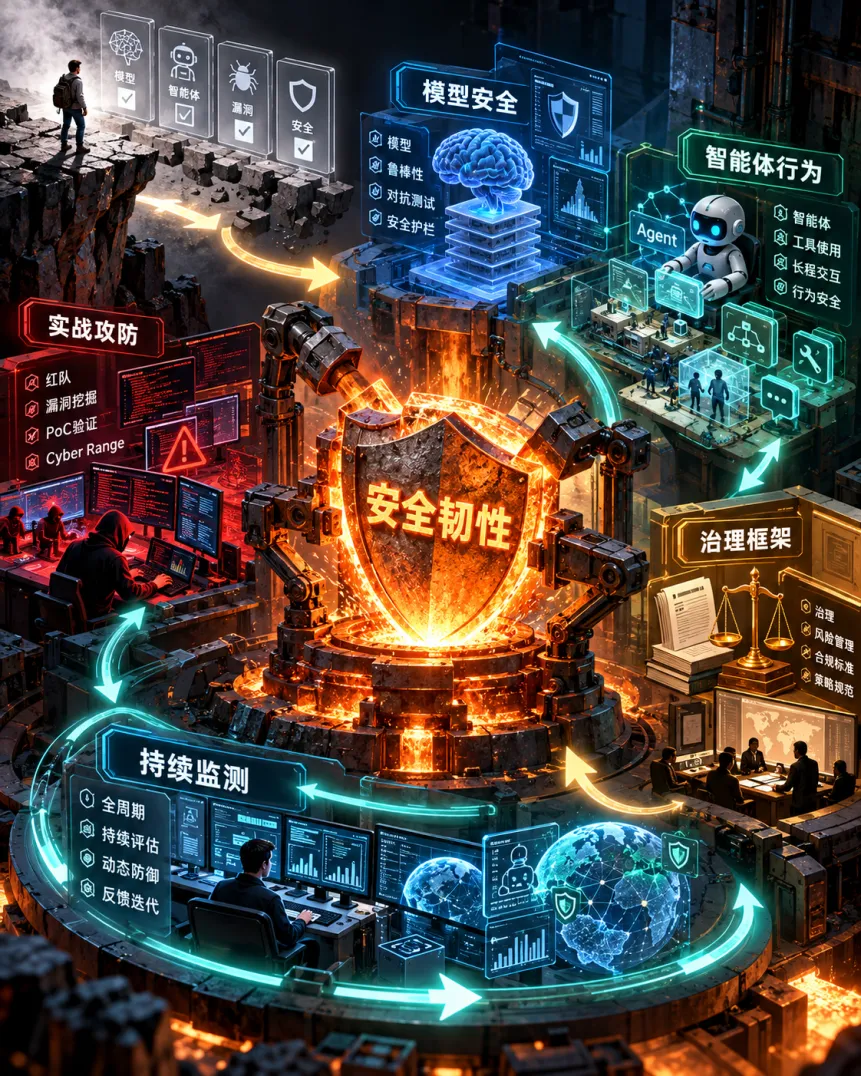
以标准为尺、以实战为炉——从单点评估迈向全周期动态安全韧性
“未来已来。让我们以标准为尺,以实战为炉,共同铸就AI时代的安全盾牌。”
谢谢大家!
> 碰撞 · 发散区 _
当AI测评从静态答题跨越至CyberGym等动态攻防与智能体目标劫持对抗,您认为企业在落地大模型应用时,哪一维度的测评标准最具有一票否决权?
👇 欢迎在评论区留下您的哲学思考 👇