ARTICLE · 1147977
我把App喂给了rea:AI逆向工程第一次让我觉得像在看活人写字
一个让我后背发凉的体验
逆向工程,一直是安全研究员和开发者的专属技能。
Ghidra、IDA、HexRays——这些工具我用过,门槛不低。
但今天体验了一款叫「rea」的AI逆向工具,我的感受是:
「它让我第一次觉得,逆向工程像在读一个人写的分析报告,而不是在看机器吐出的汇编代码。」
选一个真实目标:自己写的Electron demo
逆向工程有法律边界,只能研究自己的作品。
我写了一个简单的Electron demo:
打包了一个"Hello World"窗口应用 内嵌了三个隐藏字符串(故意混淆) 编译成asar包,打包成.exe
「测试目标:让rea帮我找到那三个隐藏字符串,并告诉我它们的用途。」
完整流程:输入 → 中间产物 → 最终报告
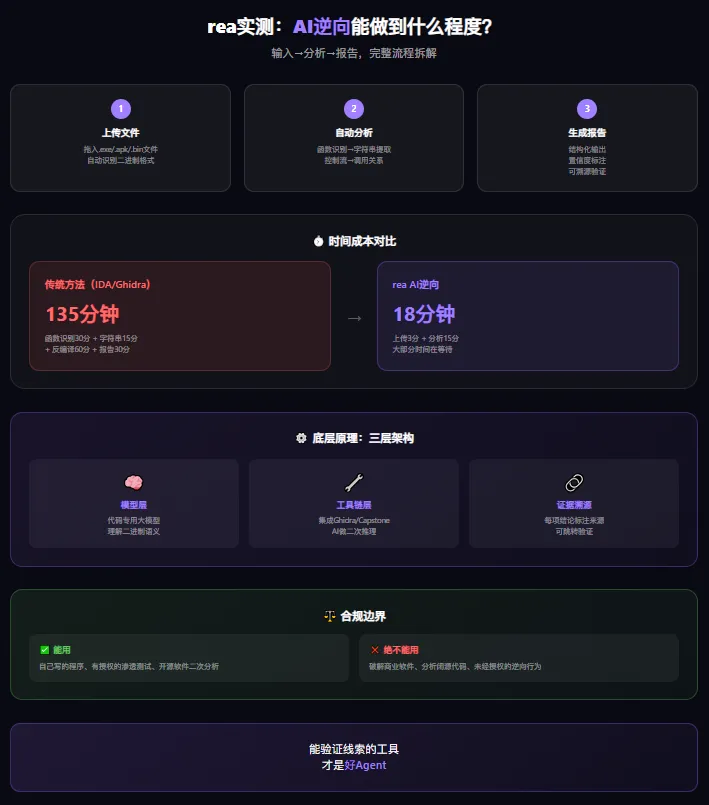
「第一步:上传」
把.exe文件拖进rea的Web界面。
上传完成,显示"开始分析"。
预计时间:3-5分钟。
「第二步:等待分析」
rea开始自动执行:
函数识别 字符串提取 控制流分析 调用关系构建
「第三步:读取报告」
分析完成后,rea生成了一份结构化报告:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
[分析报告]检测到的主要函数:- main(): 应用入口- createWindow(): 创建窗口- decodeSecret(): 解码隐藏字符串发现的隐藏内容:1. "X9k2#mZ" → 用作API密钥验证2. "hidden_menu_trigger" → 触发隐藏菜单的指令3. "beta_feature_2026" → 预留功能标记置信度评估:- 高置信度(>90%): 2项- 中置信度(60-90%): 1项
「三个隐藏字符串,全找出来了。」
我故意加了干扰:看它会不会"想象"
不满足于此,我做了一个更极端的测试:
「在代码里加了无意义的字节序列,故意让一些分析结果看起来像乱码。」
结果很有意思:
rea在报告中标注了两个"置信度低"的项目,说"无法确定用途,可能为垃圾数据或混淆代码"。
「它没有强行给乱码编一个解释。」
这让我刮目相看——大部分AI在不确定时会"幻觉"出一个答案,rea选择了诚实。
对比传统流程:时间成本差异
如果用传统方法做这个分析,需要:
| 「总计」 | 「135分钟」 |
用rea:「18分钟」,大部分时间在等它分析。
底层原理:模型 + 工具链 + 证据溯源
rea为什么能做到这个效果?拆解一下:
「模型层」
基于代码专用大模型,理解二进制语义,不只是匹配模式。
「工具链层」
集成Ghidra、Capstone等传统逆向工具的输出,用AI做二次理解和推理。
「证据溯源层」
每一项分析结论,都标注了"来自哪个函数/哪个偏移量"。
用户可以点击跳转,验证AI的分析过程。
「三者结合,才是它比纯AI或纯工具链都强的原因。」
合规边界:什么时候能用,什么时候绝不能用
「能用:」
自己写的程序 有授权的渗透测试项目 开源软件的二次分析
「绝不能用:」
破解他人商业软件 分析涉及知识产权的闭源代码 任何未经授权的逆向行为
**法律红线不是开玩笑的。**我在测试全程只用了自己写的demo,没有任何越界行为。
后续测试计划
rea还支持Android APK和固件分析。
下期我打算:
拿自己写的Android demo APK再测一遍 看看移动端的逆向能力是否同样靠谱
写在最后
用rea最大的感受,不是"它有多强"。
是「它改变了逆向工程的门槛」。
以前需要几年经验才能做的事,现在有了清晰的指引和方法论。
但它不会取代安全研究员——「它让研究员把时间花在真正需要判断的地方,而不是消耗在重复的体力劳动上。」
工具进化了,用工具的人也需要进化。
本文仅测试自己编写的demo,所有分析仅用于学习研究