ARTICLE · 1155975
【CMPS 297S GPU】P9 模板计算
模板计算是指一类在结构化网格上进行的运算,网格点的值是基于其邻近的某个子集计算得出的。模板计算是卷积的一种特殊情况。
例如,对于一个 2D 网格,该格子的值由其本身和上下、左右格子的值算出。对于一个 3D 网格,该格子的值由其本身和上下、左右、前后格子的值算出。
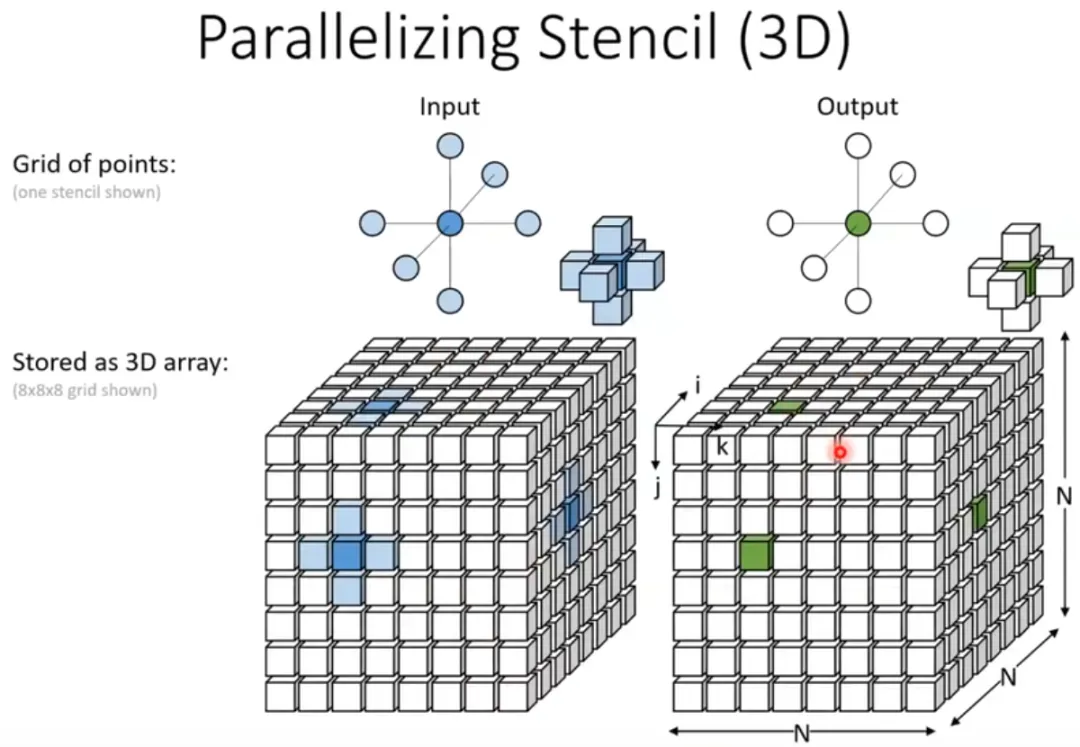
并行模式:为每个输出元素分配一个线程。
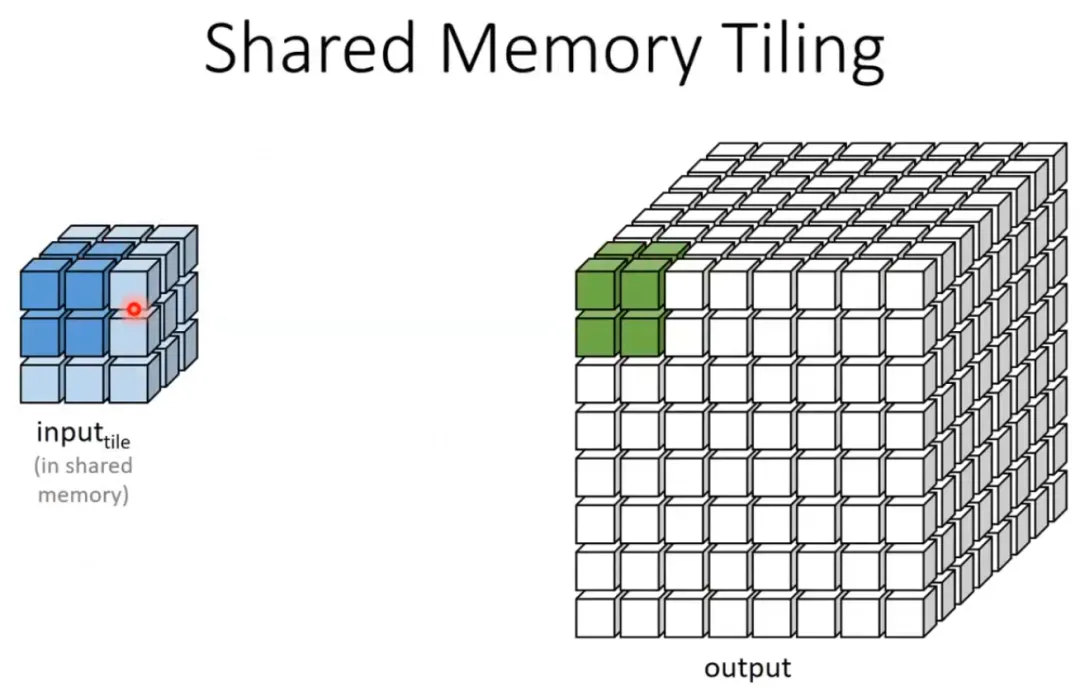
优化:每个线程加载一个元素到共享内存,其它线程就可以从共享内存中访问该元素。
挑战:输入和输出块大小不同,输入块边长 = 输出块边长 + 2
解决:分配与输入块数量相同的线程,只使用其中一部分线程计算输出分块
计算与访存比例
没有共享内存
每个线程的浮点操作数量为 6 次加法 每个线程加载全局内存的数量为 28B(7 FP) 比例: 6 OP / 28 B = 0.21 OP/B使用共享内存
考虑分块维度:input = T, output = T-2
每个 block 的计算量:
(6 OP) * (T-2)^3 = 6(T-2)^3 OP每个 block 加载全局内存的数量为
T^3 * 4B比例:
(6(T-2)^3 OP) / (4T^3 B) = 1.5(1-2/T)^3 OP/B对于 T=8,为 0.63,提升不大;如果 T=32,提升约为 2 倍
原因:边界值重复利用率较低,增大 T 就意味着边界值比例降低
但是不能增大 T,否则一个 block 内的线程数超过限制,共享内存也会超过限制
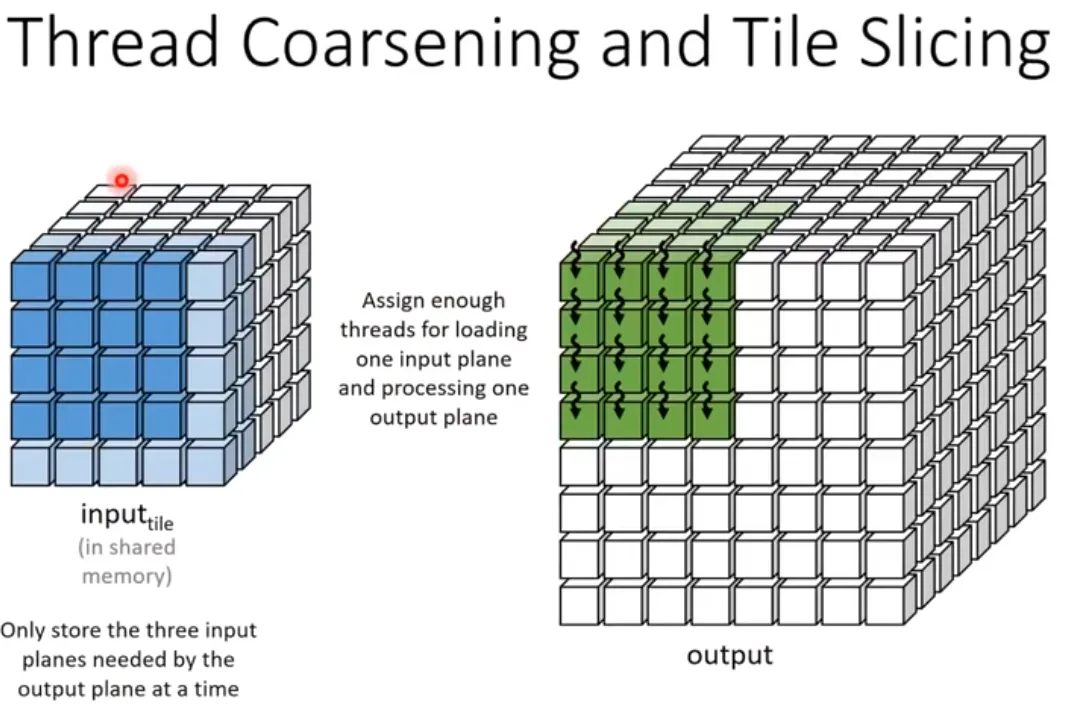
解决:线程粗化,可以在不增加线程数量的情况下扩大输出块,比如用
32 * 32的线程处理一个面,下次迭代是加载并处理下一个面。但是 prev z 面和 next z 面的大部分元素都用不到,所以不需要将 3 个面都存到共享内存,而是将 next 面加载到寄存器中。然后,当它成为 curr 面时,将寄存器中的数据移动到共享内存中。接着,当 curr 面变成 prev 面时,将共享内存中的数据移回寄存器中。数据存到寄存器而非共享内存中,这被称为寄存器分块。