ARTICLE · 1167348
multica 源码 17:附件存数据库还是磁盘——附件存储与 issue 关联机制
multica 源码系列 · 17|跟着一个上传文件,走完它在系统里的一生
附件存数据库还是磁盘?这道系统设计题的标准答案,30 秒就能背完:文件进对象存储,数据库只存元数据。
拆完 Multica 的附件子系统,我发现背完答案之后,真正的题目才刚发下来。文件用什么命名、挂在哪条记录上、删除时怎么不留下死链、换台服务器还认不认得它,每一问都有工程量。
这是 multica 源码系列第 17 篇。老规矩,代码基于 2026-09-29 的源码走读,关键结论都对着仓库核过。这次换个讲法:不按模块罗列,跟着一个上传文件,从落地走到退役。
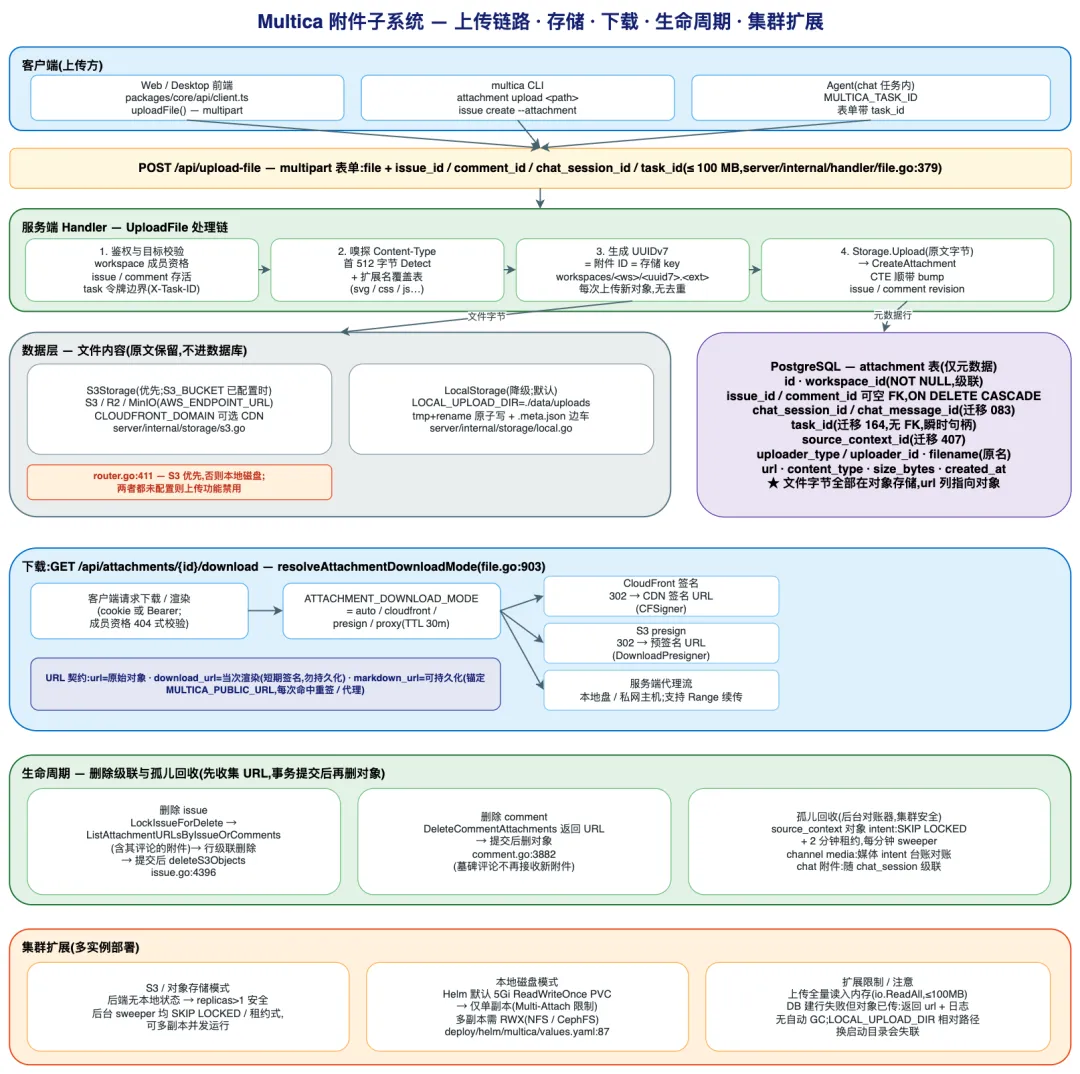
(全景图先放这儿:上传链路、存储分层、下载三模式、生命周期、集群扩展。下面按站拆,建议点开大图对照着看。)
一、落地:命运在头 512 字节就定了
一个文件进入 Multica,不管来自网页、桌面端、命令行,还是正在干活的 AI agent,都走同一个门:一个 multipart 上传端点。门后有四道检查。
第一道,身份。上传者必须是这个工作区的成员,表单里指明的 issue 或评论必须真实存在且属于本工作区。已删除的「墓碑」评论拒绝收新附件。
第二道最值得抄:服务端不信任客户端声明的文件类型。它读文件的头 512 字节做内容嗅探,再用扩展名覆盖表修正。你想把脚本改名成 .png 混进来,嗅探这一关就过不去。
第三道,命名。每个文件拿到一个 UUIDv7,这一个值同时是三样东西:附件记录的主键、对象存储里的存储 key、对外暴露的句柄。存储路径就是「工作区目录/UUID.扩展名」。
第四道,体格。单文件上限 100 MB,超过直接拒收。
这里有个乍看偷懒的设计:没有内容寻址,没有去重。同一个文件传两遍,就是两个对象、两行记录。
我认为这恰恰是算得清的取舍。去重省下的是最便宜的磁盘,换来的是内容哈希做 key、引用计数管生死——那套账本出一次 bug,代价是删错别人的文件。
附件场景里,agent 一次任务传十几张截图,磁盘根本不心疼。
还有一个限制要记着,后面会回来:上传路径会把整个文件读进内存再转发。100 MB 的上限,同时就是单请求的内存上界。
二、挂靠:一张可空外键织成的归属地图
文件落了地,下一个问题是它是谁的。
Multica 前面几篇拆库表时给过我一个印象:这个系统对外键相当克制。到附件这儿,印象破了功——attachment 表上是成组的外键,每根都指着一条归属路径。
表上几组可空外键:issue、评论、chat 会话与消息,各自一条归属路径;工作区外键则不可空,随工作区级联。一行记录一个文件,挂在哪,由哪个外键非空决定。
评论附件会同时冗余存一份 issue ID,查一个 issue 的全部家当时不必再去 join 评论表。
最反直觉的是 task 这一列。AI agent 执行任务时上传的附件先挂在 task_id 上,而这一列在第 164 号迁移里加进表时,故意没建外键。
原因:task 是个瞬时对象,任务结束时附件要改绑到一条合成的助手消息上。外键约束管的是「必须一直存在」,可这里的语义偏偏是「允许改嫁」。加了约束,改绑那天就是数据库报错那天。
多客户端同时动附件时,写路径还有一个防死锁的细节:按 issue、评论、附件的固定顺序加锁。顺序定死了,死锁就没了土壤。
三、死亡:证明题比选择题难
文件活着的事讲完了。这个子系统真正的话题,从删除开始。
麻烦的根源是个客观事实:数据库和对象存储之间没有共享事务。行删了、对象还在,是垃圾;对象删了、行还在,是死链。不管先动哪边,中间崩一次,就留下一具不一致的尸体。
Multica 选的顺序是:事务内先收集这个 issue 名下所有待删对象的地址(连评论里的附件一起),行随外键级联删除,事务提交之后,才去对象存储删文件。
方向为什么这么定?死链是用户点开就撞上的 404,垃圾是后台可以慢慢扫的账。用户体验的天平上,宁可留垃圾,不留死链。
那垃圾谁来收?一套对账系统。一张 intent 台账表记下「该删未删」,清理进程每分钟扫一轮,抢任务用 FOR UPDATE SKIP LOCKED,抢到先拿两分钟租约。
多副本同时跑也不会重复删同一批对象。
拆到这儿我才把这道题看全:「附件存哪」是道选择题,30 秒答完;「附件怎么删得干净」是道证明题,做了一整套台账加租约加定时对账。标准答案只包含选择题。
四、被取:同一份文件,三种取法,两种 URL
文件存着,总有一天要被取。取法有三种,一个环境变量切换:CDN 签名后跳转、对象存储预签名后跳转、服务端自己代理下载流。
默认自动选,有 CDN 用 CDN,本地磁盘和内网环境走代理,代理还支持断点续传。
真正容易翻车的是 URL 的语义。元数据接口对每个附件返回三个地址,命格截然不同。
第一个是原始对象地址。第二个是当次下载用的,可能是一份半小时有效期的签名链接。把它当永久链接存进自己的系统,多半等来半年后的批量 404,这是集成这类系统时最常见的事故之一。
第三个才是能持久化的那个:锚定网关域名的稳定地址,每次命中重新签名或代理。官方后来专门为这层语义修过一版,把「可长期保存的链接」和「当场生效的链接」在字段层面分开。
集成这类系统时,分清这三个字段,比记住任何架构图都省钱。
五、搬家:从一台服务器到多个副本
最后一站:这套东西怎么从单机长成集群。
答案取决于文件存在哪。配了对象存储,多副本随便加:存储后端没有实例本地状态,后台对账任务全是 SKIP LOCKED、租约这类为并发设计的安全原语。
本地磁盘模式则被 Kubernetes 摁住。Helm 默认给的持久卷是 ReadWriteOnce,第二个副本因为卷无法多机挂载,根本调度不起来。
想要多副本,要么换共享存储,要么老老实实切对象存储。chart 注释里把这条边界写得明明白白。
还有一个升级前必查的坑:本地存储目录的默认值是相对路径。哪天换了个启动目录,存量附件全部失联。自托管的读者记住这个默认值,能省一次深夜排障。
边界:这套设计别照抄
它有明确的前提:附件写入一次、不再修改、中等大小、不去重。没有分片上传,100 MB 是硬顶;改文件等于传新文件。
如果你的场景是大文件协作、频繁覆写、强一致去重,这套设计的每一条「没做」,都是留给你的坑位。
结尾
跟着这个文件走完一生,回头看那道 30 秒的选择题:存哪从来不是难点,难的是挂靠的归属、删除的一致、链接的寿命、副本的边界。
系列下一篇拆数据库变更管理——一个不停演进的在线系统,怎么安全地改自己的地基。
想继续跟这个系列的话,点个关注。