ARTICLE · 1201477
AI 只会续写文字,不会做逻辑推理:复杂工程任务该如何拆解给大模型
很多团队在使用大模型做工程文档、故障复盘、风险分析时,会遇到同一个问题: AI 输出的文字看起来通顺、专业,但细读会发现,存在逻辑跳跃、编造条款、无根推断。 不少人归因于模型能力不足,不断去换更强的大模型、更长的上下文窗口,可幻觉依旧反复出现。
核心根源常常不是模型不够强,而是任务没有被正确拆解。 大模型本质是一个预测下一个 token 的概率续写引擎,它不具备人类的目标理解、因果推理、边界判断能力。你直接把一个高度复合的工程需求一次性丢进去,它只会优先生成 “看起来合理连贯” 的文本,而不是 “符合事实、逻辑闭环、满足业务约束” 的结论。
尤其在具身智能领域(无人车、工业机器人),这个问题不再只是文笔好坏。AI 输出的错误风险结论、虚构的法规条款,一旦被采信,会直接带来安全事故、合规处罚。
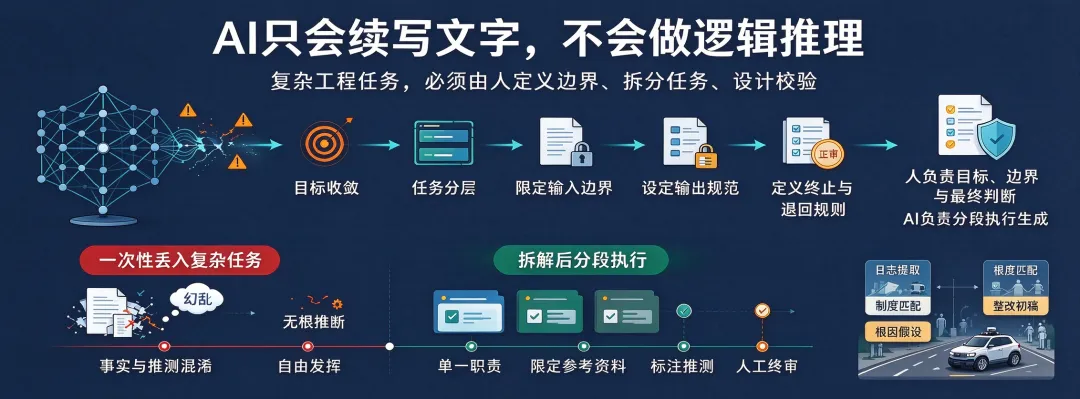
所以,我们不能让 AI 直接解决复杂工程问题。 正确分工是:人负责定义目标、拆分任务、划定边界、设计校验;AI 负责分段执行生成。
一、为什么一次性丢复杂任务给 AI,必然容易翻车?
举一个具身智能的典型需求: “帮我写一份无人车路测事件的完整风险评估报告。”
这句话里面同时包含:信息提取、时间线梳理、法规匹配、根因假设、风险定级、整改方案撰写多个不同类型任务。
信息提取:属于信息摘抄,AI 适合; 根因判断、风险定级:属于专业推理,AI 极易幻觉。
大模型不会自动识别任务内部的风险等级,不会自动区分 “事实摘录” 和 “主观推断”,会直接混在一起输出。于是报告里,把推测当成事实、编造制度条款的幻觉就产生了。
简单总结 3 条底层局限:
AI 没有内置任务优先级,不会主动把大任务切分成串行子步骤; AI 分不清 “可直接摘抄的客观素材” 和 “需要专业人评审的推理结论”; AI 没有天然约束,在信息不足时,倾向编造内容补全文本,而不是直接承认信息缺失。
模型能力越强,文字越逼真,幻觉越隐蔽,对工程场景越危险。
二、工程场景任务拆解五步法(核心方法论)
这套框架专门用来把模糊复杂工程需求,转化为 AI 可以稳定执行的子任务。 适用场景:事故复盘、风险评估、应急预案、安全文档、Agent 任务定义。
Step1 目标收敛:剥离表面需求,锁定最终产出先填 4 个问题,不写清楚,不进入下一步:
最终产出物是什么?(例:无人车路测事件风险评估报告) 这份文档给谁用?(内部复盘 / 监管汇报 / 安全评审) 硬性约束清单:适用法规、安全红线、格式规范、禁止表述 错误代价:AI 输出错误会带来什么后果?
目的:防止 AI 自由发挥,产出不符合评审要求的内容。
Step2 任务分层:拆成单一职责的串行子任务原则:一个子任务,只交给 AI 做一件事。 高风险推理环节,单独拆分,并且强制后续人工审核。
无人车事故复盘示例拆分:
子任务 1:仅从原始日志提取事件时间线,只摘录客观事实,禁止做任何根因判断 子任务 2:对照给定安全制度文档,列出事件关联的条款原文 子任务 3:生成 3 条根因假设,所有假设必须标记【推测】 子任务 4:基于假设,生成整改措施初稿
重点:推理、风险判定、定级,永远单独隔离,不能和信息提取合并在同一个 prompt。
Step3 限定输入边界:锁死参考资料来源明确允许 AI 引用的文档、日志、知识库; 禁止 AI 调用模型内置的陈旧常识、网络信息。 幻觉最大来源之一,就是 AI 脱离给定材料,调用模型内部知识库脑补信息。
Step4 设定输出规范强制固定输出结构;强制 AI 区分事实与推测。 标准指令:所有结论必须标注资料出处,没有原文支撑的观点标记【推测】,严禁直接作为事实陈述。信息不足时直接说明,不要自行补充内容。
Step5 定义终止与退回规则明确:
什么状态代表任务合格完成; 哪些错误类型,必须退回 AI 重新生成; 哪些高风险结论,必须强制人工介入终审,AI 无权直接定稿。
三、配套:三层校验机制,拦截 AI 幻觉
任务拆分只是第一步。即便拆好了,仍然需要校验机制,三层递进:
第一层|规则校验(机器侧) 检查格式、禁用词、引用来源,识别无来源结论。 第二层|交叉逻辑复核(AI 互审) 使用第二轮 prompt,让模型反向审阅输出,查找逻辑矛盾、跳跃推断。 参考提示词:你作为安全评审专家,检查这份报告,标出所有缺少原文支撑的结论、逻辑断层、过度推断内容。 第三层|专业人工终审(不可省略) 风险判断、法规结论、安全定级,必须由具备行业经验的人最终确认。
在具身智能、安全工程场景,人工终审是底线,无法被任何大模型替代。
四、实战小案例
需求:对一段机器人故障日志,输出初步故障分析。
错误方式(一次性丢全部任务)
根据日志,分析本次机器人故障,给出根因和风险评估。
正确拆解方式
子任务 1:提取日志内客观事件序列,只摘抄事实,不推断原因 子任务 2:列出日志里出现的异常信号 子任务 3:基于上述信息,列出可能根因,全部标注推测 子任务 4:交叉复核,检查有无超出日志内容的推断 人工:评估可能性,确认最终结论
五、落地建议与边界认知
这套方法不是用来替代工程师,而是把工程师从大量摘抄、整理、初稿撰写这类重复性劳动释放出来,把精力集中在判断、风险决策上。
模型越强,越需要严格的约束和拆解。强模型更容易生成看起来完美的虚假结论。
通用性提示词作用有限;真正有价值的,是绑定行业业务的整套任务拆解 + 校验 SOP。
单纯的提示词技巧很快会同质化贬值。 未来在具身智能赛道,稀缺能力是:定义任务边界、拆分复杂工程目标、搭建 AI 输出校验体系。