ARTICLE · 1208220
别再把AI当“聊天工具”了!手把手教你训练一个“只懂你”的专属模型,有人靠它半年赚了375万
🔥🔥🔥 【万字实操】别再把AI当“聊天工具”了!手把手教你训练一个“只懂你”的专属模型,有人靠它半年赚了375万 🔥🔥🔥
━━━━━━━━━━━━━━━━━━━━━━━━━━━━
💬 先问你一个扎心的问题:你每天打开豆包、DeepSeek、ChatGPT,问它问题、让它写东西,但它真的“懂你”吗?
😫 你把自己的日记、笔记、客户资料、行业经验喂给它,它转头就忘。你让它模仿你的写作风格,它写出来还是那股“AI味儿”。你问它一个只有你们行业才懂的术语,它要么泛泛而谈,要么直接编一个错误答案。
💡 为什么会这样?因为你现在用的,是“通才”,不是“专才”。
📌 打个最简单的比方:你现在用的通用大模型,就像一个刚读完几亿本书的顶级大学毕业生。他什么都懂一点,但他没在你们公司上过一天班,没读过你的私人笔记,没听过你说话的语气,更不知道你们行业那些“只有自己人才懂”的门道。
🎯 而“训练自己的模型”,就是把这个“通才毕业生”,送进你的“私人科室”做定向培训,让他变成只为你服务的“专属专家” 。
📊 先看几个真实到让人坐不住的案例:
👉 一个曾被打上“争议标签”、被多平台封禁的情感博主,把自己的方法论和说话风格“训练”进一个AI分身App,上线6个月,下载量约23万次,收入约56万美元(约合375万元人民币),会员价199元/月。
👉 两个完全不会写代码的大学生,用AI无代码工具做了一个田径跑姿分析App,凭15万粉丝“预销售”,上线首月入7万,半年总收入约50万,4万+用户,4.7分好评。
👉 一位前新东方老师,做AI英语口语陪练,400个月卡用户,月营收12万,月卡299、季卡799,边际成本极低。
😲 但另一面也必须同时看:有人花大价钱租显卡、买数据、折腾几个月,训出来的模型连自己都不愿意用。有人把一堆乱七八糟的聊天记录直接扔进去,结果模型学会了骂人,却学不会干活。
👉 训练模型的门槛确实被AI砸低了,但没有低到“扔进去就能用”。区别不在显卡,在于你“喂什么、怎么喂、训完拿来干什么”。
📌 这篇不跟你扯“反向传播的数学推导”,也不让你去学Python。就讲五件事:模型到底是什么、为什么普通人现在真的能训、零基础怎么一步步训出第一个、训完之后靠什么赚钱、以及未来它会变成什么样。工具路径、真实数据、避坑红线,全部摊开。
字数极长,建议先【收藏】,再对照自己的情况挑一条路走。
🧠 01 先把“模型”这两个字说人话:它到底是什么,为什么需要“训练”
🎯 你不需要懂神经网络,你只需要懂一个比喻。
🎛️ 模型是什么?就是一个“巨大的调音台”
想象一个调音台,上面有几百万甚至几十亿个“旋钮”。每个旋钮控制着模型对世界的某一种“理解”。
· 有些旋钮决定它怎么理解语法;
· 有些旋钮决定它怎么判断语气;
· 有些旋钮决定它在什么场景下该说什么话。
“训练”,就是把这些旋钮拧到最合适的位置 。
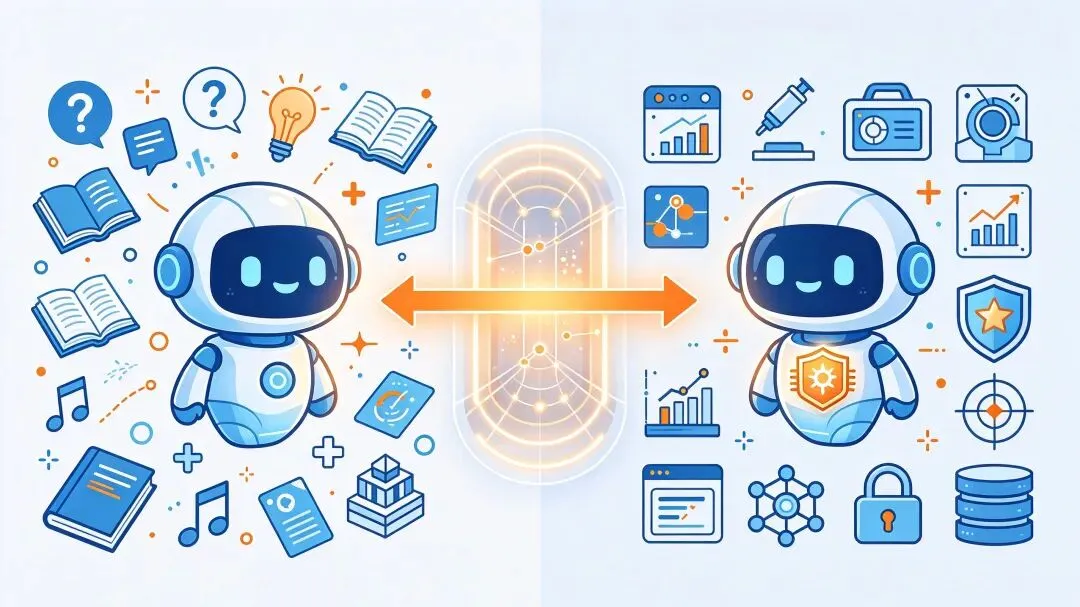
📚 训练分两步:先“上通识课”,再“上专业课”
🟢 第一步:预训练(Pre-training)——“上通识课”
用整个互联网级别的海量文本,让模型学会语言的通用规律、世界的基本常识。这一步极其昂贵,不是普通人干的活,是OpenAI、阿里、DeepSeek这些机构干的。
🟡 第二步:微调(Fine-tuning)——“上专业课”
拿一个已经上完通识课的“通才模型”,用你自己的数据,对它进行短期定向培训,让它变成你所在领域的“专才”。
👉 你要做的,是第二步。你不需要从头造一个大脑,你只需要对一个现成的大脑做“定向改造”。
🧬 微调到底怎么“调”?LoRA是普通人的命根子
传统“全参数微调”,相当于把模型所有旋钮全部重新拧一遍。效果最彻底,但需要庞大的GPU集群和极长的训练时间,普通人的钱包根本扛不住。
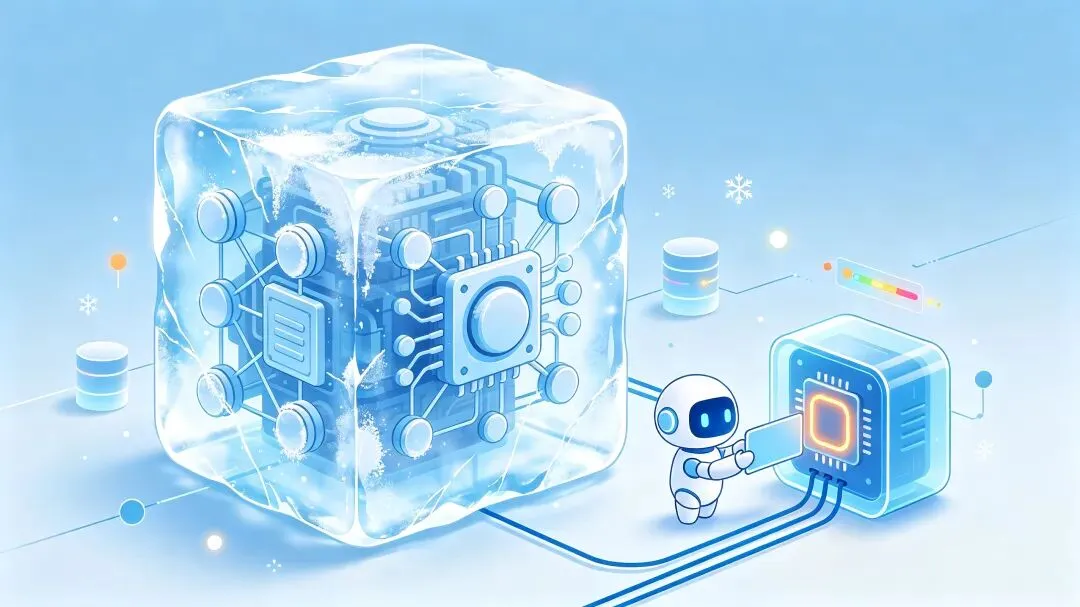
LoRA(低秩适应) 的逻辑完全不一样:原始模型的旋钮全部冻结不动,只在旁边额外加一个非常小的“外挂模块” ,只训练这个外挂模块。
📌 关键数字:LoRA通常只需要训练原模型0.1%—1%的参数,就能达到接近全参数微调90%以上的效果。
📌 硬件门槛:一张6GB以上显存的消费级显卡(RTX 2060以上)就能跑。如果连显卡都没有,用云GPU平台,按小时租,成本更低。
👉 一句话:LoRA把“训练模型”从“机构级工程”,变成了“个人级操作”。
🆚 顺便说清楚:微调不是RAG,两者是搭档
很多人会问:我给AI挂一个知识库(RAG),不就等于让它“懂我的资料”了吗?为什么还要微调?
· RAG:相当于给AI配了一个“智能资料柜”。你提问,它先去柜子里翻资料,然后把资料交给你。优点是资料一改就生效,答案是“有出处”的;缺点是AI本身的“思维方式”没变,它只是在“照着资料念” 。
· 微调:是把知识“内化”进模型的判断方式里。适合训练“风格、语气、行业判断逻辑”,而不是单纯查询事实。
👉 实战里最常见的组合:微调管“怎么想、怎么说”,RAG管“从哪查”。
⚡ 02 为什么2026年,普通人真的能训自己的模型了?
📌 三件事同时发生了,把门槛砸穿了。
🟢 第一,LoRA/QLoRA把显卡门槛降到了消费级。
QLoRA(4-bit量化)比标准LoRA更省显存。一张RTX 4090(24GB),就能对7B—9B级别的模型做QLoRA微调。如果你连4090都没有,云GPU按小时租,训练几个小时的成本可能比你想象的低得多。
🟡 第二,零代码/低代码平台把“写代码”这一步拿掉了。
现在已经有大量可视化微调工具,你只需要上传数据、点几个选项、点“开始训练” ,不需要碰一行代码。
🔴 第三,开源模型的质量已经足够“当底座”。
Qwen、Llama等开源模型,本身已经具备很强的通用能力。你要做的不是“教它说话”,而是“教它用你的方式说话、在你的场景里判断” 。
🛠️ 03 零帧起手:从“打开网页”到“训出第一个专属模型”,一步一步来
📌 新手第一条铁律:不要一上来就训“全能助手”。选一个极窄的场景,训一个“只会干一件事”的小模型。
🟢 第1步:选场景——只选“你每天重复做、且AI现在做得不够好”的那一件事
候选场景:
· 模仿你的写作风格,生成小红书/公众号初稿;
· 用你们行业的术语和判断逻辑,回答客户常见问题;
· 把你的课程/咨询方法论,做成一个可对话的“知识分身”;
· 把某类固定格式的文档(合同条款、报告模板)自动生成。
❌ 不要选:“帮我处理所有工作”“做我的全能助理”。场景越窄,数据越好准备,效果越容易验证。
🟡 第2步:选平台——零代码优先,别一上来就折腾环境
🟢 Unsloth Studio(推荐纯新手) :开源、无代码Web界面,支持500+开源模型,支持QLoRA/LoRA微调,训练速度更快、显存占用更低。可以在Vast.ai等云GPU平台上一键启动。
🟢 阿里云百炼:国内一站式平台,提供可视化微调,支持SFT、LoRA、QLoRA等,无需自己配置训练环境,上传数据集即可。
🟢 Ease-Mind(开源傻瓜式) :可视化微调流程,支持docx/txt/md/csv/json多种数据格式,有“快速/均衡/高质量”预设,一键启动。
🟢 LLaMA-Factory Online:低门槛云GPU微调平台,适合想跑标准LoRA流程的新手。
👉 第一条路径:用Unsloth Studio或阿里云百炼,先跑通“上传数据→点训练→拿到模型→对话测试”的完整闭环。 不追求效果完美,追求“走通一遍”。
🔴 第3步:准备数据——这是整个训练里最值钱的一步,没有之一
📌 模型的质量,90%取决于你喂给它的数据质量,10%才取决于你调了什么参数。
数据长什么样? 最常见的是“指令—回答”对:
指令:帮我写一段关于XX产品的小红书文案,语气轻松,带emoji。
回答:(你自己写的一段真正符合你风格的回答)
要准备多少? 对于LoRA微调,几百到几千条高质量样本,就可以开始看到效果。不要一上来追求几万条,先做200—500条“精品”,跑通再看要不要扩。
什么样的数据算“好数据”?
✅ 真实:是你自己写的、你认可的、符合你判断的。
✅ 干净:没有乱码、没有复制粘贴的垃圾、没有自相矛盾的回答。
✅ 一致:风格统一。你不能一半是正式公文,一半是网络段子,模型会精神分裂。
✅ 场景集中:同一个模型只训一个场景,不要混着训。
⚠️ 最常见的翻车:把微信聊天记录直接导出扔进去。 里面有错别字、有表情包、有半句话、有互相矛盾的信息,训出来的模型只会“像你但不像样”。
🟣 第4步:开始训练——参数先别动,用预设
在零代码平台上,先选“快速/均衡”预设,直接用默认参数跑第一轮。你不需要理解学习率、批次大小、LoRA秩是什么,第一轮的目标是“看到loss曲线在下降”,确认训练流程是通的。
训练时间:取决于模型大小、数据量和GPU。7B级别模型、几百到几千条数据,在单张消费级显卡上通常小时级就能完成一轮。
🟤 第5步:测试——先自己“找茬”,别急着给人用
训练完成后,直接在平台里对话测试。不要问“你好不好”,要问“你在这个场景下会不会犯错” :
· 给它10个你场景里最典型的问题,看回答是否符合你的判断逻辑;
· 给它3个“边界情况”,看它会不会胡编;
· 让它模仿你写3段东西,你自己读一遍,像不像你。
如果效果不行,先回去改数据,不要先改参数。 绝大多数“训不好”,问题出在数据上,不在参数上。
⚫ 第6步:部署——让它“能用起来”,而不是躺在训练记录里
零代码平台通常支持生成API Key,你可以把训好的模型接到第三方客户端、网页、甚至飞书/钉钉/企业微信里。第一步先让自己每天用起来,再考虑给别人用。
💰 04 训完之后靠什么赚钱:四条真实在跑的变现路径
📌 不要一上来就想“卖模型”。模型本身很难直接卖,值钱的是“模型+场景+交付”。
💵 路径一:AI分身/知识付费——“把你的方法论变成可订阅的产品”
🎯 逻辑:你有一门手艺、一套判断逻辑、一种说话方式,以前只能靠课程、咨询、社群交付。现在可以把这些东西“训”成一个AI分身,按订阅收费,24小时交付。
📊 真实案例:情感博主曲曲的AI分身App“美人支招”,把她的方法论和风格装进AI,会员199元/月,6个月下载23万次、收入约56万美元。前新东方老师的AI英语口语陪练,月卡299/季卡799,400用户月营收12万。
⚠️ 关键前提:你得真的有一套被验证过的方法论,并且有一批愿意为它付费的人。AI分身放大的是“已有的信任”,不是“凭空创造信任”。
📦 路径二:垂直工具/小程序——“把一次专业服务,变成一杯奶茶钱的订阅”
🎯 逻辑:某个专业服务(私教、翻译、简历诊断、合同初审)以前按次收费、价格高、供给少。你用微调/无代码工具把它做成一个小工具,按订阅或按次收低价。
📊 真实案例:两个大学生做田径跑姿分析App,把“私教一节课几百块”变成“一年一杯奶茶钱”,首月7万、半年50万、4万+用户。
⚠️ 关键前提:需求必须真实且高频。田径跑姿能成,是因为“练的人多、给反馈的人少”。先验证有人愿意付钱,再做产品。
🧑🏫 路径三:帮别人训模型/搭知识库——“卖铲子给想挖金矿的人”
🎯 逻辑:大量中小企业、个体IP想做“自己的AI”,但不会选模型、不会准备数据、不会部署。你帮他们跑通“数据整理→微调→部署”的全流程,按项目收费。
📊 参考行情:为律所搭建私有RAG系统,单项目收入可达5万+。企业级知识库/智能客服搭建,报价2000—20000元不等。
⚠️ 关键前提:你不需要是算法工程师,但你需要懂数据质量判断、懂平台操作、懂交付标准。
🛠️ 路径四:卖“经验”本身——“教别人训第一个模型”
🎯 逻辑:大多数人不是学不会,是不想自己摸索“该选哪个平台、数据怎么准备、参数怎么调”。你把跑通的流程封装成陪跑/课程/模板,收“省时间”的钱。
📊 参考定价:入门陪跑199—499元,交付标准是“对方能独立训出一个可对话的模型”;进阶陪跑(含数据诊断+部署)500—1500元。
🔮 05 未来:你训的模型,会变成你的“个人智能体”
📌 2026年9月,全球AI圈被一个词刷屏了:个人Agent(个人智能体) 。
Meta推出的个人智能体Muse,上线12天下载量约280万次,跑得比当年ChatGPT移动端还快。字节在推进代号“Spell”的个人助理,腾讯上线LightVela,阿里即将推出“千问Go!”。
🎯 个人智能体和“聊天机器人”的根本区别是什么?
聊天机器人:你问,它答,关掉就忘。
个人智能体:它一直在,记得你的上下文,自己找活干,手里的权限越来越大。
📌 这意味着什么?
你现在训的那个“只会写小红书文案”的小模型,未来不是孤立存在的。它会变成你个人智能体里的一个“技能模块” 。你的智能体可能同时调用:
· 一个“懂你写作风格”的微调模型;
· 一个“存着你所有资料”的RAG知识库;
· 一个“能替你执行操作”的工具调用能力。
谁先把自己的数据、判断逻辑、工作流程“训练”成可被AI调用的模块,谁就在个人智能体时代拥有真正的“数字资产”。 不是模型本身值钱,是“只有你有、别人复制不了的那部分数据+判断” 值钱。
⚠️ 06 五个坑,训练模型这条路上尤其要小心
🚫 坑一:一上来就训“全能模型”。 场景越宽,数据越难准备,效果越难验证。先训一个“只会干一件事”的,跑通再扩。
🚫 坑二:数据不干净,训了等于白训。 聊天记录直接导出、网上随便爬的文本、自相矛盾的素材——模型会忠实地学会你的垃圾。先花时间清洗,比调参数重要一百倍。
🚫 坑三:把RAG和微调混为一谈。 想让模型“知道某份资料”,用RAG;想让模型“用你的方式判断和表达”,用微调。用错工具,钱和时间都白花。
🚫 坑四:以为“训完就能卖”。 模型本身不是产品。产品是“场景+交付+定价”的组合。先想清楚谁付钱、为什么付钱,再动手训。
🚫 坑五:忽略合规和伦理红线。 如果你的模型涉及情感建议、医疗、法律、金融等场景,明确标注“AI辅助,非专业意见”,不承诺效果 。克隆他人音色需要授权,使用他人数据需要确认权利。模型放大的是你的判断,也包括你的责任。
🚀 07 今天就干的三步
🟢 第1步:写下三个“你每天重复做、且现在AI做得不够好”的场景。 不选平台、不看教程,先把你脑子里的“痛点”列出来。那个反复让你烦的事,就是你的第一个训练场景。
🟡 第2步:打开一个零代码平台,用100条数据跑通一次“训练→对话测试”的完整闭环。 用Unsloth Studio、阿里云百炼或Ease-Mind,准备100条你自己写的“指令—回答”对,点一次训练,看loss曲线下降,然后问它一个问题,看它答得像不像你。不追求完美,追求“走通一遍”。
🔴 第3步:把训好的模型,接到你每天用的一个工具里。 生成API Key,接到飞书/钉钉/网页/客户端。让它在你真实的工作流里被用一次。 被用过的模型,才有迭代的方向;躺在训练记录里的模型,永远只是实验。
📌 训练自己的模型,不是“学一项技术”,是“把你脑子里那部分别人拿不走的东西,变成AI能替你复用的能力”。AI把训练的门槛砸低了,但“你凭什么值得被训练”这个问题,只有你自己能回答。
━━━━━━━━━━━━━━━━━━━━━━━━━━━━
📚 调研报告与数据来源(全部来自公开可查的真实报道与技术文档):
🔍 模型训练原理与LoRA/QLoRA: 科普中国《像教孩子一样“训练”AI》(2026-07-23);阿里云开发者社区《从“通才”到“专才”:预训练与微调》(2026-02-10);阿里云开发者社区《AI也能“专业进修”?不用写代码,教你用微调打造行业专属模型》(2026-01-29);阿里云开发者社区《零代码基础也能懂的LoRA微调全指南》(2026-01-07)。
🔍 零代码平台与硬件门槛: Unsloth Studio文档(Vast.ai,2026-10-08):无代码Web UI,支持QLoRA/LoRA,500+模型;Qwen3.5-2B QLoRA可在单张RTX 4090(24GB)上运行。阿里云百炼平台解析(2026-05-28):可视化微调,支持SFT/LoRA/QLoRA。Ease-Mind GitHub(2026-08-10):可视化傻瓜式微调,支持docx/txt/md/csv/json,预设“快速/均衡/高质量”。
🔍 AI分身/知识付费案例: 投资界《被封杀的“大结果之母”,靠AI卷土重来赚了三百万》(2026-10-18):曲曲AI分身App“美人支招”上线6个月下载23万次、收入约56万美元(约375万元人民币),会员199元/月。cpengx.cn《AI英语口语陪练:前新东方老师400用户月营收12万》(2026-08-26):月卡299/季卡799。
🔍 垂直工具/小程序案例: 阿里云开发者社区《两个大学生把训练视频做成App,半年赚50万》(2026-10-17):首月约7万、半年约50万、4万+用户、4.7分,2周上线、成本不到3500元。
🔍 个人智能体趋势: OFweek《Muse起势、大厂谋变,个人智能体激战前夜》(2026-10-16):Meta Muse上线12天约280万次下载;字节“Spell”、腾讯LightVela、阿里“千问Go!”、蚂蚁“灵光”布局。36氪/OFweek:个人Agent持续在线、记得上下文、自主执行任务。
🔍 帮别人搭知识库/系统参考: CSDN《AI知识库与RAG系统》(2026-03-06):为律所搭建私有RAG系统,单项目收入5万+。
📅 核验日期:2026年10月19日。 以上收益数据为公开报道中的个案或区间参考,不代表普遍收益。训练模型涉及数据版权、个人信息保护、生成内容合规等法律要求;使用他人数据/音色需获得授权;涉及专业建议(医疗/法律/金融/情感)的场景,须明确标注AI辅助性质,不承诺效果。平台工具政策、免费额度、商用许可条款以官方最新页面为准。