ARTICLE · 1210390
让 AI 编码 agent 自己拆软件:REA 这个逆向工程工具我没想到会这么快
你在一个软件里看到过一个特别好用的功能,想把它做进自己的产品。以前只有两条路:靠猜,或者靠反汇编工具里一行行硬啃。
REA 想给你第三条:让你的 AI 编码 agent 自己拆。
它是一个开在本地、通过 MCP 协议接给 agent 用的逆向工程工具集。项目四月中旬才建仓,现在已经攒到三十万星、七万七千多 fork,协议是 MIT,代码以 TypeScript 为主,核心能力包装成 npm 包 rea-agents。
它的完整形态是:一个 MCP 服务器 + 一套给 agent 的工作流指令 + 一层对各路逆向引擎的适配。
装好之后,你在 Claude Code、Codex、Cursor 里提一句「看看 Notion 怎么复制富文本的」,agent 就会自己去拆包、定位代码、追调用链,然后把结论连同一串可核查的证据交给你。
它到底能拆什么
这是 REA 最容易被低估的部分。大多数人以为它只管「反编译一个 exe」,实际上它覆盖了二十多种目标形态,按目标分大致是这些:
原生二进制:给 Hopper、Ghidra、IDA 做桥接,返回反编译伪代码、汇编、字符串、符号、调用关系、交叉引用。也支持用 objdump、Rizin 做纯离线的静态检查。
JavaScript / Electron 应用:分析解包后的目录或 .asar,给出模块、导入关系、路由、IPC 通道,以及主进程和渲染进程之间的边界。这一步是纯静态的,不需要装任何反汇编引擎。
.NET 程序集:读 PE/CLI 元数据、IL 指令、声明的原生依赖,能对比两次编译的差异。
泛平台产物:Android APK(内置 headless JADX 反编译,输出 Manifest、类、方法、引用)、Android 真机(adb 的设备、进程、日志、截图、文件传输)、Flutter APK(Dart 快照哈希、各 ABI 库摘要、引擎构建来源)、HarmonyOS hap/hsp。
二进制里的语言指纹:Go 二进制能读出编译器和模块依赖,Rust 也能读出 cargo-auditable 记录的 crate 名、版本和依赖边,有些还能拿到源码地址。这部分不需要装 Go 或 Rust。
特殊格式:WASM(校验、导入导出 WAT 形态)、EVM 字节码(分发选择器、字节偏移、参数推断、可变性)、SQLite 数据库、Apple 应用包结构。
固件与设备:binwalk 或 unblob 拆固件镜像,输出分区结构和提取结果;逻辑分析仪录音可以按 sigrok 解码器解出协议时序。
运行时观察:浏览器页面(结构、脚本、网络请求、按需截图)、录好的 HAR 或 Fiddler SAZ 抓包、pcap 包摘要、进程行为捕获(终端输出、交互、退出码、文件系统变化)、Linux crash 现场(寄存器、信号、内存映射)、Frida 动态插桩。
版本对比:任意两个产物之间做清单级对比,按路径、内容、元数据、图关系找差异,还能顺着差异找行为变化。
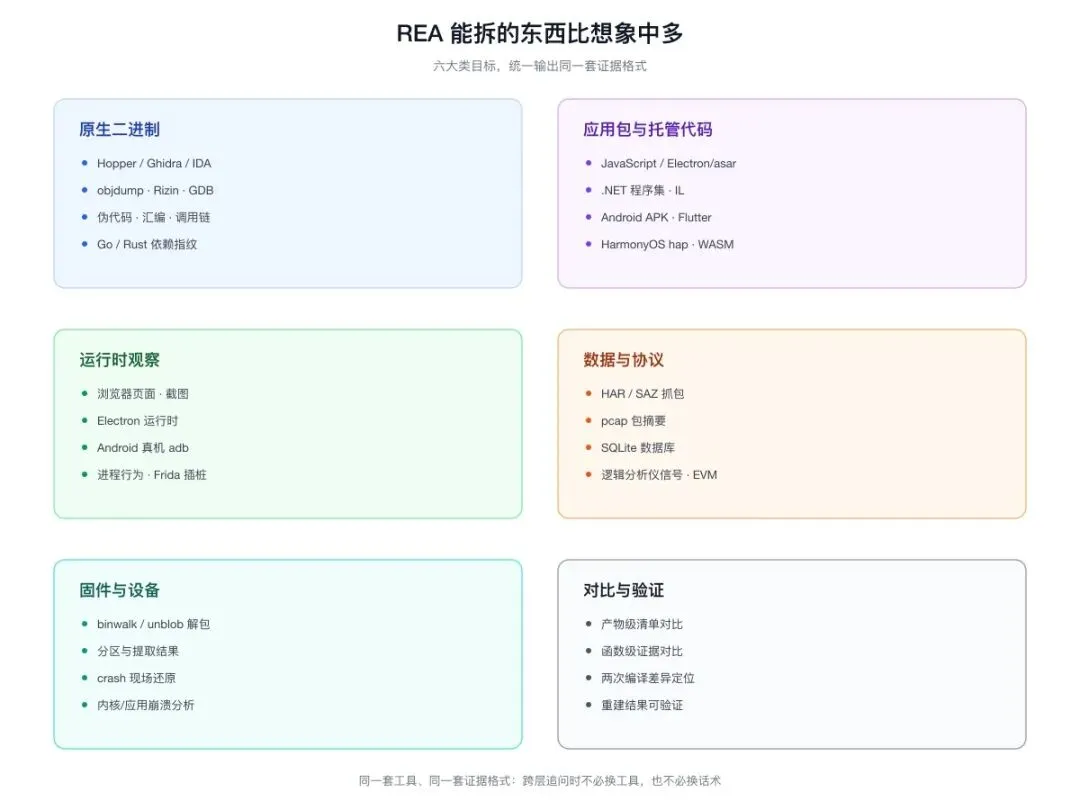 支持目标全景
这个清单本身就说明了 REA 的定位:一款给 agent 用的「万能拆解台」。传统工具各管一段——IDA 管原生,Chrome DevTools 管网页,jadx 管安卓,binwalk 管固件——REA 做的是把它们的输出统一成同一套证据格式,让 agent 能用同一套问法跨层追问。
为什么这次不一样
AI 看反编译代码这件事,早就有人试过。把 Ghidra 的伪代码贴给大模型,让它解释,这条路一直不太行,因为模型很容易编。
REA 把主要精力放在了一件很笨的事上:每一条结论都必须带证据。
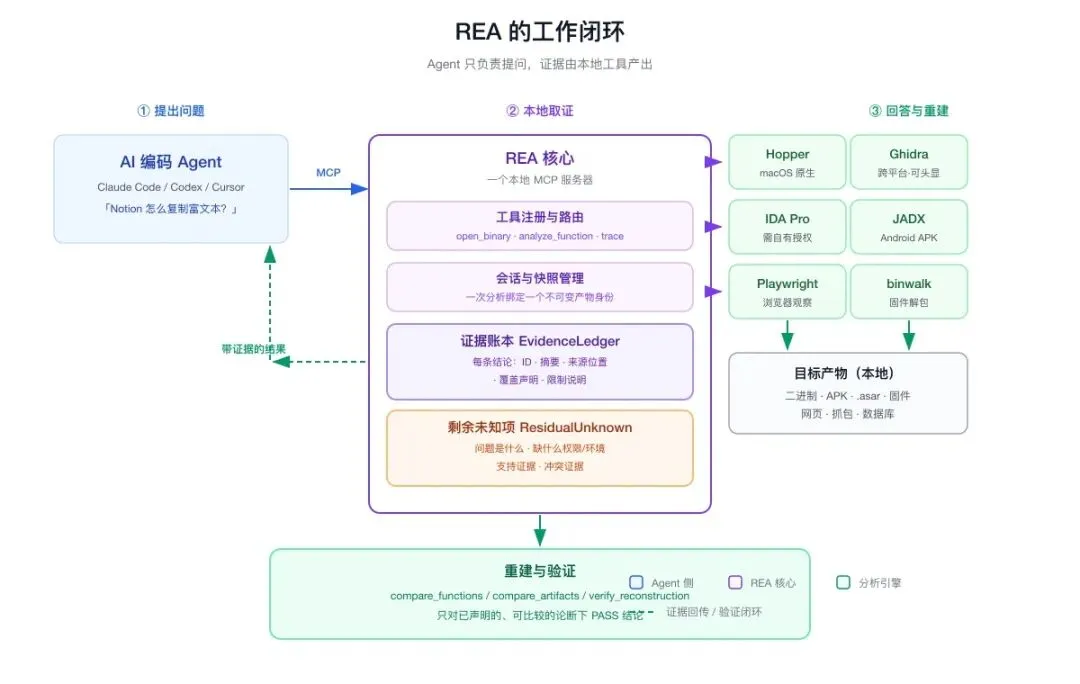 工作闭环
它内部有一本账,叫 EvidenceLedger,记录会话里产生过的全部证据。每条证据都有唯一 ID、内容摘要、来源位置、分析参数,还有一份「这次看到了什么、没看到什么」的覆盖声明。
举个它文档里的例子。分析 Notion 的预加载脚本,返回的东西长这样:
暴露给页面的 API: api_key: “__electronApi” 来源: preload.js:1:22764–22828 渲染进程的 IPC 调用: operation: “invoke” 来源: preload.js:1:6486–6522这不是「我看到大致是这么回事」,而是精确到字节的偏移区间。agent 拿着这个位置回去读原始代码,确认无误再往下追:ipcRenderer.invoke 里带的通道名叫 notion:clipboard:write,拿这个名字去主进程包里搜,找到 ipcMain.handle 的注册处,再往后就是 Electron 的 clipboard.write。
四步走完,一条链路闭合。每一步都有出处,任何一步错了都能回去核对。
这套机制的狠处在于,它把「不知道」也当成了正式产出。
分析过程中没解决的问题,会以「剩余未知项」的形式记进一本独立的账。每条未知项要写清楚:问题是什么、还需要什么权限或环境才能解决、有哪些支持证据和冲突证据。agent 不能假装这些坑不存在,只能用新证据去销账。
于是 agent 的工作方式变成:提问、拿证据、发现未知、补一轮实验、销账、再下结论。要是卡在某个工具版本上,它也得如实告诉你卡在哪。
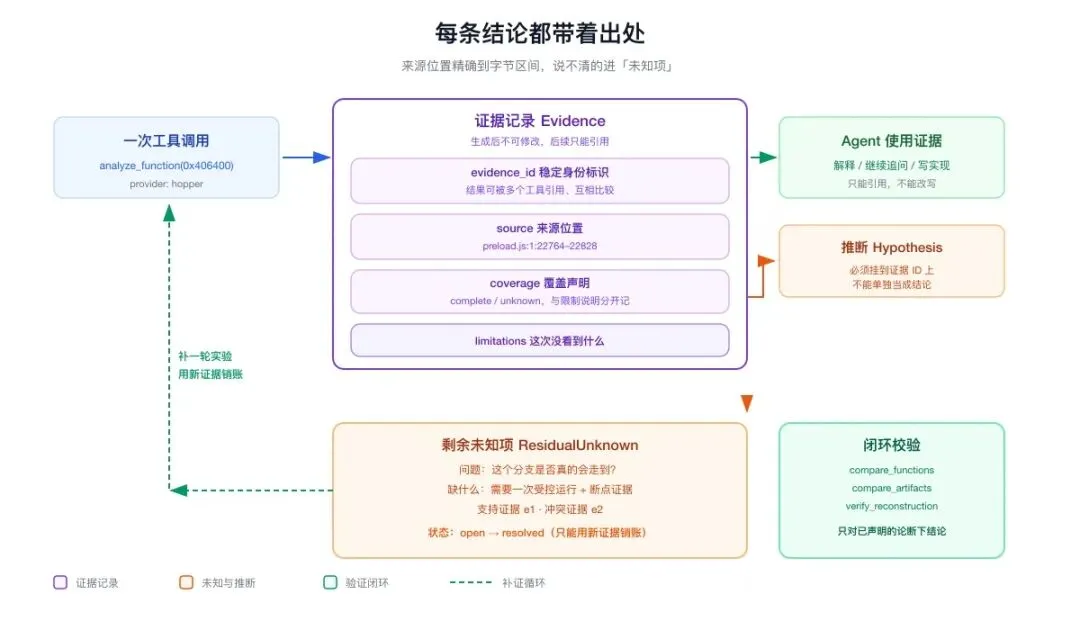 证据账本
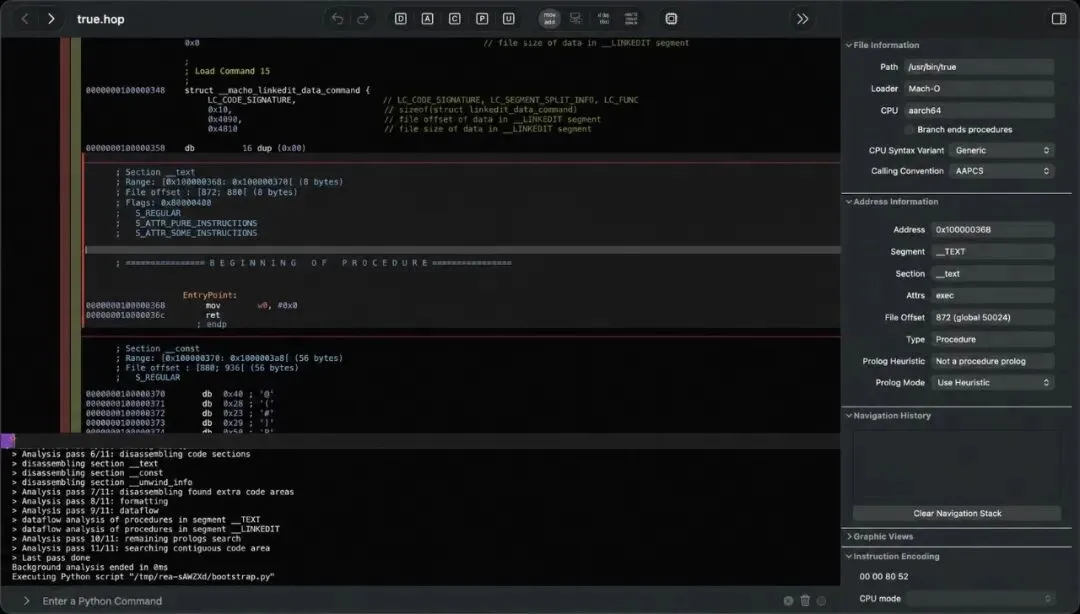 官方实机:REA 在 Hopper 里分析一个原生二进制
为什么这就是「颠覆」
传统逆向的瓶颈从来不在工具,在人。工具能给你伪代码,但伪代码准不准、这个变量是什么意思、这条路径是不是真的会走到,全靠人自己判断。老手快,新手慢,经验没法批量复制。
REA 把这套判断拆成了机器能做的步骤:定位、取证、追溯、留痕、核对。agent 不需要「手感」,它只需要照着证据走。而且证据是可以被下一个 agent 复核的。
它还支持两种闭环:把两次分析的结果做函数级或产物级对比;以及用 verify_reconstruction 拿一份带类型的规格说明去核对重建结果。仓库里的三个官方案例都是靠这个反哺出来的。
DX-Ball 的案例:要还原砖块撞击时声音的左右声像计算。第一次反编译出来的伪代码几乎是空的,只看到一次浮点转整数调用。agent 回头去看指令,发现输入参数藏在 [EBP+8] 里,伪代码没显示出来。顺着调用者往上追,发现屏幕坐标是 20 + 30 × tile_x;再按地址读内存里的双精度常量,把算法补全成 C。最终实现跑了 3205 组原始 x86 用例全过,编译出来的 63 个字节和原程序完全一致。
TH04 的案例更极端:一台 PC-98 上的 16 位 DOS 游戏,弹幕的固定角度和瞄准角度计算方法。恢复出的 C++ 跟当年编译器的输出做了逐字节比对。整个项目目前恢复了 55 个函数、做了 45380 次对比、33 个函数编译后字节一致。
这些不是「AI 猜得像」,是能拿编译器验身的。
装起来是什么样
需要 Node.js 22.19 以上(或 24.11、26 以上)和 npm。一条命令:
npx rea-agents setup它会问你接哪个 agent,把 MCP 服务器注册进去、装好配套的工作流指令,改配置前先做备份。支持 Claude Code、Codex、Cursor、Gemini CLI、Windsurf、Copilot CLI、VS Code、Grok Build 等十几种客户端。装完重启 agent 才生效。
原生二进制的深度分析要另配引擎,Hopper、Ghidra、IDA 三选一,用你现成的安装就行。setup 可以在你批准后帮你装 Hopper,Ghidra 和 IDA 不会动。纯静态的 JavaScript 和 .NET 分析什么都不用装。
不想接 agent 也能用命令行,比如拆一个 Electron 应用:
npx -y rea-agents@latest analyze-javascript-application /path/to/app --json返回的是完整的证据记录,连图和限制说明一起给你。原生分析则是 rea open、rea inspect、rea function、rea decompile、rea xrefs 这一套,用 --provider 指定引擎。
日常使用不需要背命令,基本就是对着 agent 说话:
「这个网页导出 Excel 时请求了哪些接口,响应是怎么变成文件的?」
「对比一下 1.2 和 1.3 两个版本,跟登录相关的逻辑改了什么?」
「这个固件里跑的是什么系统,有哪些服务在启动时拉起?」
该知道的几件事
分析全程在本地跑。 目标文件不上传,agent 拿到的是本地工具返回的结果。但你的模型服务商有自己的数据政策,这一点得自己掂量。
它不是安全沙箱。 运行时观察(进程捕获、浏览器操作、设备调试)用的是你自己的用户权限,会真的把目标跑起来。做这步之前要清楚在跑什么。
不同目标的上手成本差很多。 纯静态的 JS/Electron/.NET 开箱即用;原生二进制要配引擎,IDA 还得合法授权;固件、抓包、信号解码要自己在 Linux 上装 binwalk、tshark、sigrok 这些外部工具,REA 不替你装。
结果会说「不知道」。 这是设计使然,不是缺陷。但如果你习惯了工具给一个干脆的答案,得适应它时不时冒出来的「覆盖不完整」「此维度不可用」。
用在哪,边界很清楚。 读自己买的软件、做互操作性研究、软件保存、学别人的实现思路,这些是它明确支持的场景。拆别人的付费产品拿去复制、绕过授权,不在授权范围内——这点项目写得很直白。
REA 真正改变的是逆向工程的分工方式。
以前是一个人守着一堆工具,靠记忆和直觉把碎片拼起来。现在是一个人对着 agent 提问题,agent 负责取证、追溯、记账,人负责问对问题和判断值不值得。
门槛从「会不会用 IDA」变成了「会不会提问」。
对想研究别人产品实现的人,这是好事。对靠信息不对称吃饭的人,这不是。
项目地址:
https://github.com/morluto/rea官网有交互式案例可以自己点:
https://rea.tools/showcase/