ARTICLE · 1220473
AI 生成内容同质化溯源:问题不在于工具,在于缺少私有数据输入
RAG, 私有知识库, Spring Boot, 大模型, 内容同质化,迪飞特科技
前言
最近半年,我至少被问了二十次同一个问题:“为什么用 AI 写出来的东西,读起来都一个味儿?”
问这个问题的,有做自媒体的朋友,也有企业里负责内容运营的团队。他们不缺工具,ChatGPT、DeepSeek、文心一言轮着用,提示词也学了不少,但产出就是千篇一律——开头都是"在当今这个快速发展的时代",结尾都是"让我们一起拥抱未来"。
这篇文章不聊虚的,就从我们团队踩过的坑出发,讲清楚同质化的根源到底在哪,以及怎么用私有知识库把 AI 的输出"掰"回你自己的风格。适合正在用 AI 做内容、但被同质化困扰的开发者或运营负责人。看完你至少能明白:换工具解决不了问题,喂数据才能。
问题背景:我们试过换工具,没用
去年秋天,我们帮一家做本地文旅的客户做内容中台。他们每周要产出几十篇景区介绍、活动推文,之前靠两个编辑硬写,累得够呛。上了 AI 之后,效率确实上去了,但新问题来了——发出去的推文,读者反馈"像官方通稿",连他们自己老板都说"这玩意儿读着不像我们说的话"。
一开始我们以为是模型不行。从 GPT-3.5 换到 GPT-4,又试了 DeepSeek,还对比了国内几家大模型。说实话,生成速度是快了,但那股"AI 味儿"一点没少。后来我们把同一篇景区介绍分别喂给三个模型,让它们改写,结果三份输出放在一起,相似度高得吓人——连举的例子都差不多。
那时候我才意识到,问题不在模型,在输入。我们给模型的,永远是一句干巴巴的提示词:"写一篇关于天山天池的景区介绍,300 字,风格活泼。"模型哪知道你们景区的"活泼"是什么样?它只能从训练数据里找最大公约数,而最大公约数,就是同质化。
原理:大模型的"平均脸"效应
大模型的本质是概率预测。你给它一个提示,它在海量训练数据里找最可能的下一句。这个机制决定了:输入信息越少,输出越趋近于"平均"。
打个比方,你让一百个人画"一只猫",不给任何参考,最后交上来的大概率都是圆脸、尖耳、长尾巴的标准猫。AI 也一样,没有私有数据约束,它只能给你"标准答案"。
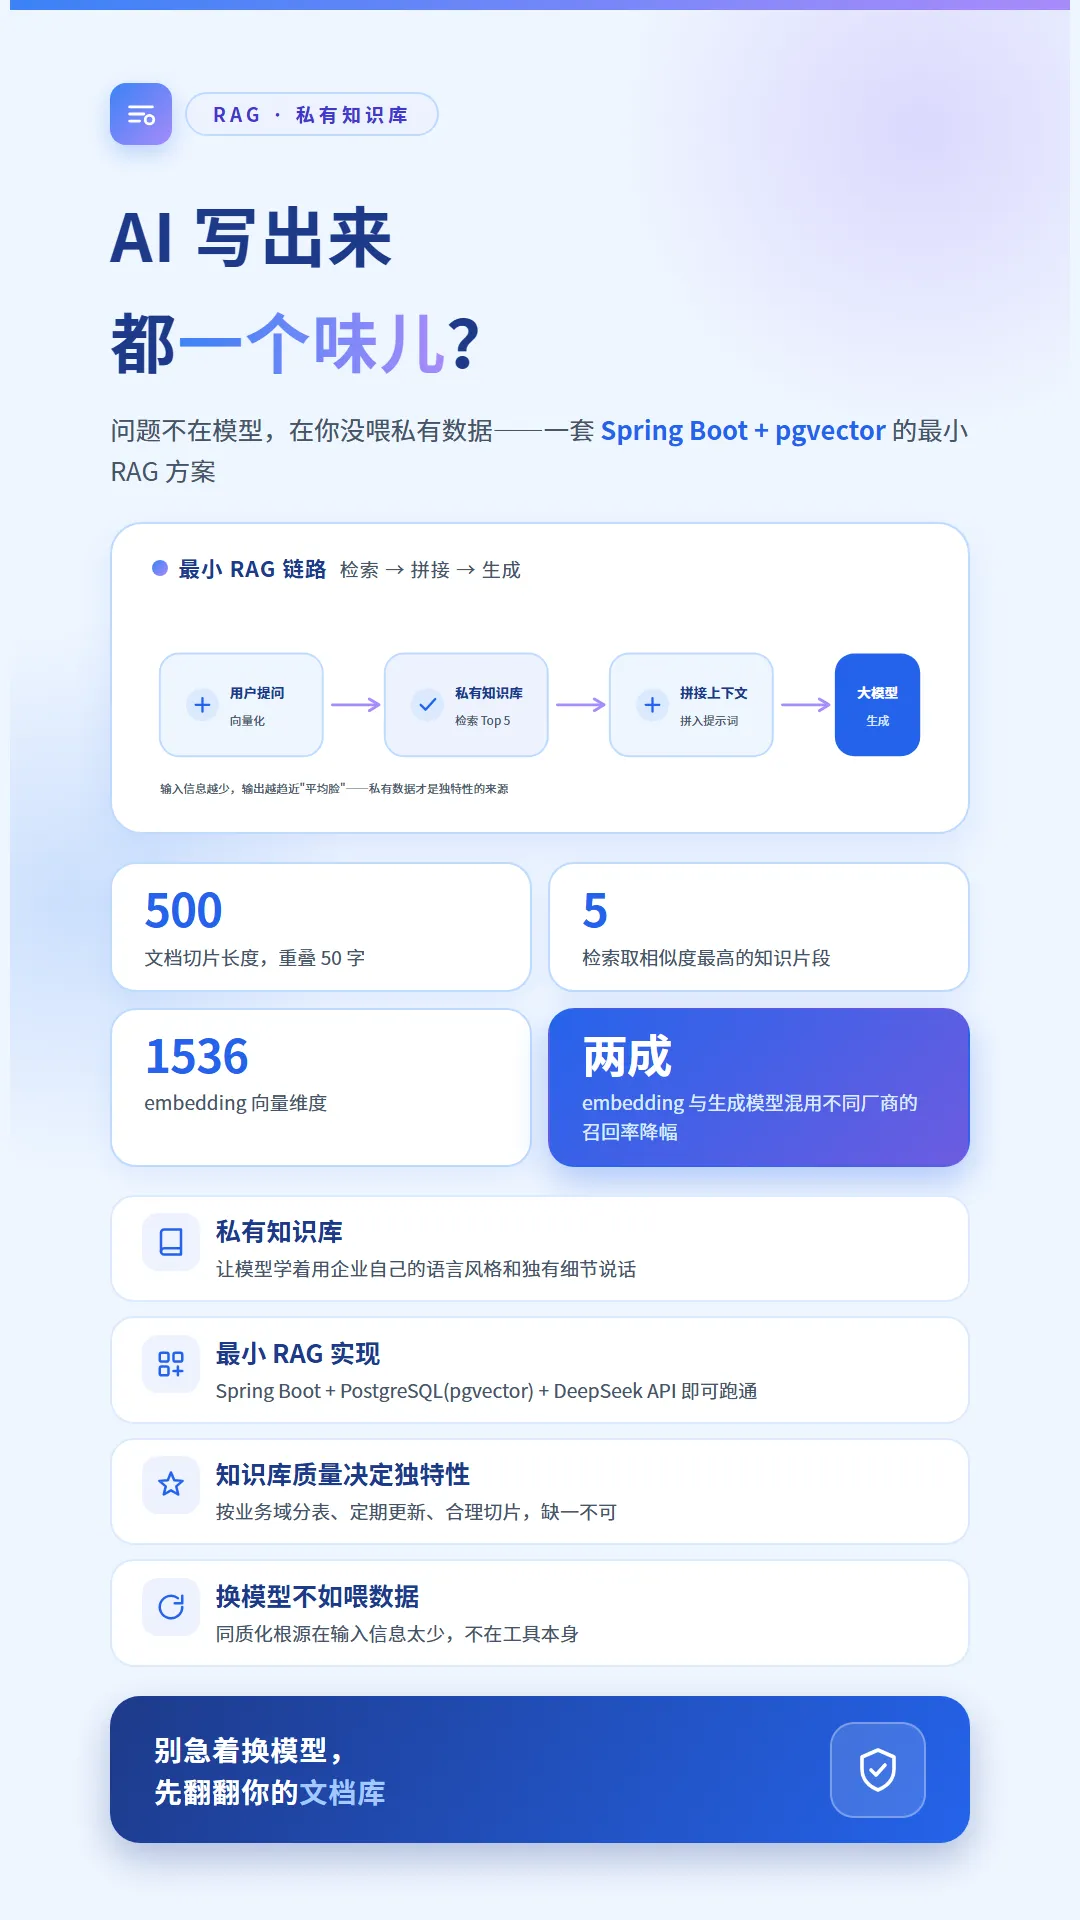
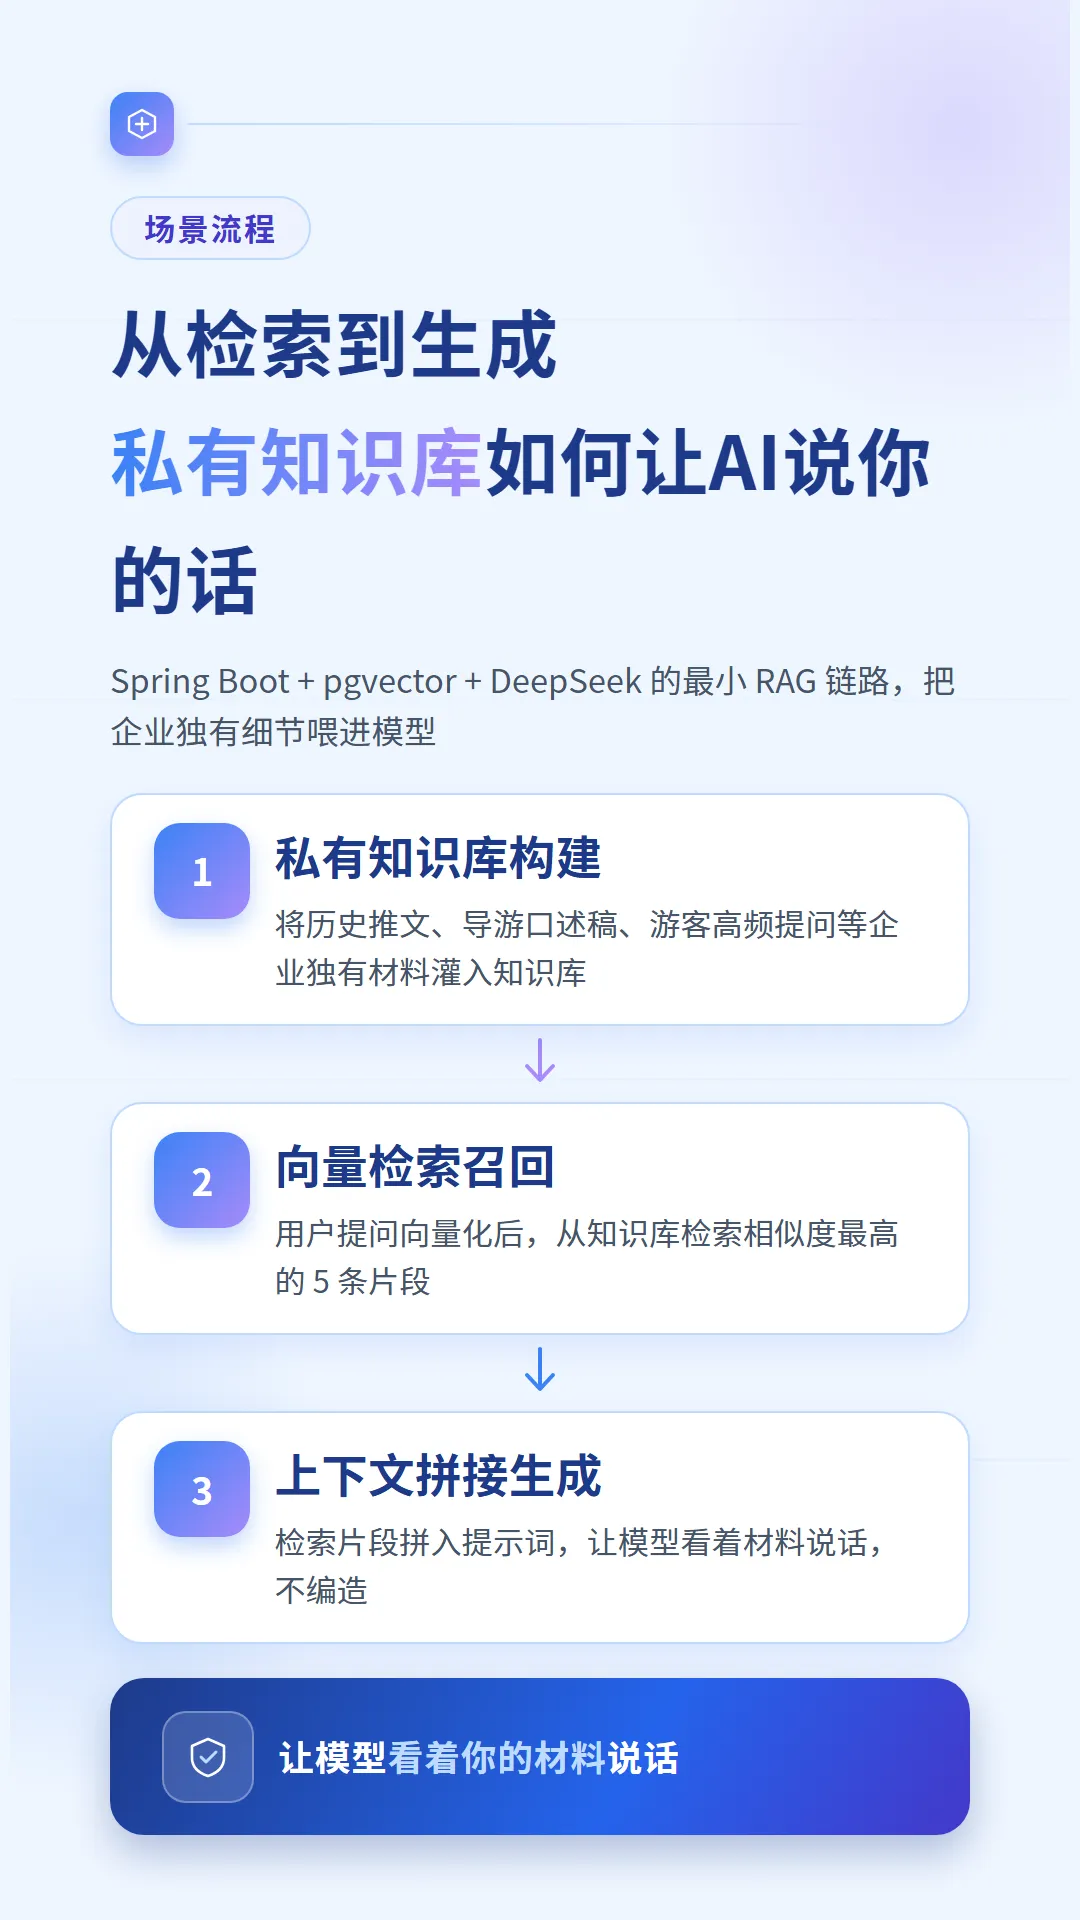
那私有数据输入是怎么起作用的?目前主流做法是 RAG(检索增强生成)。简单说,就是在模型生成之前,先从你的私有知识库里检索出相关片段,拼进提示词里,让模型"看着你的材料说话"。
用户提问 → 向量化 → 检索私有知识库 → 拼接上下文 → 大模型生成 → 输出
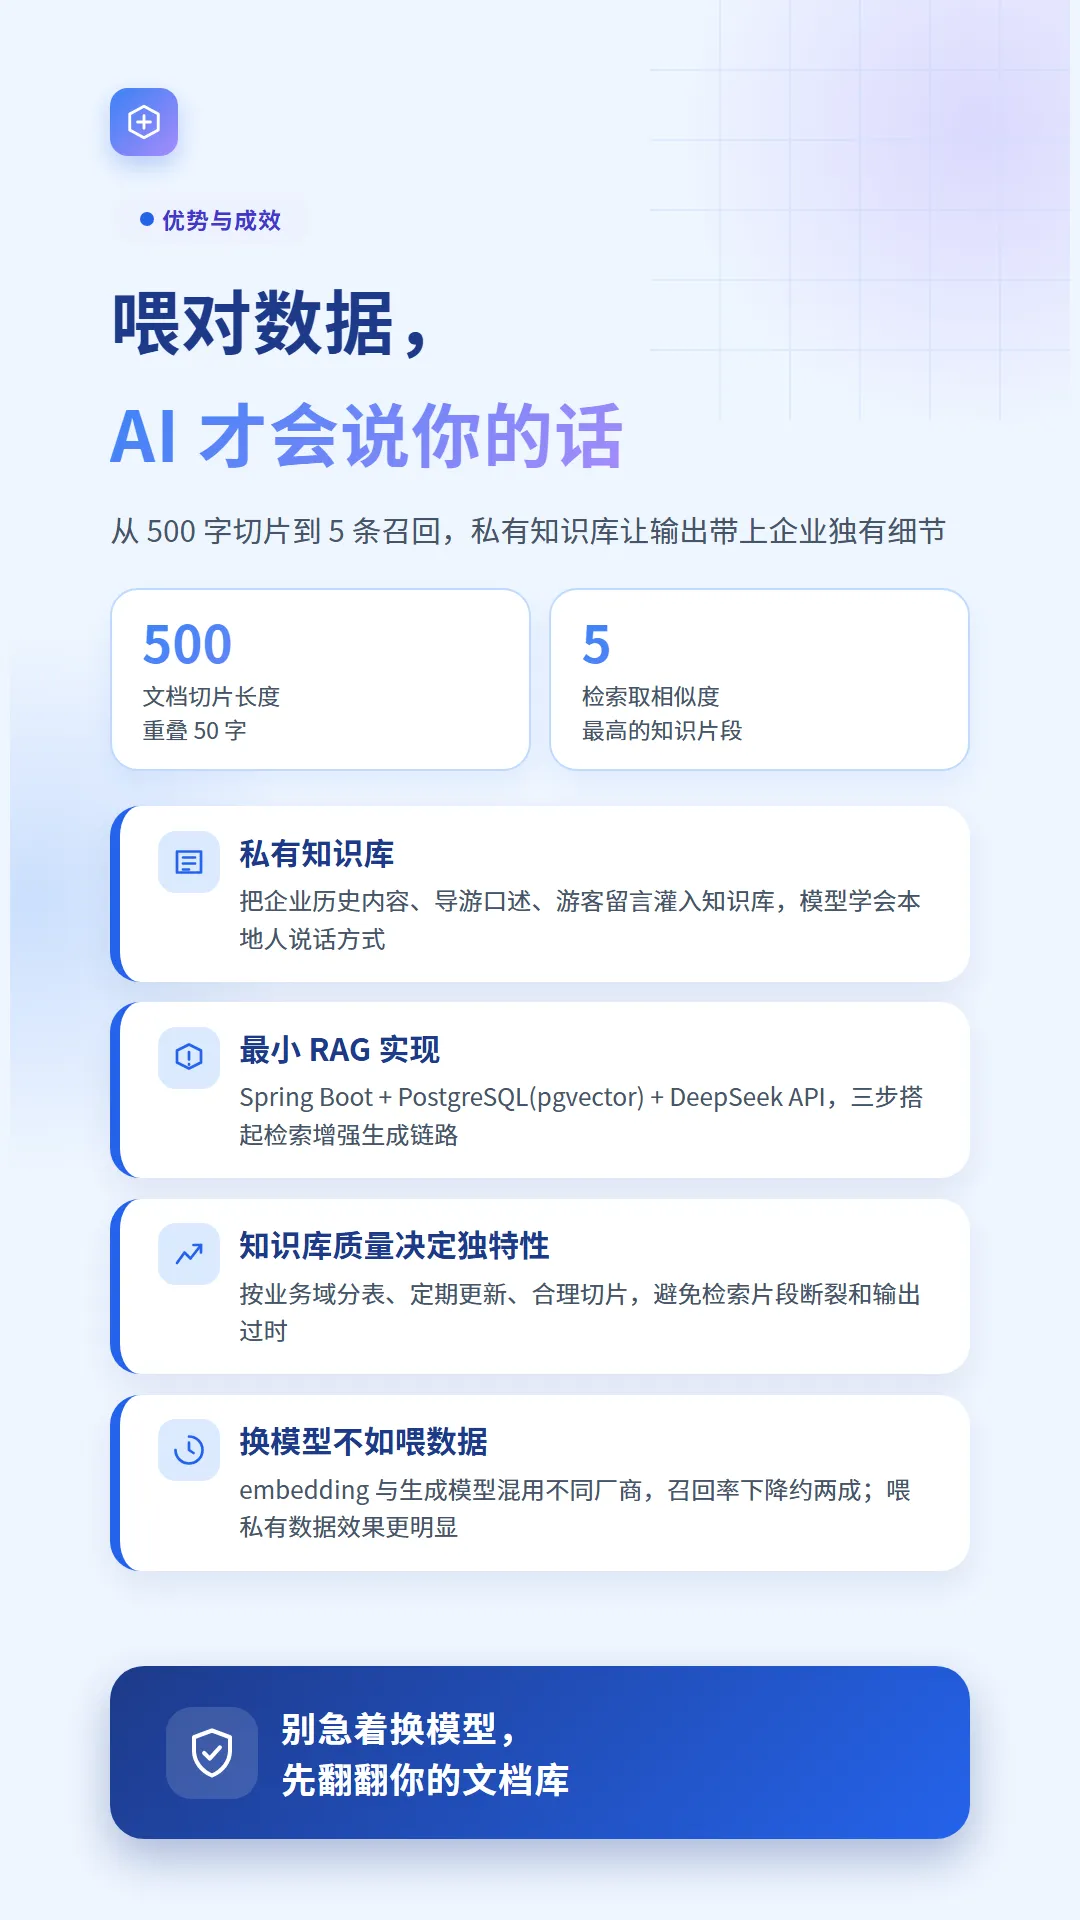
这个链条里,知识库的质量直接决定了输出的独特性。你喂进去的是景区十年的游客留言、本地导游的讲解词、往期爆款推文,模型就能学着用"本地人说话的方式"来写;你喂进去的是一堆通用模板,那输出自然还是模板。
我们后来给那个文旅客户搭了一个小知识库,把过去三年的推文、导游口述整理稿、游客高频提问都灌了进去。同样的提示词,生成出来的开头从"天山天池位于新疆阜康市"变成了"老导游常说,看天池得赶早,晚了云就上来了"。差别就在这。
实操:用 Spring Boot 搭一个最小可用的私有知识库
下面是我们实际项目里简化出来的一个最小实现,技术栈是 Spring Boot + PostgreSQL(pgvector)+ DeepSeek API。不复杂,但够用。
第一步,建表存向量。
CREATE EXTENSION IFNOTEXISTS vector;

CREATETABLE knowledge_chunk (
    id BIGSERIAL PRIMARYKEY,
    content TEXTNOTNULL,
    embedding vector(1536),
    source VARCHAR(255),
    created_at TIMESTAMPDEFAULTNOW()
);

CREATEINDEXON knowledge_chunk USING ivfflat (embedding vector_cosine_ops);
第二步,文档切片与向量化。 我们按 500 字左右切,重叠 50 字,避免语义断裂。
publicvoidingest(String rawText,String source){
List<String> chunks = splitter.split(rawText,500,50);
for(String chunk : chunks){
float[] vector = embeddingClient.embed(chunk);
        jdbcTemplate.update(
"INSERT INTO knowledge_chunk(content, embedding, source) VALUES (?, ?::vector, ?)",
            chunk,toPgVector(vector), source
);
}
}
第三步,检索并拼提示词。
publicStringgenerateWithContext(String question){
float[] qVec = embeddingClient.embed(question);
List<String> contexts = jdbcTemplate.queryForList(
"SELECT content FROM knowledge_chunk ORDER BY embedding <=> ?::vector LIMIT 5",
String.class,toPgVector(qVec)
);

String prompt ="""
        你是一个熟悉本地文旅的写作者。请参考以下材料回答问题,
        不要编造材料里没有的信息。

        材料:
        %s

        问题:%s
        """.formatted(String.join("\n---\n", contexts), question);

return llmClient.chat(prompt);
}
这套东西跑起来之后,最直观的变化是:模型开始"引用"我们自己的材料了。有一次生成一篇关于滑雪场的推文,它自动带出了知识库里一条三年前的游客留言——“缆车排队时工作人员给发了暖宝宝”。这种细节,通用模型永远编不出来。
踩坑:知识库不是灌进去就完事
说几个我们真金白银踩过的坑。
坑一:切片太碎,检索出来全是半句话。 一开始我们按 200 字切,结果检索到的片段经常断在句子中间,模型拼出来的内容前言不搭后语。后来改成按段落切,再手动补了重叠区,才顺过来。
坑二:知识库不更新,输出越来越旧。 有个客户的促销活动都换了两轮了,知识库里还躺着去年的价格。模型老老实实按旧数据写,差点闹出纠纷。现在我们给知识库加了定时同步任务,每周从业务系统拉一次最新数据。
坑三:什么都往里灌,检索精度反而下降。 早期我们图省事,把会议纪要、合同、推文全塞一个库。结果问景区介绍,检索出来一段合同条款。后来按业务域分了表,检索时加 source 过滤,才干净。
还有个细节,embedding 模型和生成模型最好别混用不同厂商的,向量空间对不上,检索效果会打折扣。我们试过用 A 家的 embedding 配 B 家的生成,召回率掉了差不多两成。
总结
AI 生成内容同质化,根子上不是模型笨,是我们给的信息太少。模型只能在你划定的圈子里跳舞,圈子越小,舞步越单调。
私有知识库的价值,不在于多高深的技术,而在于把"你们公司怎么说话、怎么做事、有什么别人没有的细节"变成模型能读到的材料。RAG 也好,微调也罢,本质都是这个思路。
如果你也在被同质化困扰,别急着换模型。先翻翻自己的文档库、聊天记录、历史内容,看看有多少东西是模型根本不知道的。把这些喂进去,效果可能比换十个工具都明显。有具体落地问题,欢迎评论区聊。